Sentryを開き直す
今回は、長く使ってきたSentryを改めて開いてみた話を書いてみたい。
筆者は会社でSentryベースのエラー監視を長く扱ってきた。イシューが上がればstack traceを開き、releaseとタグで範囲を絞り、再現条件を探す作業は手に馴染んでいる。ところが振り返ると、使う機能はいつもその周辺だけだった。Logs、Crons、Uptime、custom span、profilingは存在を知りながらも有効にしていなかった。
理由は知識ではなく探索コストだった。一つの機能が自分の問題に合うかを確かめるには、散らばったドキュメントを突き合わせて読み、実験を設計し、configを配線し、結果を解釈しなければならない。イシュー対応に追われる日には、そのコストを払う理由がなかった。最近Claude CodeにSentry MCPをつないで使うようになり、このコストのかなりの部分が下がり、筆者の手順も変わった。今は機能を有効にする前に、このアカウントの実データにまず聞いてみる。
この記事は全4回の観測シリーズの第1回だ。このブログのサーバー計測が捉えた障害を一つ追いかけたあと、MCPでそのデータを開き直して新たに見えたことを書き、機能ごとにどこで使うかを判定する。シリーズはサーバーから始まり、ブラウザ内のレンダリングとCPU、メモリを経て、検索データまで進む。
成功応答の中の失敗
このブログのSentryは2026年8月にサーバー専用で導入した。ブラウザSDKを外した判断は第2回で扱い、ここではサーバーで何を捉えようとしたのかだけを見る。目的は一つだった。サーバーでGoogle Analytics Data APIを呼んで訪問者統計を描いているのに、その呼び出しが失敗しても知る方法がなかった。
最初は統計APIルートのcatchに報告を入れればよいと思っていた。ところがローカルのプロダクションビルドに誤ったサービスアカウントキーを入れて失敗させてみると、エラーはルートまで上がってこなかった。一層下の統計モジュールのcatchが先に捕まえてデフォルト値を返しており、応答はこうだった。
HTTP 200 OK
{ "slug": "/260610", "views": 0 }
訪問者には統計が0に見え、サーバーは正常だと答える。ルートのエラー率では何も起きていない。Microsoft ResearchとMicrosoft Azureの研究者がHotOS 2017で発表したGray Failure論文は、この状態の核心を次のように規定している。
我々はまた、gray failureの重要な特徴はdifferential observability、すなわちアプリケーションが被害を受けているにもかかわらず、システムの障害検知器が問題に気づかない可能性があることだと主張する。
We also argue that a key feature of gray failure is differential observability: that the system's failure detectors may not notice problems even when applications are afflicted by them.
そこで計測ポイントをルートから統計モジュールのcatch4か所に下ろした。fallback自体は訪問者体験を守る正しい選択なのでそのまま残し、fallbackが実行されたという事実だけを別に報告したのだ。当時は4か所を区別するタグをgaQuery一つで付けていた。
// 2026-08 당시
Sentry.captureException(error, { tags: { gaQuery: 'stats' } })今のコードは、8月17日のコミットf348d4cで報告をcaptureServerException一か所にまとめ、cardinalityが大きくならないようタグキーをlocale、routeKind、operationの三つに制限した形だ。
// 현재 src/lib/google-analytics.ts
captureServerException(error, { routeKind: 'analytics', operation: 'stats' })現在の統計モジュールの報告ポイントはcatch3か所と認証情報欠落の経路一つだ。(popularの経路は後で述べる理由で9月に削除した)認証情報の経路はcatchを通らずにすぐfallbackを返すのだが、今日の訪問者数に10〜40の基準値を上乗せするロジックのせいで、画面にはもっともらしい数字が表示される。環境変数が丸ごと抜けても人の目には見えない経路なので、プロセスごとに一度だけ報告するようにした。
5秒タイムアウトの後の338秒
計測を下ろしたあとに上がってきたプロダクションのイシューJIHOON-BLOG-2は、GA呼び出しが65.877秒後にDEADLINE_EXCEEDEDで失敗したものだった。応答は相変わらず200だった。原因はGAクライアントライブラリの設定ファイルにあった。runReportのデフォルトRPCタイムアウトはtimeout_millis: 60000なのに、筆者のコードは五つの呼び出し箇所のどこにもタイムアウトを渡していなかった。Google SREのGráinne Sheerinが書いたgRPC公式ブログのdeadlineの記事が冒頭から"Always set a deadline"と警告している、まさにその失敗だ。
修正コミット927c85bはすべての呼び出しに5秒を渡すようにした。応答しないローカルTCPサーバーを立てて再現した結果は説明どおりだった。
| 条件 | 経過時間 | エラーメッセージ |
|---|---|---|
| タイムアウト未指定 | 60.04秒 | Deadline exceeded after 60.000s |
timeout: 5000 |
5.00秒 | Deadline exceeded after 5.000s |
(5という数字に根拠はない。GAの正常応答の分布は測っていない。ただこのブログで訪問者数は付加情報なので、長く待つより早く諦める方向は正しいと考えた)そのイシューは今イシュー一覧に出てこない。65.877秒という値は、コミットメッセージとリポジトリのドキュメントに残った記録だ。
ここで終わるはずだったのだが、修正がデプロイされたリリースで新しいイシューJIHOON-BLOG-8が積み上がり始めた。メッセージはDeadline exceeded after 338.655sで、スタックにもgoogle-gaxのタイムアウトラッパーがそのまま残っていた。設定はコードに届いているのに、報告された時間は設定の70倍近かったのだ。
8月18日ごろ、当時の最新100件を抽出して分布を描いた。
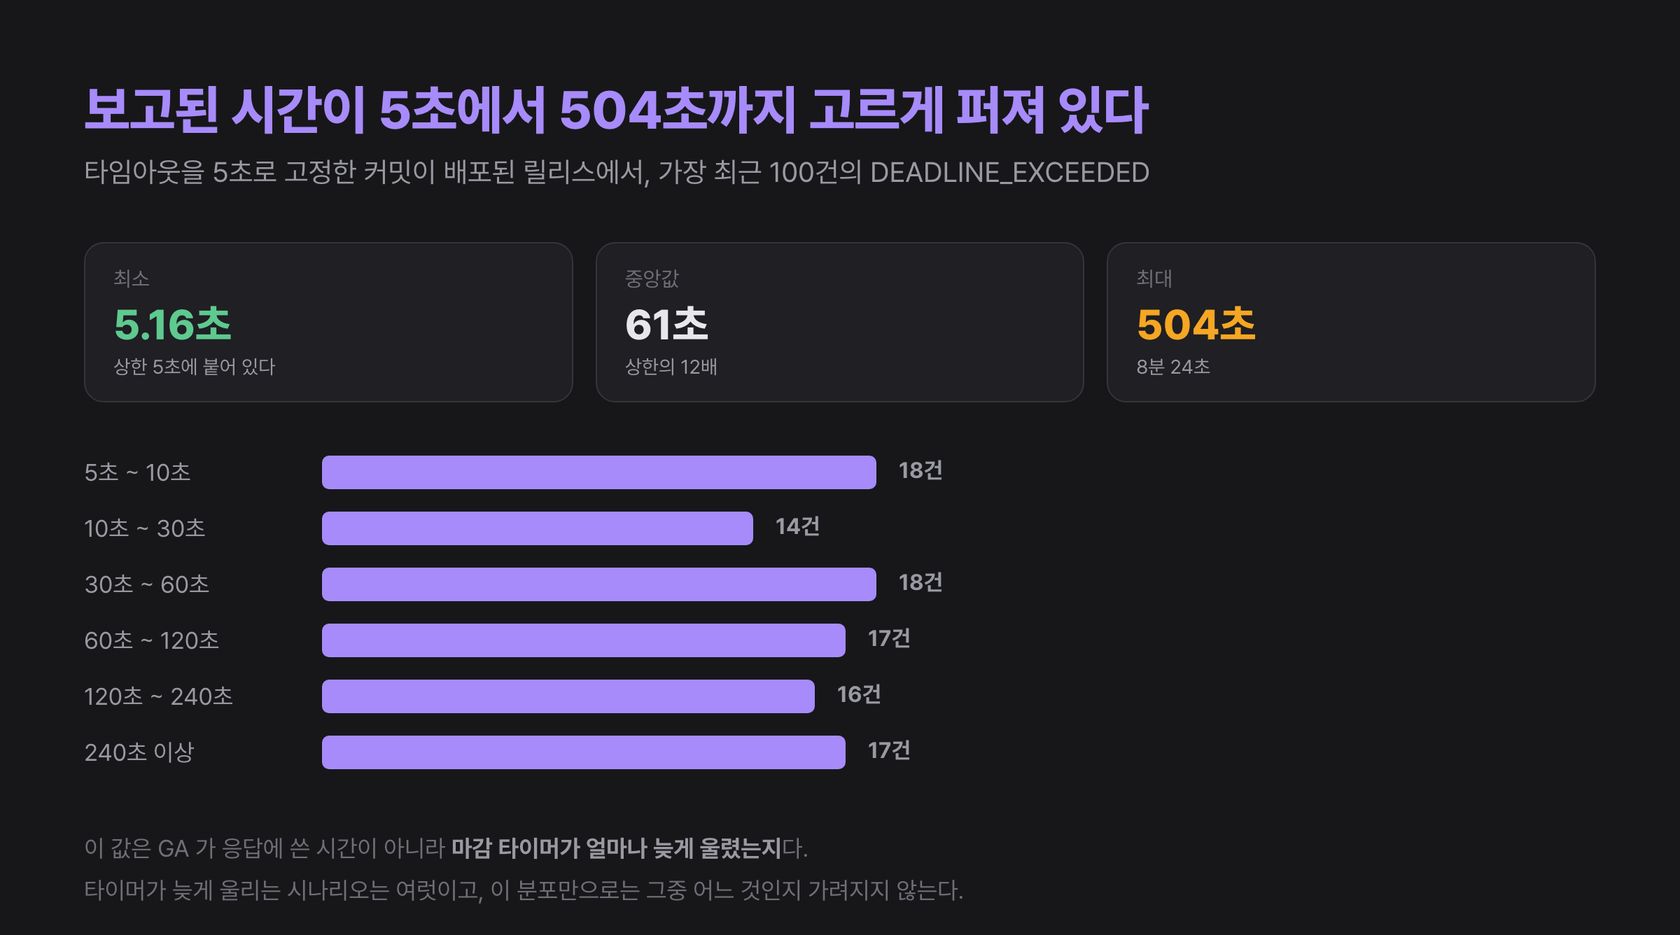
下限は5.16秒で設定に張り付いており、中央値は61秒、最大値は504秒だ。値はどの区間にも集中しなかった。(この図は今は描き直せない。理由は次の節で出てくる)タグはstatsとpopularの二つの値だけで、たいていペアで上がってきた。二つの経路の共通点は、1時間のunstable_cacheの背後にある再検証経路だということだ。リクエストごとにGAを呼ぶpage、pagesは一度も出てこなかった。
そこで筆者は一つの仮説を立てた。サーバーレス関数は応答を送ったあと、次の呼び出しまで実行環境が凍結されることがある。その間タイマーも止まり、目覚めてからようやく発火するのなら、実際に待った時間ではなく、凍結されていた時間まで含んだwall-clock time(実際の経過時間)が記録される。ただし、分布が仮説と矛盾しないことと、仮説を支持することは別だ。イベントループを重い処理が占有していても同じ形になる。
MCPで開き直したデータ
この記事を書きながら、2026年9月16日にSentry MCPで同じデータを再度照会した。直したと信じていたものが今もそうなのかを確かめるためだったが、ダッシュボードでイシュー画面を行き来しながら探していたものが、数回のやり取りで出てきた。以下では照会で確認した事実と、そこから引き出した推論を分けて書く。
発生が止まった理由
JIHOON-BLOG-8の最後の発生は8月18日13:45 UTCで、それ以降は0件だ。グラフだけ見ると問題が消えたように見えるが、筆者は仮説を検証したことも直したこともない。同じ日にコミット417d3b4が多言語化の改修でホームから訪問者統計と人気記事のエリアを外しており、statsとpopularを呼んでいた画面がまさにその二つだ。9月に残っていた人気記事の経路を削除したコミット5752e09のメッセージは、これを「5秒タイムアウトではなく、呼び出し箇所が消えたことがイベントが止まった直接の理由」と書いている。ところが時刻を突き合わせると、そのコミットがmainにプッシュされたのは22:07 UTCで、最後のイベントより8時間以上後だ。残っているイベントが1日10件ほどなので8時間の空白自体は珍しくなく、デプロイ後に発生がないという事実とも矛盾しない。ただ、時刻だけでは呼び出し箇所の削除が止まった理由だと確定できないので、筆者はそのメッセージを最も有力な説明程度に読んでいる。
イシューのresolvedは原因究明の証明ではない。発生が0になる道は、実際に直ったか、誰もその経路を通らなくなったか、計測が消えたかの三つだ。エラーシグナルだけではこの三つを区別できない。
breadcrumbに残った5分39秒
最後のイベントのbreadcrumbをMCPで取り出してみた。breadcrumbというとブラウザのクリックや遷移の記録を思い浮かべがちだが、このブログのNodeサーバーSDKもhttpリクエストとconsole出力を自動で残していた。
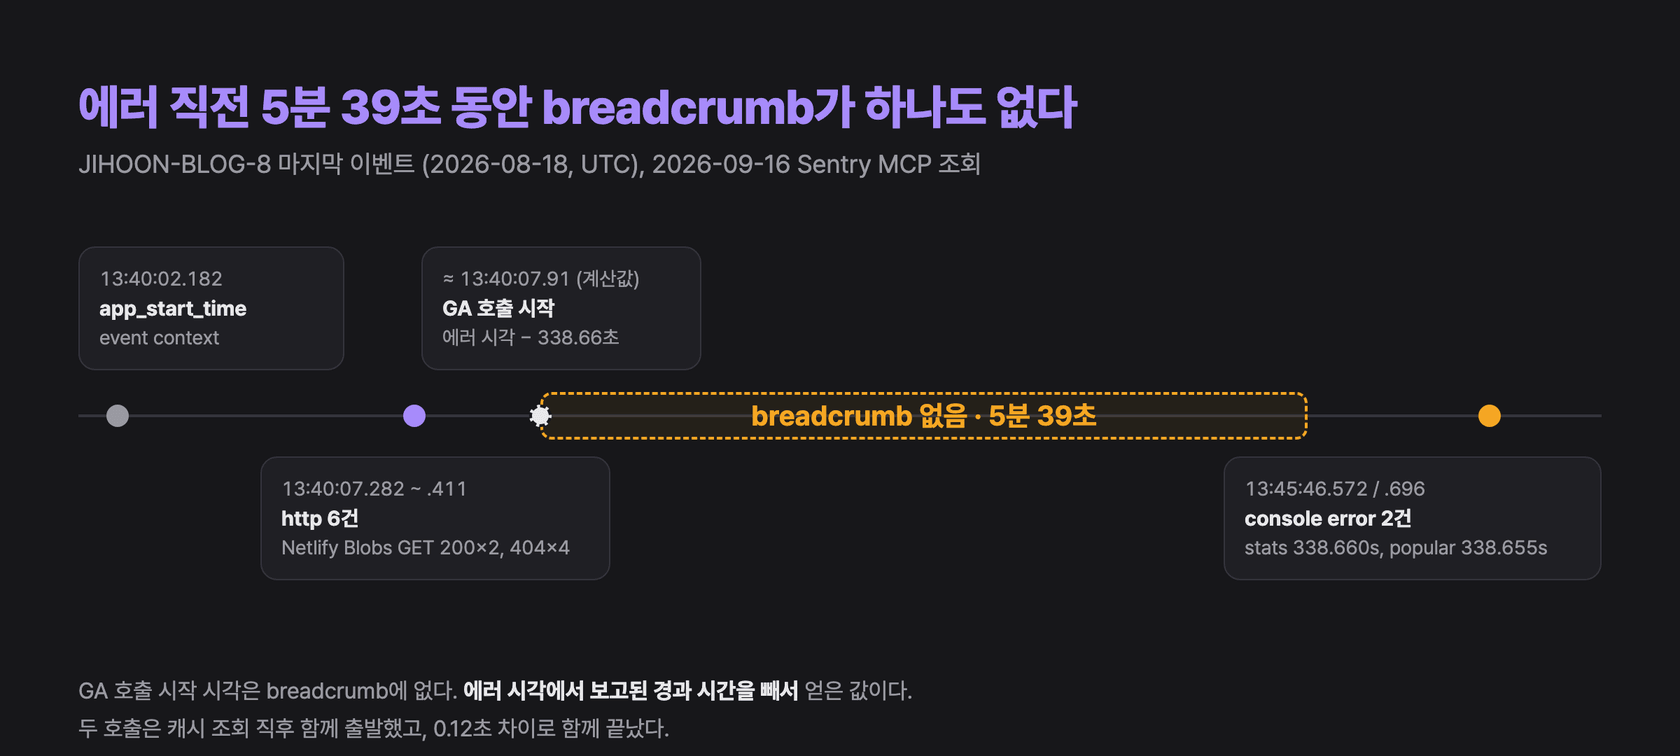
事実はこうだ。関数は13:40:02に開始し、13:40:07にNetlify Blobsのキャッシュ照会が6件あった。その次の記録は13:45:46のconsole error 2件だ。報告された338.66秒を逆算すると、GA呼び出しはキャッシュ照会の0.5秒後、コールドスタートの約6秒後に出発している。
ここから引き出せることは限られている。5秒後に鳴るはずのタイマーが5分39秒後に鳴り、その間このリクエストは何の記録も残さなかった。凍結仮説とは矛盾しないが、イベントループ占有の仮説も消せない。それでも以前はなかった情報が一つ増えた。失敗がコールドスタート直後のキャッシュ再検証から出発した呼び出しだったという開始時刻だ。
保持期間が消したイベント
JIHOON-BLOG-8イシューの発生カウンターは144だ。同じイシューをerrorsデータセットで90日間集計すると2026年9月16日14:26 UTCの照会で10件しか出てこない。残っている10件は8月17日15:03から18日13:45 UTCまでで、照会時点からほぼ正確に30日以内に収まる。同じ日の08:45 UTCに照会したときは14件だったので、この数字は照会するたびに減っていく。
推論を加えると、イベントの保持期間が30日なので古いイベントは削除され、イシューカウンターだけが残ったように見える。Sentryの料金ページは無料プランであるDeveloperの照会範囲を30日と記している。ただし、このアカウントのプランの種類とカウンターが維持される仕組みは確認していない。確かなのは結果だ。上の100件の分布はもう抽出できず、保存されなかったデータはどんなツールでも復元できない。
spanが0個のtrace
同じイベントのtrace_idでtraceを開くと、spanは0個だ。イベントにはclient_sample_rate: 0.1が記録されている。10%のsamplingから漏れたのかもしれないし、spanの保持期間を過ぎたのかもしれないが、どちらなのかは切り分けられなかった。
直近30日のhttp.client spanをドメイン別にまとめても、GA APIのドメインはなかった。大半はNetlify Blobsの照会だ。最も有力な説明は、その期間にGA呼び出し自体がほとんどなかったというものだ(ホームの統計エリアはすでに外されていた)。gRPC呼び出しが自動計測でspanとして捕捉されるかどうかはまだ確認していない。ちなみにこの集計のcount()はサンプリングを逆重み付けした外挿値なのだが、MCPの応答にはその警告がなかった。数字をリクエスト数として読まないのは、依然として人間の役目だ。
productionに紛れ込んだローカル検証
9月16日に開いたJIHOON-BLOG-BはGoogle Analytics credentials missing: GA_PROPERTY_IDだ。イベントを開いてみると、URLがhttp://localhost:3117/api/analytics、ブラウザがcurl 8.7.1、サーバー名が筆者のMacBookだった。ところがenvironmentはproductionだ。
筆者がリポジトリのドキュメントにあるローカル検証手順(pnpm buildの後にpnpm start)に従って生じたイベントだ。src/lib/sentry-options.tsはSENTRY_ENVIRONMENTがなければNetlifyのCONTEXTで環境を決める。Deploy Previewをプロダクションから切り離すために作った仕組みだが、どちらもないローカルでは環境値を渡さず、イベントには結局productionが記録された。プレビューは防げたがローカルは防げなかったわけだ。この状態でproduction基準のアラートを設定すると、筆者の実験がアラートを鳴らす。
そこでリポジトリのドキュメントの検証コマンドにSENTRY_ENVIRONMENT=localを入れた。コードでデフォルト値を変えなかった理由は、Netlifyの関数ランタイムでCONTEXTが常に見えることをまだ確認していないからだ。確認せずにデフォルト値をlocalにすると、今度はプロダクションのイベントがlocalに隠れてしまうおそれがある。
どこに何を使うか
同じやり方で、有効にしていない機能もデータから確認した。直近30日でlogs 0件、profiles 0件、replays 0件、cron monitor 0個、uptime monitor 0個だった。設定ファイルを読んで「有効にしていない」と書く代わりに、「0である」を確認したことになる。下の表は各機能の現状を、2026年9月16日に公式ドキュメントとchangelogで改めて確認して整理したものだ。
| 機能 | 答える問い | 前提 | コスト | このブログの判定 |
|---|---|---|---|---|
| Issuesとgrouping | これらのイベントは一つの事象か | SDK、ソースマップ | エラークォータ | 使用中 |
| Crons | 定期ジョブは時間どおりに動いたか | check-in送信 | 1個込み、追加分は有料プランのPAYG | 有効にする |
| Uptime | 外からURLが2xxか | なし | 1個込み、追加分は有料プランのPAYG | 補助として検討 |
| Alerts | いつ人を起こすか | environmentの分離 | 独立した料金項目なし | 件数の閾値ではなく発生の有無 |
| Logs | fallbackがいつどれだけ実行されたか | SDK設定 | 5GB込み | GA呼び出しの候補 |
| Application Metrics | サンプリングに左右されない分布は | JS SDK対応バージョン | 5GB込み | GA呼び出しの候補 |
| custom span | リクエスト内のどの区間が遅かったか | tracing | spanクォータ、10%サンプリング | 候補 |
| Session Replay | ユーザーは何を見たか | ブラウザSDK | バンドル、replayクォータ | 有効にしない(第2回) |
| User Feedback | ユーザーは何が間違っていると言っているか | ブラウザSDK | バンドル | 有効にしない |
| ブラウザprofiling | どのJS関数がメインスレッドを塞いだか | beta、Chromium、ヘッダー | UI profile時間 | 第3回で判断 |
| Seer | このイシューの原因と修正案は | GitHub/GitLab連携 | アクティブコントリビューターあたり$40/月 | 実行しない |
| Sentry MCP | エディタからデータを照会するには | OAuth接続 | エージェントのトークン | 使用中 |
| Agent Tracing | LLM呼び出しとtool実行の追跡 | AI SDK連携 | spanクォータ | 該当なし |
有効にするのはCrons
最初に有効にするのはCronsだ。このブログはGitHub Actionsで毎週月曜日にSearch Consoleのデータを収集しているが、ある週にそのジョブが静かに動かなかったら、エラーすら起きない。失敗ではなく期待した出来事の不在だからだ。Sentry CLIのCronsドキュメントどおり、sentry-cli monitors run --schedule "<expected schedule>" <monitor-slug> -- <command>の形で既存のコマンドを包めば開始と終了がcheck-inとして送られ、認証はプロジェクトのDSNで行う。料金のドキュメント上、すべてのプランにcron monitorが1個含まれ、追加分は有料プランのPAYG予算でしか購入できないが、この用途には1個で足りる。
Uptimeは対比がはっきりしている。外部からURLを定期的に叩く機能だが、デフォルトの判定は2xxなら合格なので、デフォルト設定では前で見た200応答の中の失敗を捉えられない。 Early Adopter向けのVerificationを使えばJSONボディまで検査できるが、このブログではそれでも難しい。失敗の大半は訪問者のリクエストではなくキャッシュ再検証の経路で起きており、統計APIのルートを呼ぶクライアントももうない。 サイトが丸ごと落ちる場合の補助手段としては意味があるが、このブログが実際に経験した障害とは層が違う。
GA呼び出しにはLogsとMetrics
GA呼び出しにはエラーイベントだけでは足りない理由がある。unstable_cacheが失敗結果まで1時間キャッシュするので、キャッシュの背後にある経路のエラーイベントは1時間に最大1件だ。イベント数を影響範囲として読むと、体系的に過小評価することになる。そして前の節で見たとおり、古いイベントは消えて分布を描き直せなかった。
SentryのNext.jsbreadcrumbドキュメントは冒頭から、手動のbreadcrumbの代わりにLogsを使うよう勧めている。Logsは2025年9月にGAとなり、fallbackが実行されるたびに経過時間と一緒に残すのに向いている。分布そのものが目的なら、2026年5月にGAとなったApplication Metricsのほうが直接的だ。span metricsのドキュメントも、traceのサンプリングに影響されない集計はApplication Metricsへと案内している。custom spanは一つのリクエスト内の区間を見るには良いが、10%の標本なのでまれな失敗を逃す。三つともまだ有効にしておらず、有効にするならMetricsの分布から見るつもりだ。
アラートも同じ理由で件数にはかけない。1時間に最大1件まで押さえ込まれたイベントに「N件以上」の閾値をかけると、影響範囲を過小評価したまま静かになる。だからこのブログの判定は発生の有無だ。Rob EwaschukのMy Philosophy on Alertingは、原因よりもユーザーが経験する症状にアラートをかけるよう勧めているが、その原則は症状がどこかに現れるという前提の上にある。このブログの失敗は200応答と0という数字に隠れるので、fallbackが実行されたこと自体を計測して初めて、アラートをかけられる症状になる。
ブラウザSDKが前提の機能
Session ReplayとUser FeedbackはブラウザSDKを前提とする。このブログはそのSDKを置かないと決めたので、今の判定は「有効にしない」で、バンドルコストの根拠は第2回で扱う。ブラウザprofilingもSDKが必要なうえにbetaで、条件がいくつも付くが、その条件が実際に何を見せてくれるのかは第3回で検討する。
実行しなかった機能
Seerは料金ドキュメントによると、サブスクリプションに加えてアクティブコントリビューターあたり月$40を払う有料アドオンだ。今回、9月11日に開いたNext.js内部のInvariantErrorイシュー(JIHOON-BLOG-A)にかけてみるか検討したが、サブスクリプションが必要な機能なので実行しなかった。このアカウントの契約状況は確認していない。だからこの記事にはSeerの一次経験がない。Agent Tracingは2026年9月11日にGAとなった。モデルの記憶や古い記事に頼るとbetaと誤って書きやすい項目だが、このブログにはLLM呼び出しの経路がないので該当しない。
AIが減らしたものと減らせなかったもの
今回の作業でAIが減らしてくれたコストは明確だ。散らばったドキュメントから条件を集める作業(ブラウザprofilingがbetaかどうか、ヘッダー、ブラウザの制限)、クエリ文法を覚えてgroup byを変えていく作業、breadcrumbの時刻を引いたり足したりする計算、機能表の下書きが、すべて数回のやり取りで終わった。たとえばbreadcrumbのタイムラインはget_issue_breadcrumbsの1回、モニターが0個という事実はfind_monitorsとfind_uptime_monitorsの2回の呼び出しで確認した。探索の敷居が下がったことで、「有効にするかどうか」を判断する前に「今のデータが何を語っているか」をまず問う順序が可能になった。
減らせなかったものも同じくらい明確だ。
- 保存されなかったデータ。 144件のうち134件(9月16日14:26 UTC時点)は消え、標本から漏れたspanは最初から存在しない。エージェントは存在しないデータを復元できない。
- デプロイが必要な実験。 gRPC呼び出しがspanとして捕捉されるか、凍結とイベントループ占有を切り分けられるかは、実際に計測を入れてデプロイしなければわからない。
- 解釈の条件。 外挿値の警告も、ローカルのイベントがproductionとして記録された事実も、応答には表示されなかった。気づいたのは、イベントのURLとサーバー名を自分で読んだからだ。
- 日付とツールの時差。 Agent Tracingのように5日前に状態が変わった機能は、changelogを開いて確認する必要があった。MCPツールもプロダクトを追いかけている途中だ。イシュー検索に
ORを入れると400が返り、アラートルール照会ツールは410This API no longer existsを返した。 - 何を失敗とみなすか。 200応答と0という統計を失敗と定義し、計測ポイントを下に下ろした判断が先にあったからこそ、開き直すイベントがそもそも残っていた。
おわりに
まとめると、筆者がSentryの機能の大半を有効にしていなかった理由は、知らなかったからではなく確認にかかるコストのせいだった。AIはそのコストを大きく下げ、そのおかげで機能を有効にする前にこのアカウントのデータにまず問う順序に変わった。そうして開き直したデータは、新しい機能より先にいくつかの不都合な事実を見せてくれた。直したと信じていた障害は直すことなく止まっただけで、当時の分布は保持期間を過ぎて描き直せず、筆者のローカル検証はproductionのイシューに紛れ込んでいた。
だからこのブログの次の手順は、機能リストではなく空白から決まった。週次の収集にはCronsを付け、GA呼び出しには保持期間とサンプリングに揺さぶられにくいシグナルを選び、ローカルの環境名から正すことだ。この記事を読んでいる皆さんも、長く使ってきたツールの有効にしていない機能を思い浮かべてみてほしい。その機能が本当に不要だったのか、それとも確認するコストが高かっただけなのかを、今ではデータに直接聞くことができる。
次の記事では、このブログが置かないと決めたブラウザSDKの場所に移り、ブラウザの可観測性で訪問者の画面の中で起きることをどう見るかを扱う。