Onde colocar o ErrorBoundary
Neste post quero falar sobre onde receber os erros que chegam. Em Propagação de erros lancei o mesmo erro de sete lugares e contei onde cada um aterrissava. Este post trata de colocar um receptor em cada um desses destinos.
Quando você conhece os caminhos de propagação, a próxima pergunta vem sozinha. Quantos ErrorBoundary colocar e onde? Se um basta, se é preciso um por tela, e se o que a biblioteca oferece se sobrepõe ao que você mesmo escreveu, tudo se decide aqui.
Começo pela conclusão: o número de ErrorBoundary não é questão de gosto, duas coisas decidem. O que lança e o que precisa sobrar na tela quando aquilo morre. O primeiro foi tratado na parte 1, então este post começa pelo segundo.
O alcance que você pode ceder
Quando alguém pergunta onde colocar um ErrorBoundary, costuma pensar em qual componente envolver. Essa pergunta não tem resposta. Sempre existem vários componentes que você poderia envolver, e o código roda qualquer que seja a escolha.
É preciso perguntar de outro jeito. Se isto morrer, o que precisa sobrar na tela?
A resposta muda conforme o lugar. Se falta o dado que forma o esqueleto de uma tela, aquela tela não se sustenta. Um botão de ação sozinho, sem nome nem status ao lado, não significa nada. Ao contrário, se uma lista secundária falha e você cobre a tela inteira, o usuário perde tudo o mais que conseguiria ver sem problema. Ações difíceis de desfazer são outra coisa. É preciso avisar da falha no mesmo lugar em que se clicou.
O que um ErrorBoundary faz não é capturar a falha, e sim decidir a área sobre a qual o fallback é desenhado. O fallback é o que você desenha no lugar da tela original quando algo falha. Some tudo o que você envolveu. Por isso a posição de um ErrorBoundary não é decidida pelo que você quer capturar, mas pelo alcance que você pode ceder.
Esse alcance se divide em quatro níveis.
| Camada | O que recebe | Com o que se desfaz |
|---|---|---|
| Rota | o que o loader lançou, o que ninguém capturou abaixo | revalidate() |
| Tela | o que foi lançado durante o render | resetErrorBoundary() |
| Região | o que foi lançado dentro dela | resetErrorBoundary() |
| Dentro do componente | um useQuery que falhou, uma mutation que falhou |
refetch(), um toast |
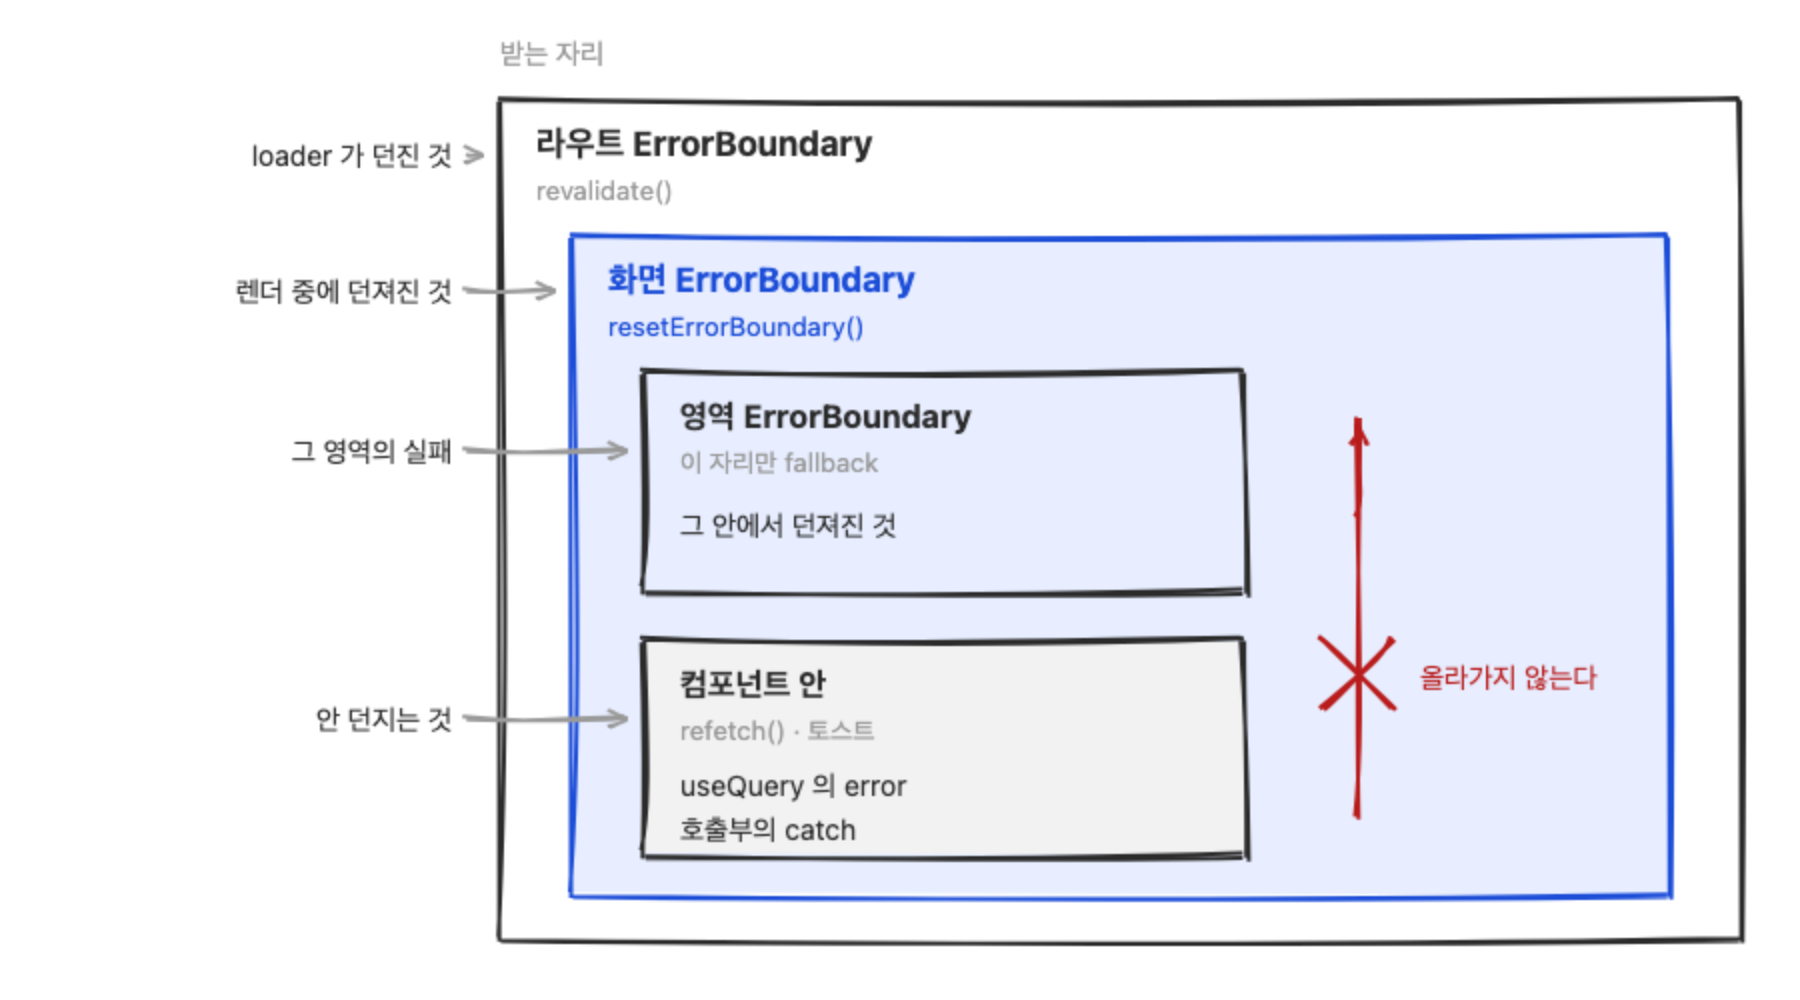
São quatro nomes, mas só dois tipos. Só o ErrorBoundary de rota é do router; os outros dois são o ErrorBoundary que você coloca na árvore. O ErrorBoundary de tela e o ErrorBoundary de região são o mesmo componente e só muda onde está preso. A linha de baixo, dentro do componente, não é um ErrorBoundary, e sim um ramo que o próprio componente desenha.
As seções a seguir mostram por que você não pode apagar nenhuma linha desta tabela.
Três camadas que você não pode apagar
Depois de instalar react-error-boundary, o lado do router parece apagável. Como os nomes coincidem, os trabalhos também parecem coincidir. Mas há três razões para não apagar nenhum deles. As três que conto aqui são rota, tela e região da tabela acima. Dentro do componente fica de fora porque não é um ErrorBoundary.
O loader vive fora do ErrorBoundary
É exatamente o que vimos na parte 1. Um ErrorBoundary é uma classe construída com getDerivedStateFromError e componentDidCatch, então só chega até ele o que o React capturou dentro da árvore. O loader é uma função que roda fora da árvore, antes de o render começar. O que ele lança não passa pelo React, então por mais que você envolva, não aparece.
Por isso, se ao menos uma rota usa loader, você não pode apagar o ErrorBoundary de rota. No momento em que apaga, aquela falha fica sem lugar para onde ir.
O cache que o revalidate não consegue limpar
A direção contrária também está fechada. O mecanismo de recuperação do ErrorBoundary de rota é revalidate(), e isso só roda o loader de novo: não toca no cache de queries.
Pense em uma rota sem loader. Se um useSuspenseQuery dentro da tela falha, no fim o ErrorBoundary de rota até recebe. O router envolve a árvore de rotas em uma classe própria chamada RenderErrorBoundary, e essa classe também tem getDerivedStateFromError. Mas apertar tentar de novo naquele ErrorBoundary não adianta nada: não há loader para rodar de novo e o erro cravado no cache continua lá. Recebeu, mas não tem com o que desfazer.
Receber e desfazer são trabalhos diferentes. Se você não olhar os dois ao posicionar um ErrorBoundary, acaba com um fallback que recebe coisas que ninguém consegue limpar.
O ErrorBoundary de baixo estreita o alcance
O terceiro não é ficar bloqueado, é perder demais.
Quando algo falha, o router escolhe um ErrorBoundary. Como ele escolhe está no código.
function findNearestBoundary(matches, routeId) {
  let eligibleMatches = routeId ? matches.slice(0, matches.findIndex((m) => m.route.id === routeId) + 1) : [...matches];
  return eligibleMatches.reverse().find((m) => m.route.hasErrorBoundary === true) || matches[0];
}
Ele percorre as rotas correspondentes de trás para frente, escolhe a primeira que tenha ErrorBoundary e, se não houver nenhuma, manda para a primeira de todas. Se o filho de uma rota aninhada não tem ErrorBoundary, esse papel fica com o pai, e se o pai também não tem, fica com a raiz.
Quando fica com a raiz, a tela inteira some. Só uma região interna falhou, mas o cabeçalho e a navegação vão junto. Prenda um ErrorBoundary na rota filha e o fallback é desenhado só no lugar do <Outlet />.
Por isso colocar mais um ErrorBoundary abaixo não é duplicar. Não é capturar a mesma falha duas vezes: é mudar até onde se apaga. Um arranjo que parece três limites sobrepostos é, na verdade, três coisas diferentes recebidas com três alcances diferentes.
Entre o ErrorBoundary de região e dentro do componente
Depois de dividir em quatro camadas, sobra uma última bifurcação. Para uma região sem a qual a tela se sustenta, você escolhe entre subi-la para um ErrorBoundary ou receber ali mesmo.
De qualquer um dos dois jeitos você perde só aquela região e mantém o resto. O que muda não é quanto você perde, e sim o que você desenha ali no lugar.
Subir para um ErrorBoundary reduz o código. Se você chama useSuspenseQuery dentro, aquele componente não tem nem isPending nem isError. A espera fica com o Suspense de fora e a falha com o ErrorBoundary de fora. O componente desenha só o caso em que há dados.
<section>
  <h2>댓글</h2>
  <QueryAsyncBoundary pendingFallback={<p>불러오는 중</p>}>
    <CommentList postId={postId} />
  </QueryAsyncBoundary>
</section>
Em troca, aquela região inteira vira o fallback. Num lugar como uma lista, onde não sobra nada que valha guardar se ela some inteira, não há prejuízo.
Receber ali mesmo é o contrário. Você chama useQuery e desenha os quatro estados (espera, falha, resultado vazio, resultado) por conta própria. Os ramos se multiplicam, mas em troca você pode colocar textos e ações ajustados àquele lugar. Se quiser um botãozinho de tentar de novo só na linha que falhou, é por aqui. Se subir para um ErrorBoundary, o formato daquela linha passa a ser decidido pelo componente de fallback, que em geral é o compartilhado com o ErrorBoundary de tela e fica pesado demais para a falha de uma linha só.
O critério fica assim. Se a região pode sumir inteira, ErrorBoundary é melhor; se são necessários textos ou ações ajustados àquele lugar, useQuery é melhor. O ErrorBoundary tira os ramos do seu componente, mas leva junto a liberdade de decidir a tela.
Se você decidir não subir para um ErrorBoundary, precisa tratar os quatro estados.
const { data, isPending, isError, refetch, isRefetching } = useQuery(commentsOptions(postId))

if (isPending) return <p>불러오는 중</p>

if (isError) {
  return (
    <div role="alert">
      <p>댓글을 불러오지 못했어요</p>
      <button onClick={() => refetch()} disabled={isRefetching}>재시도</button>
    </div>
  )
}

if (data.length === 0) return <p>아직 댓글이 없어요</p>
Se esquecer o isError, a falha escorre em silêncio para o estado vazio. O data de uma query que falhou é undefined, e uma checagem como data == null || data.length === 0 não distingue esse undefined de um array vazio. Na tela aparece que ainda não há comentários enquanto o servidor devolve um 500 naquele exato momento.
Se você filtrar isError primeiro, abaixo disso data se estreita para um array e a checagem == null desaparece.
Um fallback diferente por camada
Com as camadas colocadas, é hora de decidir o que cada uma desenha na tela. Aqui o ErrorBoundary de rota e o ErrorBoundary que você coloca na árvore se separam de novo, e o critério de escolha não é gosto, e sim como aquela camada recebe o erro.
O ErrorBoundary de rota lê sozinho
O ErrorBoundary de rota não precisa que o erro seja passado ao fallback. O componente lê direto com useRouteError() e busca o mecanismo de recuperação por conta própria.
export function RootErrorBoundary() {
  const error = useRouteError()
  const { revalidate, state } = useRevalidator()

  return <ErrorFallback error={error} onRetry={revalidate} retrying={state === 'loading'} />
}
Então na rota basta encaixar o componente. O ErrorBoundary de uma rota filha tem o mesmo formato e usa os mesmos hooks. O que separa os dois não é o código, e sim a rota em que estão presos. Em qual rota foi preso é exatamente o alcance sobre o qual o fallback é desenhado.
O ErrorBoundary que repassa
Em react-error-boundary, o ErrorBoundary é o contrário. Como ele mesmo segura o erro e a função de reset, precisa repassá-los ao fallback. Por isso existem três props, e a definição de tipos amarra as três como mutuamente exclusivas.
fallback recebe um elemento pronto como está. Escreve-se assim: fallback={<p role="alert">댓글을 불러오지 못했어요</p>}. Não te dá nem o erro nem a função de reset. Só serve quando a mensagem é fixa e também não há como tentar de novo.
FallbackComponent recebe um componente e passa error e resetErrorBoundary como props. Fica limpo quando vários ErrorBoundary compartilham o mesmo fallback, mas o nome da prop é fixo como resetErrorBoundary, então quem recebe precisa conhecer esse nome.
function CommentsFallback({ error, resetErrorBoundary }: FallbackProps) {
  return <ErrorFallback error={error} onRetry={resetErrorBoundary} />
}

<ErrorBoundary onReset={reset} FallbackComponent={CommentsFallback}>
  <CommentList postId={postId} />
</ErrorBoundary>
ErrorFallback recebe onRetry, então os nomes não batem. Isso custa mais um componente cujo único trabalho é mover o nome de um lado para o outro.
fallbackRender recebe uma função e renderiza ali mesmo.
<ErrorBoundary
  onReset={reset}
  fallbackRender={({ error, resetErrorBoundary }) => (
    <ErrorFallback error={error} onRetry={resetErrorBoundary} />
  )}
>
Eu escolhi este. A razão é que dá para trocar o nome ali mesmo. Acima, resetErrorBoundary virou onRetry. Graças a isso, ErrorFallback vira um componente que conhece apenas error e onRetry, e revalidate como mecanismo do ErrorBoundary de rota e resetErrorBoundary como mecanismo do ErrorBoundary da árvore: os dois usam o mesmo fallback.
Duas camadas cujas telas não se desalinham é o que essa escolha compra. Se você divide em quatro camadas, as telas de falha que o usuário vê correm o risco de virar quatro também, e trocar um nome uma vez faz delas uma só.
Três casos em que tentar de novo não funciona
Coloquei um botão de tentar de novo no fallback. É aquele botão que o usuário aperta para desfazer uma falha. Vamos apertar. Não funciona. A mesma tela volta igual.
Isso aparece por três razões e cada uma se resolve de um jeito. Elas têm uma coisa em comum. Um ErrorBoundary só desfaz o próprio estado. O estado que quem lançou está segurando tem que ser limpo por quem lançou.
O erro de query que o reset limpa
Tudo o que resetErrorBoundary() faz é voltar a flag interna do ErrorBoundary. Os children remontam e a query volta a ser assinada. Mas aquela query está cravada no cache em estado de erro. Então ela lança imediatamente o mesmo erro de novo e o ErrorBoundary desenha o fallback de novo.
Por que ela usa o erro antigo em vez de refazer a requisição também está no código. errorBoundaryUtils.js tranca assim.
if (options.suspense || throwOnError) {
  if (!errorResetBoundary.isReset()) options.retryOnMount = false;
}
É preciso ler primeiro a guarda de fora. Essa trava só pega nas queries que lançam. Uma query com suspense, ou com throwOnError ligado, que monte sem a marca de reset fica com o retry desligado. Um useQuery que não lança não se aplica e, ao remontar, simplesmente refaz a requisição.
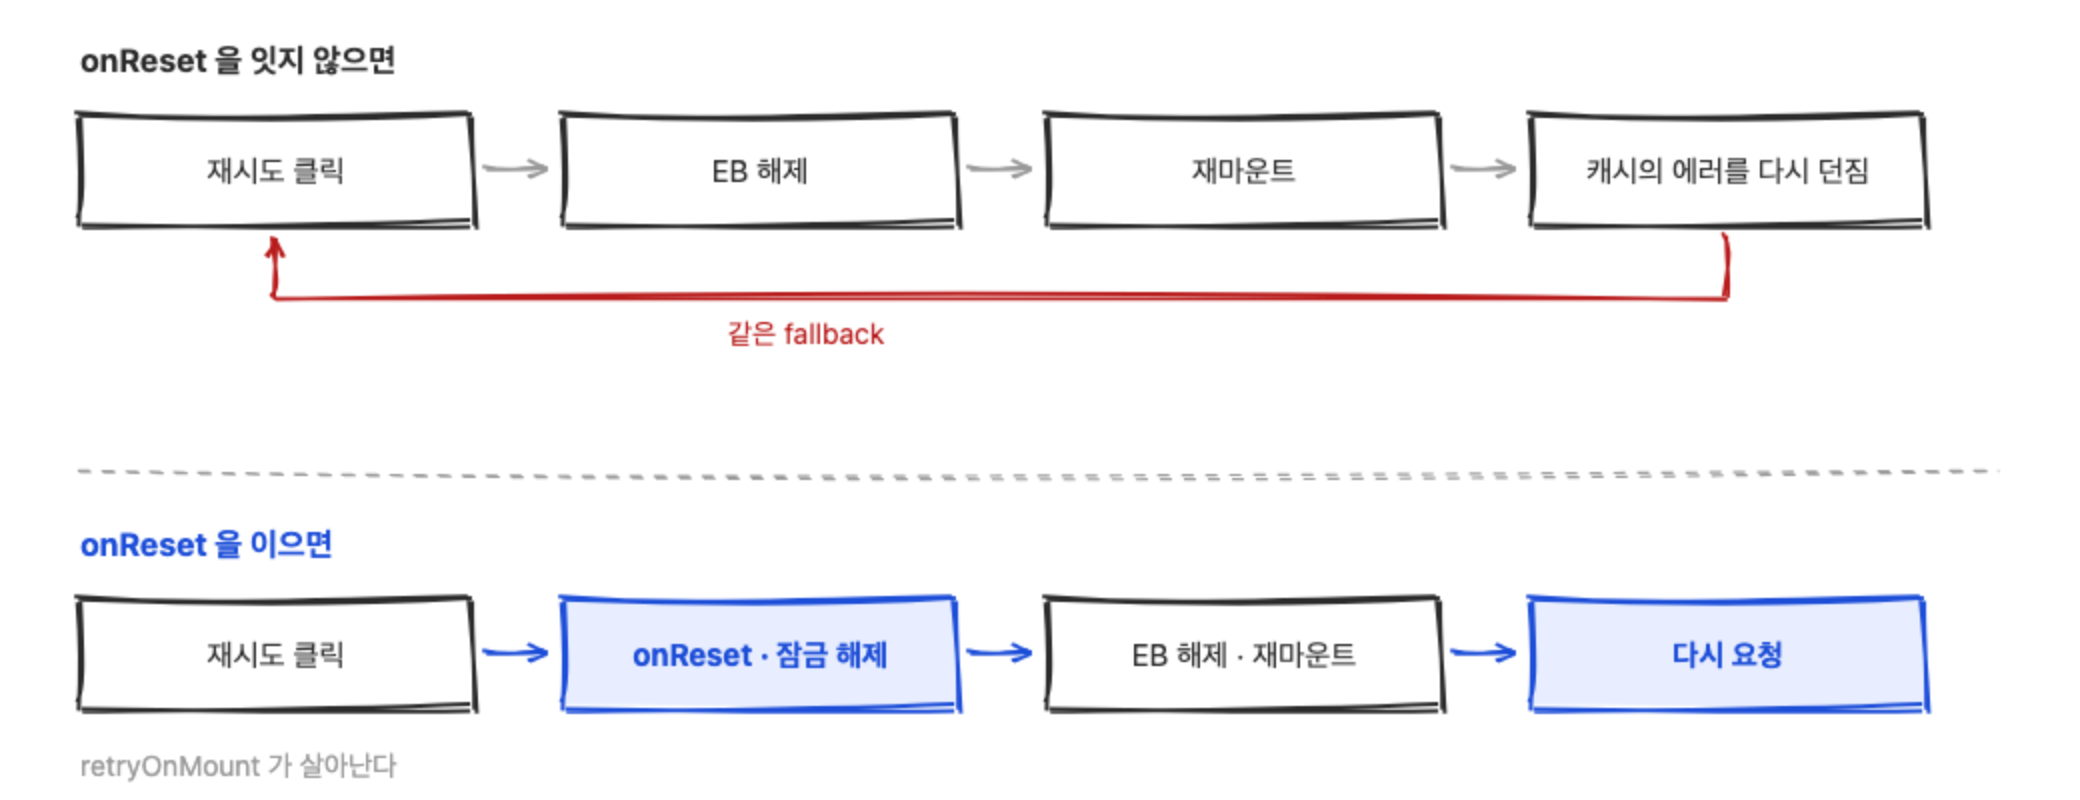
O que é travado é só a query subida para um ErrorBoundary, e por isso os dois estados precisam ser limpos juntos. Quem levanta essa marca é QueryErrorResetBoundary. Abrindo o código, o estado é um único booleano.
reset: () => {
	isReset = true;
},
Basta ligar este reset ao ErrorBoundary, no seu onReset. A documentação do TanStack Query e os comentários do código trazem a mesma ligação como exemplo.
export function QueryAsyncBoundary({ children, pendingFallback }: Props) {
  return (
    <QueryErrorResetBoundary>
      {({ reset }) => (
        <ErrorBoundary
          onReset={reset}
          fallbackRender={({ error, resetErrorBoundary }) => (
            <ErrorFallback error={error} onRetry={resetErrorBoundary} />
          )}
        >
          <Suspense fallback={pendingFallback}>{children}</Suspense>
        </ErrorBoundary>
      )}
    </QueryErrorResetBoundary>
  )
}
A ordem importa. E essa ordem é garantida por react-error-boundary. É um arquivo compilado, então os nomes ficaram com uma letra só, mas a estrutura continua legível.
resetErrorBoundary(...e) {
  const { didCatch: t } = this.state;
  t && (this.props.onReset?.({ args: e, reason: "imperative-api" }), this.setState(d));
}
Estão unidos pelo operador vírgula, então onReset roda primeiro e setState vem depois. d é o estado inicial com didCatch em false. Por isso os children remontam depois que a trava do cache foi solta. Uma linha de diferença é o que transforma o tentar de novo em um tentar de novo de verdade.
Colocar Query no nome também é proposital. Se você chamar de AsyncBoundary, lê-se como se servisse para qualquer assincronia, e não serve, porque tem um QueryErrorResetBoundary dentro. Pela mesma razão não dei valor padrão a pendingFallback. Com um valor padrão, olhando só a linha da chamada você não sabe o que está sendo colocado embaixo.
O erro de render que o reset não consegue limpar
O segundo é o caso que vimos na parte 1. O servidor devolve um 200 com um formato diferente do esperado e o render que o lê lança um TypeError. O mesmo ErrorBoundary recebeu e o onReset está ligado, mas tentar de novo não funciona.
O que reset limpa é uma query em estado de erro. Mas essa query teve sucesso. O servidor deu um 200 e o cache guarda aquele valor como dado normal. Quem produziu o erro foi o render que o leu. Então reset não tem o que limpar, e o componente remontado recebe o mesmo cache, com o staleTime ainda válido, e lança de novo na mesma linha.
O lugar de corrigir é queryFn.
queryFn: async () => {
  const data = await getComments(postId)
  if (!Array.isArray(data.comments)) {
    throw new TypeError('comments 가 배열이 아니다')
  }
  return data.comments
},
Na parte 1 eu disse que o lugar onde os tipos terminam é o lugar de colocar uma checagem em tempo de execução. Esse lugar é aqui. Se você sobe essa checagem para queryFn, a mesma falha vira o erro da query. Fica no cache em estado de erro, reset limpa e o tentar de novo refaz a requisição.
Se você adiar a checagem em tempo de execução porque o ErrorBoundary recebe de qualquer jeito, acaba com um fallback que recebe mas não consegue desfazer.
O lazy que só um recarregamento resolve
O terceiro é uma falha ao carregar um chunk. Desta vez nem reset nem queryFn têm a ver. Quem segura o estado é o próprio lazy.
Como vimos na parte 1, o lazyInitializer do React anota a rejeição no payload e, daí em diante, lança sempre a mesma coisa.
throw payload._result;Ele não faz import() de novo. A chamada de lazy() aconteceu uma vez no topo do módulo, e aquele payload fica como está enquanto o app viver. Mesmo soltando o ErrorBoundary e remontando, o mesmo erro volta.
Por isso recuperar-se dessa falha é baixar a página de novo. Também significa que uma versão nova foi publicada, então é melhor dizer isso ao usuário.
Colocando os três casos lado a lado, um único botão de tentar de novo precisa fazer três trabalhos diferentes. O erro de query se resolve com reset, o erro de render transformando-o antes em erro de query no queryFn, e a falha de chunk com um recarregamento. O ErrorBoundary não faz nenhum dos três por você.
Falhas em que não se coloca tentar de novo
Separadas as falhas recuperáveis das que não são, o botão também precisa ser separado.
Mostrar o mesmo botão em toda falha é orientar o usuário a uma ação que ele não pode fazer. Apertar tentar de novo num 404 traz o mesmo 404. Um 403 por falta de permissão é igual. A falha ao carregar um chunk simplesmente não funciona, pela razão vista na seção anterior.
Basta separar uma vez dentro do fallback compartilhado.
function describe(error: unknown) {
  if (isChunkLoadError(error)) {
    return { title: '새 버전이 배포됐어요', description: '새로 고침하면 이어서 볼 수 있어요.', action: 'reload' }
  }

  const status = isHttpError(error) ? error.status : isRouteErrorResponse(error) ? error.status : undefined

  if (status === 404) {
    return { title: '찾을 수 없어요', description: '주소가 바뀌었거나 삭제된 항목이에요.', action: null }
  }
  if (status !== undefined && status >= 400 && status < 500) {
    return { title: '요청을 처리할 수 없어요', description: '입력한 내용을 다시 확인해 주세요.', action: null }
  }
  return { title: '불러오지 못했어요', description: '잠시 후 다시 시도해 주세요.', action: 'retry' }
}
Há uma razão para isRouteErrorResponse estar aqui também. Como o ErrorBoundary de rota e o ErrorBoundary da árvore compartilham o fallback, esta função recebe os dois tipos de erro. Ler o código de status de um Response que o router lançou e lê-lo de um erro HTTP que você mesmo construiu funcionam de formas diferentes, então ela olha os dois.
Não é preciso montar uma ramificação enorme desde o início. Basta separar as falhas que dão outro resultado ao serem apertadas de novo das que não dão.
Quando o ErrorBoundary vê a falha
Todos os ErrorBoundary colocados, e ainda falta um. Quando o ErrorBoundary enxerga?
As camadas foram decididas de cima para baixo, mas a ordem de execução é o contrário. O ErrorBoundary só vê alguma coisa depois que todas as tentativas se esgotaram. Por isso a condição de retry é parte do design do ErrorBoundary.
O valor padrão muda conforme o lugar. Os dois usam o mesmo createRetryer, mas passam valores diferentes. A query não passa nada, então recebe o padrão de retryer.js.
const retry = config.retry ?? (isServer() ? 0 : 3);A mutation coloca 0 diretamente em mutation.js.
retry: this.options.retry ?? 0,A mutation em 0 significa que, assim que uma requisição termina em erro, aquela ação falha na hora. Não ter retry em ações difíceis de desfazer é um padrão seguro, mas se a ação for idempotente, mandar mais uma vez é melhor para o usuário.
É melhor declarar a mesma condição dos dois lados.
const MAX_RETRY = 2

export function retryOnServerError(failureCount: number, error: unknown): boolean {
  if (failureCount >= MAX_RETRY) return false
  return !isHttpError(error) || error.status >= 500
}
failureCount começa em 0 e pergunta com 0 na primeira falha. Então com MAX_RETRY em 2 ele manda três requisições no total e para. É a contagem de retries, não a de tentativas.
Deixar os 4xx de fora é o ponto central. A requisição em si está errada, então por mais vezes que você mande volta a mesma resposta. Mas o motivo de deixá-los de fora não é só desperdício: o atraso padrão cresce de forma exponencial.
function defaultRetryDelay(failureCount) {
	return Math.min(1e3 * 2 ** failureCount, 3e4);
}
O primeiro retry é 1 segundo e o seguinte é 2, então só dois retries já consomem 3 segundos. Se você não filtrar os 4xx, está escondendo por 3 segundos uma falha que não tem conserto.
Erros de render e falhas de chunk não têm esse tempo. Como nenhuma requisição sai, não há retry algum, e o ErrorBoundary vê no momento em que é lançado. É por isso que o mesmo fallback aparece 3 segundos depois em algumas falhas e na hora em outras.
Há uma premissa a confirmar antes de ligar os retries. Aquela requisição é idempotente? Mandar a mesma requisição duas vezes tem que dar o mesmo resultado. Se o servidor não garante isso, retry é um recurso que fabrica bugs.
Encerrando
Na parte 1 tratei de para onde os erros vão, e neste post decidi o que colocar nesses lugares. Resumindo:
- A posição de um
ErrorBoundaryé decidida pelo alcance que você pode ceder. Você pergunta não o que envolver, mas o que precisa sobrar quando isto morre. - Você não pode apagar nenhuma das três camadas de
ErrorBoundary. O que o loader lançou não chega aoErrorBoundaryda árvore,revalidatenão limpa o cache de queries, e colocar mais um abaixo é estreitar o alcance. - Se a região pode ser jogada fora inteira,
ErrorBoundary; se são necessários textos próprios daquele lugar,useQuery. Escolhendo o segundo, você precisa tratar os quatro estados. - Trocando o nome com
fallbackRender, o fallback fica um só mesmo com camadas diferentes. - Tentar de novo só funciona se você limpar o estado que quem lançou está segurando. A query é
reset, o erro de render sobe paraqueryFn, e o chunk é um recarregamento. - Quando o
ErrorBoundaryvê a falha é decidido pela condição de retry. Se você não filtrar os 4xx, esconde por alguns segundos uma falha sem conserto.
Dá para perguntar se um ErrorBoundary e um toast não bastam. Para um produto de duas ou três telas isso soa razoável e, de fato, o número de camadas é decidido pelo produto. Se há uma tela só, só há uma tela a ceder, então as diferenças de alcance não aparecem. Quanto mais regiões independentes houver dentro de uma tela, maior fica essa diferença.
Ainda assim, algo sobra independentemente do número. Por mais ErrorBoundary que você ponha na árvore, o que o loader lançou não vai para lá, e tentar de novo não funciona sem limpar o estado que quem lançou está segurando. O que dá para reduzir são as camadas, não esses fatos.