重新打开 Sentry
这篇文章想聊聊重新打开用了很久的 Sentry 这件事。
我在公司长期负责基于 Sentry 的错误监控。issue 一来,打开 stack trace,用 release 和标签缩小范围,找出复现条件,这些工作早已驾轻就熟。可回头一看,我用到的功能始终停留在这一圈里。Logs、Crons、Uptime、custom span、profiling,我明知道它们存在,却从没开启过。
原因不在知识,而在探索成本。要确认某个功能是否适合自己的问题,就得把零散的文档对照着读,设计实验,接好 config,再解读结果。在忙于处理 issue 的日子里,没有理由去付这笔成本。最近我在 Claude Code 里接上 Sentry MCP 使用后,这笔成本降下了相当一部分,我的顺序也变了。现在在开启某个功能之前,我会先去问这个账号里的真实数据。
本文是四篇观测系列的第一篇。先追踪这个博客的服务端埋点捕获到的一次故障,然后用 MCP 重新打开那些数据,记下新看到的东西,再逐项判定各个功能该用在哪里。这个系列从服务端出发,经过浏览器内的渲染、CPU 和内存,最后走到搜索数据。
成功响应里的失败
这个博客的 Sentry 是 2026 年 8 月以纯服务端方式接入的。去掉浏览器 SDK 的判断放在第 2 篇讨论,这里只看我想在服务端捕获什么。目的只有一个。服务端调用 Google Analytics Data API 来绘制访客统计,但那个调用即使失败,我也无从得知。
起初我以为在统计 API 路由的 catch 里加上上报就够了。可是在本地生产构建里放入错误的服务账号密钥让它失败后,错误根本没有冒到路由层。下面一层统计模块的 catch 先把它接住并返回了默认值,响应是这样的。
HTTP 200 OK
{ "slug": "/260610", "views": 0 }
访客看到的统计是 0,服务端却回答一切正常。从路由的错误率看,什么都没发生。Microsoft Research 与 Microsoft Azure 的研究人员在 HotOS 2017 上发表的 Gray Failure 论文这样界定这种状态的核心。
我们还认为,gray failure 的一个关键特征是 differential observability,即即使应用程序正受到问题影响,系统的故障检测器也可能察觉不到。
We also argue that a key feature of gray failure is differential observability: that the system's failure detectors may not notice problems even when applications are afflicted by them.
于是我把埋点位置从路由下移到统计模块的 4 处 catch。fallback 本身是保护访客体验的正确选择,所以原样保留,只把 fallback 被执行这一事实单独上报。当时用来区分这 4 处的标签只有一个 gaQuery。
// 2026-08 당시
Sentry.captureException(error, { tags: { gaQuery: 'stats' } })
现在的代码是 8 月 17 日的提交 f348d4c 改成的样子:把上报收拢到 captureServerException 一处,并为了不让基数膨胀,把标签键限制为 locale、routeKind、operation 三个。
// 현재 src/lib/google-analytics.ts
captureServerException(error, { routeKind: 'analytics', operation: 'stats' })
现在统计模块的上报点是 3 处 catch 加一条凭据缺失路径。(popular 路径出于后面会讲到的原因,已在 9 月删除)凭据路径不经过 catch,直接返回 fallback,而由于一段给今日访客数叠加 10~40 基准值的逻辑,界面上会显示一个看似合理的数字。即使环境变量整个丢失,人眼也看不出来,所以我让它每个进程只上报一次。
5 秒超时之后的 338 秒
埋点下移之后出现的生产 issue JIHOON-BLOG-2,是一次 GA 调用在 65.877 秒后以 DEADLINE_EXCEEDED 失败。响应依然是 200。原因在 GA 客户端库的配置文件里。runReport 的默认 RPC 超时是 timeout_millis: 60000,而我的代码在五个调用点中没有一处传入超时。Google SRE 的 Gráinne Sheerin 撰写的 gRPC 官方博客 deadline 文章开篇第一句就警告 "Always set a deadline",说的正是这个错误。
修复提交 927c85b 让所有调用都传入 5 秒。搭一个不响应的本地 TCP 服务器复现,结果与解释一致。
| 条件 | 耗时 | 错误信息 |
|---|---|---|
| 未指定超时 | 60.04 秒 | Deadline exceeded after 60.000s |
timeout: 5000 |
5.00 秒 | Deadline exceeded after 5.000s |
(5 这个数字没有依据。我没有测量 GA 正常响应的分布。只是在这个博客里访客数是附加信息,比起久等,尽快放弃的方向是对的)那个 issue 现在已经不出现在 issue 列表里了。65.877 秒这个值,是留在提交信息和仓库文档里的记录。
本该到此为止,可在部署了修复的 release 里,新的 issue JIHOON-BLOG-8 开始堆积。信息是 Deadline exceeded after 338.655s,stack 里也原样保留着 google-gax 的超时包装器。配置确实作用到了代码上,报告的时间却接近配置的 70 倍。
8 月 18 日前后,我抽取了当时最新的 100 条事件并画出分布。
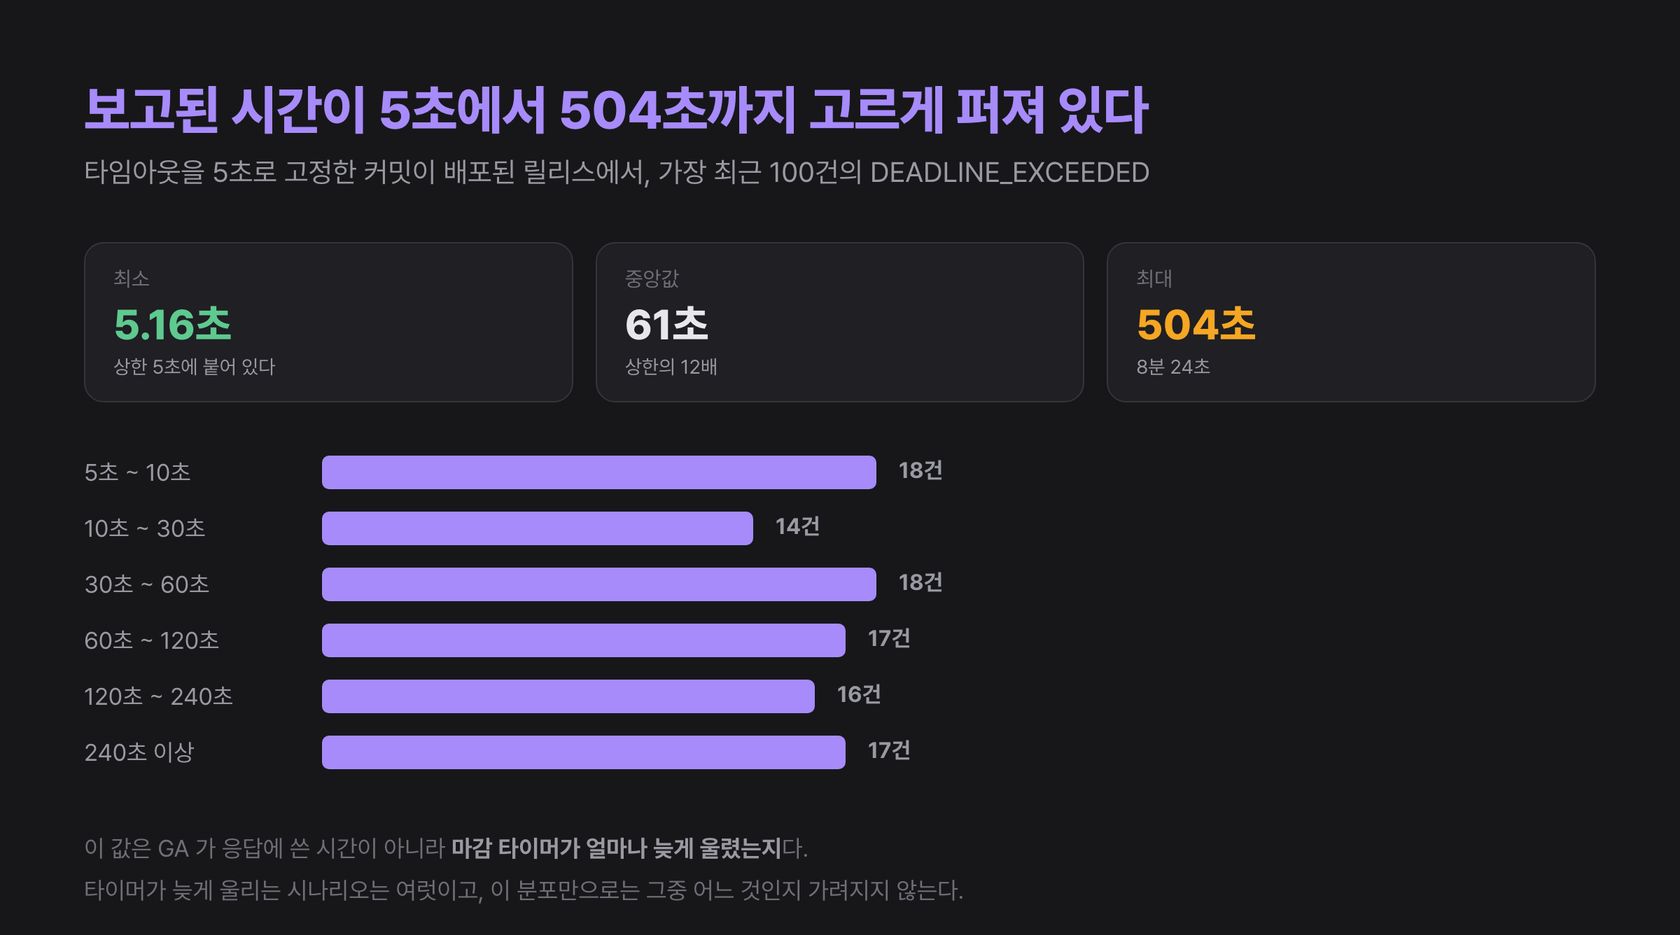
下限是 5.16 秒,紧贴配置值,中位数 61 秒,最大值 504 秒。数值没有集中在任何区间。(这张图现在已经无法重画。原因在下一节)标签只有 stats 和 popular 两个值,而且大多成对出现。两条路径的共同点是,它们都是一小时 unstable_cache 背后的重新验证路径。每次请求都调用 GA 的 page、pages 一次也没出现。
于是我提出一个假设。Serverless 函数在发出响应后,到下一次调用之前,执行环境可能会被冻结。如果这期间计时器也停住,醒来后才触发,那么记录下来的就不是实际等待的时间,而是连冻结时间也算进去的 wall-clock time(实际经过时间)。不过,分布与假设不矛盾,和分布支持假设是两回事。如果有繁重的任务一直占着事件循环,也会呈现同样的形状。
用 MCP 重新打开的数据
写这篇文章时,我在 2026 年 9 月 16 日用 Sentry MCP 重新查询了同一批数据。本意是确认自以为修好的东西现在是否仍然如此,结果以前要在仪表盘的 issue 页面之间来回翻找的内容,几轮对话就出来了。下面把查询确认的事实和由此得出的推论分开写。
发生为何停止
JIHOON-BLOG-8 的最后一次发生是 8 月 18 日 13:45 UTC,此后为 0 次。只看图表,问题似乎消失了,但我从未验证过假设,也没有修过。同一天,提交 417d3b4 在多语言改版中把访客统计和热门文章区域从首页移除了,调用 stats 和 popular 的界面恰恰就是这两个。9 月删除剩余热门文章路径的提交 5752e09,其提交信息把这写成"事件停止的直接原因是调用点消失,而不是 5 秒超时"。可是对齐时间就会发现,这个提交推送到 main 是在 22:07 UTC,比最后一次事件晚了 8 个多小时。剩下的事件一天只有 10 条左右,8 小时的空白本身并不反常,也和部署之后再无发生的事实不矛盾。不过,单凭时间无法断定删除调用点就是停止的原因,所以我只把那条提交信息当作最有力的解释来读。
issue 被 resolved 并不能证明原因已查明。发生次数归零有三条路:真的修好了,没人再走那条路径,或者埋点消失了。仅凭错误信号无法区分这三者。
breadcrumb 里留下的 5 分 39 秒
我用 MCP 取出了最后一条事件的breadcrumb。说起 breadcrumb,人们往往想到浏览器里的点击和导航记录,但这个博客的 Node 服务端 SDK 也在自动记录 http 请求和 console 输出。
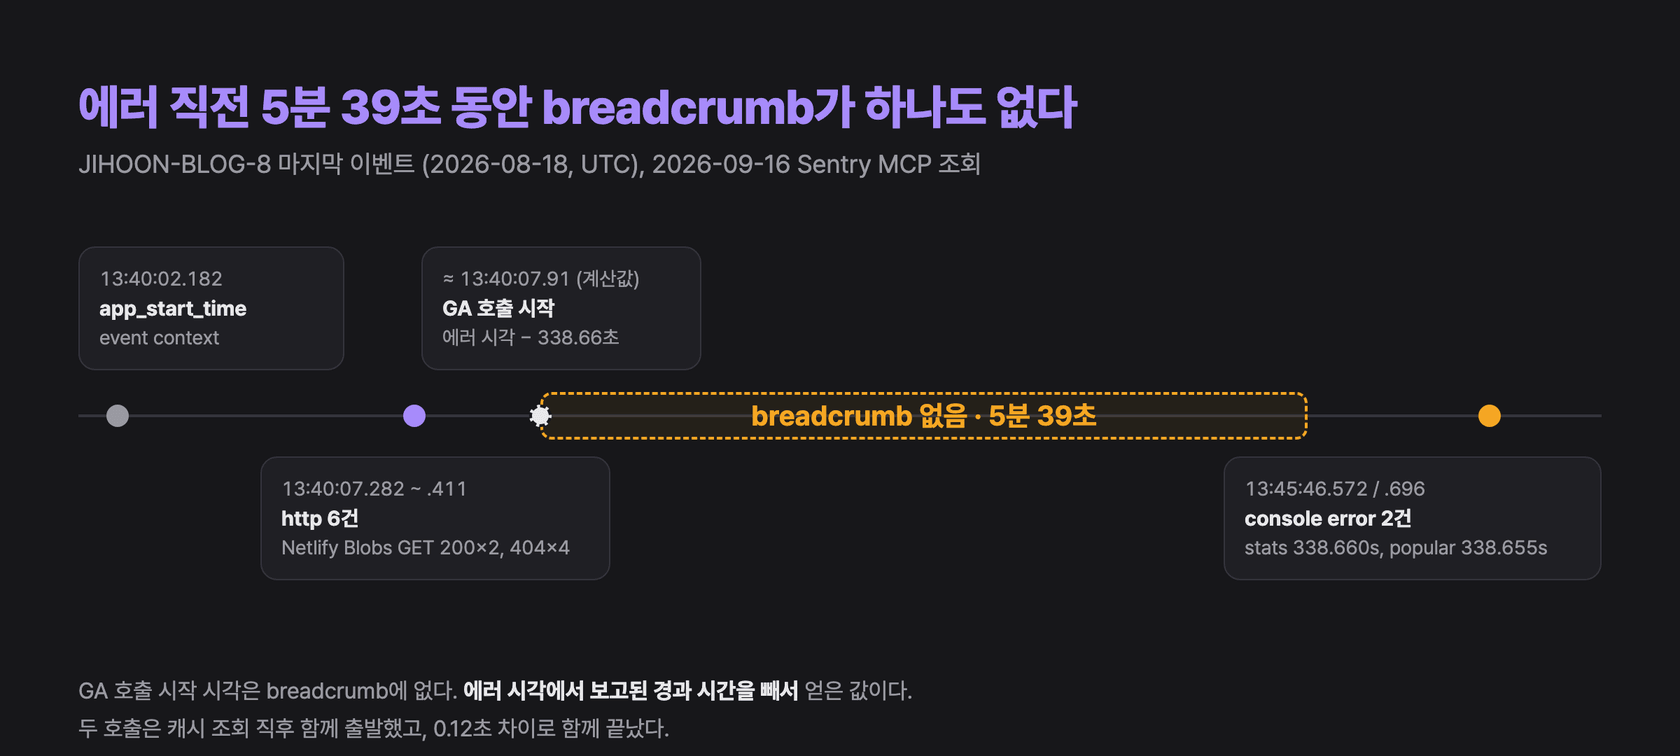
事实如下。函数在 13:40:02 启动,13:40:07 有 6 次 Netlify Blobs 缓存查询。下一条记录是 13:45:46 的两条 console error。用报告的 338.66 秒倒推,GA 调用是在缓存查询 0.5 秒后、冷启动约 6 秒后发出的。
从这里能得出的结论有限。本应在 5 秒后触发的计时器在 5 分 39 秒后才触发,其间这个请求没有留下任何记录。这与冻结假设不矛盾,但也排除不了事件循环被占用的假设。尽管如此,还是多了一条以前没有的信息:开始时间表明,这次失败是冷启动之后紧接着从缓存重新验证发出的调用。
被保留期抹掉的事件
JIHOON-BLOG-8 这个 issue 的发生计数器是 144。在 errors 数据集中按 90 天统计同一 issue,按 2026 年 9 月 16 日 14:26 UTC 的查询,只有 10 条。剩下的 10 条从 8 月 17 日 15:03 到 18 日 13:45 UTC,几乎恰好落在查询时间点往前 30 天之内。同一天 08:45 UTC 查询时还是 14 条,所以这个数字每查一次都会变少。
补充推论的话,事件保留期看起来是 30 天,所以旧事件被删除,只剩下 issue 计数器。Sentry 的定价页面写明免费方案 Developer 的查询范围是 30 天。不过,这个账号的方案类型以及计数器如何保留,我没有确认。能确定的是结果。上面那 100 条的分布再也抽不出来,没有存下来的数据,任何工具都无法恢复。
span 为 0 个的 trace
用同一事件的 trace_id 打开 trace,span 是 0 个。事件上记录着 client_sample_rate: 0.1。可能是在 10% 的采样中被漏掉,也可能是超过了 span 的保留期,究竟是哪一种无法判定。
把最近 30 天的 http.client span 按域名分组,也没有 GA API 的域名。大部分是 Netlify Blobs 查询。最有力的解释是那段时间 GA 调用本身几乎没有(首页的统计区域已经移除)。gRPC 调用是否会被自动埋点记录为 span,我还没有确认。顺带一提,这个统计里的 count() 是按采样率倒数加权的外推值,但 MCP 的响应里没有这条警告。不把这个数字当成请求数来读,仍然是人的职责。
混进 production 的本地验证
9 月 16 日新开的 JIHOON-BLOG-B 是 Google Analytics credentials missing: GA_PROPERTY_ID。打开事件一看,URL 是 http://localhost:3117/api/analytics,浏览器是 curl 8.7.1,服务器名是我的 MacBook。然而 environment 却是 production。
这是我按照仓库文档里的本地验证步骤(pnpm build 之后 pnpm start)操作时产生的事件。src/lib/sentry-options.ts 在没有 SENTRY_ENVIRONMENT 时,用 Netlify 的 CONTEXT 来决定环境。这是为了把 Deploy Preview 从生产环境中分离出来而做的机制,但在两者都没有的本地,它不会传入环境值,事件最终被记为 production。它挡住了预览,却没挡住本地。如果在这种状态下设置基于 production 的告警,我的实验就会触发告警。
所以我在仓库文档的验证命令里加上了 SENTRY_ENVIRONMENT=local。之所以没有在代码里改默认值,是因为我还没确认 Netlify 函数运行时里 CONTEXT 是否总是可见。如果不确认就把默认值设为 local,这回生产事件可能会藏进 local 里。
什么功能用在哪里
对于没开启的功能,我也用同样的方式先从数据确认。最近 30 天里 logs 0 条、profiles 0 条、replays 0 条、cron monitor 0 个、uptime monitor 0 个。与其读配置文件写"没开启",不如确认"是 0"。下表是在 2026 年 9 月 16 日对照官方文档和 changelog 重新确认后整理的各功能现状。
| 功能 | 回答的问题 | 前提 | 成本 | 本博客的判定 |
|---|---|---|---|---|
| Issues 与 grouping | 这些事件是同一起事故吗 | SDK、source map | 错误配额 | 使用中 |
| Crons | 定时任务按时运行了吗 | 发送 check-in | 含 1 个,额外的需付费方案 PAYG | 开启 |
| Uptime | 从外部访问 URL 是 2xx 吗 | 无 | 含 1 个,额外的需付费方案 PAYG | 作为辅助考虑 |
| Alerts | 什么时候该叫醒人 | 区分 environment | 无单独计费项 | 看是否发生,不设数量阈值 |
| Logs | fallback 何时执行了多少次 | SDK 配置 | 含 5GB | GA 调用候选 |
| Application Metrics | 不受采样影响的分布是怎样的 | 支持的 JS SDK 版本 | 含 5GB | GA 调用候选 |
| custom span | 请求里哪一段慢 | tracing | span 配额,10% 采样 | 候选 |
| Session Replay | 用户看到了什么 | 浏览器 SDK | bundle,replay 配额 | 不开启(第 2 篇) |
| User Feedback | 用户说哪里不对 | 浏览器 SDK | bundle | 不开启 |
| 浏览器 profiling | 哪个 JS 函数阻塞了主线程 | beta、Chromium、响应头 | UI profile 时长 | 第 3 篇判断 |
| Seer | 这个 issue 的原因和修复方案是什么 | GitHub/GitLab 集成 | 每位活跃贡献者 $40/月 | 未运行 |
| Sentry MCP | 如何在编辑器里查询数据 | OAuth 连接 | 智能体 token | 使用中 |
| Agent Tracing | 追踪 LLM 调用与 tool 执行 | AI SDK 集成 | span 配额 | 不适用 |
要开启的是 Crons
最先要开启的是 Crons。这个博客每周一用 GitHub Actions 采集 Search Console 数据,如果某一周这个任务悄无声息地没有运行,连错误都不会产生。因为那不是失败,而是预期事件的缺席。按照 Sentry CLI 的 Crons 文档,用 sentry-cli monitors run --schedule "<expected schedule>" <monitor-slug> -- <command> 的形式包住现有命令,开始和结束就会作为 check-in 发送,认证使用项目 DSN。按定价文档,所有方案都包含 1 个 cron monitor,额外的只能用付费方案的 PAYG 预算购买,而这个用途 1 个就够了。
Uptime 的对比很鲜明。它从外部定期请求 URL,默认只要是 2xx 就算通过,所以默认设置下抓不到前面看到的 200 响应里的失败。 用面向 Early Adopter 的 Verification 可以连 JSON 响应体一起检查,但在这个博客里依然很难奏效。失败大多发生在缓存重新验证路径上,而不是访客请求里,而且统计 API 路由现在已经没有客户端调用了。 作为整站宕机时的辅助手段有意义,但和这个博客实际经历的故障不在同一层。
GA 调用用 Logs 和 Metrics
GA 调用光靠错误事件不够,是有原因的。unstable_cache 连失败结果也缓存一小时,所以缓存背后路径的错误事件每小时最多 1 条。把事件数当作影响范围来读,就会系统性地低估。而且正如前一节所见,旧事件会消失,分布无法重画。
Sentry 的 Next.js breadcrumb 文档开头就建议用 Logs 代替手动 breadcrumb。Logs 已于 2025 年 9 月 GA,适合在每次执行 fallback 时连同耗时一起记录。如果目的就是分布本身,2026 年 5 月 GA 的 Application Metrics 更直接。span metrics 文档也把不受 trace 采样影响的聚合引导到 Application Metrics。custom span 适合查看单个请求内部的区段,但它是 10% 的样本,会漏掉罕见的失败。这三者我都还没开启,真要开的话,会先看 Metrics 的分布。
出于同样的原因,告警也不按数量设置。对被压到每小时最多 1 条的事件设"N 条以上"的阈值,只会在低估影响范围的同时保持安静。所以这个博客的判定是看是否发生。Rob Ewaschuk 的 My Philosophy on Alerting 建议针对用户感受到的症状而不是原因来告警,但这条原则的前提是症状会在某处显现。这个博客的失败藏在 200 响应和 0 这个数字后面,只有把 fallback 被执行这件事本身计测出来,才会出现可以告警的症状。
以浏览器 SDK 为前提的功能
Session Replay 和 User Feedback 以浏览器 SDK 为前提。这个博客决定不放这个 SDK,所以现在的判定是"不开启",bundle 成本的依据在第 2 篇讨论。浏览器 profiling 同样需要 SDK,而且还是 beta,附带好几个条件,这些条件实际能展示什么,在第 3 篇细究。
没有运行的功能
根据定价文档,Seer 是在订阅之外按每位活跃贡献者每月 $40 计费的付费附加功能。这次我考虑过拿 9 月 11 日新开的 Next.js 内部 InvariantError issue(JIHOON-BLOG-A)来跑一下,但因为它需要这项订阅,没有运行。这个账号是否已订阅,我没有确认。所以本文里没有 Seer 的第一手经验。Agent Tracing 已于 2026 年 9 月 11 日 GA。依赖模型记忆或旧文章的话,很容易误写成 beta,但这个博客没有 LLM 调用路径,所以不适用。
AI 减少了什么,没减少什么
这次工作中 AI 帮忙减少的成本很明确。从零散文档里收集条件(浏览器 profiling 是否为 beta、响应头、浏览器限制),学习查询语法来切换 group by,对 breadcrumb 时间做加减运算,起草功能表,这些都在几轮对话里完成了。比如 breadcrumb 时间线只用了一次 get_issue_breadcrumbs,确认监控器为 0 个只用了 find_monitors 和 find_uptime_monitors 两次调用。探索门槛降低之后,在判断"开不开"之前先问"现在的数据在说什么",这样的顺序成为可能。
没减少的东西也同样明确。
- 没有存下来的数据。 144 条里有 134 条(截至 9 月 16 日 14:26 UTC)已经消失,从样本中漏掉的 span 从一开始就不存在。智能体无法恢复不存在的数据。
- 需要部署的实验。 gRPC 调用是否会被记为 span,能否区分冻结与事件循环占用,只有真正加上埋点并部署才知道。
- 解读的条件。 外推值的警告,以及本地事件被记为 production 的事实,都没有显示在响应里。我之所以察觉,是因为自己读了事件的 URL 和服务器名。
- 日期与工具的时差。 像 Agent Tracing 这样五天前状态刚变的功能,必须打开 changelog 才能确认。MCP 工具也还在追赶产品。在 issue 搜索里加
OR会返回 400,告警规则查询工具则返回 410This API no longer exists。 - 把什么视为失败。 正因为先有了把 200 响应和 0 这个统计定义为失败、把埋点位置往下移的判断,才有可供重新打开的事件留存下来。
结语
总结一下,我之所以没有开启 Sentry 的大部分功能,不是因为不了解,而是因为确认的成本。AI 大幅降低了这笔成本,于是我的顺序变成了在开启功能之前先问这个账号的数据。这样重新打开的数据,比任何新功能都更早地揭示了几个令人不舒服的事实。我以为修好的故障其实没修就停了,当时的分布因为超过保留期而无法重画,我的本地验证正混进 production 的 issue 里。
所以这个博客接下来的步骤,不是由功能列表决定的,而是由空白决定的。给每周采集接上 Crons,为 GA 调用挑选受保留期和采样影响更小的信号,并先把本地环境名称纠正过来。也希望读到这篇文章的各位想一想,自己用了很久的工具里有哪些从未开启的功能。那个功能是真的不需要,还是只是确认的成本太高,现在可以直接去问数据了。
下一篇会转到这个博客决定不放的浏览器 SDK 那一侧,在浏览器可观测性里讨论如何看清访客屏幕里发生的事。