결정 모델, Jev와 Kev
이번 포스팅에서는 텍스트를 만들지 않는 모델에 대한 이야기를 해보려고 한다. 지난주에 TypeSafe AI가 Jev를 공개했다.
가장 먼저 눈에 들어온 사용처는 브라우저 자동화였다. Browserbase가 Stagehand의 act()에 Jev를 붙이는 PR을 올렸다. 페이지의 접근성 트리를 state로 보내고 「다음에 클릭할 요소는 어느 것인가」를 선택지로 묻는 구조였다. 40개 과제에서 act() 중앙값이 1.97초에서 0.46초로 줄었고, 147번의 동작 중 LLM으로 되돌아간 것은 4번이었다. Playwright 스크립트가 selector 하나 바뀌면 깨지는 자리를, 확률 하나 돌려받는 호출로 메운 것이다. 이 글을 쓰는 시점에 PR은 아직 머지되지 않았다.
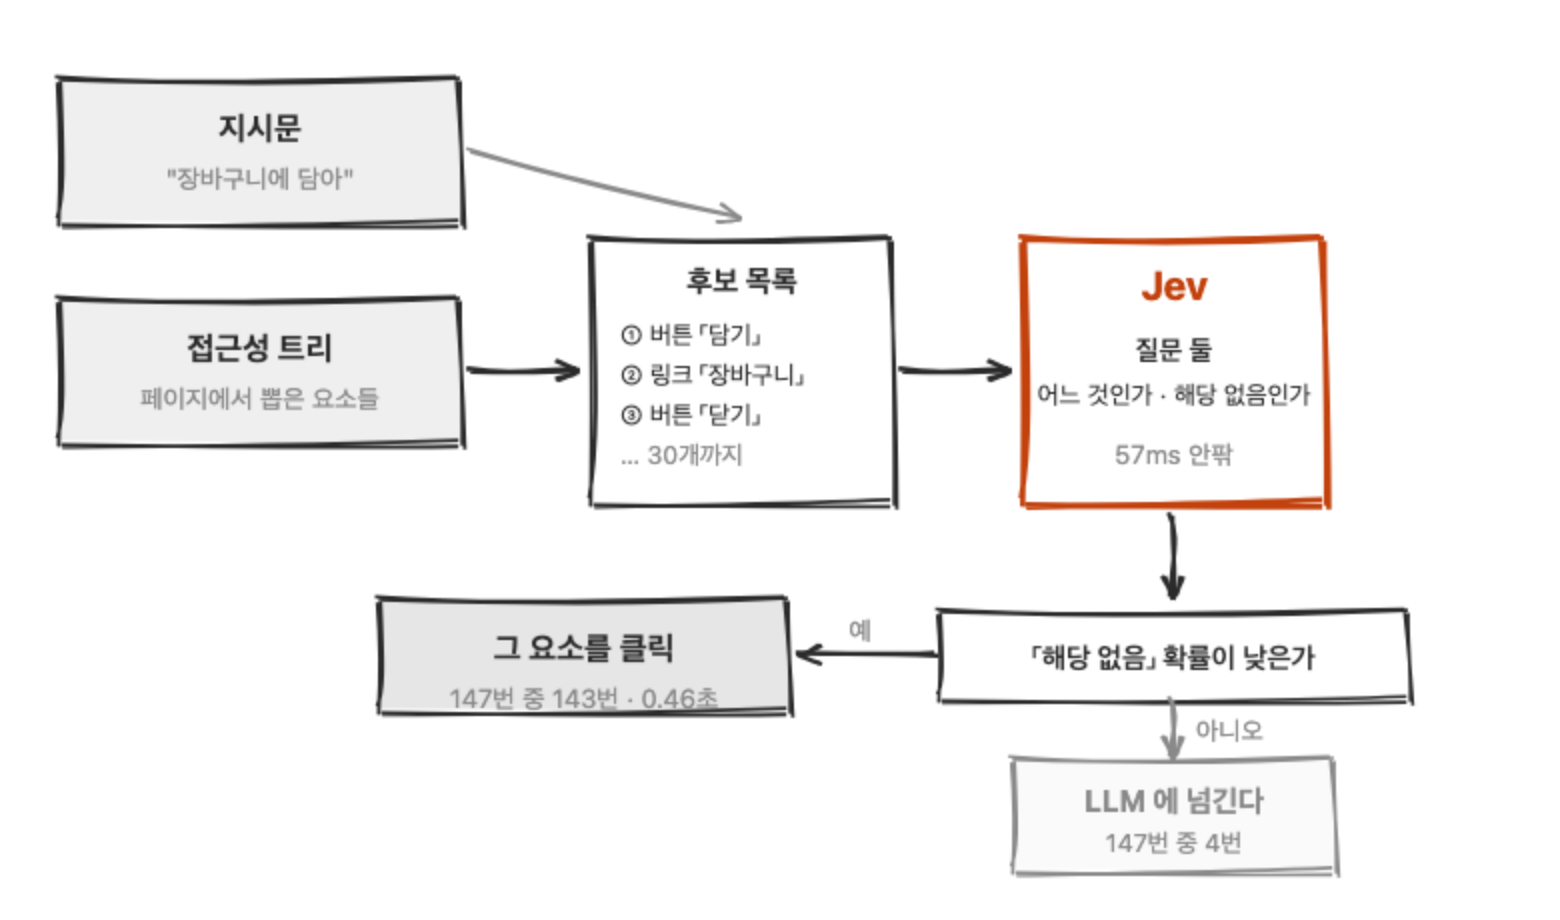
그 PR이 그은 선이 이 글의 질문이다. Jev의 답을 받아들이는 기준을 확률 0.7로 두고, 못 넘으면 LLM에게 넘긴다. 저 모델이 돌려주는 확률을 믿고 코드에서 선을 그어도 되는가.
남의 벤치마크만으로는 판단할 수 없어서 필자의 데이터로 검증해보려 한다. 이 블로그에는 음차 외래어를 막는 게이트가 있다. 피커가 아니라 picker로 쓰자는 규칙인데, 정규식은 확실한 절반만 잡고 멀티스레드나 콜 스택처럼 합성어이거나 이미 정착한 말은 필자가 매번 손으로 판단한다. 답은 「되돌린다」와 「둔다」 둘뿐이고, 아는 사람은 1초에 판단하고, 빌드 스크립트 안에서 사람 확인 없이 통과와 실패를 정해야 한다. Stagehand의 selector 판단과 모양이 같다.
그래서 순서를 이렇게 잡았다. Jev가 무엇을 돌려주는지, 그 확률이 어떤 학습에서 나오는지, 필자의 게이트에 넘기면 어떤 숫자가 나오는지, 그리고 그 숫자를 어디에 쓸 수 있는지다.
텍스트를 만들지 않는 모델
2026년 9월 15일에 공개되었다. TypeSafe에서 이것을 LLM이라고 부르지 않고 System One Model이라는 새 범주로 부른다. 이 글에서는 결정 모델이라고 부른다. 창업자 Diogo Almeida는 OpenAI에서 InstructGPT 논문의 네 번째 저자로 참여했던 사람이다. ChatGPT 만든 팀에 있었고, 지금은 그 방법의 한계를 지적하는 쪽에 서 있다.
Jev는 문장을 생성하지 않는다. 답의 모양을 미리 정해 주면 그중에서 고르고 확률을 함께 돌려준다. 질문 타입은 셋뿐이다.
| 타입 | 묻는 것 | 돌려주는 것 |
|---|---|---|
choice |
이 중 어느 것인가 | 선택, probabilities, confidence |
score |
어느 수준인가 | 점수, legend, probabilities, confidence |
noul |
참인가 | 0에서 1 사이 확률 하나 |
endpoint도 하나다. POST /v1/systemone에 state(평가할 내용), model, questions(질문 맵)를 보내면 답이 온다. 같은 state에 대한 질문 여러 개를 한 요청에 담을 수 있고, 질문을 늘려도 응답 시간이 거의 안 늘어난다.
왜 빠른지는 토큰의 원리에서 정리한 prefill과 decode의 비대칭으로 설명된다. LLM이 느린 이유는 출력을 한 토큰씩 순차적으로 짜내기 때문인데, Jev는 그 decode 단계가 없다. 입력을 한 번 병렬로 읽고 확률을 바로 읽어낸다. 그래서 출력 토큰 요금이 아예 없고 입력만 백만 토큰당 $0.042다.
Archer Hume이라는 개발자가 API를 약 1만 번 호출해 바깥에서 동작을 복원한 분석이 있다. 입력 360토큰에 중앙값 57.5ms, 29,835토큰에 218ms, 질문을 1,500개 넣었을 때 610ms였다. 그중 가장 직접적인 증거는 선택지가 200개인 응답이 2개짜리와 같은 속도로 돌아왔다는 관찰이다. 답을 쓰는 데 시간이 안 걸린다는 뜻이다.
사람이 안 보는 판단
속도와 가격이 눈에 띄지만, Almeida가 공개 발표 글에서 던진 질문은 다른 쪽이었다. 모델이 몇 년째 대화에서 초인적인데 자동화는 다 어디 갔느냐는 것이다.
그의 답은 두 일의 종류가 다르다는 것이다. 챗봇과 copilot과 코딩 agent는 사람이 옆에서 보면서 만족하는 것이 목표다. 서버에서 조용히 돌면서 아무도 안 보는 판단은 그렇지 않다. 앞을 assistant, 뒤를 automation이라고 부른다면, 지금까지 나온 모델은 전부 앞쪽을 위해 만들어졌다.
harness 설계를 정리하면서도 비슷한 구분을 한 적이 있다. 에이전트 시스템 안에는 사람이 보지 않는 판단이 무수히 많다. 이 요청을 사람에게 넘길까. 이 명령을 실행해도 되나. 지금은 그것들을 전부 비싼 LLM에게 물어보고 있다. 필자의 정규식 게이트가 못 덮는 나머지 절반도 그런 판단이다.
RLHF가 남긴 자리
그런데 왜 새 학습법이 필요했을까. 기존 모델에게 예/아니오만 시키면 안 되는 걸까.
RLHF(reinforcement learning from human feedback)의 계보에 답이 있다. 사람의 선호 비교로 보상 모델을 세우는 골격은 Deep reinforcement learning from human preferences에서 나왔고, Learning to summarize from human feedback에 언어 모델에 적용했으며, InstructGPT가 지시 따르기로 확장했다. 세 논문이 공유하는 목표 함수는 하나다. 평가자인 사람이 더 선호하는 출력을 내는 것.
여기서 정확도와 캘리브레이션을 구분해야 한다. 정확도는 몇 퍼센트 맞히느냐이고, 캘리브레이션은 자기가 몇 퍼센트 맞힐지를 아느냐다. 강수 확률 70%라고 한 날들만 모았을 때 실제로 열 번 중 일곱 번 비가 왔다면 그 예보는 캘리브레이션이 잘 된 것이다. 정확도가 높다는 뜻이 아니다. 자기 한계를 안다는 뜻이다. 60%만 맞히는 모델도 스스로 60%라고 말하면 캘리브레이션은 만점이다.
그 어긋남을 재는 지표가 ECE(expected calibration error)다. 확률 구간마다 「말한 확률」과 「실제 적중률」의 차이를 그 구간의 표본 비율로 가중해 평균한 값이고, 0이 완벽이다.
챗봇에는 사람의 선호가 맞는 목표다. 문제는 사람이 우물쭈물하는 답보다 자신 있는 답을 선호한다는 데 있다. 그래서 모델은 애매할 때도 단정적으로 말하는 버릇을 들인다. TypeSafe 문서는 이것을 mode dropping이라고 부른다. 선호 최적화가 특정 스타일을 편애하도록 모델을 밀면서 다른 가능한 출력의 확률을 눌러 버린다는 것이다.
OpenAI도 같은 것을 보고서에 적었다. GPT-4 기술 보고서의 Figure 8은 사전학습 모델과 post-training 모델의 캘리브레이션 곡선을 나란히 놓는데, 캡션이 이렇다.
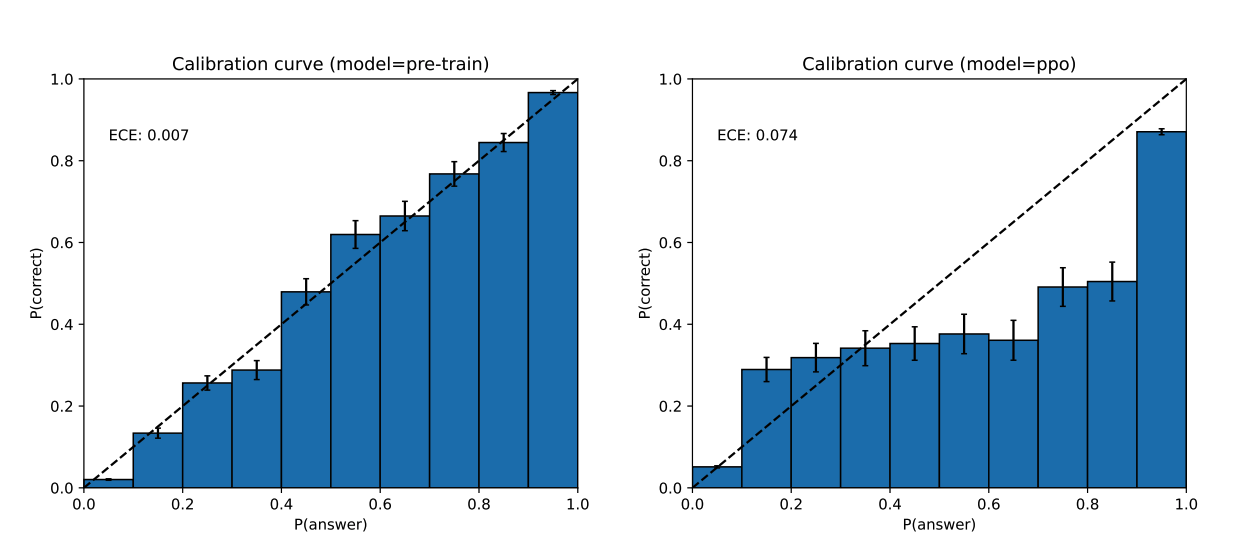
출처: OpenAI, GPT-4 Technical Report (arXiv:2303.08774), Figure 8.
Right: Calibration plot of the post-trained GPT-4 model on the same subset of MMLU. The post-training hurts calibration significantly.
그림에 찍힌 숫자로는 사전학습 모델의 ECE가 0.007이고 PPO를 거친 모델이 0.074다. 열 배 넘게 나빠졌다. 사람을 만족시키도록 다듬는 과정에서 자기가 몇 퍼센트 맞힐지 아는 능력이 깎인 것이다.
다만 ECE 하나로는 부족하다. 모든 입력에 0.6을 찍는 상수 예측기도 실제 적중률이 60%면 ECE가 0이다. 확률이 정직하기만 하고 사안마다 갈리지 않으면 선을 그을 자리가 없다. 그래서 캘리브레이션과 별개로 확률이 실제로 갈라지는지를 같이 봐야 하고, 뒤에서 쓸 「오차 예산 안에서 자동 처리할 수 있는 비율」이 그 둘을 한 숫자로 묶은 지표다.
소프트웨어 입장에서 중요한 것은 이 부분이다. 확률이 정직하고 갈라지면 선을 그을 수 있다. 0.95 넘으면 자동 처리하고 그 아래는 사람에게 넘기는 구조가 나온다.
TypeSafe는 그 자리를 겨냥해 세 번째 길을 냈다고 말한다. 사람의 선호를 최적화하는 RLHF, 기계가 채점할 수 있는 정답을 최적화하는 RLVR(reinforcement learning with verifiable rewards), 그리고 캘리브레이션된 결정을 최적화한다는 RLCD다.
다만 RLCD로 공개된 것은 출력 계약 세 줄이 전부다. 이 글을 쓰는 2026년 9월 23일 기준으로 TypeSafe의 문서와 발표 글 어디에도 논문이나 기술 보고서가 없다. 같은 약어를 쓰는 ICLR 2024 논문이 따로 있는데 그쪽은 reinforcement learning from contrastive distillation이라 다른 방법이다.
confidence의 정체
그래서 Jev가 돌려주는 숫자는 정직한가. 답하기 전에 먼저 볼 것이 있다. 돌려주는 숫자가 하나가 아니다.
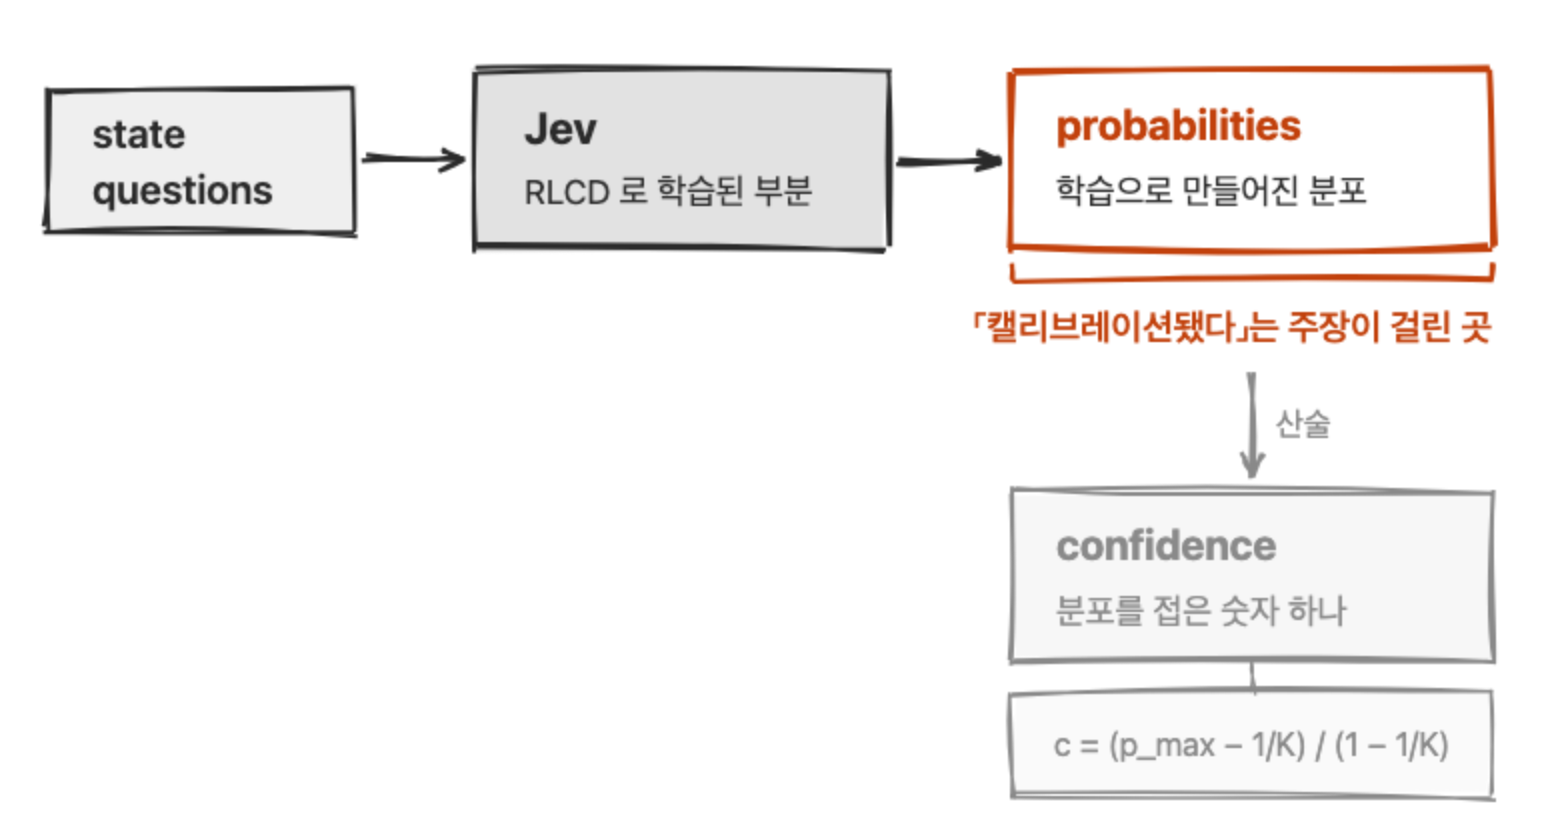
Choice와 Score 응답에는 probabilities와 confidence가 같이 들어 있다. 앞은 선택지 전체에 걸친 확률 분포이고, 뒤는 0에서 1 사이 숫자 하나다. 코드에서 임계값을 걸 때 손이 먼저 가는 쪽은 confidence다.
이 값은 모델이 만든 것이 아니다. TypeSafe 조직이 공개한 system-one-adapter-python의 _utils/confidence_metrics.py의 Choice 부분은 아래와 같다.
def choice_confidence(probs: list[float]) -> float:
    """Scale peak choice probability from uniform to certainty."""
    if len(probs) == 1:
        return 1.0

    normalized_probs = _normalize(probs)
    uniform_probability = 1.0 / len(normalized_probs)
    return (max(normalized_probs) - uniform_probability) / (1.0 - uniform_probability)
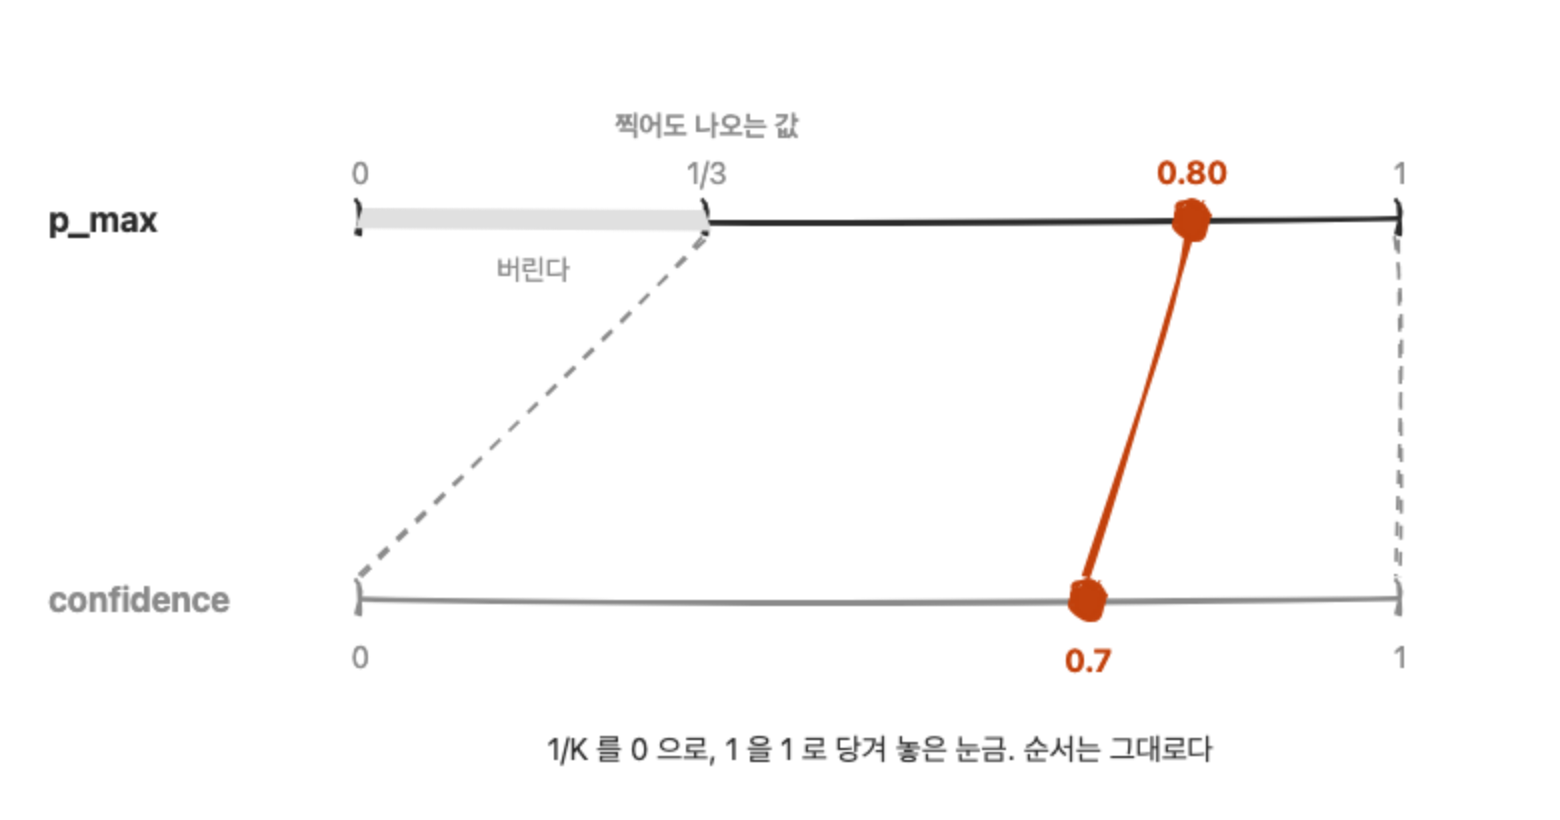
모델 호출도 없고 학습된 파라미터도 없다. probabilities 벡터 하나가 들어가고 실수 하나가 나온다. 식으로 쓰면 c = (p_max − 1/K) / (1 − 1/K)이고, 선택지가 셋이고 최대 확률이 0.8이면 0.7이 된다.
이 저장소는 프로덕션 Jev 서버가 아니라 LLM으로 같은 API를 흉내 내는 대체 구현이다. 그러니 이것만으로 단정할 수는 없다. 그런데 같은 식을 가리키는 증거가 둘 더 있다. TypeSafe 공식 문서의 confidence 페이지가 이 값을 "a statistic computed from the probability distribution"이라고 적고, 데모 코드에는 세 선택지용 근사식이라며 (3 × largest probability − 1) / 2를 실었다. K가 3이면 위 식과 같다. 그리고 주장 감사 원장이 실제 API에서 둘 다 틀린 선택지 둘만 준 응답의 승자가 0.52일 때 confidence가 0.04로 왔다고 기록했다. K가 2면 (0.52 − 0.5) / (1 − 0.5) = 0.04다. 식과 맞는다.
같은 저장소에서 Score는 아예 다른 식을 쓴다. 최빈 수준으로부터의 평균 절대 거리를 균등 분포의 그것으로 나눈 뒤 1에서 뺀다. 문서는 Score의 식을 공개하지 않는다. 그러니까 confidence라는 한 이름 아래 산식이 둘 있고, 타입이 다르면 같은 숫자가 다른 뜻이다. Noul에 confidence가 없는 것도 같은 이유다. 접을 분포가 없다.
문서도 이것을 숨기지 않는다. 다른 계산을 쓰고 싶으면 probabilities 전체를 줄 테니 알아서 하라고까지 안내한다. 적혀 있는 내용이고, 읽지 않고 쓰는 쪽이 문제다.
그런데 공개 발표 글의 비교표는 둘을 붙여 쓴다. "Calibrated: higher confidence means higher accuracy"라고 적혀 있다. 읽는 사람은 confidence가 캘리브레이션된 값이라고 받아들이는데, 캘리브레이션 주장이 실제로 걸려 있는 쪽은 probabilities다.
이 구분이 숫자로 얼마나 벌어지는지는 측정이 있다. scienthoon이라는 개발자가 공개한 독립 캘리브레이션 측정이 confidence를 「맞을 확률」로 읽었을 때의 ECE를 따로 쟀다. OpenBookQA에서 0.035, HellaSwag에서 0.078, 합성 집합에서 0.18이다. 같은 집합의 원본 확률은 각각 0.024, 0.029, 0.107이었다. 세 집합 전부에서 confidence 쪽이 나쁘다.
왜 나빠지는지는 식에 있다. K가 고정이면 c는 p_max의 순증가 변환이라 순서가 보존된다. 판별력은 그대로이고 임계값만 옮겨 적으면 된다. 망가지는 것은 정보가 아니라 눈금이다. K가 질문마다 다르면 문제가 하나 더 생긴다. 늘이는 배율도 달라진다. 같은 p_max 0.8이 선택지 둘에서는 0.6이 되고 다섯에서는 0.75가 된다. 선택지 수가 섞인 워크로드에서 임계값 하나를 쓰는 순간 그게 문제가 된다.
분포에 따라 달라지는 캘리브레이션
그렇다면 probabilities 쪽은 믿어도 될까.
Jev를 실제로 호출해 재본 기록이 공개되어 있다. Jared Palmer가 만든 오픈소스 재현 구현 Kev의 저장소에는 runs/jev-* directory가 있고, usage.json이 "model": "typesafe-ai/jev"로 Vercel AI Gateway를 거친 실호출임을 기록하고 있다. jev-* directory 여섯 개의 usage.json을 합치면 2026년 9월 18일과 20일에 걸쳐 5,364회를 불렀고 입력이 2,418,260토큰이다. 아래 일곱 집합 중 scienthoon은 그 개발자의 결과 파일을 변환해 들여온 것이라 이 합계에 들어 있지 않다.
가격이 실제로 입력만 과금된다는 것은 다른 곳에서 확인된다. 피싱 벤치마크 저자가 TypeSafe dashboard를 보고 적어 뒀다. 두 번 돌린 456만 토큰 중 입력이 366만, 출력이 90만이었는데 청구는 $0.15였고 그 값이 입력만 계산한 것과 맞았다.
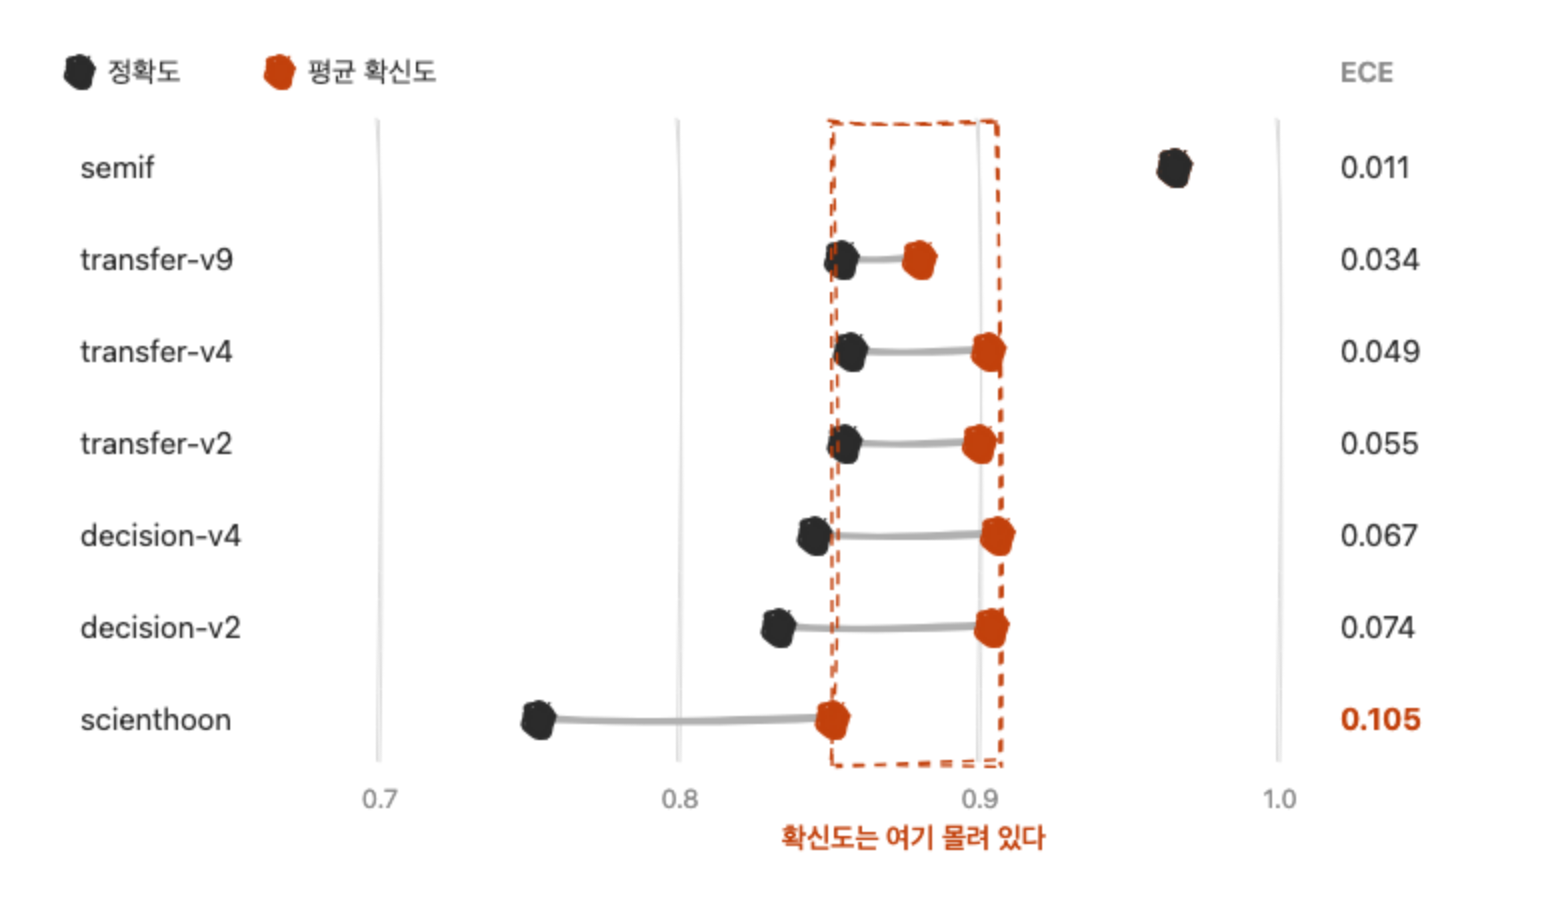
같은 directory의 report.json에서 평가 집합 일곱 개의 지표를 꺼내 정리하면 이렇다. 아래에서 확신도는 confidence 필드가 아니라 probabilities의 최댓값이다. 과신은 평균 확신도 − 정확도이고 총 5,743건이다. 판단 근거를 지운 「알 수 없는」 항목은 정확도 채점에서 빼는 clean 블록의 값이다.
| 평가 집합 | n | 정확도 | 평균 확신도 | 과신 | ECE |
|---|---|---|---|---|---|
| semif | 144 | 0.965 | 0.965 | -0.000 | 0.011 |
| transfer-v9 | 1,046 | 0.854 | 0.880 | +0.026 | 0.034 |
| transfer-v4 | 656 | 0.857 | 0.903 | +0.046 | 0.049 |
| transfer-v2 | 560 | 0.855 | 0.900 | +0.045 | 0.055 |
| decision-v4 | 1,264 | 0.845 | 0.906 | +0.061 | 0.067 |
| decision-v2 | 1,200 | 0.833 | 0.904 | +0.071 | 0.074 |
| scienthoon | 873 | 0.753 | 0.851 | +0.099 | 0.105 |
두 가지가 읽힌다.
첫째, ECE가 열 배 가까이 움직인다. 0.011에서 0.105다. 같은 채점기, 같은 모델이다. 「캘리브레이션됐다」는 모델의 성질이 아니라 모델과 분포의 관계인 것이다. 분포가 바뀌면 캘리브레이션이 무너진다는 것 자체는 이미 알려진 결과다. 여기서 새로운 것은 캘리브레이션을 학습 목표로 내세운 모델에서도 같은 모양이 나온다는 점이다.
ECE가 가장 큰 집합의 0.105는 앞에서 본 post-RLHF GPT-4의 0.074보다도 크다. 다만 이 둘을 순위로 읽으면 안 된다. 과제가 다르고, ECE는 구간을 몇 개로 나누느냐와 표본이 어느 구간에 몰렸느냐에 따라 값이 움직이는 추정량이라 서로 다른 채점기에서 나온 숫자를 맞대면 비교가 성립하지 않는다.
둘째, 측정된 ECE가 과신 하나로 거의 전부 설명된다. 두 열의 차이가 일곱 개 전부 0.002에서 0.011 사이다. ECE는 구간별 격차의 가중 평균이라 전체 과신보다 작을 수 없는데, 그 차이가 거의 0이라는 것은 구간마다 어긋나는 부호가 한 방향으로 쏠려 있다는 뜻이다. 구간별로 엇갈려 상쇄되는 잡음이 아니다.
왜 그런지는 세로로 읽으면 보인다. 평균 확신도는 semif를 빼면 0.851에서 0.906 사이에 여섯 개가 붙어 있다. 같은 구간에서 정확도는 0.753에서 0.857로 두 배 넓게 움직인다. 확신도는 분포가 바뀌어도 잘 안 움직이고 정확도만 움직인다. 남는 차이가 그대로 ECE다.
이 성질이 실무에서 어떻게 나타나는지는 다른 벤치마크가 보여준다. 피싱 이메일 2,000건에 Claude Haiku 4.5를 대조군으로 세운 측정에서 Jev의 정확도는 62.6%였고 Haiku는 81.3%였다. 그런데 더 눈에 띄는 것은 ECE다. 리포가 보고한 ECE는 Jev 0.154, Haiku 0.097이고, 주장 감사 원장이 Jev의 P(phishing) 값을 0에서 1까지 10구간으로 다시 재면 0.170이다. 어느 쪽으로 읽어도 캘리브레이션을 학습 목표로 내세운 모델이 RLHF로 만든 LLM에게 캘리브레이션에서 졌다. 같은 저자가 링크 호스트 목록 규칙 하나만으로 91.6%를 냈다.
같은 지표를 여러 집합에서 보면 폭이 더 분명하다. 오차 예산 5%에서 자동 처리할 수 있는 비율이 scienthoon 집합에서 0.486, transfer-v9에서 0.695, semif에서 1.000이다. Kev의 채점기는 이 값을 표본 안에서 임계값을 고른 최댓값이라고 적어 두었고, 배포 후의 오차 보장이 아니다. 어느 하나를 모델의 스펙처럼 인용하면 안 된다.
음차 판별 게이트
남의 벤치마크를 읽는 것과 내 데이터에서 재보는 것은 다르다. 그래서 서두의 게이트를 실제로 넘겨 봤다.
필자는 앞서 언급한 Kev-9B를 로컬에서 돌렸다. Qwen3.5-9B-Base에 rank-16 LoRA와 pointer head를 얹은 재현 구현이고 Apache-2.0이다. 아래 숫자는 Jev의 숫자가 아니다. Kev의 학습 데이터는 영어 결정 과제이고, 같은 저자의 측정에서 Kev-9B는 영어 과제에서도 Jev에 뒤진다. 오차 예산 5%의 자동화 비율이 0.45에서 0.57인데 Jev가 0.70이고, MMLU-Pro는 0.52 대 0.84다. 그리고 TypeSafe 문서도 Jev에 대해 영어가 주 학습 언어이고 CJK는 동등하지 않다고 밝히고 있다.
평가 집합은 필자의 한국어 블로그 글 18편에서 뽑았다. 라벨의 정답 기준은 블로그에서 그 단어를 일관되게 어느 표기로 쓰는가다. 한국어 기술 문서 공동체의 합의가 아니라 이 블로그의 관습이라는 뜻이고, 둘이 갈리는 단어에서는 모델이 공동체 기준으로 맞고 이 기준으로 틀릴 수 있다.
- 게이트에 있는 단어, 102문장. 게이트가 이미 아는 단어다. 본문이 영어로 쓴
calendar,picker,adapter같은 단어를 한글 음차로 바꿔 만든 문장, 즉 되돌릴 문장이 23개이고,write-post.md가 예외로 명시한리렌더링이나콜 스택이 실제로 쓰인 문장, 즉 그대로 둘 문장이 79개다. 여기서 현재 정규식 게이트는 정의상 100%를 맞힌다. - 게이트에 없는 단어, 60문장. 게이트가 한 번도 본 적 없는 단어다. 머신러닝에서 held-out 이라고 부르는 쪽이다. 본문이 영어로만 쓰는
loader,mutation,prefill을 음차로 바꾼 되돌릴 문장이 30개, 본문이 한글로만 쓰는리듀서,스냅샷,런타임이 실제로 쓰인 그대로 둘 문장이 30개다. 여기서 정규식은 되돌릴 문장을 하나도 못 잡는다.
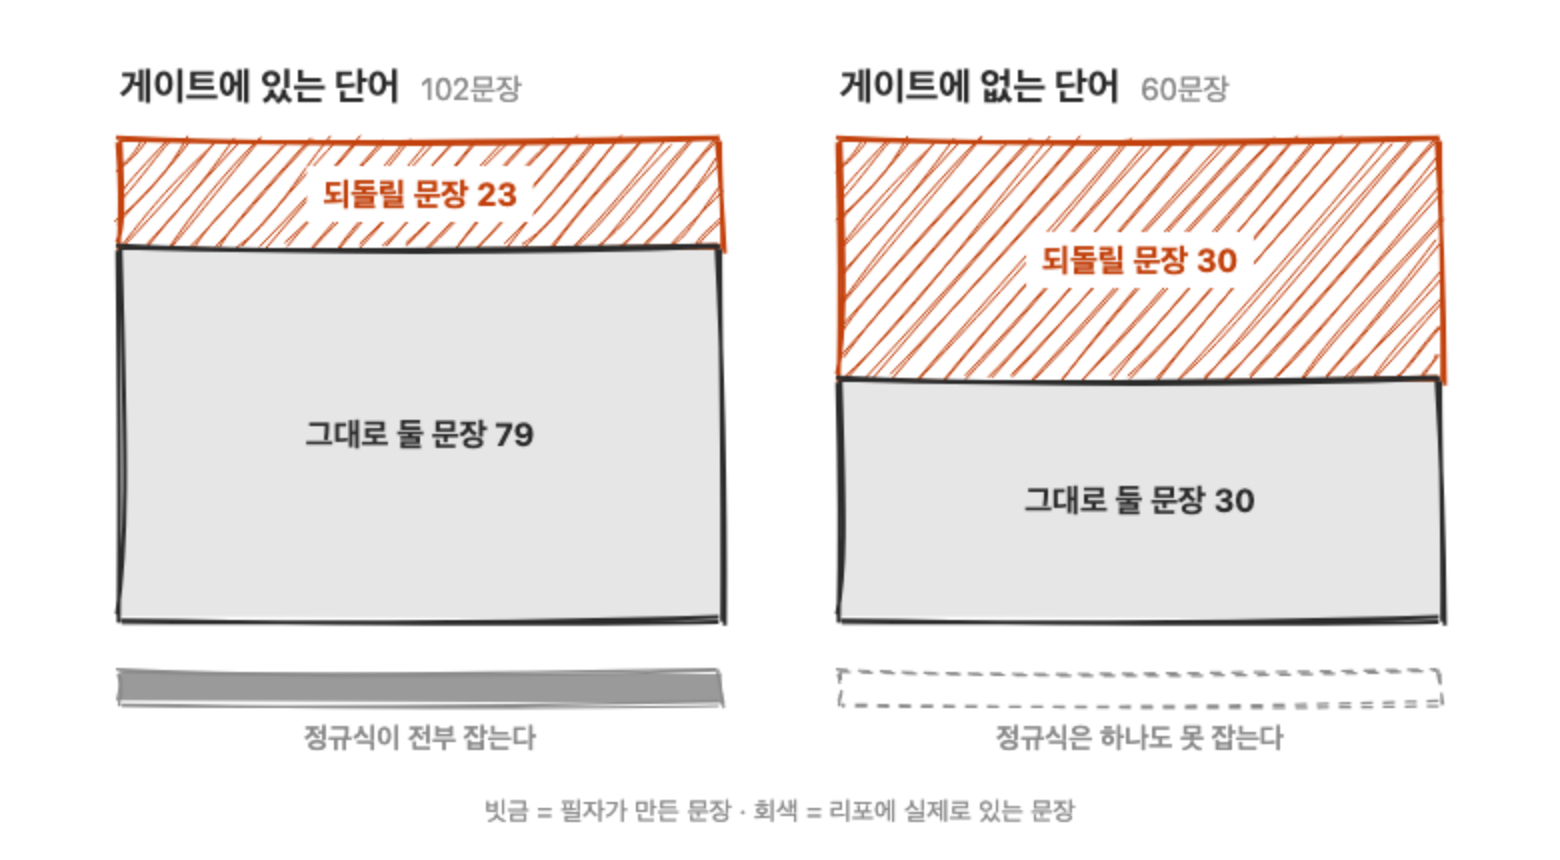
되돌릴 문장은 필자가 만든 것이고 그대로 둘 문장은 실제 문장이라는 비대칭은 먼저 밝혀 둔다. 그리고 유효 표본은 문장 수가 아니라 단어 수다. 라벨이 단어 단위로 정해지므로 같은 단어가 나오는 문장들은 독립 관측이 아니다. 게이트에 있는 단어는 24종, 없는 단어는 13종이다.
아래 표는 「이 단어를 영어로 되돌려야 하는가」를 묻는 noul 질문 하나만 집계한 것이다. 같은 요청에 질문을 넷 담았지만 나머지 셋은 부정형과 Choice 변형, 그리고 라벨을 제대로 세우지 못한 합성어 판정이라 여기 섞지 않았다. 5% 예산 자동화 비율은 확신도가 높은 쪽부터 잘라 내려가며 그 위 구간의 오차가 5%를 넘지 않는 최대 비율이다.
| 게이트에 있는 단어 | 게이트에 없는 단어 | |
|---|---|---|
| 문장 / 단어 | 102 / 24종 | 60 / 13종 |
| 현재 정규식 게이트 | 1.000 | 0.500 |
| Kev-9B 정확도 | 0.225 | 0.500 |
| 단어 단위 정확도 | 6/24 | 7/13 |
| 다수 클래스 기준선 | 0.775 | 0.500 |
| ECE | 0.664 | 0.336 |
| 평균 확신도 | 0.876 | 0.821 |
| 확신도 0.9 이상 비율 | 0.490 | 0.317 |
| 그 구간의 실제 적중 | 0.240 | 0.526 |
| 5% 예산 자동화 비율 | 0.010 | 0.000 |
다수 클래스 기준선은 문장을 안 읽고 많은 쪽 라벨만 찍었을 때의 점수다. 모델이 그 아래다.
마지막 줄이 이 실험의 답이다. 게이트에 없는 단어에서는 임계값을 아무리 높게 잡아도 5% 오차 안에서 자동 처리할 수 있는 결정이 한 건도 없었다.
예측 분포를 보면 무슨 일이 일어났는지 나온다. 모델은 162문장 전부에 「되돌려야 한다」고 답했다. 단어 37종 전부다. 되돌릴 문장은 전부 맞고 그대로 둘 문장은 전부 틀렸다. 그래서 게이트에 없는 단어의 0.500은 실력이 아니라 집합이 균형 잡혀 있어서 나온 숫자다.
그러면서 평균 확신도가 0.876이었다. 게이트에 있는 단어에서 확신도 0.9를 넘은 것이 49%인데 그 구간의 실제 적중은 0.240이다.
두 확률의 합이 1이 되는 관계도 성립하지 않았다. 「되돌려야 하는가」와 「그대로 둬야 하는가」의 확률을 더하면 게이트에 있는 단어에서 평균 1.655가 나왔고, 102문장 전부가 1에서 0.1 넘게 벗어났다.
설계상 그렇다. 두 질문은 서로를 읽지 못하는 별개의 평가이고, TypeSafe도 jaggedness 페이지에 refund 0.72와 not_refund 0.47을 더해 1.19가 되는 예를 직접 실어 뒀다.
실무에서 걸리는 지점은 이것이다. Noul에 맞춰 조율한 임계값을 Choice로 옮기면 안 된다. 같은 판단인데 결론이 갈리는 문장이 14%에서 17%였다.
무엇을 물어도 예라고 하는 모델이면 이 결과는 무의미하다. 그것부터 확인했다.
| 상태 / 질문 | 물은 것 | 답 |
|---|---|---|
| 한국어 / 한국어 | 이 문장은 영어로 쓰여 있는가? | 0.02 |
| 한국어 / 한국어 | 이 문장은 요리법을 설명하는가? | 0.04 |
| 한국어 / 한국어 | 이 문장은 한국어로 쓰여 있는가? | 0.98 |
| 한국어 / 영어 | Is this sentence written in English? | 0.01 |
| 영어 / 영어 | Is this sentence about software? | 0.96 |
한국어를 읽고, 「아니오」를 말하고, 0.02와 0.98을 가른다. 전역적인 순응 편향은 아니다. 배제되는 것은 거기까지다. 게이트 질문의 문구 자체가 나쁠 가능성은 남는다.
규칙을 state에 넣은 결과
그렇다면 판별에 필요한 지식을 직접 주면 달라질까. TypeSafe 문서가 권하는 도메인 적응 방식이 이것이다. 가중치를 건드리지 않고 참고 자료를 state에 실어 보낸다.
write-post.md에 이미 적혀 있는 규칙 문단을 state에 함께 넣고 다시 돌렸다. 입력이 문장당 100토큰에서 450토큰으로 늘었다. 게이트에 있는 단어 쪽은 데이터 누출이다. 그 참고 자료가 게이트 단어와 예외 단어를 이름으로 나열하기 때문이다. 그래서 그쪽은 「참고 자료를 읽기는 하는가」를 보는 대조군이고, 진짜 시험은 게이트에 없는 단어다.
| 있는 단어(누출) | 있는 단어 +규칙 | 없는 단어 | 없는 단어 +규칙 | |
|---|---|---|---|---|
noul 정확도 |
0.225 | 0.676 | 0.500 | 0.500 |
| 단어 단위 정확도 | 6/24 | 7/13 | 5/13 | |
| 되돌릴 문장 정답 | 23/23 | 1/23 | 30/30 | 8/30 |
| 그대로 둘 문장 정답 | 0/79 | 68/79 | 0/30 | 22/30 |
| 5% 예산 자동화 비율 | 0.010 | 0.314 | 0.000 | 0.050 |
| 지연 중앙값 | 2,924ms | 6,903ms | 2,908ms | 6,918ms |
지연은 M2 Max에서 돌린 로컬 추론이라 앞에서 본 Jev의 API 지연과 같은 축이 아니다. 여기서 볼 것은 절대값이 아니라 참고 자료를 넣었을 때의 2.4배다.
균형 잡힌, 게이트에 없는 단어에서 문장 단위 정확도가 0.500에서 0.500으로, 전혀 움직이지 않았다. 단어 단위로는 7/13에서 5/13으로 오히려 내려갔다.
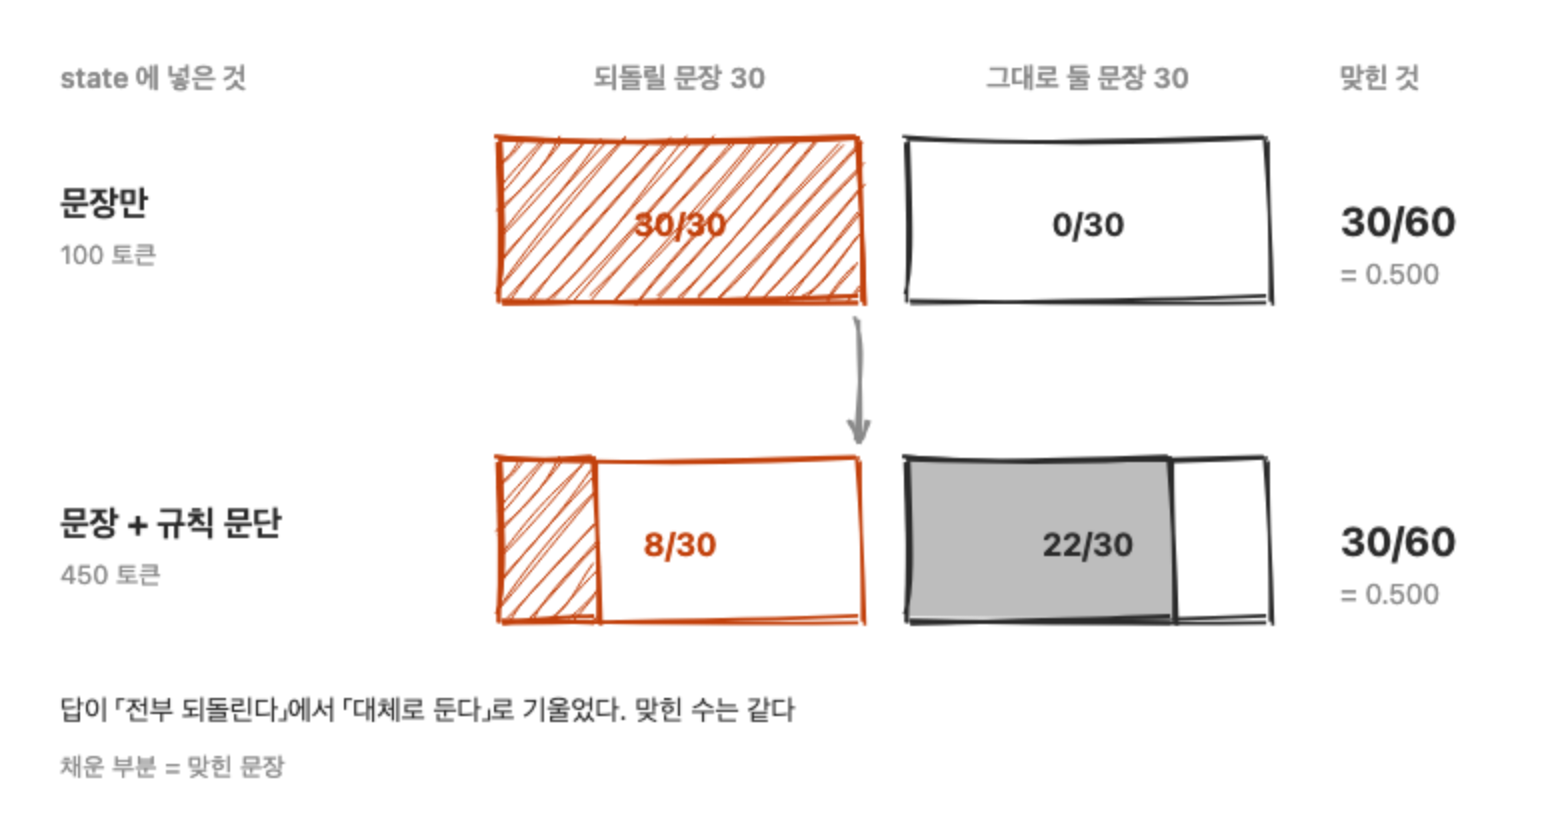
게이트에 있는 단어의 0.225에서 0.676은 실력 향상이 아니다. 전에는 102문장 전부에 「되돌린다」고 했고, 참고 자료를 주자 12문장에만 그렇게 답했다. 그대로 둘 문장이 0/79에서 68/79로 올랐지만 되돌릴 문장이 23/23에서 1/23으로 무너졌다. 그 집합은 그대로 둘 문장이 79대 23으로 많으니 「대체로 두라」는 상수가 자동으로 더 높은 점수를 받는다. 구별을 배운 것이 아니라 기울기를 바꾼 것이다.
그렇다고 모델이 문장을 읽지 않는 것은 아니다. 같은 단어의 같은 문장들인데 참고 자료를 주자 문장마다 예측이 흩어졌다. 로더의 표준편차가 0.096에서 0.217로, 뮤테이션이 0.042에서 0.236으로 늘었다. 읽기는 하는데 구별을 못 한다.
그리고 이 결과는 앞 절의 해석을 흔들기도 한다. state 텍스트 하나로 출력이 통째로 뒤집힌다면, 첫 실행의 「전부 되돌린다」도 모델의 한계가 아니라 질문 문구의 부족일 수 있다. 이 글은 그 가능성을 배제하지 못했다.
한 가지는 눈에 띄게 좋아졌다. 「되돌린다」와 「그대로」의 확률 합이 게이트에 없는 단어에서 1.508에서 0.963으로 붙었고, 1에서 크게 벗어난 문장이 59개에서 18개로 줄었다. 그런데 정확도는 움직이지 않았다. 두 질문의 확률이 서로 맞아떨어지는 것과 그 확률이 맞는 것은 다른 일이다.
결정 모델의 자리
여기까지 보면 이 모델 범주 전체가 쓸모없다는 결론으로 기울기 쉬운데, 공개된 벤치마크를 나란히 놓으면 그렇지 않다.
| 과제 | n | Jev | 비교 대상 |
|---|---|---|---|
| 스팸, 분포 안 | 18,514 | 98.3% | TF-IDF 회귀 98.4% |
| 스팸, 분포 밖 | 2,876 | 98.6% | TF-IDF 회귀 73.0% |
| 피싱 | 2,000 | 62.6% | Haiku 4.5 81.3%, 규칙 기준선 91.6% |
| rerank 영어 8종 | 1,617 | nDCG@10 0.692 | Cohere Rerank 4 Pro 0.691 |
rerank 행만 검색 순위 품질 지표라 다른 행의 정확도와 축이 다르다.
분포 안에서는 정규식이나 맞춰 놓은 분류기가 이기거나 비긴다. 필자의 게이트에 있는 단어에서 정규식이 1.000 대 0.225로 이긴 것과 같은 자리다. 라벨을 모을 수 있으면 작은 모델을 학습시키는 편이 더 싸고 더 빠르고 더 정확하다. 그건 예전부터 하던 일이다.
격차는 분포가 새롭고 라벨이 없을 때 벌어진다. 분포 밖 스팸에서 98.6% 대 73.0%다. 맞춰 놓은 분류기는 자기가 본 적 없는 모양 앞에서 무너지는데 이쪽은 버틴다. 결정 모델의 자리는 데이터를 모으고 라벨을 붙여 학습시킬 수 없는 판단이다. 매번 상황이 새로워 라벨을 못 모으는데 판단은 초 단위로 내려야 하는 곳이다.
필자의 음차 판별이 왜 실패했는지도 이 틀로 설명된다. 그 판단에 필요한 것은 일반적인 추론이 아니라 한국어 기술 문서에서 어떤 말이 정착했는가라는 특정 도메인 지식이고, 영어 결정 과제로 학습한 9B 재현 구현에게 그건 분포 밖이 아니라 그냥 없는 지식이다. 규칙을 글로 줘도 안 된 이유가 여기 있다.
TechCrunch 기사에서 Pi harness를 만드는 Earendil의 CTO Armin Ronacher가 이렇게 말했다.
At the end of the day, it delegates the hallucination problem a little bit to the user.
환각을 없앤 것이 아니라 판단을 개발자에게 넘긴 것이다. TypeSafe 문서도 캘리브레이션은 예측 묶음에 대해 성립하는 성질이지 개별 답이 맞는다는 보장이 아니라고 적고 있고, 공개 발표 글의 환각률 0% 막대 아래 Nuance 항목에는 "Our number is not empirical"이라고 적혀 있다. 형식은 보장되고 내용은 아니다.
jevable의 194개 프로젝트
필자의 데이터에서는 실패했으니 다른 사람들은 어디에 쓰는지 봤다. jevable.com은 Nikunj라는 개발자가 X에 올라온 Jev 프로젝트를 심사해 모은 독립 큐레이션이다. 2026년 9월 23일 기준 194개이고 등록일은 9월 16일부터 20일 사이에 몰려 있다. 152개가 9월 18일 하루에 들어왔다. 공개 사흘 뒤다.
| 카테고리 | 개수 |
|---|---|
| Games | 39 |
| Developer tools | 34 |
| Productivity | 31 |
| Agents | 19 |
| Experiments | 18 |
| Creative tools | 16 |
| Data & research, Finance, Browser extensions, Robotics, Marketing | 37 |
카테고리보다 「무엇을 묻는가」로 다시 묶으면 세 모양이 나온다. 아래 수치는 전부 게시자가 자기 게시물에 적은 값이다.
첫째, 분류와 라우팅. 이메일 1,500건 분류, 세금 서류 분류, 경쟁사 광고 1,891건을 19초에 $0.12로 분류, PR diff 하나에 typed check 14개, Android 알림에서 광고 판별, 건설 도면 26장을 2.9초에 분류. 앞 절의 표가 말한 대로 라벨이 매일 쌓이는 자리라, 시간이 지나면 자기 라벨로 학습한 작은 분류기가 이기거나 비긴다. Jev의 이점은 라벨이 없는 첫날에 있다.
둘째, 행동 선택 루프. Browser Use에 붙여 항공권 검색을 7초에 $0.0039로 끝냈다는 browser agent, 음성으로 Mac을 조작하는 computer use, Mario가 죽을 때마다 VM을 네 갈래로 fork해 살아남는 쪽을 고르는 게임, 3D 캐릭터의 입과 눈썹과 시선 등 열 가지를 메시지마다 결정하는 표정 엔진. 매 스텝 action space가 바뀌므로 라벨을 모을 수 없고, 판단은 초 아래로 내려야 한다. 분포 밖 스팸에서 격차가 벌어진 것과 같은 자리다. Games가 39개로 가장 큰 카테고리인 이유도 여기 있다고 본다. 게임은 틀려도 되돌릴 수 있는 행동 선택 루프다.
셋째, 확률을 사용자에게 보여주는 UI. 답 대신 판정만 돌려주는 Ask Jev, 다음 질문을 확률로 고르는 분기 폼 JevForm, 기술 깊이와 드라마 같은 슬라이더 여섯 개로 Hacker News 첫 화면을 다시 정렬하는 Upweight. 임계값을 코드에 박지 않고 사람이 확률을 읽는 자리라, 이 글이 문제 삼은 캘리브레이션 요구가 가장 낮다.
한 가지가 눈에 띈다. 194개 설명문에서 비용을 적은 것이 30개, 속도를 적은 것이 53개인데, 정확도나 기준선을 적은 것은 7개다. 설명문이 원 게시물의 앞부분만 담으므로 하한이지만 방향은 분명하다. 빠르고 싸다는 것은 첫날 알 수 있고 맞는지는 재야 알 수 있는데, 재는 쪽이 드물다. 그 7개 중 하나가 jevcal이다. 다들 임계값을 감으로 고른다며, 자기 데이터와 목표 정확도를 넣으면 임계값과 자동 처리 비율을 돌려주는 도구다. 다음 절이 권하는 절차를 그대로 도구로 만든 것이다.
선을 긋는 절차
이 글의 결론은 이것이다. 모델이 돌려준 확률을 스펙처럼 읽지 말고, 자기 데이터에서 직접 재서 선을 그어야 한다.
재는 절차는 이렇다. 라벨이 있는 100건 남짓을 모아 확률 구간별 실제 적중률 표를 만들고, 임계값을 위에서부터 낮춰 가며 그 위 구간의 오차율을 본다. 오차 예산을 정했으면 그 예산을 지키는 최대 커버리지가 곧 자동화할 수 있는 비율이다. 필자의 실험에서 확신도 0.9 이상 구간의 실제 적중이 0.240이었다는 것은 102문장으로 드러났다.
눈금이 어긋난 것은 대개 고칠 수 있다. 과신이 전 구간에 고르게 깔려 있으면 온도 하나로 대부분 맞춰진다. Kev도 그렇게 해서 ECE를 0.106에서 0.042로 내렸다. 문제는 그 온도를 맞추려면 그 분포의 라벨이 필요하다는 것이고, 프로덕션에서 없는 것이 정확히 그것이다. 게다가 온도는 확률의 순서를 바꾸지 못하므로 자동화 가능 비율은 그만큼 안 올라간다. 그래서 눈금보다 순서가, ECE보다 오차 예산 커버리지가 더 실무적인 지표다.
문서가 예제에 쓴 0.9를 그대로 코드에 박았다면, 이 게이트는 조용히 38건을 잘못 고쳤을 것이다. 에러가 나지 않으므로 알아차리기 어려운 실패다. TypeSafe 문서도 그 예제 바로 아래에 자기 데이터로 시험해 보라고 적어 두었다. 코드에 박히는 것은 대개 그 아래 문장이 아니라 위의 숫자다.
키가 없어도 재는 것부터는 오늘 할 수 있다. Kev가 Apache-2.0으로 공개돼 있고 노트북에서 돈다.
지금 운영하는 서비스에서 큰 모델에게 예/아니오만 묻는 호출이 몇 개인지 세어 보면 좋겠다. 그 호출을 결정 모델로 옮기기 전에, 옮긴 다음 그어야 할 선이 어디인지를 먼저 재 보기를 권한다. 필자는 그 순서를 지켰기 때문에 게이트를 안 건드리기로 정할 수 있었다. Jev 키를 받으면 같은 집합을 다시 돌려 볼 생각이고, 그때 결론이 바뀌면 그것도 적겠다.
참고 자료
[paper] Lambert et al., Tulu 3: RLVR의 명명 [repo] themsquared/jev-benchmark, 도구 호출 위험 판정