LLM calibration과 overconfidence
이번 포스팅에서는 모델의 calibration과 RLHF 뒤에 나타나는 overconfidence에 대한 이야기를 해보려고 한다. 모델이 돌려주는 확률이나 확신도를 코드에서 판단 기준으로 쓰려는 개발자를 위한 글이다. 끝까지 읽으면 정확도와 calibration이 어떻게 다른지, ECE가 무엇을 재는지, 그리고 사람의 선호로 다듬은 모델의 확률이 실제 적중률과 어떻게 어긋나는지와 그 원인이 어디까지 밝혀졌는지 설명할 수 있다.
필자는 TypeSafe AI가 공개한 결정 모델 Jev의 주장을 검증하면서 이 개념부터 정리해야 했다. Jev는 문장 대신 선택지마다 확률을 돌려주고, calibration을 학습 목표로 내세운다. 그 주장을 따지려면 calibration이 무엇이고 기존 모델에서 왜 어긋나는지부터 알아야 했다.
정확도와 calibration
먼저 정확도와 Calibration을 구분해야 한다. 정확도는 몇 퍼센트 맞히느냐이고, calibration은 자기가 몇 퍼센트 맞힐지를 아느냐다. 강수 확률 70%라고 한 날들만 모았을 때 실제로 열 번 중 일곱 번 비가 왔다면 그 예보는 calibration이 잘 된 것이다. 정확도가 높다는 뜻이 아니다. 자기 한계를 안다는 뜻이다. 60%만 맞히는 모델도 스스로 60%라고 말하면 calibration은 만점이다.
눈금이 어긋나는 방향은 둘이다. 모델이 말한 확률이 실제 적중률보다 높으면 overconfidence, 낮으면 underconfidence라고 한다. 말한 확률을 가로축에, 그 확률 구간의 실제 적중률을 세로축에 놓으면 둘이 갈리는 자리가 한눈에 보인다. 이렇게 그린 그림을 reliability diagram이라고 부른다.
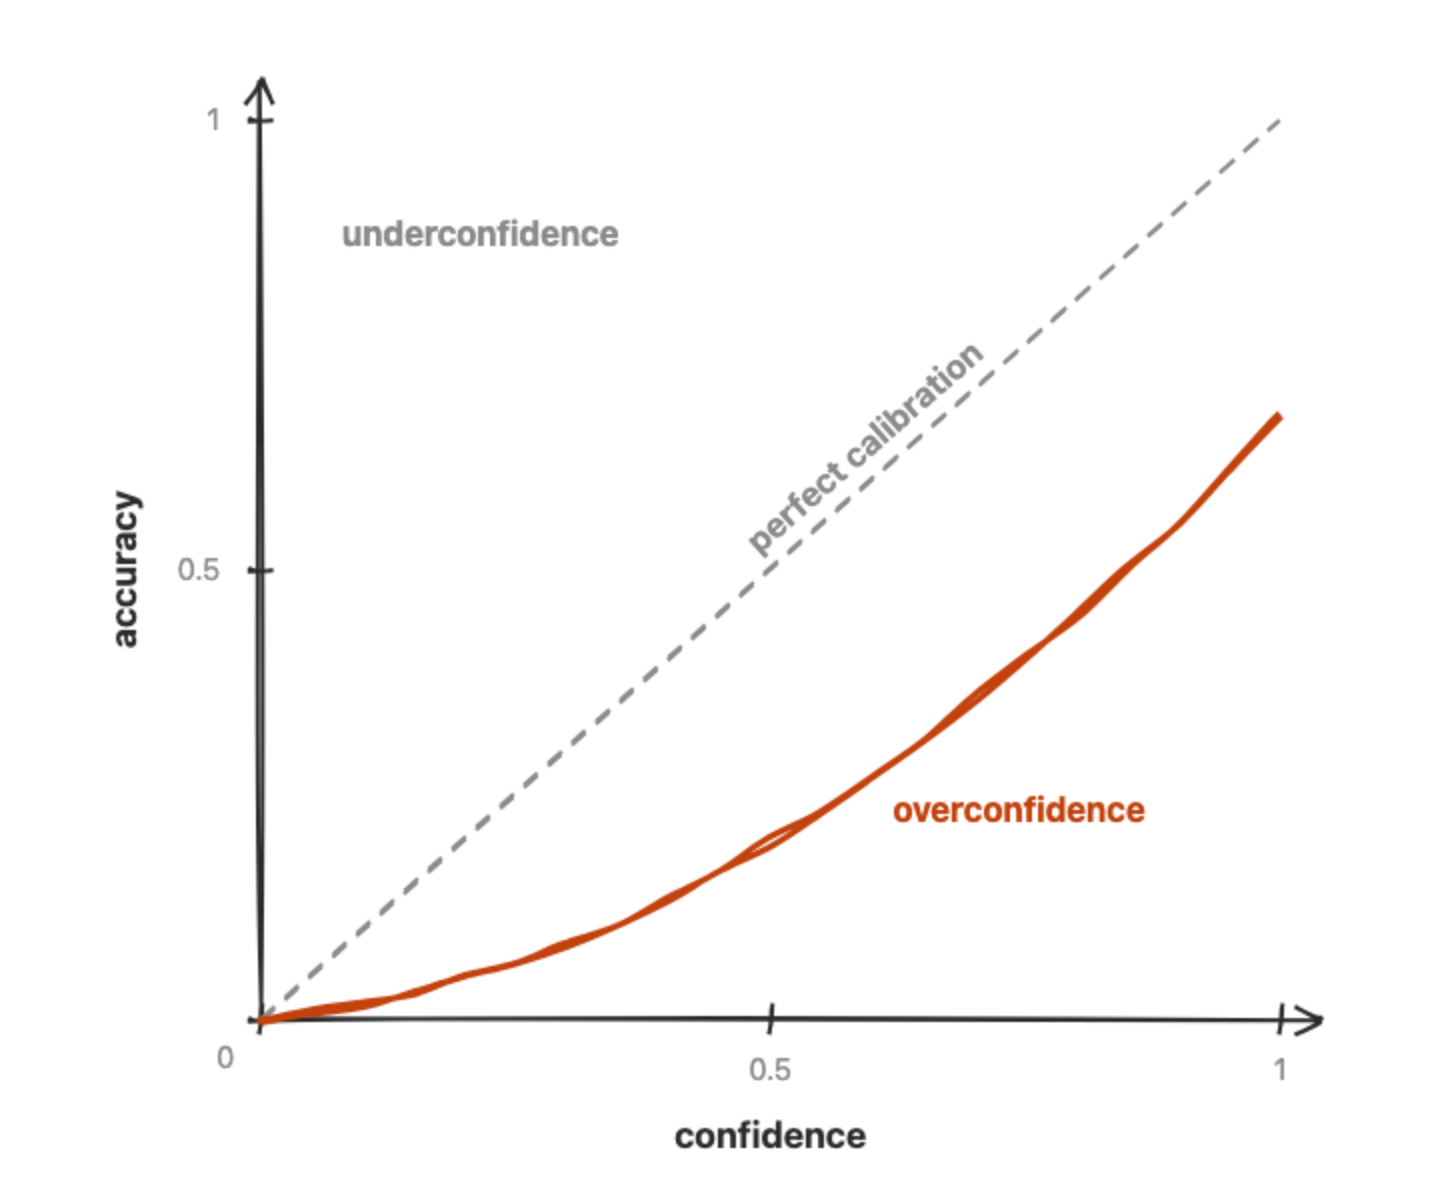
곡선이 대각선에 붙어 있으면 말한 만큼 맞힌 것이다. 대각선 아래로 처질수록 말한 확률에 비해 덜 맞힌다.
그 어긋남을 재는 지표가 ECE(expected calibration error)다. Guo et al. 2017의 정의를 따르면 확률 구간마다 "말한 확률"과 "실제 적중률"의 차이를 그 구간의 표본 비율로 가중해 평균한 값이고, 0이 완벽이다. 아래는 그 식을 옮긴 코드다. 10문제 중 6문제를 맞히는 모델이 매번 0.6이라고 말할 때와 매번 0.95라고 말할 때를 비교한다.
// Guo et al. 2017 의 식 (3). 구간은 등간격 10개(논문 실험은 15개), 경계는 왼쪽 닫힘
function ece(preds, M = 10) {
  const bins = Array.from({ length: M }, () => ({ n: 0, hit: 0, conf: 0 }))
  for (const { p, correct } of preds) {
    const b = bins[Math.min(M - 1, Math.floor(p * M))]
    b.n++
    b.hit += correct ? 1 : 0
    b.conf += p
  }
  return bins.reduce(
    (sum, b) => (b.n ? sum + (b.n / preds.length) * Math.abs(b.hit / b.n - b.conf / b.n) : sum),
    0,
  )
}

// 10문제 중 6문제를 맞힌다
const answers = Array.from({ length: 10 }, (_, i) => ({ correct: i < 6 }))
console.log(ece(answers.map((a) => ({ ...a, p: 0.6 }))).toFixed(3)) // 매번 0.6 이라고 말할 때
console.log(ece(answers.map((a) => ({ ...a, p: 0.95 }))).toFixed(3)) // 매번 0.95 라고 말할 때
2026-10-08에 Node v24.16.0으로 돌린 결과다.
0.000
0.350
정확도는 둘 다 0.6이다. 말한 확률만 바뀌었는데 ECE는 0에서 0.35로 올라간다. 그런데 식에 절댓값이 들어 있어서 ECE는 어긋남의 크기만 재고 방향은 모른다. 매번 0.25라고 말하면서 6문제를 맞혀도 ECE는 똑같이 0.35다. overconfidence인지 underconfidence인지는 reliability diagram이나 평균 확신도에서 정확도를 뺀 값을 봐야 안다.
RLHF의 목표 함수
그렇다면 사람의 피드백으로 다듬은 모델은 왜 이 눈금이 어긋날까. 먼저 RLHF(reinforcement learning from human feedback)가 무엇을 최적화하는지 봐야 한다. 사람의 선호 비교로 보상 모델을 세우는 골격은 Christiano et al. 2017에서 나왔고, 이것을 언어 모델에 옮긴 초기 작업이 Ziegler et al. 2019이며, InstructGPT가 지시 따르기에 적용했다. 이때 끌어올리는 값은 사람의 선호를 흉내 낸 보상 모델의 점수다. 언어 모델 쪽 작업은 강화학습을 시작하기 전 모델에서 너무 멀어지지 않도록 KL penalty를 보상에 더하고, InstructGPT는 사전학습 데이터의 기울기도 섞었지만(PPO-ptx), 끌어올리는 대상은 여전히 그 점수다.
챗봇에는 사람의 선호가 맞는 목표다. 문제는 그 선호가 불확실성을 드러낸 말투를 피하는 쪽으로 기울어 있다는 것이다. Zhou et al. 2024는 네 개의 공개 선호 데이터셋에서 주석자가 "I'm not sure, maybe" 같은 약화 표현이 든 답을 덜 고른다는 것을 보였다. 차이는 작지만 유의했다. 다만 확신을 강조한 표현이 든 답을 더 고르지는 않았다. Leng et al. 2025는 보상 모델이 답의 실제 품질과 상관없이 높은 확신 점수를 적은 답에 점수를 더 준다는 것을 보였다. 둘 다 토큰 확률이 아니라 문장 속 확신 표현(verbalized confidence)에 대한 결과다. RLHF를 대신할 학습법을 내놓은 TypeSafe도 자사의 입문 문서에서 RLHF가 자신 있게 들리는 환각(confident-sounding hallucinations)을 보상할 수 있다고 적는다. 대안을 파는 쪽의 입장이다.
GPT-4의 calibration 곡선
토큰 확률에서도 같은 방향의 어긋남이 관측됐다. GPT-4 기술 보고서 본문의 Figure 8은 사전학습 모델과 post-training 모델의 reliability diagram을 나란히 놓는데, 캡션이 이렇다.
Right: Calibration plot of the post-trained GPT-4 model on the same subset of MMLU. The post-training hurts calibration significantly.
가로축은 MMLU 객관식 문제의 보기 A, B, C, D 각각에 모델이 매긴 확률(logprob)이고, 세로축은 그 구간의 실제 적중률이다. Figure 8에 찍힌 숫자로는 사전학습 모델의 ECE가 0.007이고 PPO(RLHF에서 보상 모델의 점수를 높이는 쪽으로 모델을 갱신할 때 쓰는 강화학습 알고리즘)를 거친 모델이 0.074다. 열 배 넘게 나빠졌다.
Figure 8의 오른쪽(PPO) 패널에서 0.4 이상 구간의 막대는 대각선 아래에 있지만 0.1에서 0.3 사이 구간은 오히려 대각선 위다. 0.1에서 0.9 사이 막대는 실제 적중률 약 0.3에서 0.5에 평평하게 몰려 있어서, 모델이 말하는 확률이 올라가도 적중률이 거의 따라 오르지 않는다. 0.074에는 이 underconfidence 구간도 섞여 있다. 그리고 Guo et al.이 지적했듯이 reliability diagram은 구간마다 표본이 몇 개인지 보여주지 않으므로, 막대가 대각선에서 떨어진 거리와 그 구간이 ECE에 보탠 몫은 비례한다고 볼 수 없다.
이 패널은 위 개념도와 두 가지가 다르다. 먼저 개념도의 곡선처럼 대각선 아래로만 처지지 않고, 대각선을 한 번 가로지른다. 또 보기 네 개의 확률을 전부 구간에 넣었으므로, 위 코드처럼 고른 답 하나의 확률로 재는 정의와도 다르다. 그래서 0.074와 위 코드의 0.35를 같은 눈금에 놓고 비교하지는 않는다.
그러면 왜 나빠졌을까. 보고서 본문은 사전학습 모델이 잘 calibration되어 있었고 post-training 뒤에 calibration이 줄었다고만 적고, 원인은 말하지 않는다. 단서는 Anthropic의 Kadavath et al. 2022에 있다. 이들이 자기 언어 모델로 학습한 RLHF 정책은 겉보기에 calibration이 매우 나빴다. 논문은 이것이 놀랍지 않다며, RL fine-tuning이 보상을 가장 많이 받는 행동 쪽으로 예측을 몰아주는 경향이 있기 때문이라고 적었다. 본론이 아니라 짧게 덧붙인 실험이다. 그런데 모든 평가에 같은 온도 T=2.5 하나를 적용하자 세 평가에서 calibration 문제가 대부분 풀렸다. 온도는 logit을 나누는 값이고, 1보다 크면 답의 순서는 그대로 둔 채 확률 분포만 평평하게 편다. 필자는 값 하나로 대부분 풀렸다는 결과를, 어긋남이 일부 구간에 몰린 것이 아니라 분포 전체가 한쪽으로 좁혀진 모양이라는 뜻으로 읽는다. 논문은 더 강한 RL 학습은 이렇게 고칠 수 없는 방식으로 calibration을 망가뜨릴 수 있다는 단서도 함께 달았다.
이것은 Anthropic 모델의 결과라서 Figure 8의 원인으로 바로 옮길 수는 없다. 앞 절의 연구들도 문장 속 확신 표현을 다뤘다. 사람이 불확실한 말투를 피한다는 결과와 토큰 확률의 어긋남을 직접 이어 주는 1차 근거는 필자가 찾지 못했다.
코드가 받는 확률
Figure 8의 확률은 토큰의 로그 확률이다. 같은 종류의 값을 받으려면 OpenAI API 명세대로 Chat Completions 요청에 logprobs를 true로 주고, top_logprobs로 토큰 위치마다 받을 후보 수를 0에서 20 사이로 정한다. 모델에게 답과 함께 확신도를 숫자로 말하게 해서 받는 값은 문장으로 말한 확신이고, 토큰 확률과는 다른 값이다.
두 값을 다룬 연구는 서로 다른 짝을 비교한다. Tian et al. 2023은 ChatGPT, GPT-4, Claude 같은 RLHF 모델 안에서 문장으로 말한 확신이 조건부 확률보다 대체로 calibration이 좋았고, 세 벤치마크에서 ECE를 상대적으로 50% 가량 줄인 경우가 많았다고 보고했다. 다만 이 비교에서 가중치가 공개되지 않은 모델의 조건부 확률은 API의 토큰 확률이 아니라 같은 질문을 10번 샘플링해 답이 나온 비율로 추정한 값이다. 앞서 본 Leng et al.은 RLHF 이전 모델과 견주어 RLHF 모델이 문장으로 말한 확신에서 더 overconfident하다고 보고했다. 두 결과는 함께 성립할 수 있다. 그리고 0.074는 2023년 GPT-4 post-training 모델이 MMLU 일부에서 낸 값이라, 지금 API로 부르는 모델에 그대로 옮길 수 없다.
마무리
정리하면, calibration은 몇 퍼센트 맞히느냐가 아니라 자기가 몇 퍼센트 맞힐지 아느냐의 문제이고, ECE는 그 어긋남의 크기를 재는 숫자다. 방향은 reliability diagram이나 평균 확신도에서 정확도를 뺀 값을 봐야 안다. RLHF는 사람의 선호를 흉내 낸 보상 모델의 점수를 끌어올린다. Kadavath et al.은 그 최적화가 보상을 많이 받는 쪽으로 예측을 좁히는 경향이 있다고 본다. 사람은 불확실성을 드러낸 답을 덜 고르고, 보상 모델은 품질과 상관없이 높은 확신 점수를 적은 답에 점수를 더 준다는 연구가 있다. GPT-4에서는 post-training 뒤 ECE가 0.007에서 0.074로 찍혔지만, OpenAI는 그 원인까지 적지는 않았다. 코드가 받는 확률이 토큰 확률인지 문장으로 말한 확신인지에 따라 calibration도 다르게 나오므로, 어느 쪽이든 자기 데이터에서 다시 재야 한다.
Calibration을 학습 목표로 내세운 결정 모델 Jev의 확률이 실제로 정직한지는 결정 모델, Jev와 Kev에서 다룬다.
이 글을 읽는 독자 분들도 모델이 돌려준 확률을 코드에 임계값으로 박기 전에, 그 모델이 무엇을 목표로 학습됐고 자기 데이터에서 눈금이 맞는지 한 번쯤 재 보시길 바란다.