Dónde colocar ErrorBoundary
En esta entrada quiero hablar de dónde se reciben los errores que llegan. En Propagación de errores lancé el mismo error desde siete sitios y conté dónde aterrizaba cada uno. Esta entrada trata de colocar un receptor en cada uno de esos destinos.
Cuando conoces las rutas de propagación, la siguiente pregunta llega sola. ¿Cuántos ErrorBoundary poner y dónde? Si basta con uno, si hace falta uno por pantalla, y si lo que da la librería se solapa con lo que escribiste tú, se decide aquí.
Empiezo por la conclusión: el número de ErrorBoundary no es cuestión de gusto, lo deciden dos cosas. Qué lanza y qué tiene que quedar en pantalla cuando eso muere. Lo primero se trató en la parte 1, así que esta entrada arranca por lo segundo.
El alcance que puedes permitirte
Cuando alguien pregunta dónde poner un ErrorBoundary, suele pensar en qué componente envolver. Esa pregunta no tiene respuesta. Siempre hay varios componentes que podrías envolver, y el código funciona elijas el que elijas.
Hay que preguntarlo de otro modo. Si esto muere, ¿qué tiene que quedar en pantalla?
La respuesta cambia según el sitio. Si falta el dato que forma el esqueleto de una pantalla, esa pantalla no se sostiene. Un botón de acción solo, sin nombre ni estado al lado, no significa nada. Al revés, si falla una lista secundaria y tapas la pantalla entera, el usuario pierde todo lo demás que podía ver perfectamente. Las acciones difíciles de deshacer son otra cosa. Hay que avisar del fallo en el mismo sitio donde se pulsó.
Lo que hace un ErrorBoundary no es atrapar el fallo, sino decidir el área sobre la que se dibuja el fallback. El fallback es lo que dibujas en lugar de la pantalla original cuando algo falla. Desaparece todo lo que envolviste. Por eso la posición de un ErrorBoundary no la decide lo que quieres atrapar, sino el alcance que puedes permitirte.
Ese alcance se divide en cuatro niveles.
| Capa | Qué recibe | Con qué se deshace |
|---|---|---|
| Ruta | lo que lanzó el loader, lo que nadie atrapó más abajo | revalidate() |
| Pantalla | lo lanzado durante el render | resetErrorBoundary() |
| Región | lo lanzado dentro de ella | resetErrorBoundary() |
| Dentro del componente | un useQuery fallido, una mutation fallida |
refetch(), un toast |
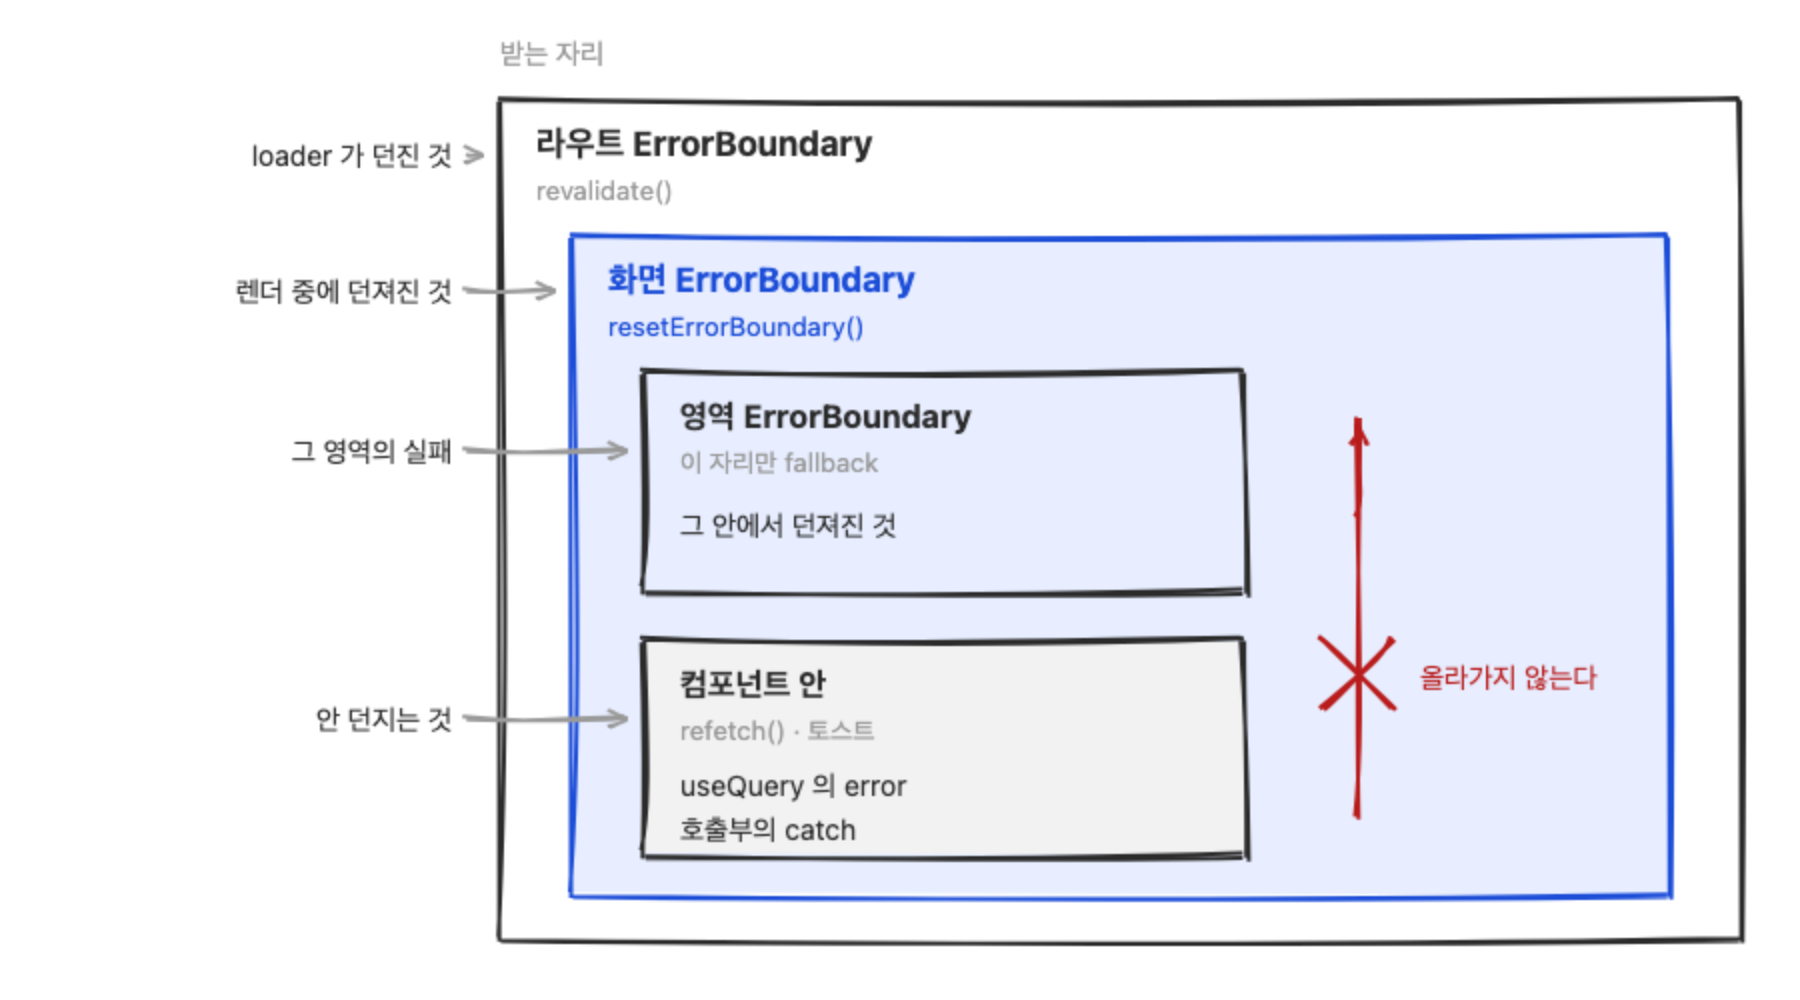
Son cuatro nombres pero solo dos tipos. Solo el ErrorBoundary de ruta es del router; los otros dos son el ErrorBoundary que colocas en el árbol. El ErrorBoundary de pantalla y el ErrorBoundary de región son el mismo componente y solo cambia dónde está enganchado. La fila de abajo, dentro del componente, no es un ErrorBoundary sino una rama que el propio componente dibuja.
Las secciones siguientes ven por qué no puedes borrar ninguna fila de esta tabla.
Tres capas que no puedes borrar
Cuando instalas react-error-boundary, el lado del router parece borrable. Como los nombres coinciden, los trabajos también lo parecen. Pero hay tres razones por las que no puedes borrar ninguno. Las tres que cuento aquí son ruta, pantalla y región de la tabla de arriba. Dentro del componente queda fuera porque no es un ErrorBoundary.
El loader vive fuera de ErrorBoundary
Es exactamente lo que vimos en la parte 1. Un ErrorBoundary es una clase construida con getDerivedStateFromError y componentDidCatch, así que solo le llega lo que React atrapó dentro del árbol. El loader es una función que corre fuera del árbol, antes de que empiece el render. Lo que lanza ahí no pasa por React, así que por mucho que lo envuelvas no se ve.
Por eso, si aunque sea una ruta usa loader, no puedes borrar el ErrorBoundary de ruta. En cuanto lo borras, ese fallo se queda sin sitio adonde ir.
La caché que revalidate no puede limpiar
La dirección contraria también está cerrada. El mecanismo de recuperación del ErrorBoundary de ruta es revalidate(), y eso solo vuelve a ejecutar el loader: no toca la caché de queries.
Piensa en una ruta sin loader. Si un useSuspenseQuery dentro de la pantalla falla, al final también lo recibe el ErrorBoundary de ruta. El router envuelve el árbol de rutas en una clase propia llamada RenderErrorBoundary, y esa clase también tiene getDerivedStateFromError. Pero pulsar reintentar en ese ErrorBoundary no sirve de nada: no hay loader que volver a ejecutar y el error clavado en la caché sigue ahí. Lo recibió, pero no tiene con qué deshacerlo.
Recibir y deshacer son trabajos distintos. Si no miras los dos al colocar un ErrorBoundary, acabas con un fallback que recibe cosas que nadie puede limpiar.
El ErrorBoundary de abajo estrecha el alcance
El tercero no es quedarse bloqueado, sino perder demasiado.
Cuando algo falla, el router elige un ErrorBoundary. Cómo lo elige está en el código.
function findNearestBoundary(matches, routeId) {
  let eligibleMatches = routeId ? matches.slice(0, matches.findIndex((m) => m.route.id === routeId) + 1) : [...matches];
  return eligibleMatches.reverse().find((m) => m.route.hasErrorBoundary === true) || matches[0];
}
Recorre las rutas emparejadas desde el final, elige la primera que tenga ErrorBoundary y, si no hay ninguna, lo manda a la primera de todas. Si el hijo de una ruta anidada no tiene ErrorBoundary, ese papel lo asume el padre, y si el padre tampoco lo tiene, lo asume la raíz.
Cuando lo asume la raíz, la pantalla entera desaparece. Solo falló una región interior, pero se van con ella la cabecera y la navegación. Engancha un ErrorBoundary a la ruta hija y el fallback se dibuja solo en el hueco de <Outlet />.
Por eso poner un ErrorBoundary más abajo no es duplicar. No atrapa el mismo fallo dos veces: cambia hasta dónde se borra. Una disposición que parece tres límites solapados es en realidad tres cosas distintas recibidas con tres alcances distintos.
Entre el ErrorBoundary de región y dentro del componente
Una vez dividida la cosa en cuatro capas, queda una última bifurcación. Para una región sin la que la pantalla se sostiene, eliges entre subirla a un ErrorBoundary o recibirla ahí mismo.
De cualquiera de las dos maneras pierdes solo esa región y conservas el resto. Lo que cambia no es cuánto pierdes, sino qué dibujas ahí en su lugar.
Subirlo a un ErrorBoundary reduce el código. Si llamas a useSuspenseQuery dentro, ese componente no tiene ni isPending ni isError. La espera la recibe el Suspense de fuera y el fallo, el ErrorBoundary de fuera. El componente solo dibuja el caso en que hay datos.
<section>
  <h2>댓글</h2>
  <QueryAsyncBoundary pendingFallback={<p>불러오는 중</p>}>
    <CommentList postId={postId} />
  </QueryAsyncBoundary>
</section>
A cambio, esa región entera se convierte en el fallback. Si es un sitio como una lista, donde no queda nada que salvar si se va entera, no pierdes nada.
Recibirlo ahí mismo es lo contrario. Llamas a useQuery y dibujas tú los cuatro estados (espera, fallo, resultado vacío, resultado). Se multiplican las ramas, pero a cambio puedes poner textos y acciones ajustados a ese sitio. Si quieres un botón pequeño de reintentar solo en la fila que falló, es por aquí. Si lo subes a un ErrorBoundary, la forma de esa fila la decide el componente de fallback, que suele ser el compartido con el ErrorBoundary de pantalla y resulta excesivo para el fallo de una sola fila.
El criterio queda así. Si la región puede desaparecer entera, mejor ErrorBoundary; si hacen falta textos o acciones ajustados a ese sitio, mejor useQuery. El ErrorBoundary te quita las ramas del componente, pero se lleva con ellas la libertad de decidir la pantalla.
Si decides no subirlo a un ErrorBoundary, tienes que tratar los cuatro estados.
const { data, isPending, isError, refetch, isRefetching } = useQuery(commentsOptions(postId))

if (isPending) return <p>불러오는 중</p>

if (isError) {
  return (
    <div role="alert">
      <p>댓글을 불러오지 못했어요</p>
      <button onClick={() => refetch()} disabled={isRefetching}>재시도</button>
    </div>
  )
}

if (data.length === 0) return <p>아직 댓글이 없어요</p>
Si te dejas isError, el fallo se cuela en silencio hacia el estado vacío. El data de una query fallida es undefined, y una comprobación como data == null || data.length === 0 no distingue ese undefined de un array vacío. En pantalla sale que todavía no hay comentarios mientras el servidor está devolviendo un 500 en ese mismo momento.
Si filtras isError primero, más abajo data se estrecha a un array y desaparece la comprobación == null.
Un fallback distinto por capa
Colocadas las capas, toca decidir qué dibuja cada una en pantalla. Aquí vuelven a separarse el ErrorBoundary de ruta y el ErrorBoundary que colocas en el árbol, y el criterio para elegir no es el gusto, sino cómo recibe el error esa capa.
El ErrorBoundary de ruta lo lee solo
Al ErrorBoundary de ruta no hace falta pasarle el error al fallback. El componente lo lee directamente con useRouteError() y también consigue el mecanismo de recuperación por su cuenta.
export function RootErrorBoundary() {
  const error = useRouteError()
  const { revalidate, state } = useRevalidator()

  return <ErrorFallback error={error} onRetry={revalidate} retrying={state === 'loading'} />
}
Así que a la ruta solo hay que enchufarle el componente. El ErrorBoundary de una ruta hija tiene la misma forma y usa los mismos hooks. Lo que los separa no es el código sino la ruta a la que están enganchados. En qué ruta se enganchó es exactamente el alcance sobre el que se dibuja el fallback.
El ErrorBoundary que lo pasa hacia abajo
En react-error-boundary, el ErrorBoundary es lo contrario. Como tiene él mismo el error y la función de reset, tiene que pasárselos al fallback. Por eso hay tres props, y la definición de tipos ata las tres como mutuamente excluyentes.
fallback recibe un elemento ya terminado tal cual. Se escribe así: fallback={<p role="alert">댓글을 불러오지 못했어요</p>}. No te da ni el error ni la función de reset. Solo sirve cuando el mensaje es fijo y tampoco hay forma de reintentar.
FallbackComponent recibe un componente y le pasa error y resetErrorBoundary como props. Queda limpio cuando varios ErrorBoundary comparten el mismo fallback, pero el nombre de la prop está fijado como resetErrorBoundary, así que quien lo recibe tiene que conocer ese nombre.
function CommentsFallback({ error, resetErrorBoundary }: FallbackProps) {
  return <ErrorFallback error={error} onRetry={resetErrorBoundary} />
}

<ErrorBoundary onReset={reset} FallbackComponent={CommentsFallback}>
  <CommentList postId={postId} />
</ErrorBoundary>
ErrorFallback recibe onRetry, así que los nombres no encajan. Eso cuesta un componente más cuyo único trabajo es mover el nombre de un lado a otro.
fallbackRender recibe una función y la renderiza ahí mismo.
<ErrorBoundary
  onReset={reset}
  fallbackRender={({ error, resetErrorBoundary }) => (
    <ErrorFallback error={error} onRetry={resetErrorBoundary} />
  )}
>
Yo elegí este. La razón es que puedes cambiar el nombre ahí mismo. Arriba, resetErrorBoundary pasó a ser onRetry. Gracias a eso, ErrorFallback se convierte en un componente que solo conoce error y onRetry, y revalidate como mecanismo del ErrorBoundary de ruta y resetErrorBoundary como mecanismo del ErrorBoundary del árbol: los dos usan el mismo fallback.
Que las pantallas de dos capas no se desalineen es lo que compra esta elección. Si divides en cuatro capas, las pantallas de fallo que ve el usuario corren el riesgo de ser también cuatro, y cambiar un nombre una vez las convierte en una.
Tres casos en los que reintentar no hace nada
Le puse al fallback un botón de reintentar. Es ese botón que pulsa el usuario para deshacer un fallo. Vamos a pulsarlo. No hace nada. Vuelve a salir la misma pantalla.
Aparece por tres razones y cada una se resuelve de otra manera. Tienen una cosa en común. Un ErrorBoundary solo deshace su propio estado. El estado que tiene quien lanzó hay que limpiarlo en quien lanzó.
El error de query que reset limpia
Lo único que hace resetErrorBoundary() es devolver la bandera interna del ErrorBoundary. Los children se vuelven a montar y la query se vuelve a suscribir. Pero esa query está clavada en la caché en estado de error. Así que lanza de inmediato el mismo error otra vez y el ErrorBoundary vuelve a dibujar el fallback.
Por qué usa el error viejo en lugar de volver a pedir también está en el código. errorBoundaryUtils.js lo bloquea así.
if (options.suspense || throwOnError) {
  if (!errorResetBoundary.isReset()) options.retryOnMount = false;
}
Hay que leer primero la guarda de fuera. Este bloqueo solo afecta a las queries que lanzan. Una query con suspense, o con throwOnError activado, que se monte sin la marca de reset se queda con el reintento apagado. Un useQuery que no lanza no entra ahí y, al volver a montarse, simplemente vuelve a pedir.
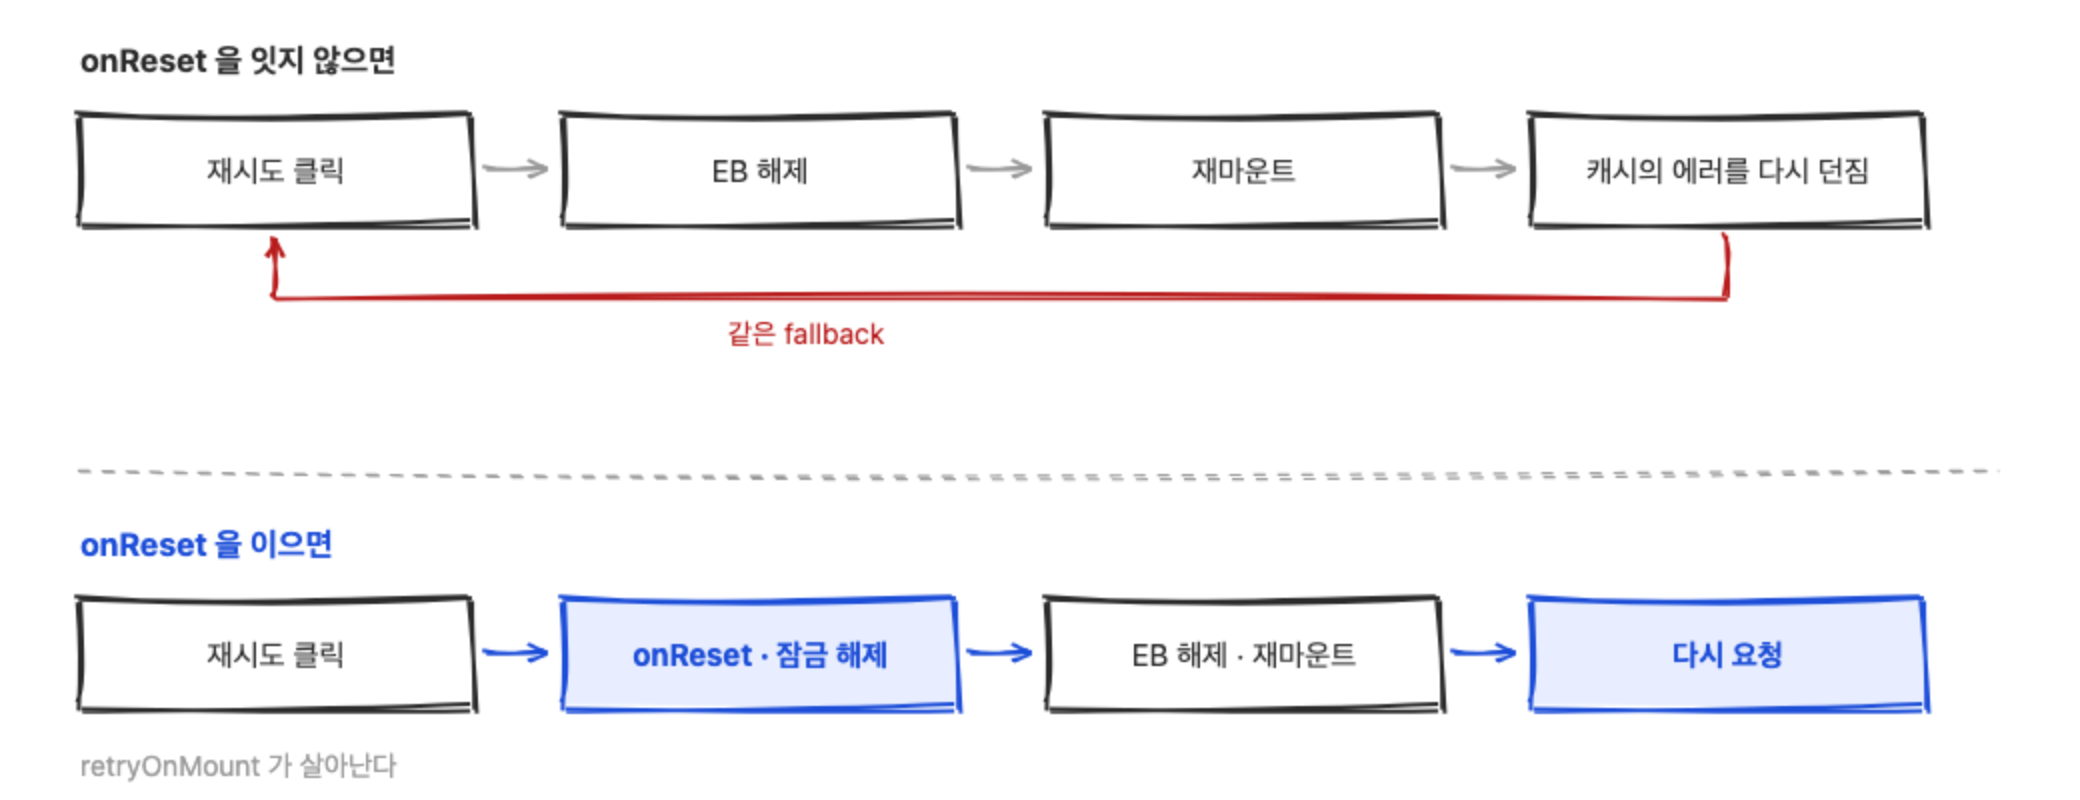
Lo que se bloquea es solo la query subida a un ErrorBoundary, y por eso hay que limpiar los dos estados a la vez. Quien levanta esa marca es QueryErrorResetBoundary. Si abres el código, el estado es un solo booleano.
reset: () => {
	isReset = true;
},
Basta con conectar este reset al ErrorBoundary, en su onReset. La documentación de TanStack Query y los comentarios del código traen el mismo cableado como ejemplo.
export function QueryAsyncBoundary({ children, pendingFallback }: Props) {
  return (
    <QueryErrorResetBoundary>
      {({ reset }) => (
        <ErrorBoundary
          onReset={reset}
          fallbackRender={({ error, resetErrorBoundary }) => (
            <ErrorFallback error={error} onRetry={resetErrorBoundary} />
          )}
        >
          <Suspense fallback={pendingFallback}>{children}</Suspense>
        </ErrorBoundary>
      )}
    </QueryErrorResetBoundary>
  )
}
El orden importa. Y ese orden lo garantiza react-error-boundary. Es un archivo compilado, así que los nombres se han quedado en una letra, pero la estructura se lee igual.
resetErrorBoundary(...e) {
  const { didCatch: t } = this.state;
  t && (this.props.onReset?.({ args: e, reason: "imperative-api" }), this.setState(d));
}
Están unidos por el operador coma, así que onReset corre primero y setState va después. d es el estado inicial con didCatch en false. Por eso los children se vuelven a montar después de haberse soltado el bloqueo de la caché. Una línea de diferencia es lo que convierte el reintento en un reintento de verdad.
Ponerle Query en el nombre también es intencionado. Si lo llamas AsyncBoundary se lee como si sirviera para cualquier asincronía, y no es así, porque dentro lleva QueryErrorResetBoundary. Por la misma razón no le puse valor por defecto a pendingFallback. Con un valor por defecto, mirando solo la línea de la llamada no sabes qué se está poniendo debajo.
El error de render que reset no puede limpiar
El segundo es el caso que vimos en la parte 1. El servidor devuelve un 200 con una forma distinta de la esperada y el render que la lee lanza un TypeError. Lo recibió el mismo ErrorBoundary y onReset está conectado, pero reintentar no hace nada.
Lo que reset limpia es una query en estado de error. Pero esta query tuvo éxito. El servidor dio un 200 y la caché guarda ese valor como dato normal. Quien produjo el error fue el render que lo leyó. Así que reset no tiene nada que limpiar, y el componente remontado recibe la misma caché, con el staleTime todavía vigente, y vuelve a lanzar en la misma línea.
El sitio donde se arregla es queryFn.
queryFn: async () => {
  const data = await getComments(postId)
  if (!Array.isArray(data.comments)) {
    throw new TypeError('comments 가 배열이 아니다')
  }
  return data.comments
},
En la parte 1 dije que el sitio donde acaban los tipos es el sitio donde poner una comprobación en tiempo de ejecución. Ese sitio es este. Si subes esa comprobación a queryFn, el mismo fallo se convierte en el error de la query. Se queda en la caché en estado de error, reset lo limpia y el reintento vuelve a pedir.
Si aplazas la comprobación en tiempo de ejecución porque total ya la recibe el ErrorBoundary, acabas con un fallback que recibe pero no puede deshacer.
El lazy que solo arregla una recarga
El tercero es un fallo al cargar un chunk. Esta vez no tienen nada que ver ni reset ni queryFn. Quien guarda el estado es el propio lazy.
Como vimos en la parte 1, el lazyInitializer de React apunta el rechazo en payload y a partir de ahí lanza siempre lo mismo.
throw payload._result;No vuelve a hacer import(). La llamada a lazy() ocurrió una vez en el nivel superior del módulo y ese payload se queda igual mientras viva la aplicación. Aunque sueltes el ErrorBoundary y se vuelva a montar, vuelve el mismo error.
Por eso recuperarse de este fallo es volver a descargar la página. También significa que se ha desplegado una versión nueva, así que es mejor decírselo así al usuario.
Puestos los tres casos uno al lado del otro, un solo botón de reintentar tiene que hacer tres trabajos distintos. El error de query se resuelve con reset, el error de render convirtiéndolo antes en error de query en queryFn, y el fallo de chunk con una recarga. El ErrorBoundary no hace ninguno de los tres por ti.
Fallos a los que no poner reintentar
Separados los fallos recuperables de los que no lo son, hay que separar también el botón.
Enseñar el mismo botón en todos los fallos es guiar al usuario hacia una acción que no puede hacer. Si pulsas reintentar en un 404 vuelve el mismo 404. Un 403 por falta de permisos es igual. El fallo al cargar un chunk directamente no hace nada, por lo que vimos en la sección anterior.
Basta con separarlo una vez dentro del fallback compartido.
function describe(error: unknown) {
  if (isChunkLoadError(error)) {
    return { title: '새 버전이 배포됐어요', description: '새로 고침하면 이어서 볼 수 있어요.', action: 'reload' }
  }

  const status = isHttpError(error) ? error.status : isRouteErrorResponse(error) ? error.status : undefined

  if (status === 404) {
    return { title: '찾을 수 없어요', description: '주소가 바뀌었거나 삭제된 항목이에요.', action: null }
  }
  if (status !== undefined && status >= 400 && status < 500) {
    return { title: '요청을 처리할 수 없어요', description: '입력한 내용을 다시 확인해 주세요.', action: null }
  }
  return { title: '불러오지 못했어요', description: '잠시 후 다시 시도해 주세요.', action: 'retry' }
}
Hay una razón para que isRouteErrorResponse esté aquí también. Como el ErrorBoundary de ruta y el ErrorBoundary del árbol comparten fallback, esta función recibe los dos tipos de error. Leer el código de estado de un Response que lanzó el router y leerlo de un error HTTP que construiste tú funcionan de manera distinta, así que mira los dos.
No hace falta montar una ramificación enorme desde el principio. Basta con separar los fallos que dan otro resultado al volver a pulsar de los que no.
Cuándo ve el fallo el ErrorBoundary
Colocados todos los ErrorBoundary, todavía queda uno. ¿Cuándo mira el ErrorBoundary?
Las capas se decidieron de arriba abajo, pero el orden de ejecución es el contrario. El ErrorBoundary no ve nada hasta que se han agotado todos los reintentos. Por eso la condición de reintento es parte del diseño del ErrorBoundary.
El valor por defecto cambia según el sitio. Los dos usan el mismo createRetryer, pero le pasan valores distintos. La query no pasa nada, así que recibe el valor por defecto de retryer.js.
const retry = config.retry ?? (isServer() ? 0 : 3);La mutation mete un 0 directamente en mutation.js.
retry: this.options.retry ?? 0,Que la mutation esté a 0 significa que, en cuanto una petición acaba en error, esa acción falla de inmediato. Que las acciones difíciles de deshacer no tengan reintentos es un valor por defecto seguro, pero si la acción es idempotente, mandarla una vez más es mejor para el usuario.
Es mejor declarar la misma condición en los dos lados.
const MAX_RETRY = 2

export function retryOnServerError(failureCount: number, error: unknown): boolean {
  if (failureCount >= MAX_RETRY) return false
  return !isHttpError(error) || error.status >= 500
}
failureCount empieza en 0 y en el primer fallo pregunta con 0. Así que con MAX_RETRY en 2 manda tres peticiones en total y para. Es el número de reintentos, no el número de intentos.
Dejar fuera los 4xx es lo esencial. La petición en sí está mal, así que por muchas veces que la mandes vuelve la misma respuesta. Pero la razón para dejarlos fuera no es solo el desperdicio: el retardo por defecto crece de forma exponencial.
function defaultRetryDelay(failureCount) {
	return Math.min(1e3 * 2 ** failureCount, 3e4);
}
El primer reintento es 1 segundo y el siguiente 2, así que con solo dos reintentos se van 3 segundos. Si no filtras los 4xx, estás escondiendo durante 3 segundos un fallo que no tiene arreglo.
Los errores de render y los fallos de chunk no tienen ese tiempo. Como no sale ninguna petición, no hay reintento alguno y el ErrorBoundary lo ve en el momento en que se lanza. Por eso el mismo fallback sale 3 segundos después en unos fallos y al instante en otros.
Hay una premisa que comprobar antes de activar los reintentos. ¿Esa petición es idempotente? Mandar la misma petición dos veces tiene que dar el mismo resultado. Si el servidor no lo garantiza, reintentar es una función que fabrica bugs.
Para terminar
En la parte 1 traté adónde van los errores, y en esta entrada decidí qué poner en esos sitios. Resumiendo:
- La posición de un
ErrorBoundaryla decide el alcance que puedes permitirte. No preguntas qué envolver, sino qué tiene que quedar cuando esto muere. - No puedes borrar ninguna de las tres capas de
ErrorBoundary. Lo que lanzó el loader no lo recibe elErrorBoundarydel árbol,revalidateno limpia la caché de queries, y poner uno más abajo es estrechar el alcance. - Si la región se puede tirar entera,
ErrorBoundary; si hacen falta textos propios de ese sitio,useQuery. Si eliges lo segundo, tienes que tratar los cuatro estados. - Si cambias el nombre con
fallbackRender, el fallback queda unificado aunque las capas sean distintas. - Reintentar solo funciona si limpias el estado que tiene quien lanzó. La query es
reset, el error de render se sube aqueryFn, y el chunk es una recarga. - Cuándo ve el fallo el
ErrorBoundarylo decide la condición de reintento. Si no filtras los 4xx, escondes unos segundos un fallo sin arreglo.
Se puede preguntar si no basta con un ErrorBoundary y un toast. Para un producto de dos o tres pantallas suena razonable y, de hecho, el número de capas lo decide el producto. Si solo hay una pantalla, solo hay una pantalla que ceder, así que las diferencias de alcance no se ven. Cuantas más regiones independientes haya dentro de una pantalla, mayor se hace esa diferencia.
Aun así, hay algo que queda al margen del número. Pongas los ErrorBoundary que pongas en el árbol, lo que lanzó loader no va allí, y reintentar no funciona si no limpias el estado que tiene quien lanzó. Lo que puedes reducir son las capas, no estos hechos.