LLMのキャリブレーションと過信
今回の記事では、モデルのキャリブレーションと、RLHF の後に現れる過信について話してみたい。モデルが返す確率や確信度を、コードの中で判断基準として使いたい開発者のための記事だ。最後まで読めば、正解率とキャリブレーションがどう違うのか、ECE が何を測るのか、そして人の選好で仕上げたモデルの確率が実際の的中率とどうずれるのか、その原因がどこまで明らかになっているのかを説明できるようになる。
筆者は TypeSafe AI が公開した決定モデル Jev の主張を検証する中で、まずこの概念を整理する必要があった。Jev は文章の代わりに選択肢ごとの確率を返し、キャリブレーションを学習目標に掲げている。その主張を検討するには、キャリブレーションとは何か、既存のモデルでなぜずれるのかを先に知る必要があった。
正解率とキャリブレーション
まず正解率とキャリブレーションを区別しなければならない。正解率は何パーセント当てるかであり、キャリブレーションは自分が何パーセント当てるかを知っているかどうかだ。降水確率70%と言った日だけを集めたとき、実際に10回のうち7回雨が降ったなら、その予報はキャリブレーションがよく取れている。正解率が高いという意味ではない。自分の限界を知っているという意味だ。60%しか当てないモデルでも、自分で60%だと言えばキャリブレーションは満点である。
目盛りがずれる方向は二つある。モデルが言った確率が実際の的中率より高ければ overconfidence(過信)、低ければ underconfidence と呼ぶ。言った確率を横軸に、その確率区間の実際の的中率を縦軸に置くと、二つが分かれる場所がひと目で見える。こうして描いた図を reliability diagram と呼ぶ。
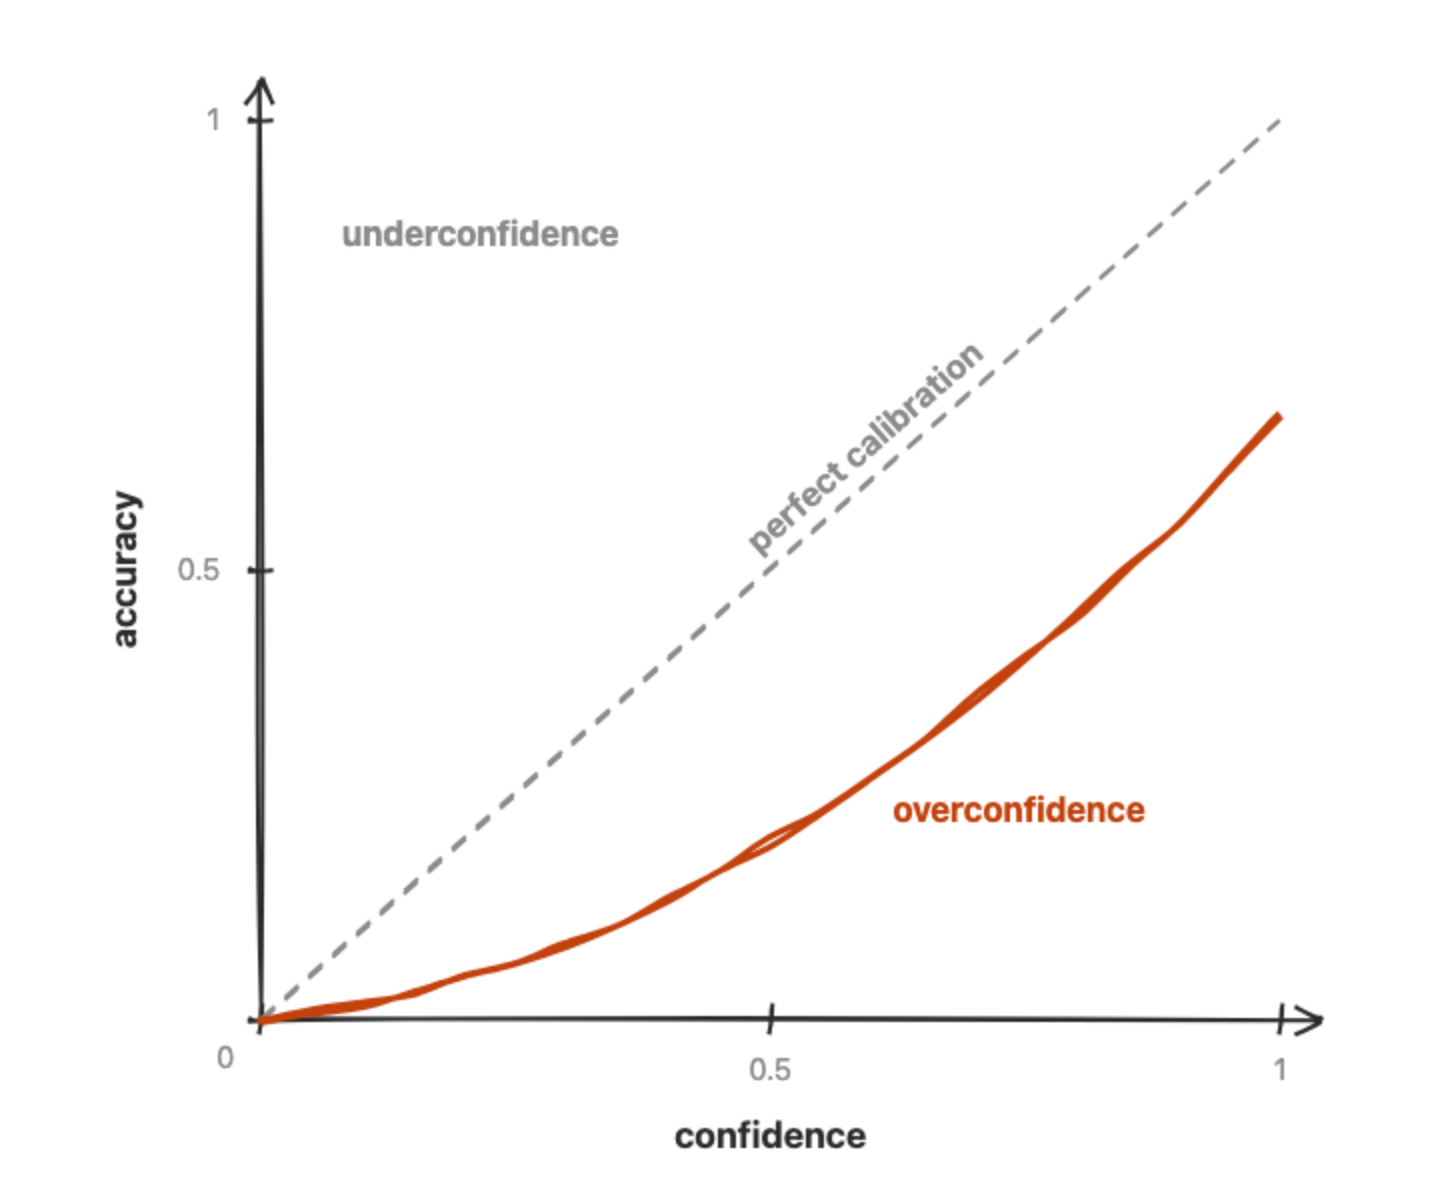
曲線が対角線の上に乗っていれば、言ったとおりに当てたということだ。対角線の下に垂れるほど、言った確率に比べて当たらない。
そのズレを測る指標が ECE(expected calibration error)だ。Guo et al. 2017 の定義に従えば、確率の区間ごとに「言った確率」と「実際の的中率」の差を、その区間の標本比率で重み付けして平均した値で、0が完璧である。下はその式を写したコードだ。10問中6問を当てるモデルが、毎回0.6と言う場合と毎回0.95と言う場合を比べる。
// Guo et al. 2017 의 식 (3). 구간은 등간격 10개(논문 실험은 15개), 경계는 왼쪽 닫힘
function ece(preds, M = 10) {
  const bins = Array.from({ length: M }, () => ({ n: 0, hit: 0, conf: 0 }))
  for (const { p, correct } of preds) {
    const b = bins[Math.min(M - 1, Math.floor(p * M))]
    b.n++
    b.hit += correct ? 1 : 0
    b.conf += p
  }
  return bins.reduce(
    (sum, b) => (b.n ? sum + (b.n / preds.length) * Math.abs(b.hit / b.n - b.conf / b.n) : sum),
    0,
  )
}

// 10문제 중 6문제를 맞힌다
const answers = Array.from({ length: 10 }, (_, i) => ({ correct: i < 6 }))
console.log(ece(answers.map((a) => ({ ...a, p: 0.6 }))).toFixed(3)) // 매번 0.6 이라고 말할 때
console.log(ece(answers.map((a) => ({ ...a, p: 0.95 }))).toFixed(3)) // 매번 0.95 라고 말할 때
2026-10-08 に Node v24.16.0 で実行した結果だ。
0.000
0.350
正解率はどちらも0.6だ。言った確率が変わっただけなのに、ECE は0から0.35に上がる。ただし式に絶対値が入っているので、ECE はズレの大きさだけを測り、方向はわからない。毎回0.25と言いながら6問当てても、ECE はまったく同じ0.35になる。overconfidence なのか underconfidence なのかは、reliability diagram か、平均確信度から正解率を引いた値を見なければわからない。
RLHFの目的関数
では、人のフィードバックで仕上げたモデルは、なぜこの目盛りがずれるのだろうか。まず RLHF(reinforcement learning from human feedback)が何を最適化しているのかを見る必要がある。人の選好比較から報酬モデルを立てる骨格は Christiano et al. 2017 で生まれ、これを言語モデルに移した初期の仕事が Ziegler et al. 2019 で、InstructGPT が指示追従に適用した。このとき押し上げる値は、人の選好を真似た報酬モデルの点数だ。言語モデルでの仕事は、強化学習を始める前のモデルから離れすぎないよう引き留める KL penalty を報酬に加え、InstructGPT は事前学習データの勾配も混ぜたが(PPO-ptx)、押し上げる対象はやはりその点数である。
チャットボットにとって、人の選好は正しい目標だ。問題は、その選好が不確実さを表に出した口調を避ける側に傾いていることにある。Zhou et al. 2024 は、四つの公開選好データセットで、アノテーターが "I'm not sure, maybe" のような弱める表現を含む答えをあまり選ばないことを示した。差は小さいが有意だった。ただし、確信を強める表現を含む答えをより多く選んだわけではない。Leng et al. 2025 は、報酬モデルが答えの実際の品質と関係なく、高い確信度の数値を書いた答えに高い点数を与えることを示した。どちらもトークン確率ではなく、文章の中の確信表現(verbalized confidence)についての結果だ。RLHF に代わる学習法を打ち出した TypeSafe も、自社の入門ドキュメントで、RLHF が自信ありげに聞こえるハルシネーション(confident-sounding hallucinations)に報酬を与えうると書いている。代替案を売る側の立場である。
GPT-4のキャリブレーション曲線
トークン確率でも同じ方向のズレが観測されている。GPT-4 技術レポート本文の Figure 8 は、事前学習モデルと post-training モデルの reliability diagram を並べて置いているが、そのキャプションがこうだ。
Right: Calibration plot of the post-trained GPT-4 model on the same subset of MMLU. The post-training hurts calibration significantly.
横軸は MMLU の多肢選択問題の選択肢 A、B、C、D それぞれにモデルが付けた確率(logprob)で、縦軸はその区間の実際の的中率だ。Figure 8 に刻まれた数字では、事前学習モデルの ECE が 0.007 で、PPO(RLHF で報酬モデルの点数が上がる方向にモデルを更新するときに使う強化学習アルゴリズム)を経たモデルが 0.074 だ。10倍以上悪くなった。
Figure 8 の右(PPO)のパネルでは、0.4以上の区間の棒は対角線の下にあるが、0.1から0.3の区間はむしろ対角線の上だ。0.1から0.9の棒は実際の的中率およそ0.3から0.5に平らに集まっていて、モデルが言う確率が上がっても的中率はほとんどついてこない。0.074 にはこの underconfidence の区間も混ざっている。そして Guo et al. が指摘したように、reliability diagram は区間ごとの標本数を示さないので、棒が対角線から離れた距離と、その区間が ECE に足した分は比例するとは言えない。
このパネルは上の概念図と二つの点で異なる。まず、概念図の曲線のように対角線の下に垂れるだけでなく、対角線を一度横切る。また、選択肢四つの確率をすべて区間に入れているので、上のコードのように選んだ答え一つの確率で測る定義とも異なる。だから 0.074 と上のコードの 0.35 を同じ目盛りに置いて比べはしない。
では、なぜ悪くなったのか。レポート本文は、事前学習モデルはよくキャリブレーションされていて、post-training の後にキャリブレーションが下がったとだけ書き、原因は述べていない。手がかりは Anthropic の Kadavath et al. 2022 にある。彼らが自社の言語モデルから学習させた RLHF ポリシーは、見かけ上キャリブレーションがとても悪かった。論文はこれを驚くことではないとし、RL fine-tuning が最も多くの報酬を受ける振る舞いのほうへ予測を寄せる傾向があるからだと書いた。本題ではなく、短く添えた実験である。ところが、すべての評価に同じ温度 T=2.5 を一つ適用すると、三つの評価でキャリブレーションの問題がおおむね解消された。温度は logit を割る値で、1より大きければ答えの順序はそのままに確率分布だけを平らに広げる。筆者は、値一つでおおむね解消されたという結果を、ズレが一部の区間に集まったのではなく、分布全体が一方に狭まった形だという意味に読む。論文は、より強い RL 学習はこのやり方では直せない形でキャリブレーションを損なうかもしれない、という但し書きも添えている。
これは Anthropic のモデルの結果なので、Figure 8 の原因としてそのまま持ち込むことはできない。前の節の研究も文章の中の確信表現を扱っている。人が不確かな口調を避けるという結果とトークン確率のズレを直接つなぐ一次資料を、筆者は見つけられなかった。
コードが受け取る確率
Figure 8 の確率はトークンの対数確率だ。同じ種類の値を受け取るには、OpenAI API の仕様どおり Chat Completions のリクエストで logprobs を true にし、top_logprobs でトークン位置ごとに受け取る候補の数を0から20のあいだで決める。モデルに答えと一緒に確信度を数字で言わせて受け取る値は、文章で述べた確信であり、トークン確率とは別の値だ。
二つの値を扱った研究は、それぞれ異なる組を比べている。Tian et al. 2023 は、ChatGPT、GPT-4、Claude のような RLHF モデルの中で、文章で述べた確信が条件付き確率よりおおむねキャリブレーションがよく、三つのベンチマークで ECE を相対的に50%ほど減らした場合が多かったと報告した。ただしこの比較で、重みが公開されていないモデルの条件付き確率は、API のトークン確率ではなく、同じ質問を10回サンプリングして答えが出た割合で推定した値である。先に見た Leng et al. は、RLHF 以前のモデルと比べて、RLHF モデルは文章で述べる確信でより overconfident だと報告した。二つの結果は両立しうる。そして 0.074 は2023年の GPT-4 post-training モデルが MMLU の一部で出した値なので、いま API で呼んでいるモデルにそのまま当てはめることはできない。
まとめ
まとめると、キャリブレーションは何パーセント当てるかではなく、自分が何パーセント当てるかを知っているかの問題であり、ECE はそのズレの大きさを測る数字だ。方向は reliability diagram か、平均確信度から正解率を引いた値を見なければわからない。RLHF は人の選好を真似た報酬モデルの点数を押し上げる。Kadavath et al. は、その最適化が多くの報酬を受ける側へ予測を狭める傾向があると見ている。人は不確実さを表に出した答えをあまり選ばず、報酬モデルは品質と関係なく高い確信度の数値を書いた答えに高い点数を与えるという研究がある。GPT-4 では post-training の後に ECE が 0.007 から 0.074 として刻まれたが、OpenAI はその原因までは書いていない。コードが受け取る確率がトークン確率なのか文章で述べた確信なのかによってキャリブレーションも違って出るので、どちらにしても自分のデータでもう一度測る必要がある。
キャリブレーションを学習目標に掲げた決定モデル Jev の確率が本当に正直なのかは、決定モデル、Jev と Kevで扱う。
この記事を読んでいる皆さんも、モデルが返した確率をしきい値としてコードに埋め込む前に、そのモデルが何を目標に学習されたのか、自分のデータで目盛りが合っているのかを一度は測ってみてほしい。