決定モデル、Jev と Kev
今回の記事では、テキストを生成しないモデルについて話してみたい。先週 TypeSafe AI が Jev を公開した。
最初に目に入った用途はブラウザ自動化だった。Browserbase が Stagehand の act() に Jev をつなぐ PR を出した。ページのアクセシビリティツリーを state として送り、「次にクリックする要素はどれか」を選択肢で問う構造だった。40 個の課題で act() の中央値が 1.97 秒から 0.46 秒に縮み、147 回の操作のうち LLM に戻ったのは 4 回だった。Playwright スクリプトが selector 一つ変わるだけで壊れる場所を、確率を一つ返してもらう呼び出しで埋めたわけだ。この記事を書いている時点で PR はまだマージされていない。
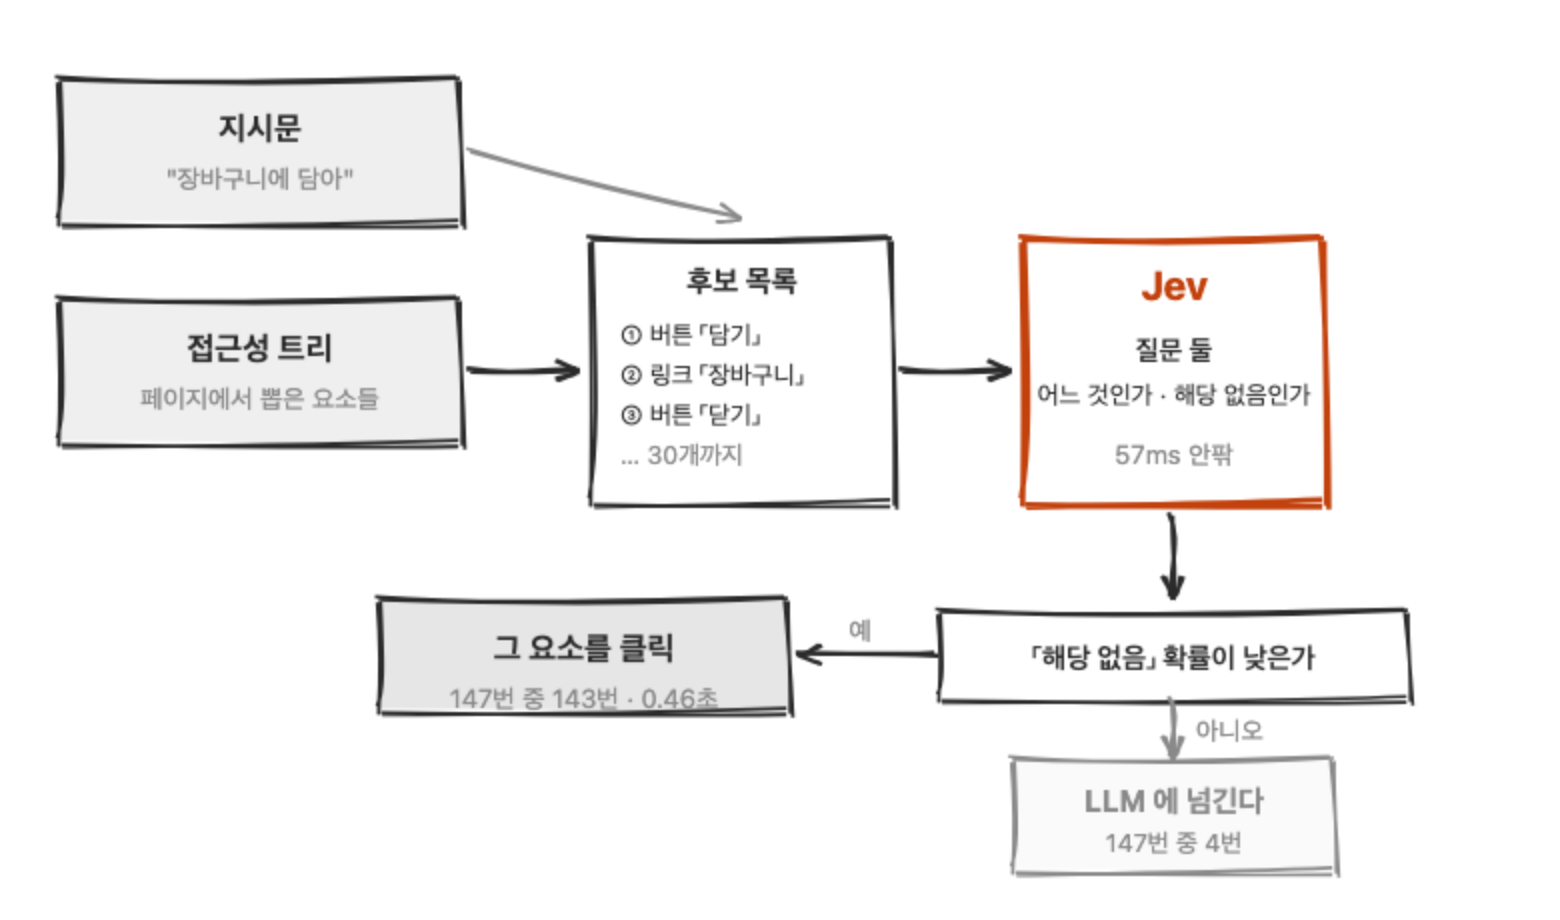
その PR が引いた線が、この記事の問いだ。Jev の答えを受け入れる基準を確率 0.7に置き、越えなければ LLM に渡す。あのモデルが返す確率を信じて、コードの中に線を引いてよいのか。
他人のベンチマークだけでは判断できないので、筆者のデータで検証してみることにした。このブログには音写された外来語を止めるゲートがある。ハングルの音写である 피커 ではなく picker と書こうという規則だが、正規表現が捕まえるのは確実な半分だけで、멀티스레드 や 콜 스택 のように複合語の中にあったり韓国語にすでに定着していたりする語は筆者が毎回手で判断する。答えは「戻す」と「そのまま」の二つしかなく、分かる人なら 1 秒で判断でき、ビルドスクリプトの中で人の確認なしに合否を決めなければならない。Stagehand の selector 判断と同じ形だ。
そこで順序をこう決めた。Jev が何を返すのか、その確率がどんな学習から出てくるのか、筆者のゲートに渡すとどんな数字が出るのか、そしてその数字をどこに使えるのか、だ。
テキストを生成しないモデル
公開日は2026年9月15日だ。同社はこれを LLM とは呼ばず、System One Model という新しいカテゴリとして扱う。この記事では決定モデルと呼ぶ。創業者の Diogo Almeida は OpenAI で InstructGPT 論文の4番目の著者として名を連ねた人物だ。ChatGPT の直系の祖先となったその手法を作ったチームにいて、いまはその手法の限界を指摘する側に立っている。
Jev は文を生成しない。答えの形をあらかじめ決めて渡すと、その中から選び、確率を一緒に返す。質問タイプは三つだけだ。
| タイプ | 問うもの | 返すもの |
|---|---|---|
choice |
このうちどれか | 選択、probabilities、confidence |
score |
どの水準か | スコア、legend、probabilities、confidence |
noul |
真か | 0から1のあいだの確率ひとつ |
endpoint も一つだ。POST /v1/systemone に state(評価する内容)、model、questions(質問のマップ)を送れば答えが返る。同じ state に対する質問を複数まとめて一つのリクエストに入れられ、質問を増やしても応答時間はほとんど伸びない。
なぜ速いのかは、トークンの仕組みでまとめた prefill と decode の非対称で説明できる。LLM が遅いのは出力を1トークンずつ順に絞り出すからだが、Jev にはその decode の段階がない。入力を一度並列に読み、確率をそのまま読み出す。だから出力トークンの料金が最初から存在せず、入力のみ100万トークンあたり $0.042 だ。
Archer Hume という開発者が API を約1万回呼び出し、外側から動作を復元した分析がある。入力360トークンで中央値57.5ms、29,835トークンで218ms、質問を1,500個入れたときで610msだった。そのうち最も直接的な証拠は、選択肢が200個の応答が2個のものと同じ速度で返ってきたという観察だ。答えを書くのに時間がかからないという意味である。
人が見ていない判断
速度と価格が目を引くが、Almeida が公開の発表記事で投げかけた問いは別の方にあった。モデルは何年も前から対話では超人的なのに、自動化はどこへ行ったのか、という問いだ。
彼の答えは、二つの仕事は種類が違うというものだ。チャットボットと copilot とコーディング agent は、人が横で見ながら満足することが目標だ。サーバーで静かに回りながら誰も見ていない判断はそうではない。前者を assistant、後者を automation と呼ぶなら、これまでに出てきたモデルはすべて前者のために作られてきた。
harness 設計をまとめたときにも、似た区別をしたことがある。エージェントシステムの中には、人が見ていない判断が無数にある。このリクエストを人に回すべきか。このコマンドを実行してよいか。いまはそれらを全部、高価な LLM に尋ねている。筆者の正規表現ゲートが覆えない残りの半分も、そうした判断だ。
RLHFが残した空白
ところで、なぜ新しい学習法が必要だったのだろうか。既存のモデルに「はい」か「いいえ」だけを答えさせてはいけないのだろうか。
RLHF(reinforcement learning from human feedback)の系譜に答えがある。人の選好比較から報酬モデルを立てる骨格は Christiano らの2017年の論文で生まれ、Stiennon らが2020年に言語モデルへ適用し、InstructGPT が指示追従へ拡張した。三つの論文が共有する目的関数は一つだ。人間の評価者がより選好する出力を出すこと。
ここで正解率とキャリブレーションを区別しなければならない。正解率は何パーセント当てるかであり、キャリブレーションは自分が何パーセント当てるかを知っているかどうかだ。降水確率70%と言った日だけを集めたとき、実際に10回のうち7回雨が降ったなら、その予報はキャリブレーションがよく取れている。正解率が高いという意味ではない。自分の限界を知っているという意味だ。60%しか当てないモデルでも、自分で60%だと言えばキャリブレーションは満点である。
そのズレを測る指標が ECE(expected calibration error)だ。確率の区間ごとに「言った確率」と「実際の的中率」の差を、その区間の標本比率で重み付けして平均した値で、0が完璧である。
チャットボットにとって、人の選好は正しい目標だ。問題は、人が歯切れの悪い答えより自信のある答えを好むところにある。そのためモデルは、曖昧なときでも断定的に話す癖をつける。TypeSafe のドキュメントはこれを mode dropping と呼ぶ。選好の最適化が特定のスタイルを偏愛するようモデルを押しやり、他のありうる出力の確率を押し潰してしまうという話だ。
OpenAI も同じことを自社のレポートに書いている。GPT-4 技術レポートの Figure 8 は事前学習モデルと post-training モデルのキャリブレーション曲線を並べて置いているが、そのキャプションがこうだ。
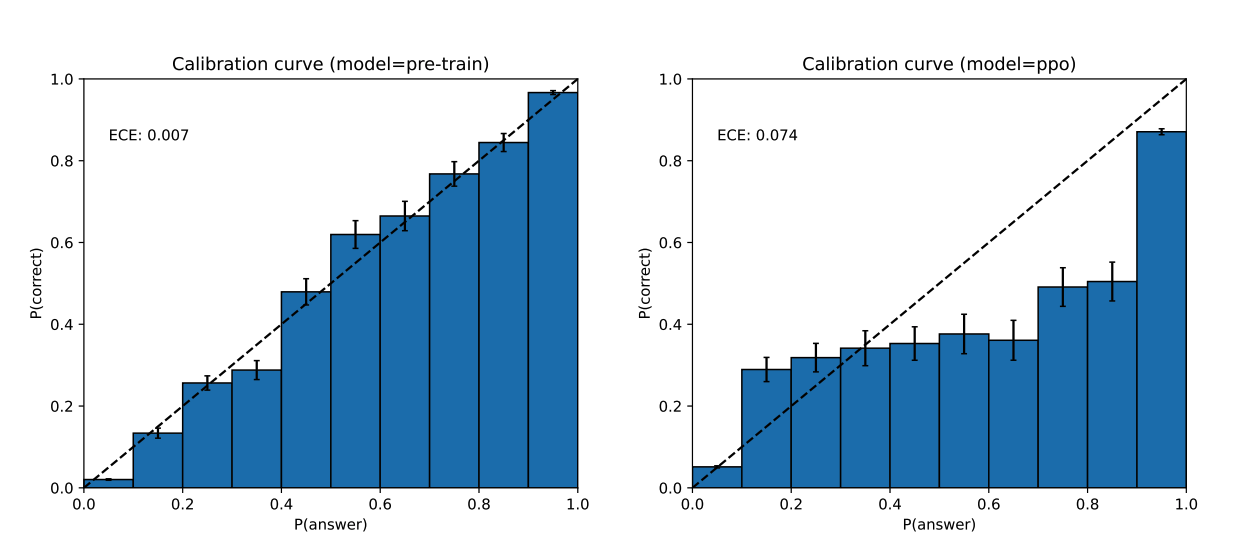
出典: OpenAI, GPT-4 Technical Report (arXiv:2303.08774), Figure 8.
Right: Calibration plot of the post-trained GPT-4 model on the same subset of MMLU. The post-training hurts calibration significantly.
図に刻まれた数字では、事前学習モデルの ECE が 0.007 で、PPO を経たモデルが 0.074 だ。10倍以上悪くなった。人を満足させるよう仕上げる過程で、自分が何パーセント当てるかを知る能力が削られたのである。
ただし ECE 一つでは足りない。 すべての入力に0.6を出す定数予測器でも、実際の的中率が60%なら ECE は0になる。確率が正直なだけで案件ごとに分かれないなら、線を引く場所がない。だからキャリブレーションとは別に、確率が実際に分かれるかも一緒に見なければならず、後で使う「誤差予算の中で自動処理できる比率」が、その二つを一つの数字にまとめた指標である。
ソフトウェアの立場で重要なのはこの部分だ。確率が正直で、かつ分かれるなら、線を引ける。0.95を超えれば自動処理し、その下は人に回すという構造が作れる。
TypeSafe はその場所を狙って三番目の道を出したと言う。人の選好を最適化する RLHF、機械が採点できる正解を最適化する RLVR(reinforcement learning with verifiable rewards)、そしてキャリブレーションされた決定を最適化するという RLCD である。
ただし RLCD として公開されているのは出力契約の3行がすべてだ。この記事を書いている2026年9月23日の時点で、TypeSafe のドキュメントにも発表記事にも論文や技術レポートはない。同じ略語を使う ICLR 2024 の論文が別にあるが、そちらは reinforcement learning from contrastive distillation で別の手法だ。検索するときは混ざらないよう注意する。
confidenceの正体
では、Jev が返す数字は正直なのか。答える前に、まず見ておくことがある。返ってくる数字は一つではない。
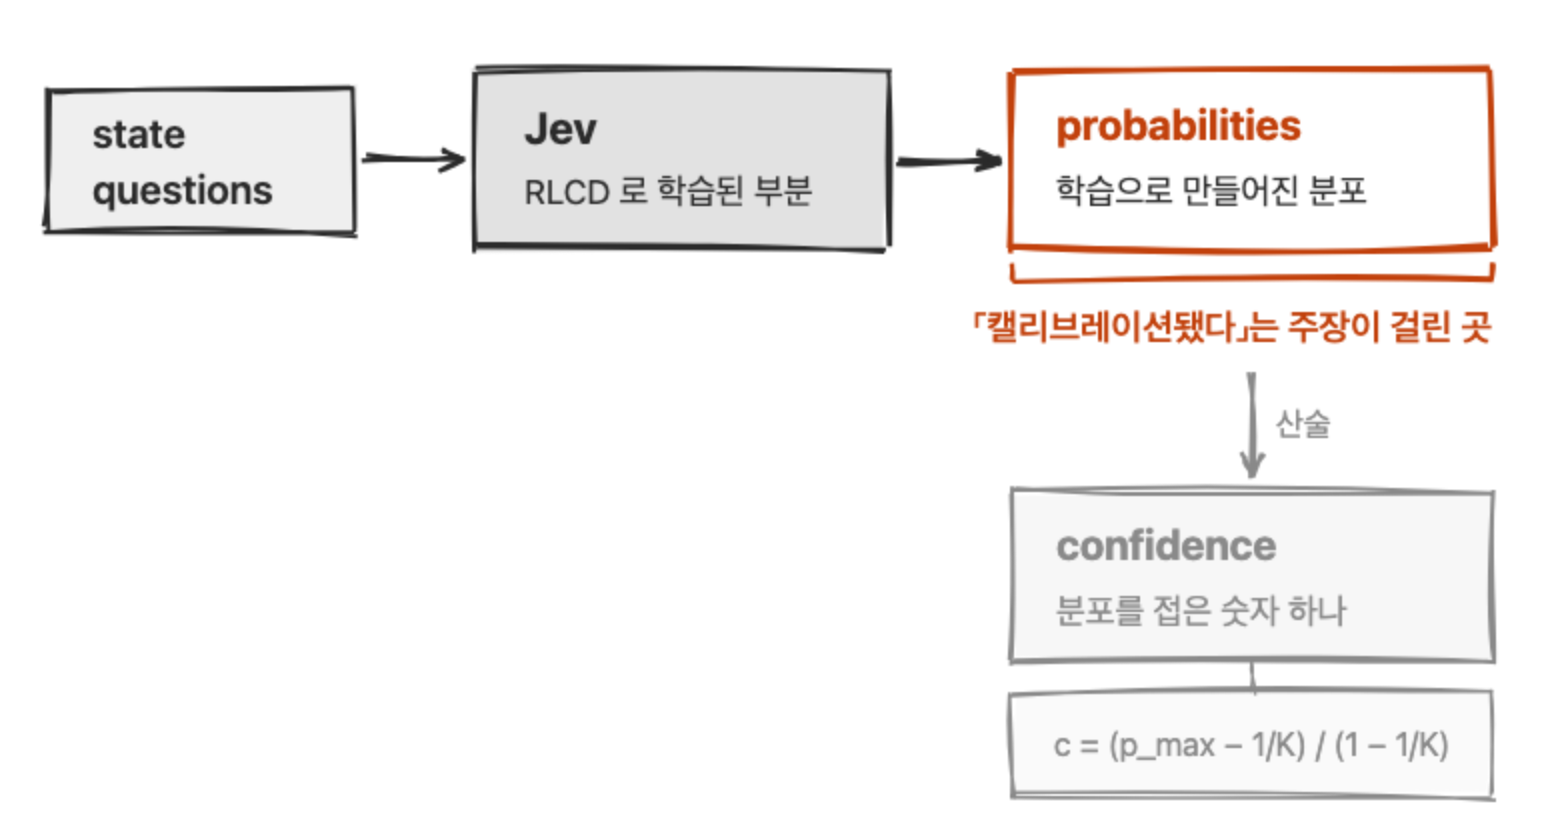
Choice と Score の応答には probabilities と confidence が一緒に入っている。前者は選択肢全体にわたる確率分布で、後者は0から1のあいだの数字ひとつだ。コードでしきい値をかけるとき、まず手が伸びるのは confidence の方である。
この値は、モデルが作ったものではない。TypeSafe の organization が公開している system-one-adapter-python の _utils/confidence_metrics.py は全部で32行で、Choice の部分がこうなっている。
def choice_confidence(probs: list[float]) -> float:
    """Scale peak choice probability from uniform to certainty."""
    if len(probs) == 1:
        return 1.0

    normalized_probs = _normalize(probs)
    uniform_probability = 1.0 / len(normalized_probs)
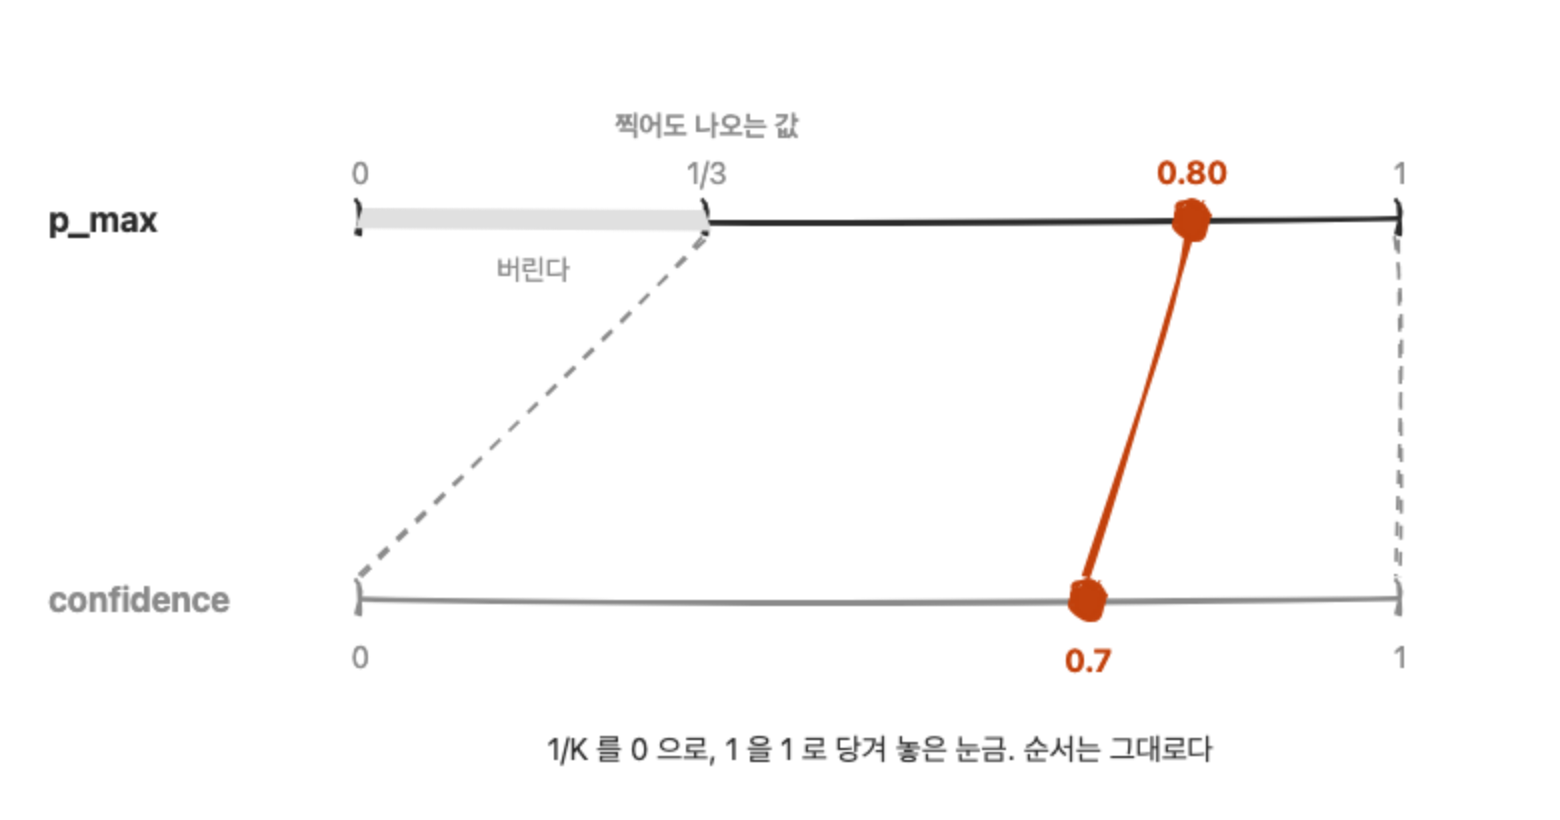
return (max(normalized_probs) - uniform_probability) / (1.0 - uniform_probability)モデルの呼び出しもなく、学習されたパラメータもない。probabilities のベクトルが一つ入り、実数が一つ出る。式で書くと c = (p_max − 1/K) / (1 − 1/K) で、選択肢が三つで最大確率が0.8なら0.7になる。
このリポジトリはプロダクションの Jev サーバーではなく、LLM で同じ API を模倣する代替実装だ。だからこれだけで断定することはできない。ところが、同じ式を指す証拠がもう二つある。TypeSafe 公式ドキュメントの confidence ページはこの値を "a statistic computed from the probability distribution" と記し、デモコードには三つの選択肢用の近似式として (3 × largest probability − 1) / 2 を載せている。K が3なら上の式と同じだ。そして主張の監査台帳が、実際の API で、どちらも誤りの選択肢を二つだけ与えた応答の勝者が0.52のとき confidence が0.04で返ってきたと記録した。K が2なら (0.52 − 0.5) / (1 − 0.5) = 0.04 だ。式と一致する。
同じリポジトリで Score はまったく別の式を使う。最頻の水準からの平均絶対距離を、一様分布のそれで割ってから1から引く。 ドキュメントは Score の式を公開していない。つまり confidence という一つの名前の下に計算式が二つあり、タイプが違えば同じ数字でも意味が違う。Noul に confidence がないのも同じ理由だ。畳むべき分布がない。
ドキュメントもこれを隠していない。別の計算を使いたければ probabilities 全体を渡すので好きにしてよい、とまで案内している。書いてある内容であり、読まずに使う側の問題だ。
ところが、公開の発表記事の比較表は二つをくっつけて書いている。"Calibrated: higher confidence means higher accuracy" と書かれている。読む人は confidence がキャリブレーションされた値だと受け取るが、キャリブレーションの主張が実際にかかっているのは probabilities の方だ。
この区別が数字でどれだけ開くかは、測定がある。scienthoon という開発者が公開した独立したキャリブレーション測定が、confidence を「当たる確率」として読んだときの ECE を別に測っている。OpenBookQA で0.035、HellaSwag で0.078、合成した集合で0.18だ。同じ集合の元の確率はそれぞれ0.024、0.029、0.107だった。三つの集合すべてで confidence の方が悪い。
なぜ悪くなるのかは式にある。K が固定なら c は p_max の単調増加変換なので、順序は保存される。判別力はそのままで、しきい値だけ書き換えればよい。壊れるのは情報ではなく目盛りだ。 K が質問ごとに違うと、問題がもう一つ増える。引き伸ばす倍率も変わる。同じ p_max 0.8が、選択肢二つでは0.6になり、五つでは0.75になる。選択肢の数が混ざったワークロードでしきい値を一つだけ使った瞬間、それが問題になる。
分布によって変わるキャリブレーション
では、probabilities の方は信じてよいのだろうか。
Jev を実際に呼び出して測った記録が公開されている。Jared Palmer が作ったオープンソースの再現実装 Kev のリポジトリには runs/jev-* の directory があり、usage.json が "model": "typesafe-ai/jev" として、Vercel AI Gateway を経た実際の呼び出しであることを記録している。jev-* の directory 六つの usage.json を合わせると、2026年9月18日と20日にわたって5,364回呼び出し、入力が2,418,260トークンだ。以下の七つの集合のうち scienthoon は、その開発者の結果ファイルを変換して取り込んだものなので、この合計には入っていない。
価格が実際に入力だけ課金されることは、別のところで確認できる。フィッシングのベンチマークの著者が TypeSafe の dashboard を見て書き残している。二回回した456万トークンのうち入力が366万、出力が90万だったが、請求は $0.15 で、その値が入力だけを計算したものと一致した。
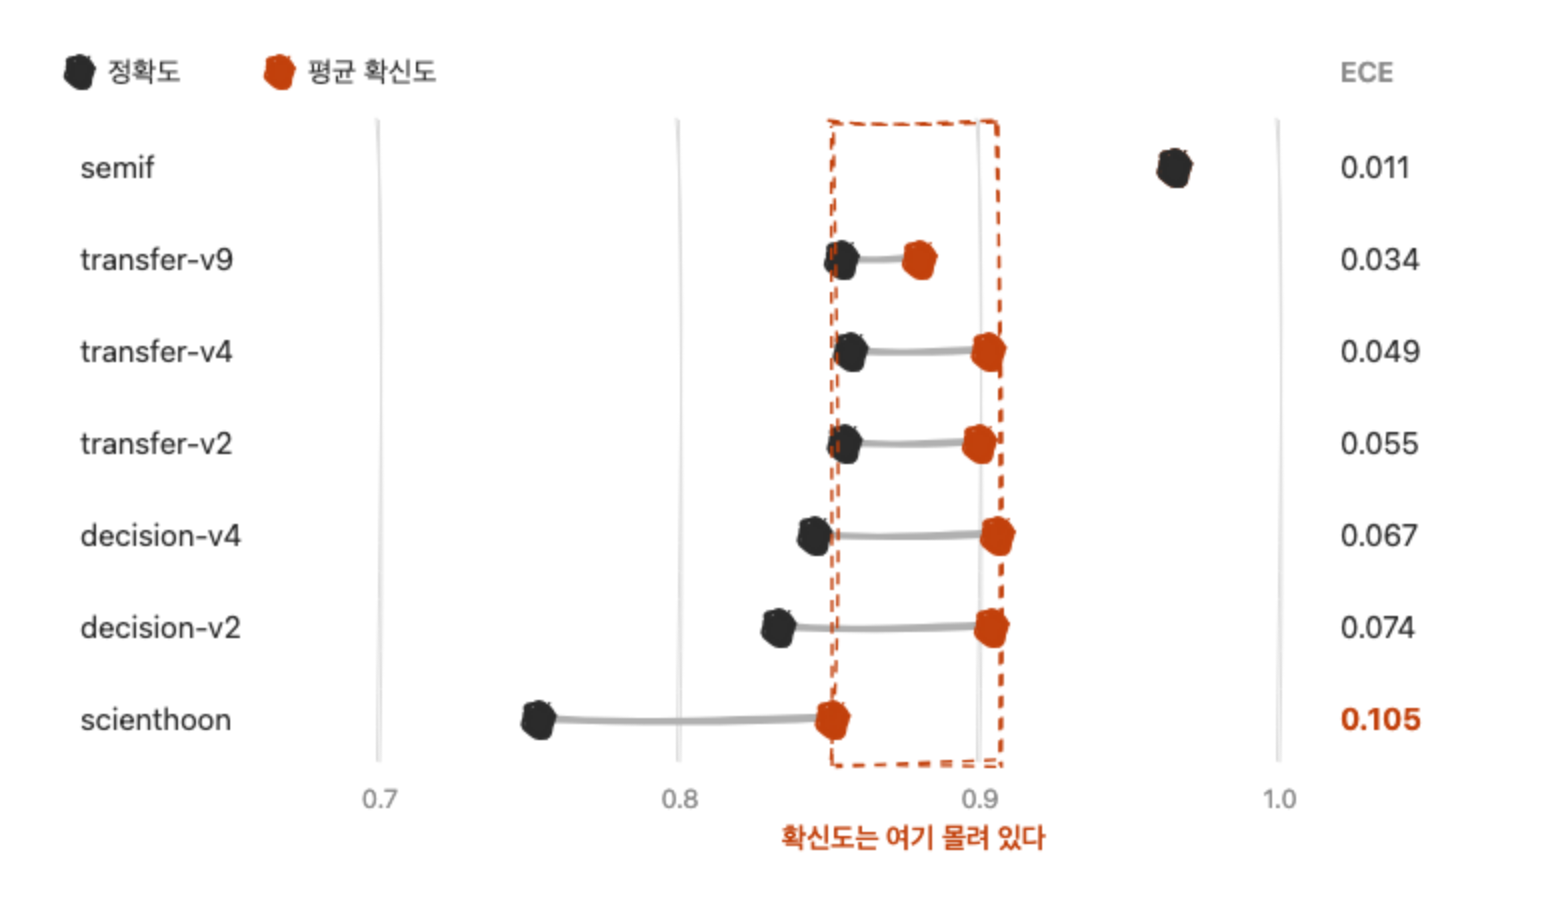
同じ directory の report.json から評価集合7個の指標を取り出して整理するとこうなる。以下で確信度は confidence フィールドではなく probabilities の最大値である。過信は 평균 확신도 − 정확도(平均確信度 − 正解率)で、合計5,743件だ。判断の根拠を消した「分からない」項目を正解率の採点から外す clean ブロックの値である。
| 評価集合 | n | 正解率 | 平均確信度 | 過信 | ECE |
|---|---|---|---|---|---|
| semif | 144 | 0.965 | 0.965 | -0.000 | 0.011 |
| transfer-v9 | 1,046 | 0.854 | 0.880 | +0.026 | 0.034 |
| transfer-v4 | 656 | 0.857 | 0.903 | +0.046 | 0.049 |
| transfer-v2 | 560 | 0.855 | 0.900 | +0.045 | 0.055 |
| decision-v4 | 1,264 | 0.845 | 0.906 | +0.061 | 0.067 |
| decision-v2 | 1,200 | 0.833 | 0.904 | +0.071 | 0.074 |
| scienthoon | 873 | 0.753 | 0.851 | +0.099 | 0.105 |
二つのことが読み取れる。
第一に、ECE が10倍近く動く。 0.011から0.105だ。同じ採点器、同じモデルである。「キャリブレーションされている」はモデルの性質ではなく、モデルと分布の関係なのである。分布が変わればキャリブレーションが崩れること自体は、すでに知られた結果だ。ここで新しいのは、キャリブレーションを学習目標として掲げたモデルでも同じ形が出るという点である。
ECE が最も大きい集合の0.105は、先に見た post-RLHF の GPT-4 の0.074よりも大きい。ただし、この二つを順位として読んではいけない。課題が違ううえ、ECE は区間をいくつに分けるか、標本がどの区間に偏っているかによって値が動く推定量なので、別々の採点器から出た数字を突き合わせても比較は成立しない。
第二に、測定された ECE が過信ひとつでほぼ全部説明される。 二つの列の差は7個すべてで0.002から0.011のあいだだ。ECE は区間ごとの差の加重平均なので全体の過信より小さくなりようがないが、その差がほぼ0だということは、区間ごとのズレの符号が一方向に偏っているという意味である。区間ごとに食い違って打ち消し合うノイズではない。
なぜそうなるかは、縦に読むと見える。平均確信度は semif を除けば0.851から0.906のあいだに6個が固まっている。同じ区間で正解率は0.753から0.857へ、2倍の幅で動く。確信度は分布が変わってもあまり動かず、正解率だけが動く。残った差がそのまま ECE だ。
この性質が実務でどう現れるかは、別のベンチマークが見せてくれる。フィッシングメール2,000件に Claude Haiku 4.5 を対照群として置いた測定で、Jev の正解率は62.6%、Haiku は81.3%だった。ところが、もっと目を引くのは ECE だ。リポジトリが報告した ECE は Jev が0.154、Haiku が0.097で、主張の監査台帳が Jev の P(phishing) の値を0から1まで10区間で測り直すと0.170になる。どちらで読んでもキャリブレーションを学習目標として掲げたモデルが、RLHF で作った LLM にキャリブレーションで負けた。 同じ著者がリンクのホスト一覧の規則一つだけで91.6%を出した。
同じ指標を複数の集合で見ると、その幅はもっとはっきりする。誤差予算5%で自動処理できる比率が、scienthoon の集合で0.486、transfer-v9 で0.695、semif で1.000だ。Kev の採点器はこの値を、標本の中でしきい値を選んだ最大値だと書き残しており、デプロイ後の誤差の保証ではない。そのどれか一つをモデルのスペックのように引用してはいけない。
音写判別ゲート
他人のベンチマークを読むことと、自分のデータで測ってみることは違う。そこで冒頭のゲートを実際に通してみた。
筆者はまだ Jev の API キーを持っていない。代わりに、先に触れた Kev-9B をローカルで回した。 Qwen3.5-9B-Base に rank-16 LoRA と pointer head を載せた再現実装で、Apache-2.0 だ。以下の数字は Jev の数字ではない。Kev の学習データは英語の決定課題であり、同じ著者の測定でも Kev-9B は英語の課題ですら Jev に劣る。誤差予算5%の自動化比率が0.45から0.57なのに対し Jev は0.70で、MMLU-Pro は0.52対0.84だ。そして TypeSafe のドキュメントも Jev について、英語が主な学習言語であり CJK は同等ではないと明らかにしている。
評価集合は、このリポジトリの韓国語記事18本から取り出した。ラベルの正解基準は、このリポジトリがその単語を一貫してどの表記で書いているかである。韓国語技術文書のコミュニティの合意ではなく、このブログの慣習だという意味で、両者が分かれる単語では、モデルがコミュニティ基準では正しく、この基準では間違うことがありうる。
- ゲート集合102文。 ゲートがすでに知っている単語だ。本文が英語で書いている
calendar、picker、adapterのような単語をハングルの音写に戻した反事実の文が陽性23件、write-post.mdが例外として明示した리렌더링や콜 스택が実際に使われている文が陰性79件である。ここでは現在の正規表現ゲートが定義上100%を当てる。 - 保留集合60文。 ゲートが一度も見たことのない単語だ。 機械学習で held-out と呼ぶ側だ。 本文が英語だけで書く
loader、mutation、prefillを音写に戻したものが陽性30件、本文がハングルだけで書く리듀서、스냅샷、런타임が陰性30件である。ここでは正規表現は陽性を一つも捕まえられない。
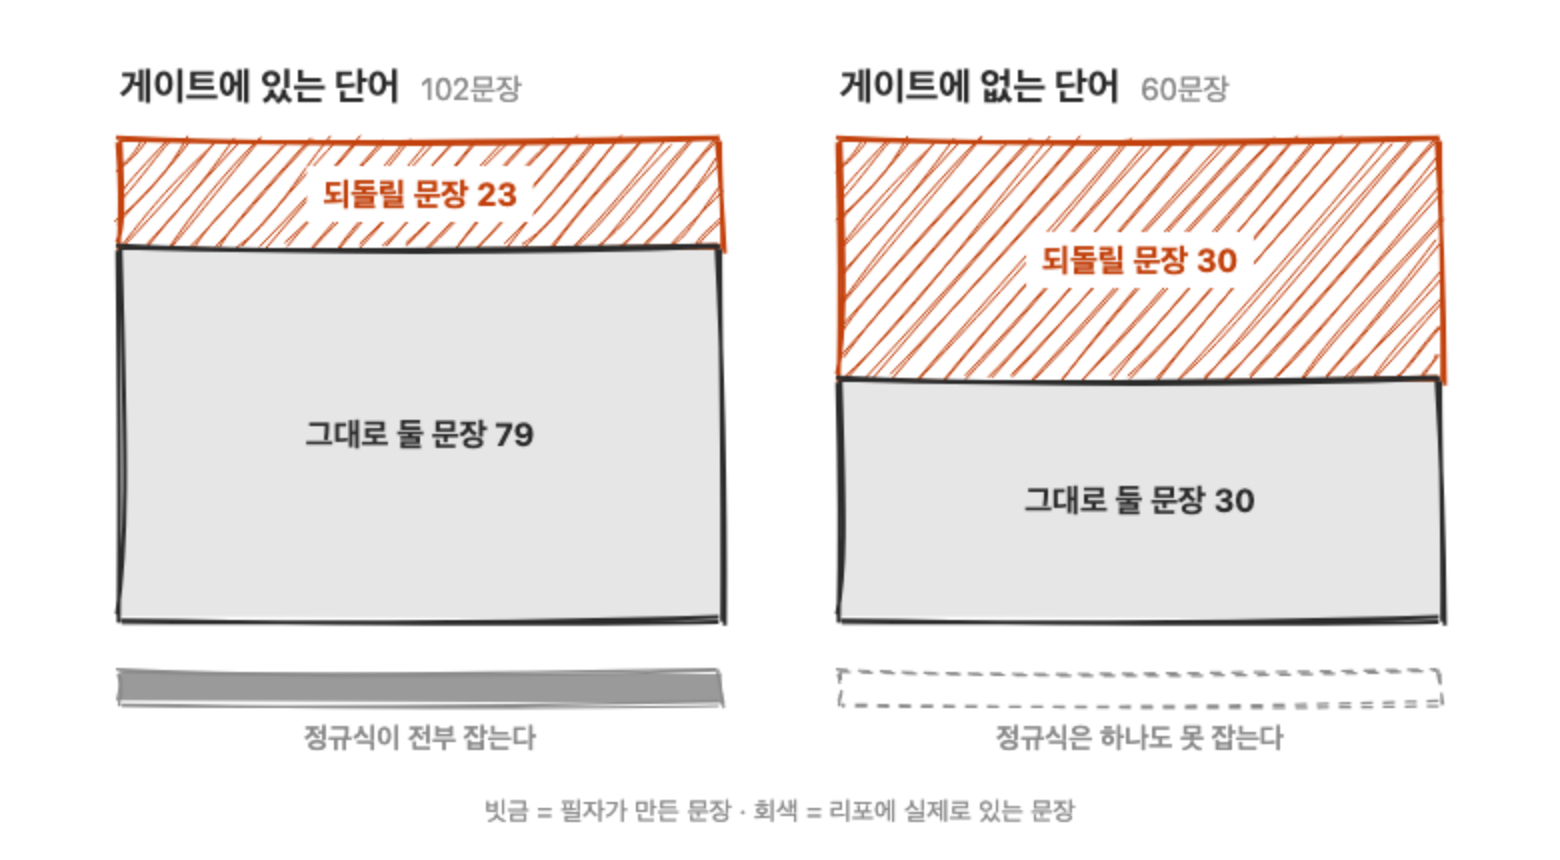
陽性が筆者の作った反事実の文で、陰性が実際の文だという非対称は、先に明らかにしておく。そして有効な標本は文の数ではなく単語の数だ。 ラベルが単語単位で決まるので、同じ単語が出てくる文どうしは独立した観測ではない。ゲート集合は24種、保留集合は13種である。
以下の表は「この単語を英語に戻すべきか」を問う noul の質問一つだけを集計したものだ。同じリクエストに質問を四つ入れたが、残りの三つは否定形と Choice の変形、そしてラベルをきちんと立てられなかった複合語の判定なので、ここには混ぜていない。5%予算の自動化比率は、確信度の高い方から切り下げていき、その上の区間の誤差が5%を超えない最大の比率である。
| ゲート集合 | 保留集合 | |
|---|---|---|
| 文 / 単語 | 102 / 24種 | 60 / 13種 |
| 現在の正規表現ゲート | 1.000 | 0.500 |
| Kev-9B 正解率 | 0.225 | 0.500 |
| 単語単位の正解率 | 6/24 | 7/13 |
| 多数クラスのベースライン | 0.775 | 0.500 |
| ECE | 0.664 | 0.336 |
| 平均確信度 | 0.876 | 0.821 |
| 確信度0.9以上の比率 | 0.490 | 0.317 |
| その区間の実際の的中 | 0.240 | 0.526 |
| 5%予算の自動化比率 | 0.010 | 0.000 |
多数クラスのベースラインは、文を読まずに多い方のラベルだけを出したときのスコアだ。モデルはその下である。
最後の行がこの実験の答えだ。保留集合では、しきい値をどれだけ高く取っても、5%の誤差の中で自動処理できる決定は一件もなかった。
予測分布を見れば、何が起きたのかが分かる。モデルは162文すべてに「戻すべきだ」と答えた。 単語37種すべてである。陽性は全部当たり、陰性は全部外した。だから保留集合の0.500は実力ではなく、集合が均衡しているから出た数字だ。
それでいて平均確信度は0.876だった。ゲート集合で確信度0.9を超えたものが49%なのに、その区間の実際の的中は0.240である。
構造的な恒等式も成り立たなかった。「戻すべきか」と「そのままにすべきか」の確率を足すと、ゲート集合で平均1.655になり、102文すべてが1から0.1以上ずれた。
設計上そうなっている。二つの質問は互いを読めない別々の評価であり、TypeSafe 自身も jaggedness のページに、refund 0.72と not_refund 0.47を足して1.19になる例を載せている。
実務で引っかかる点はここだ。Noul に合わせて調整したしきい値を Choice に移してはいけない。 同じ判断なのに結論が分かれる文が14%から17%あった。
何を聞いても「はい」と答えるモデルなら、この結果は無意味だ。まずそれから確認した。
| 状態 / 質問 | 聞いたこと | 答え |
|---|---|---|
| 韓国語 / 韓国語 | この文は英語で書かれているか? | 0.02 |
| 韓国語 / 韓国語 | この文は料理法を説明しているか? | 0.04 |
| 韓国語 / 韓国語 | この文は韓国語で書かれているか? | 0.98 |
| 韓国語 / 英語 | Is this sentence written in English? | 0.01 |
| 英語 / 英語 | Is this sentence about software? | 0.96 |
韓国語を読み、「いいえ」と言い、0.02と0.98を分ける。 全域的な迎合バイアスではない。排除できるのはそこまでだ。ゲートの質問の文言そのものが悪い可能性は残る。
規則をstateに入れた結果
では、判別に必要な知識を直接与えれば変わるだろうか。TypeSafe のドキュメントが勧めるドメイン適応の方式がこれだ。重みには触れず、参考資料を state に載せて送る。
write-post.md にすでに書かれている規則の段落を state に一緒に入れて、もう一度回した。入力が1文あたり100トークンから450トークンに増えた。ゲート集合はリークだ。 その参考資料が、ゲートの単語と例外の単語を名前で並べているからである。だからそちらは「参考資料を読んではいるのか」を見る対照群で、本当の試験は保留集合だ。
| ゲート(リーク) | ゲート +規則 | 保留 | 保留 +規則 | |
|---|---|---|---|---|
noul 正解率 |
0.225 | 0.676 | 0.500 | 0.500 |
| 単語単位の正解率 | 6/24 | 7/13 | 5/13 | |
| 陽性の正解 | 23/23 | 1/23 | 30/30 | 8/30 |
| 陰性の正解 | 0/79 | 68/79 | 0/30 | 22/30 |
| 5%予算の自動化比率 | 0.010 | 0.314 | 0.000 | 0.050 |
| レイテンシ中央値 | 2,924ms | 6,903ms | 2,908ms | 6,918ms |
レイテンシは M2 Max で回したローカル推論なので、先に見た Jev の API レイテンシとは同じ軸ではない。ここで見るべきは絶対値ではなく、参考資料を入れたときの2.4倍である。
均衡の取れた保留集合で、文単位の正解率は0.500から0.500へ、まったく動かなかった。 単語単位では7/13から5/13へ、むしろ下がった。
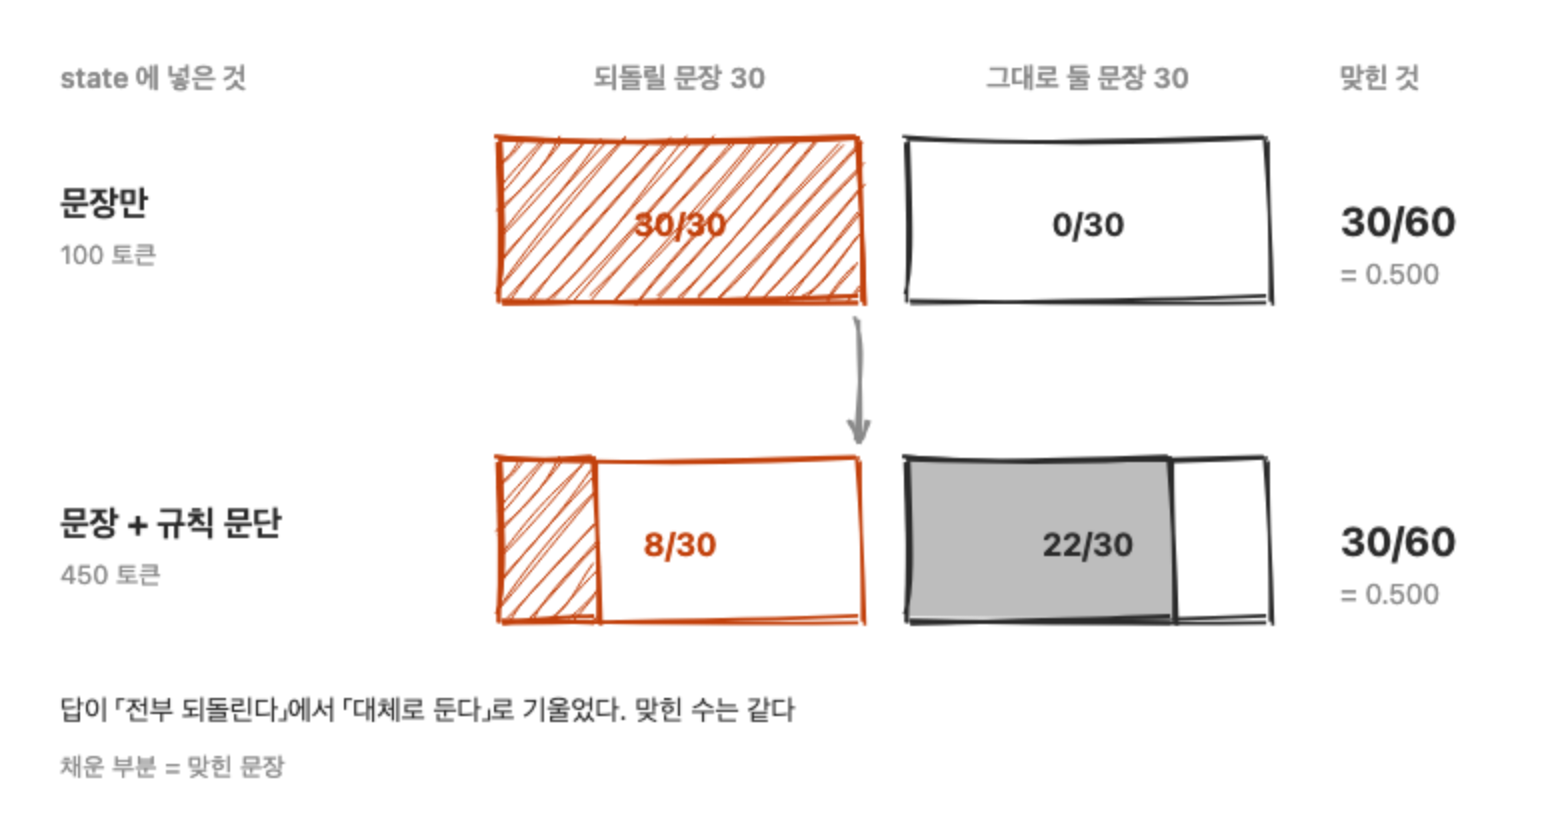
ゲート集合の0.225から0.676は、実力の向上ではない。以前は102文すべてに「戻す」と答えていたが、参考資料を渡すと12文にだけそう答えた。陰性が0/79から68/79へ上がった一方、陽性は23/23から1/23へ崩れた。その集合は陰性が79対23で多いので、「おおむねそのまま置け」という定数が自動的により高いスコアを得る。区別を学んだのではなく、傾きを変えただけだ。
だからといって、モデルが文を読んでいないわけではない。同じ単語の同じ文なのに、参考資料を渡すと文ごとに予測が散らばった。로더 の標準偏差が0.096から0.217へ、뮤테이션 が0.042から0.236へ増えた。読んではいるが、区別ができない。
そしてこの結果は、前節の解釈を揺さぶりもする。state のテキスト一つで出力が丸ごとひっくり返るなら、初回の「全部戻す」もモデルの限界ではなく、質問の文言の不足かもしれない。この記事はその可能性を排除できていない。
一つだけは目に見えてよくなった。「戻す」と「そのまま」の確率の和が、保留集合で1.508から0.963へ近づき、1から大きく外れた文が59個から18個に減った。ところが正解率は動かなかった。 二つの質問の確率が互いに噛み合うことと、その確率が当たっていることは別の話だ。
決定モデルの居場所
ここまで見ると、このモデルのカテゴリ全体が役に立たないという結論に傾きやすいが、公開されたベンチマークを並べてみるとそうではない。
| 課題 | n | Jev | 比較対象 |
|---|---|---|---|
| スパム、分布内 | 18,514 | 98.3% | TF-IDF 回帰 98.4% |
| スパム、分布外 | 2,876 | 98.6% | TF-IDF 回帰 73.0% |
| フィッシング | 2,000 | 62.6% | Haiku 4.5 81.3%、ルールのベースライン 91.6% |
| rerank 英語8種 | 1,617 | nDCG@10 0.692 | Cohere Rerank 4 Pro 0.691 |
rerank の行だけが検索順位の品質指標なので、他の行の正解率とは軸が違う。
分布の内側では、正規表現や作り込んだ分類器が勝つか引き分ける。 筆者のゲート集合で正規表現が1.000対0.225で勝ったのと同じ位置だ。ラベルを集められるなら、小さなモデルを学習させる方が安く、速く、正確である。それは昔からやってきたことだ。
差が開くのは、分布が新しくラベルがないときだ。 分布外のスパムで98.6%対73.0%である。作り込んだ分類器は自分が見たことのない形の前で崩れるが、こちらは持ちこたえる。決定モデルの居場所は、データを集めてラベルを付けて学習させることができない判断だ。毎回状況が新しいのでラベルを集められないのに、判断は秒単位で下さなければならない場所である。
筆者の音写判別がなぜ失敗したのかも、この枠組みで説明できる。その判断に必要なのは一般的な推論ではなく、韓国語の技術文書でどの語が定着したかという特定ドメインの知識であり、英語の決定課題で学習した9Bの再現実装にとって、それは分布外ですらなく、単に持っていない知識だ。規則を文章で渡しても駄目だった理由がここにある。
TechCrunch の記事で、Pi harness を作る Earendil の CTO である Armin Ronacher がこう語っている。
At the end of the day, it delegates the hallucination problem a little bit to the user.
ハルシネーションをなくしたのではなく、判断を開発者に渡したということだ。TypeSafe のドキュメントも、キャリブレーションは予測の束に対して成り立つ性質であって、個別の答えが当たっているという保証ではないと書いている。そして公開の発表記事のハルシネーション率0%の棒の下の Nuance 項目には "Our number is not empirical" と書かれている。形式は保証され、中身は保証されない。
jevable の194プロジェクト
筆者のデータでは失敗したので、ほかの人はどこに使っているのかを見た。jevable.comは、Nikunj という開発者が X に投稿された Jev プロジェクトを審査して集めた独立のキュレーションだ。2026年9月23日時点で194件あり、登録日は9月16日から20日の間に集中している。152件が9月18日の一日に入ってきた。公開から三日後だ。
| カテゴリ | 件数 |
|---|---|
| Games | 39 |
| Developer tools | 34 |
| Productivity | 31 |
| Agents | 19 |
| Experiments | 18 |
| Creative tools | 16 |
| Data & research, Finance, Browser extensions, Robotics, Marketing | 37 |
カテゴリではなく「何を尋ねているか」で括り直すと、三つの形が出てくる。以下の数値はすべて投稿者が自分の投稿に書いた値だ。
第一に、分類とルーティング。 メール1,500件の分類、税務書類の分類、競合他社の広告1,891件を19秒、$0.12で分類、PR の diff ひとつに typed check 14個、Android の通知から広告の判別、建設図面26枚を2.9秒で分類。冒頭の音写ゲートと同じ形だ。前の節の表が言ったとおりラベルが毎日たまる場所なので、時間がたてば自分のラベルで学習した小さな分類器が勝つか、引き分ける。Jev の利点はラベルのない初日にある。
第二に、行動選択のループ。 Browser Use につないで航空券の検索を7秒、$0.0039で終えたという browser agent、音声で Mac を操作する computer use、Mario が死ぬたびに VM を四つに fork して生き残る方を選ぶゲーム、3D キャラクターの口と眉と視線など十項目をメッセージごとに決める表情エンジン。ステップごとに action space が変わるのでラベルを集められず、判断は秒未満に下げなければならない。分布外のスパムで差が開いたのと同じ場所だ。Games が39件で最大のカテゴリである理由もここにあると見ている。ゲームは間違えても巻き戻せる行動選択のループだ。
第三に、確率をユーザーに見せる UI。 答えの代わりに判定だけを返す Ask Jev、次の質問を確率で選ぶ分岐フォーム JevForm、技術的な深さやドラマ性のようなスライダー六本で Hacker News のトップ画面を並べ直す Upweight。しきい値をコードに埋め込まず人が確率を読む場所なので、この記事が問題にしたキャリブレーションの要求が最も低い。
一つ目立つことがある。194件の説明文のうち、コストを書いたものが30件、速度を書いたものが53件ある一方で、正確さや基準線を書いたものは7件だ。説明文は元の投稿の冒頭だけを収めているので下限だが、方向は明らかだ。速くて安いことは初日にわかり、当たっているかは測ってみないとわからないのに、測る側がまれである。その7件のひとつが jevcal だ。みんなしきい値を勘で選んでいると言い、自分のデータと目標の正確さを入れるとしきい値と自動処理の比率を返す道具である。次の節が勧める手順をそのまま道具にしたものだ。
線を引く手順
この記事の結論はこれだ。モデルが返した確率をスペックのように読まず、自分のデータで直接測って線を引かなければならない。
測る手順はこうだ。ラベルのある100件ほどを集めて、確率の区間ごとの実際の的中率の表を作り、しきい値を上から下げながら、その上の区間の誤り率を見る。誤差予算を決めたなら、その予算を守れる最大のカバレッジが、そのまま自動化できる比率だ。筆者の実験で確信度0.9以上の区間の実際の的中が0.240だったというのは、102文で明らかになった。
目盛りがずれていることは、たいてい直せる。 過信が全区間に均等に広がっているなら、温度ひとつでほとんど合わせられる。Kev もそうして ECE を0.106から0.042へ下げた。問題は、その温度を合わせるにはその分布のラベルが必要だということで、プロダクションで手元にないのがまさにそれだ。しかも温度は確率の順序を変えられないので、自動化できる比率はその分だけ上がらない。だから目盛りより順序が、ECE より誤差予算のカバレッジの方が実務的な指標である。
ドキュメントが例に使った0.9をそのままコードに埋め込んでいたら、このゲートは静かに38件を誤って直していただろう。エラーが出ないので気づきにくい失敗だ。TypeSafe のドキュメントもその例のすぐ下に、自分のデータで試してみるようにと書いている。コードに埋め込まれるのは、たいていその下の文章ではなく上の数字の方だ。
キーがなくても、測ることだけなら今日からできる。Kev が Apache-2.0 で公開されていて、ノートパソコンで動く。
いま運営しているサービスで、大きなモデルに「はい」か「いいえ」だけを尋ねている呼び出しがいくつあるか、数えてみてほしい。その呼び出しを決定モデルへ移す前に、移したあとに引くべき線がどこなのかを先に測ってみることをお勧めしたい。筆者はその順序を守ったからこそ、ゲートには手を付けないと決められた。Jev のキーを受け取れたら同じ集合をもう一度回してみるつもりで、そのとき結論が変われば、それも書くつもりだ。
참고 자료
[paper] Lambert et al., Tulu 3: RLVRの命名 [repo] themsquared/jev-benchmark, ツール呼び出しの危険度判定