Reabrindo o Sentry
Neste post, quero falar sobre reabrir o Sentry, uma ferramenta que uso há muito tempo.
Na empresa, trabalho há anos com monitoramento de erros baseado no Sentry. Quando chega uma issue, abrir o stack trace, estreitar o escopo com releases e tags e encontrar as condições de reprodução é um trabalho que já faço no automático. Olhando para trás, porém, os recursos que eu usava sempre ficavam em torno disso. Eu sabia que Logs, Crons, Uptime, custom spans e profiling existiam, mas nunca os ativei.
O motivo não era conhecimento, e sim o custo de exploração. Para verificar se um recurso serve para o meu problema, preciso ler e cruzar documentação espalhada, desenhar um experimento, ligar a configuração e interpretar os resultados. Nos dias em que a resposta a incidentes era urgente, não havia motivo para pagar esse custo. Desde que passei a usar o Sentry MCP conectado ao Claude Code, boa parte desse custo caiu, e a minha ordem de trabalho mudou. Agora, antes de ativar um recurso, primeiro pergunto aos dados reais desta conta.
Este artigo é o primeiro de uma série de quatro sobre observabilidade. Ele acompanha uma falha capturada pela instrumentação de servidor deste blog, registra o que ficou visível ao reabrir esses dados via MCP e dá um veredito sobre onde usar cada recurso. A série começa no servidor, passa por renderização, CPU e memória dentro do navegador e termina nos dados de busca.
Falha dentro de uma resposta de sucesso
Conectei o Sentry a este blog em agosto de 2026, apenas no servidor. A decisão de deixar de fora o SDK do navegador fica para a parte 2; aqui olho só para o que eu tentava capturar no servidor. O objetivo era um só. O servidor chama a Google Analytics Data API para desenhar as estatísticas de visitantes, e, se essa chamada falhasse, eu não tinha como saber.
No início, achei que bastaria colocar um reporte no catch da rota da API de estatísticas. Mas, quando forcei a falha num build de produção local com uma chave de conta de serviço inválida, o erro nunca chegou à rota. O catch do módulo de estatísticas, uma camada abaixo, capturava antes e devolvia um valor padrão, e a resposta era esta.
HTTP 200 OK
{ "slug": "/260610", "views": 0 }
O visitante vê as estatísticas zeradas, e o servidor responde que está tudo bem. Pela taxa de erros da rota, nada aconteceu. O artigo sobre Gray Failure que pesquisadores da Microsoft Research e da Microsoft Azure apresentaram no HotOS 2017 define assim o núcleo desse estado.
Também argumentamos que uma característica central da gray failure é a differential observability: os detectores de falha do sistema podem não perceber problemas mesmo quando as aplicações são afetadas por eles.
We also argue that a key feature of gray failure is differential observability: that the system's failure detectors may not notice problems even when applications are afflicted by them.
Por isso desci o ponto de instrumentação da rota para quatro catch do módulo de estatísticas. O fallback em si é a escolha certa para proteger a experiência do visitante, então o mantive e reportei à parte apenas o fato de o fallback ter sido executado. Na época, eu distinguia os quatro pontos com uma única tag, gaQuery.
// 2026-08 당시
Sentry.captureException(error, { tags: { gaQuery: 'stats' } })
No código atual, o commit f348d4c, de 17 de agosto, concentrou o reporte num único captureServerException e, para a cardinalidade não crescer, limitou as chaves de tag a três: locale, routeKind e operation.
// 현재 src/lib/google-analytics.ts
captureServerException(error, { routeKind: 'analytics', operation: 'stats' })
Hoje o módulo de estatísticas reporta a partir de três catch e de um caminho de credenciais ausentes. (O caminho popular eu removi em setembro, por motivos que conto mais adiante) O caminho de credenciais não passa por um catch e devolve o fallback diretamente, e, por causa de uma lógica que soma um valor base de 10 a 40 ao número de visitantes do dia, aparece na tela um número plausível. Mesmo que as variáveis de ambiente sumam por completo, é um caminho invisível ao olho humano, então fiz com que ele reportasse apenas uma vez por processo.
338 segundos depois de um timeout de 5 segundos
Depois de descer a instrumentação, a issue de produção que apareceu, JIHOON-BLOG-2, era uma chamada ao GA que falhou com DEADLINE_EXCEEDED após 65,877 segundos. A resposta continuava sendo 200. A causa estava no arquivo de configuração da biblioteca cliente do GA. O timeout RPC padrão de runReport é timeout_millis: 60000, e o meu código não passava timeout em nenhum dos seus cinco pontos de chamada. É exatamente o erro contra o qual o post sobre deadlines no blog oficial do gRPC, escrito por Gráinne Sheerin, do Google SRE, alerta já na primeira linha: "Always set a deadline".
O commit de correção 927c85b fez todas as chamadas passarem um timeout de 5 segundos. Reproduzindo com um servidor TCP local que nunca responde, o resultado bateu com a explicação.
| Condição | Tempo decorrido | Mensagem de erro |
|---|---|---|
| Sem timeout | 60,04 s | Deadline exceeded after 60.000s |
timeout: 5000 |
5,00 s | Deadline exceeded after 5.000s |
(O número 5 não tem fundamento. Não medi a distribuição das respostas normais do GA. Mas, neste blog, o número de visitantes é informação complementar, então considerei que desistir rápido era a direção certa, em vez de esperar muito) Essa issue não aparece mais na lista de issues. O valor de 65,877 segundos é um registro que ficou na mensagem do commit e na documentação do repositório.
Deveria ter terminado aí, mas no release em que a correção foi implantada começou a se acumular uma nova issue, JIHOON-BLOG-8. A mensagem era Deadline exceeded after 338.655s, e o stack ainda continha o wrapper de timeout do google-gax. A configuração chegava ao código, mas o tempo reportado era quase 70 vezes o configurado.
Por volta de 18 de agosto, extraí os 100 eventos mais recentes daquele momento e desenhei a distribuição.
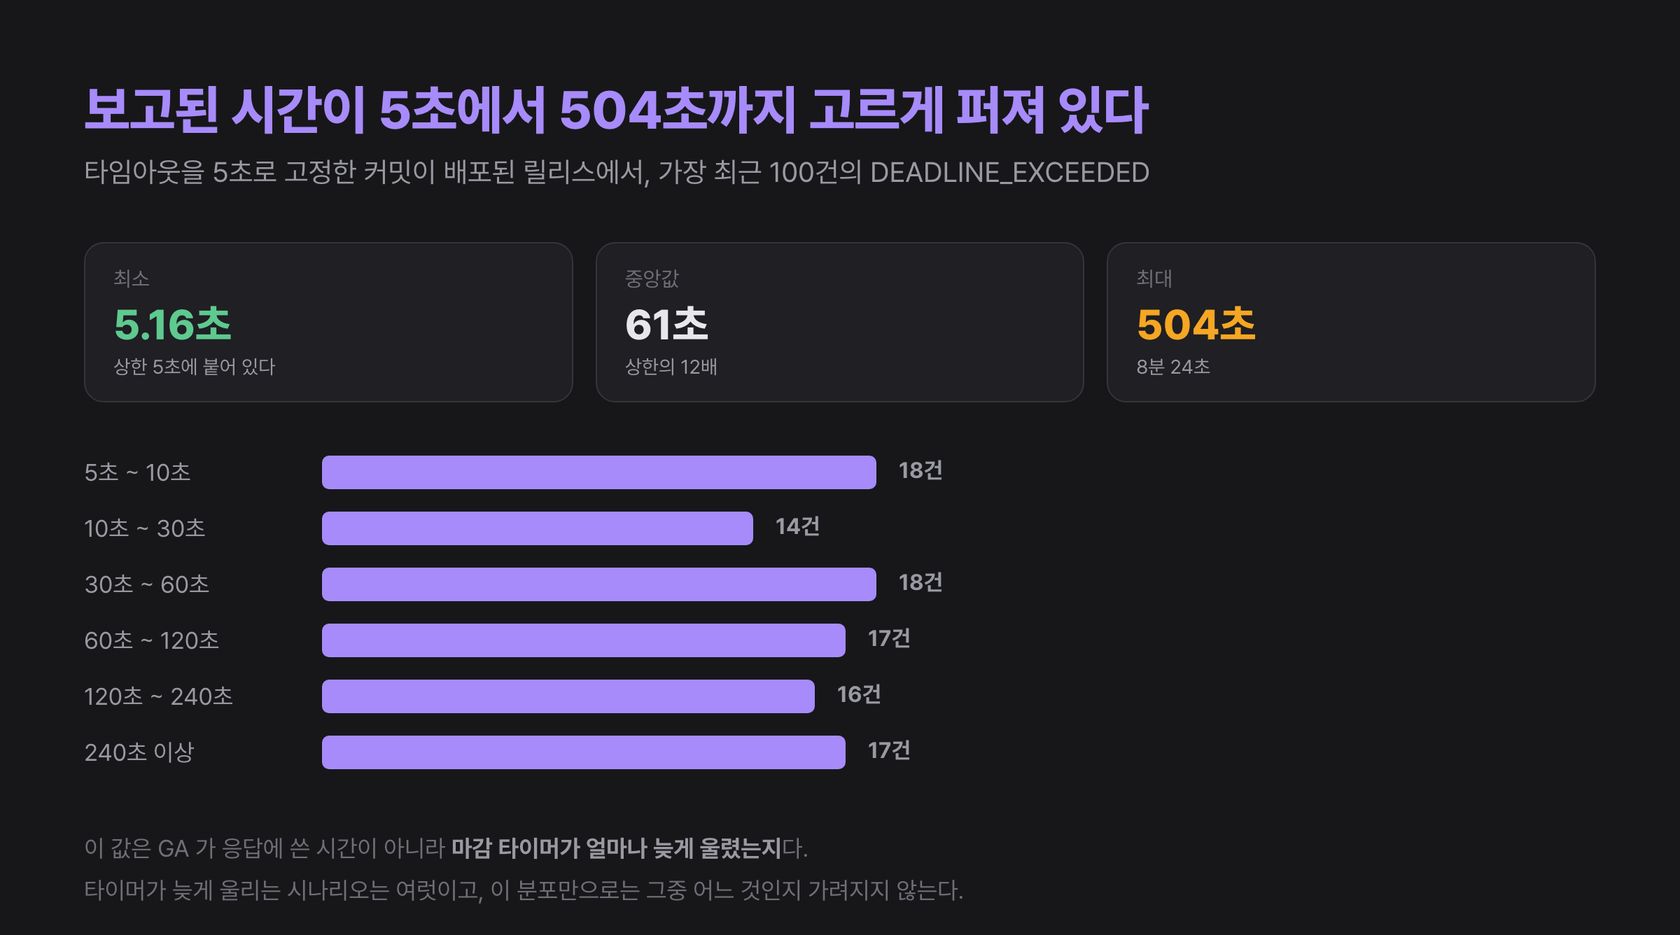
O mínimo era 5,16 segundos, colado na configuração; a mediana, 61 segundos; e o máximo, 504 segundos. Os valores não se concentraram em nenhuma faixa. (Não consigo redesenhar este gráfico agora. O motivo aparece na próxima seção) A tag tinha só dois valores, stats e popular, e eles quase sempre chegavam em pares. O que os dois caminhos têm em comum é serem caminhos de revalidação atrás de um unstable_cache de uma hora. page e pages, que chamam o GA a cada requisição, não apareceram nenhuma vez.
Então formulei uma hipótese. Numa função serverless, o ambiente de execução pode congelar depois de enviar a resposta até a próxima invocação. Se os timers também param nesse intervalo e só disparam depois de acordar, o que fica registrado não é o tempo efetivamente esperado, e sim um wall-clock time (tempo real decorrido) que inclui o período congelado. Ainda assim, uma distribuição não contradizer uma hipótese é diferente de sustentá-la. O mesmo formato apareceria se um trabalho pesado estivesse ocupando o event loop.
Os dados reabertos com MCP
Enquanto escrevia este artigo, em 16 de setembro de 2026, consultei de novo os mesmos dados com o Sentry MCP. A ideia era verificar se o que eu acreditava ter corrigido continuava corrigido, e o que eu antes procurava navegando entre telas de issues no dashboard saiu em poucas trocas de mensagens. Abaixo, separo os fatos confirmados pela consulta das inferências que tirei deles.
Por que as ocorrências pararam
A última ocorrência de JIHOON-BLOG-8 foi em 18 de agosto às 13:45 UTC, e desde então são 0. Olhando só o gráfico, parece que o problema sumiu, mas eu nunca validei a hipótese nem o corrigi. No mesmo dia, o commit 417d3b4 tirou da home as áreas de estatísticas de visitantes e de posts populares como parte da reformulação multilíngue, e as telas que chamavam stats e popular eram exatamente essas duas. A mensagem do commit 5752e09, que em setembro removeu o caminho de posts populares que restava, descreve isso assim: "o motivo direto de os eventos terem parado foi o desaparecimento dos pontos de chamada, não o timeout de 5 segundos". Alinhando os horários, porém, esse commit foi enviado para a main às 22:07 UTC, mais de oito horas depois do último evento. Com só uns dez eventos por dia, um intervalo de oito horas não é estranho em si, e também não contradiz o fato de não ter havido nenhuma ocorrência desde o deploy. Ainda assim, os horários sozinhos não permitem afirmar que a remoção dos pontos de chamada foi o que fez parar, então leio essa mensagem apenas como a explicação mais provável.
Uma issue resolved não é prova de que a causa foi identificada. Há três caminhos para as ocorrências chegarem a zero: foi de fato corrigido, ninguém passa mais por aquele caminho ou a instrumentação desapareceu. Só o sinal de erro não distingue essas três situações.
5 minutos e 39 segundos nos breadcrumbs
Extraí via MCP os breadcrumbs do último evento. Breadcrumbs costumam lembrar cliques e navegação no navegador, mas o SDK de servidor Node deste blog também registrava automaticamente as requisições http e a saída do console.
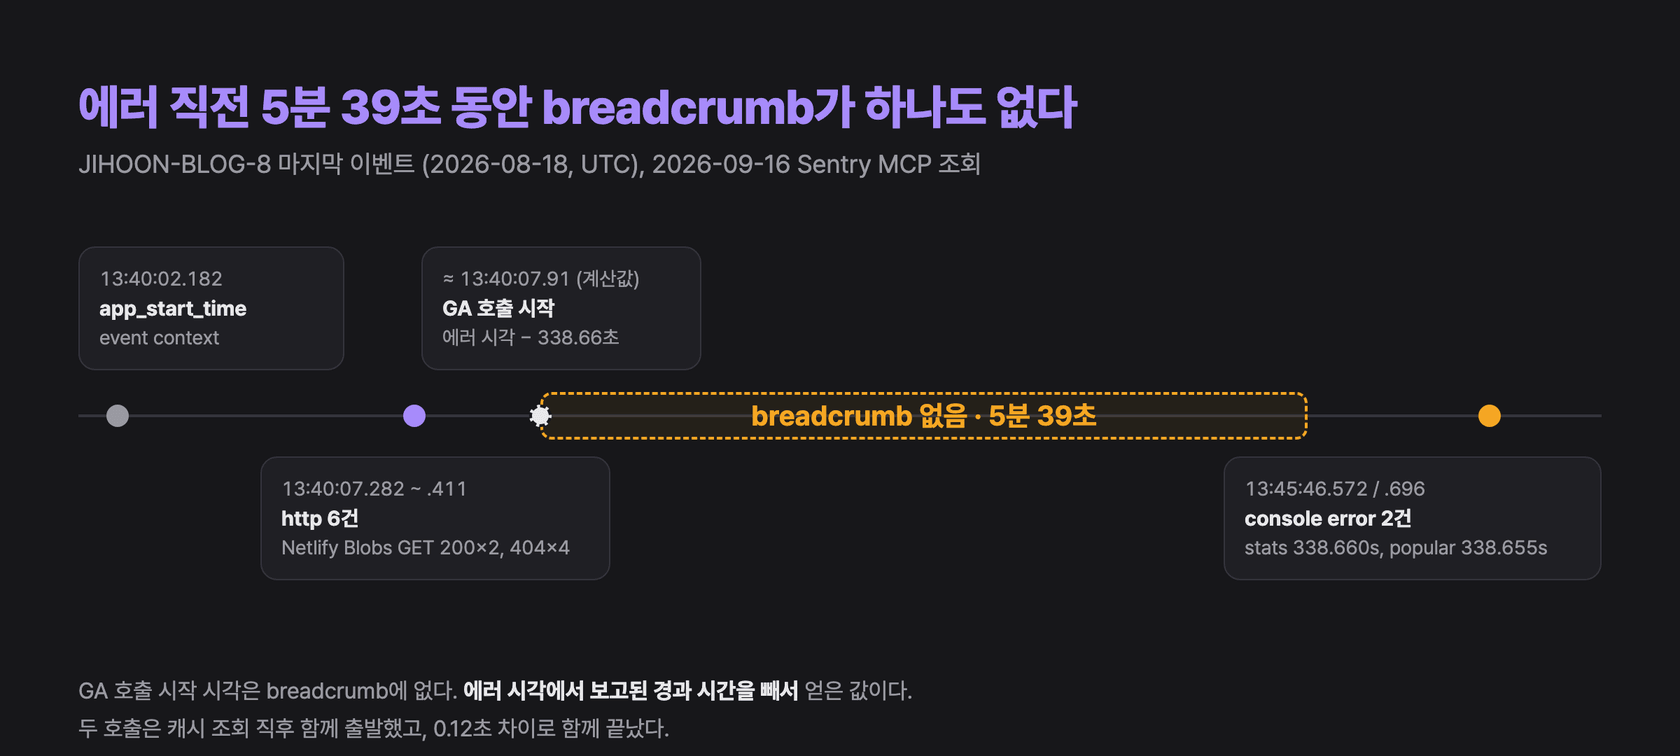
Os fatos são estes. A função começou às 13:40:02, e às 13:40:07 houve 6 consultas ao cache do Netlify Blobs. O registro seguinte são dois console error às 13:45:46. Subtraindo para trás os 338,66 segundos reportados, a chamada ao GA partiu 0,5 segundo depois das consultas ao cache e cerca de 6 segundos depois do cold start.
O que dá para tirar daqui é limitado. Um timer que deveria disparar após 5 segundos disparou após 5 minutos e 39 segundos, e nesse meio-tempo essa requisição não deixou registro algum. Isso não contradiz a hipótese do congelamento, mas também não elimina a hipótese do event loop ocupado. Ainda assim, surgiu uma informação que eu não tinha antes: o horário de início, que mostra que a falha foi uma chamada que partiu da revalidação de cache logo após um cold start.
Eventos apagados pela retenção
O contador de ocorrências da issue JIHOON-BLOG-8 marca 144. Agregando a mesma issue no dataset errors em 90 dias, aparecem só 10 numa consulta feita em 16 de setembro de 2026 às 14:26 UTC. Esses 10 restantes vão de 17 de agosto às 15:03 a 18 de agosto às 13:45 UTC, quase exatamente dentro dos 30 dias anteriores à consulta. Uma consulta no mesmo dia às 08:45 UTC retornou 14, então esse número diminui a cada consulta.
Como inferência, parece que o período de retenção de eventos é de 30 dias, de modo que os eventos antigos foram apagados e só o contador da issue ficou. A página de preços do Sentry informa 30 dias de consulta para o Developer, o plano gratuito. Porém, não verifiquei o tipo de plano desta conta nem como o contador é mantido. O que é certo é o resultado. A distribuição de 100 eventos acima não pode ser extraída de novo, e dados que não foram armazenados não são restaurados por ferramenta nenhuma.
Um trace com zero spans
Abrindo o trace pelo trace_id do mesmo evento, há 0 spans. O evento traz client_sample_rate: 0.1. Ele pode ter ficado de fora da amostragem de 10% ou pode ter passado do período de retenção de spans, e não consegui determinar qual dos dois.
Agrupando por domínio os spans http.client dos últimos 30 dias, o domínio da API do GA também não apareceu. A maioria são consultas ao Netlify Blobs. A explicação mais provável é que quase não houve chamadas ao GA nesse período (a área de estatísticas da home já tinha sido removida). Ainda não verifiquei se a instrumentação automática captura chamadas gRPC como spans. Vale notar que o count() dessa agregação é um valor extrapolado com peso inverso à amostragem, mas a resposta do MCP não trazia esse aviso. Não ler o número como quantidade de requisições continua sendo trabalho de uma pessoa.
Verificação local misturada à produção
JIHOON-BLOG-B, aberta em 16 de setembro, é Google Analytics credentials missing: GA_PROPERTY_ID. Ao abrir o evento, a URL era http://localhost:3117/api/analytics, o navegador era curl 8.7.1 e o nome do servidor era o meu MacBook. Mesmo assim, o environment era production.
É um evento gerado quando segui o procedimento de verificação local da documentação do repositório (pnpm build seguido de pnpm start). Em src/lib/sentry-options.ts, se não houver SENTRY_ENVIRONMENT, o ambiente é definido pelo CONTEXT do Netlify. É um mecanismo criado para separar os Deploy Previews da produção, mas localmente, onde não existe nenhum dos dois, nenhum valor de ambiente é passado, e o evento acabou marcado como production. Ele barrou os previews, mas não o ambiente local. Se eu configurar alertas com base em production nesse estado, meus experimentos vão disparar alertas.
Por isso adicionei SENTRY_ENVIRONMENT=local ao comando de verificação na documentação do repositório. O motivo de não ter mudado o valor padrão no código é que ainda não confirmei que CONTEXT fica sempre visível no runtime de funções do Netlify. Se eu definir o padrão como local sem confirmar, desta vez eventos de produção poderiam se esconder sob local.
O que usar e onde
Do mesmo jeito, verifiquei a partir dos dados os recursos que eu não tinha ativado. Nos últimos 30 dias havia 0 logs, 0 profiles, 0 replays, 0 cron monitors e 0 uptime monitors. Em vez de ler arquivos de configuração e escrever "não está ativado", confirmei que "é 0". A tabela abaixo resume o estado atual de cada recurso, conferido de novo na documentação oficial e nos changelogs em 16 de setembro de 2026.
| Recurso | Pergunta que responde | Pré-requisito | Custo | Veredito para este blog |
|---|---|---|---|---|
| Issues e grouping | Esses eventos são um mesmo incidente? | SDK, source maps | Cota de erros | Em uso |
| Crons | O job agendado rodou no horário? | Envio de check-ins | 1 incluído, adicionais via PAYG em planos pagos | Ativar |
| Uptime | A URL responde 2xx de fora? | Nenhum | 1 incluído, adicionais via PAYG em planos pagos | Considerar como apoio |
| Alerts | Quando acordar alguém? | Separar environment | Sem cobrança própria na tabela de preços | Se ocorreu, não um limite de quantidade |
| Logs | Quando e quanto o fallback foi executado? | Configuração do SDK | 5GB incluídos | Candidato para chamadas ao GA |
| Application Metrics | Qual é a distribuição independente da amostragem? | Versão compatível do SDK de JS | 5GB incluídos | Candidato para chamadas ao GA |
| custom span | Qual trecho da requisição foi lento? | tracing | Cota de spans, amostragem de 10% | Candidato |
| Session Replay | O que o usuário viu? | SDK do navegador | Bundle, cota de replays | Desativado (parte 2) |
| User Feedback | O que o usuário diz que está errado? | SDK do navegador | Bundle | Desativado |
| Profiling do navegador | Qual função JS bloqueou a main thread? | beta, Chromium, cabeçalhos | Horas de UI profile | Decidido na parte 3 |
| Seer | Qual é a causa e a correção desta issue? | Integração com GitHub/GitLab | $40/mês por colaborador ativo | Não executado |
| Sentry MCP | Como consultar dados a partir do editor? | Conexão OAuth | Tokens do agente | Em uso |
| Agent Tracing | Rastreamento de chamadas a LLM e execução de tools | Integração com AI SDK | Cota de spans | Não se aplica |
O que vou ativar: Crons
O primeiro a ativar é o Crons. Este blog coleta dados do Search Console toda segunda-feira com GitHub Actions, e, se numa semana esse job deixar de rodar silenciosamente, nem sequer ocorre um erro. Porque não é uma falha, e sim a ausência de um evento esperado. Conforme a documentação de Crons do Sentry CLI, envolvendo o comando existente no formato sentry-cli monitors run --schedule "<expected schedule>" <monitor-slug> -- <command>, o início e o fim são enviados como check-ins, e a autenticação é feita pelo DSN do projeto. Segundo a documentação de preços, todos os planos incluem um cron monitor e os adicionais só podem ser comprados com o orçamento PAYG de um plano pago, mas para esse uso basta um.
O Uptime oferece um contraste claro. É um recurso que acessa periodicamente uma URL de fora e, por padrão, aceita qualquer 2xx, então com a configuração padrão não consegue capturar a falha dentro de uma resposta 200 que vimos antes. Com o Verification, disponível para o programa Early Adopter, dá para verificar até o corpo JSON, mas neste blog isso ainda ajudaria pouco. A maioria das falhas veio do caminho de revalidação de cache, não de requisições de visitantes, e nenhum cliente chama mais a rota da API de estatísticas. Faz sentido como apoio para quando o site inteiro cai, mas está numa camada diferente da falha que este blog realmente viveu.
Logs e Metrics para as chamadas ao GA
Há um motivo para eventos de erro não bastarem nas chamadas ao GA. Como o unstable_cache guarda em cache até os resultados de falha por uma hora, os eventos de erro dos caminhos atrás do cache são no máximo um por hora. Ler a quantidade de eventos como alcance do impacto leva a subestimá-lo sistematicamente. E, como vimos na seção anterior, eventos antigos desaparecem, e não foi possível redesenhar a distribuição.
A documentação de breadcrumbs do Sentry para Next.js recomenda logo no início usar Logs em vez de breadcrumbs manuais. O Logs ficou GA em setembro de 2025 e é adequado para registrar cada execução do fallback junto com o tempo decorrido. Se o objetivo é a distribuição em si, o Application Metrics, GA desde maio de 2026, é mais direto. A documentação de span metrics também encaminha para o Application Metrics as agregações que não são afetadas pela amostragem de traces. Custom spans são bons para ver trechos dentro de uma requisição, mas, sendo uma amostra de 10%, deixam escapar falhas raras. Ainda não ativei nenhum dos três, e, se ativar, começaria pela distribuição no Metrics.
Pelo mesmo motivo, não coloco alertas em quantidades. Um limite de "N ou mais" sobre eventos achatados a no máximo um por hora fica em silêncio enquanto subestima o impacto. Por isso o veredito deste blog é se ocorreu ou não. My Philosophy on Alerting, de Rob Ewaschuk, recomenda alertar sobre os sintomas que o usuário sente e não sobre as causas, mas esse princípio parte da premissa de que o sintoma aparece em algum lugar. Neste blog a falha fica escondida atrás de uma resposta 200 e de um 0, então só instrumentando o fato de o fallback ter rodado surge um sintoma sobre o qual alertar.
Recursos que exigem o SDK do navegador
Session Replay e User Feedback pressupõem o SDK do navegador. Este blog decidiu não incluir esse SDK, então o veredito atual é "desativado", e o fundamento do custo de bundle fica para a parte 2. O profiling do navegador também precisa do SDK, além de estar em beta e vir com várias condições; o que essas condições realmente mostram é analisado na parte 3.
Recursos que não rodei
Segundo a documentação de preços, o Seer é um add-on pago que, além de uma assinatura, custa $40 por mês por colaborador ativo. Desta vez considerei rodá-lo na issue InvariantError interna do Next.js aberta em 11 de setembro (JIHOON-BLOG-A), mas não rodei, porque ele exige essa assinatura. Não verifiquei se esta conta a tem. Por isso este artigo não traz experiência de primeira mão com o Seer. O Agent Tracing ficou GA em 11 de setembro de 2026. É um item fácil de descrever erroneamente como beta quando se confia na memória de um modelo ou em artigos antigos, mas este blog não tem caminhos de chamada a LLM, então não se aplica.
O que a IA reduziu e o que não reduziu
Os custos que a IA reduziu neste trabalho são claros. Reunir condições em documentação espalhada (se o profiling do navegador está em beta, os cabeçalhos, as restrições de navegador), aprender a sintaxe de consulta para ir trocando o group by, a conta de subtrair e somar horários de breadcrumbs e o rascunho da tabela de recursos: tudo se resolveu em poucas trocas de mensagens. Por exemplo, a linha do tempo de breadcrumbs saiu de uma única chamada a get_issue_breadcrumbs, e confirmar que não havia monitores levou duas chamadas, find_monitors e find_uptime_monitors. Com a barreira da exploração mais baixa, ficou possível perguntar primeiro "o que os dados atuais dizem" antes de decidir "ativo ou não".
O que ela não reduziu é igualmente claro.
- Dados que não foram armazenados. Dos 144 eventos, 134 (às 14:26 UTC de 16 de setembro) sumiram, e os spans que ficaram fora da amostra nunca existiram. Um agente não restaura dados que não existem.
- Experimentos que exigem deploy. Se chamadas gRPC são capturadas como spans, e se é possível distinguir congelamento de event loop ocupado, só se descobre adicionando instrumentação de verdade e fazendo deploy.
- As condições de interpretação. Nem o aviso sobre valores extrapolados nem o fato de um evento local ter sido marcado como production apareceram nas respostas. Percebi porque li eu mesmo a URL e o nome do servidor do evento.
- A defasagem entre datas e ferramentas. Em recursos como o Agent Tracing, cujo status mudou cinco dias antes, precisei abrir o changelog para confirmar. As ferramentas de MCP também ainda estão correndo atrás do produto. Colocar
ORnuma busca de issues retornou 400, e a ferramenta de consulta de regras de alerta retornou 410This API no longer exists. - O que considerar falha. Foi porque antes veio a decisão de definir uma resposta 200 com estatísticas zeradas como falha e de descer o ponto de instrumentação que restaram eventos para reabrir.
Conclusão
Resumindo, o motivo de eu ter deixado desativada a maior parte dos recursos do Sentry não era desconhecimento, e sim o custo de verificar. A IA reduziu bastante esse custo, e graças a isso minha ordem mudou: antes de ativar recursos, pergunto primeiro aos dados desta conta. Os dados que reabri assim mostraram, antes de qualquer recurso novo, alguns fatos incômodos. A falha que eu acreditava ter corrigido só parou sem nunca ter sido corrigida, a distribuição daquela época não pode mais ser redesenhada porque passou do período de retenção, e a minha verificação local estava se misturando às issues de production.
Por isso os próximos passos deste blog não foram definidos por uma lista de recursos, e sim pelas lacunas. Colocar o Crons na coleta semanal, escolher para as chamadas ao GA sinais menos abalados por retenção e amostragem, e começar corrigindo o nome do ambiente local. Espero que quem lê este artigo também pense nos recursos que nunca ativou numa ferramenta que usa há muito tempo. Se aquele recurso realmente não era necessário, ou se só era caro verificar, agora é algo que dá para perguntar diretamente aos dados.
O próximo artigo passa para o lugar do SDK de navegador que este blog decidiu não instalar e, em Observabilidade do navegador, vê como enxergar o que acontece na tela do visitante.