系统观测
这篇文章想聊聊系统观测。
我在公司长期负责基于 Sentry 的错误监控。issue 一上来,打开 stack trace,用 release 和标签缩小范围,寻找复现条件,这些都是熟悉的工作。可偏偏这个博客一直没有错误监控,直到今年 8 月我才以仅服务器端的配置接入了 Sentry。而刚接上,这套插桩就抓住了一次真实的故障。本文的后半部分,就是调查那次故障、相信已经修好、重新测量后确认那个信念是错的的记录。
在浏览器观测中,我们看了浏览器把网络、渲染、用户输入留成什么样的数据。但就算在浏览器里发现了一个慢请求,问题也没有结束。还得继续追:那个请求是在 CDN 慢了,在 API 服务器等了,卡在数据库调用上了,还是捕获了失败并返回了默认值。
本文从一个错误事件出发,追踪每种信号如何补上前一种信号回答不了的问题。用 breadcrumb 还原出错前的那段时间,用 trace 和 metric 找到路径和影响范围,用 profile 和 Replay 确认执行成本和界面上下文。最后,把问题扩展到要把什么当作失败来插桩,包括从未发生的事件和藏在成功响应里的失败。我经历的那次故障,恰好横跨这两个类别。
对前端工程师来说,这条边界正变得越来越模糊。从 React 组件发起的请求,会一路连到 Server Component、route handler、外部 API、queue 和 background job。屏幕上出现的症状在浏览器里,但原因可能在系统的另一层。
以前要进入这个领域,得先了解每台服务器的日志格式和运维工具。现在,在 Sentry 这样的产品里可以在错误与相关的 trace、profile、replay 之间来回移动,OpenTelemetry 则为不同工具之间交换信号提供了共同规约。
但这不意味着观测会自动完成。留下哪些信号、用什么标识符把它们连起来、把什么叫作失败,这些都必须由构建系统的人来决定。
一条错误的上下文
最熟悉的出发点是错误事件。异常发生时,把消息和 stack trace 发送出去,就能知道是哪段代码失败了。但调试真正需要的,与其说是那一个异常对象,不如说是它周围的上下文。
看 Sentry 的 Issue Details 文档,一个事件上除了 stack trace,还可以附上 breadcrumb、tag、context、release、trace、replay、attachment。每个要素回答的问题各不相同。
| 信息 | 回答的问题 |
|---|---|
| stack trace | 异常发生在哪条代码路径上 |
| source map | 能否把部署后的 bundle 位置还原为原始源码的文件和行号 |
| breadcrumb | 异常之前有过哪些请求和用户行为 |
| tag | 在哪个浏览器、release、路由、功能中反复出现 |
| context | 理解这个事件需要哪些结构化的值 |
| release·commit | 首次出现在哪次部署,与哪个变更接近 |
| trace | 同一请求流程的其他服务和 span 里发生了什么 |
| replay | 用户在屏幕上实际经历了怎样的状态 |
这个区分里,重要的是可搜索性。Sentry 的 tag 是为在 UI 中搜索和过滤而设计的 key-value,而 context 是用来在事件详情中阅读结构化值的区域,不是 UI 过滤的对象。把所有东西都塞进 context,单个事件会变得丰富,但"在哪类客户中增加了"这类反复出现的问题就难以回答。
反过来,把所有值都作为 tag 发送,cardinality 和存储成本就会膨胀。邮箱、完整 URL、任意错误消息这类取值种类无限增长的属性,很难做成 tag。插桩设计既是附加信息的工作,同时也是决定要反复搜索哪些问题的工作。在后文我的调查中,起决定性作用的也不是 stack trace,而是顺手加上的一个标签。
只接在服务器端的插桩
这个博客的 Sentry 是仅服务器端的。我没有放浏览器 SDK 的初始化文件。因为我决定不支付浏览器插桩增加的 client bundle 成本,而引入的目的是抓住在服务器上静默失败的调用,那部分几乎是免费的。所以能抓到的和抓不到的就分开了。route handler 和服务器组件的错误,以及在服务器上执行的 Google Analytics 查询的失败,能抓到。客户端组件的事件处理器、水合不一致这类只在浏览器里发生的错误,抓不到。
在这个配置下,有两件事我想亲自确认。
一是自动钩子的范围。接好 Next.js 的 onRequestError 钩子后,未处理的路由错误也能在不直接调用 captureException 的情况下被捕获。我在 Deploy Preview 上放了一个故意抛异常的临时路由来确认,事件带着 auto.function.nextjs.on_request_error 这个 mechanism 进来了。
二是 source map。应用之前,生产事件的 culprit 是 y([root-of-the-server]__468aa3ae._) 这样被混淆的 bundle 位置。上传 source map 之后,同类事件被解析到了 src/... 路径、行号,甚至周围的源码。这正是表格第二行所回答的问题实际分岔的地方。
这里记一条岔路。上传之后,必须从构建产物中删掉 .map 文件。因为 Turbopack 生成的服务器 source map 有 57MB,比服务器 JS(15MB)还大,放着不管就会全部装进部署函数的 bundle。刚好有一个上传后删除 source map 的 deleteSourcemapsAfterUpload 选项,我打开了,但实测发现,即使在上传刚结束时,服务器的 .map 也原封不动地留着 57MB。那个选项只删 .next/static,偏偏不碰真正占体积的 .next/server。最后我改成直接指定要删除的路径,并且出于同样的理由,不再永远关闭上传日志,而是有条件地保留。日志一直关着的话,就算令牌过期导致上传整个失败,也要等到下次看到无法阅读的 stack trace 时才有人知道。读了文档打开一个选项,和确认那个选项做了你期待的事,是两回事。
分组与原因的差别
Sentry 把相似的事件归并成一个 issue。默认的 grouping 中,stack trace 是核心信号,exception 和 message 之类的信息也会被使用。必要时可以用 fingerprint 改变归组的标准。
不过,同一个 issue 未必意味着同一个原因。如果网络错误都从包裹 fetch() 的一个公共函数抛出,DNS 失败、认证过期、upstream 的 500 响应就可能混进同一个组。反过来,同一个原因在多条代码路径上产生不同的异常,就会被拆成多个 issue。
issue 是待调查事件的集合,不是领域原因的分类表。把 grouping 原样当作故障件数或产品 KPI 使用,就会错过这个差别。
必要时可以调整 fingerprint,或把 domain error code 加成 tag。但过早把 grouping 规则做得太精细,会错过 SDK 的默认改进,只让运维规则越积越多。我认为更好的顺序是,先看实际的事件分布,确认默认 grouping 挡住了哪些问题。
失败的时间轴
错误通常只留下最后一幕。breadcrumb 把在那之前发生的事按时间顺序附上。除了浏览器的 navigation、click、console message、HTTP request,应用自己记录的状态变化也可以放进去。
它和传统日志相似,但目的略有不同。日志存储擅长搜索整个服务的事件,breadcrumb 擅长还原特定错误发生前的那小段时间轴。
所以,重要的状态变化可能两个地方都需要。如果支付状态从 pending 变成了 failed,在运维日志里统计整体失败率,在错误事件的 breadcrumb 里看那一个用户经历的顺序。这不是复制同一个事实,而是构造互不相同的搜索单位。
OpenTelemetry 的 Logs 文档介绍了把活跃 trace 和 span 的标识符附加到既有日志上、自动建立关联的方式。日志真正的效用不在行数,而在能移动到其他信号的连接点上。
延迟产生的路径
如果说错误回答的是"什么坏了",那么 trace 回答的是"一个请求经过了哪里、把时间花在了哪里"。
trace 是多个 span 的集合。浏览器的文档加载、fetch、服务器的 route handler、外部 API 调用、数据库查询和 background job,都可以各自成为一个 span。只要共享同一个 trace_id,就能还原成一张请求图。
这种连接不会自动产生。跨越请求边界时,必须传递 trace context。W3C 的 Trace Context 标准定义了 traceparent 和 tracestate 两个 header 的格式。它是让不同供应商也能把同一个请求接起来的最小公共语言。
在前端,这里也有条件。
- 向所有外部域名发送 trace header,可能带来信息暴露和 CORS 问题。
- 必须限制范围,让浏览器 SDK 只向被允许的 API origin 传递 context。
- 服务器和 upstream 也要保留或转换同样的 header。
- 如果各服务各自做 sampling 决定,trace 的中间就会出现空洞。
trace 断掉的时候,与其以"没有数据"收场,不如确认 context 是在哪条边界上消失的。从浏览器到服务器的分布式追踪,与其说取决于装了 SDK,不如说取决于 context propagation 的设计。
该放进 span 的边界
自动插桩很擅长捕捉 HTTP 请求、DB 调用、framework lifecycle 这类库级边界。OpenTelemetry 的 Instrumentation 文档解释说,zero-code instrumentation 作为起点很有用,但要看到应用内部的判断,就需要 code-based instrumentation。
比如,只凭"订单 API 整体花了 800ms"这样的自动 span,很难知道为什么慢。可能需要这样的领域 span。
await tracer.startActiveSpan('checkout.calculate-discount', async (span) => {
  span.setAttribute('promotion.type', promotionType)

  try {
    return await calculateDiscount(cart)
  } finally {
    span.end()
  }
})
不过,如果每个函数都建一个 span,trace 就变成了代码执行记录。观测的目标不是保存所有调用,而是区分关于延迟和失败的假说。
好的 span 边界,大体是下面几种之一。
- 网络、DB、queue 这类失败主体发生变化的边界
- cache hit 与 miss 这类执行路径分岔的边界
- 支付批准、权限判定这类领域结果分岔的边界
- 需要单独管理延迟预算的工作
如果看着一个 span 说不出谁做了什么、做了多少,就该重新审视边界或名字。
从分布到个案
把 trace 全部存下来,成本会迅速膨胀。所以通行的方式是,用 metric 看系统的整体状态,再针对异常区间的具体请求下钻到 trace。
OpenTelemetry 的 Signals 文档把 trace、metric、log、baggage 区分为互不相同的 telemetry signal。在单独的 Profiles 文档里,profile 信号截至 2026 年 9 月标注为 Alpha。数据模型和 OTLP 传输路径已经有了,但不应假定它与稳定化的信号处于同一水平。
各信号的强项如下。
| 信号 | 强项 | 弱项 |
|---|---|---|
| metric | 整体趋势、比率、分布、告警 | 缺少单个请求的上下文 |
| trace | 单个请求的路径与延迟 | 全量存储成本高 |
| log | 事件的详细记录与自由搜索 | 格式和 cardinality 容易失控 |
| profile | 使用 CPU 和内存的代码位置 | 不与请求关联,用户影响就模糊 |
这些信号不是竞争关系。比如,先在 latency histogram 里找到 p99 恶化的时间段,再用 exemplar 或 trace id 打开慢请求,然后看那个 span 的日志和 profile,这样移动。
Grafana Tempo 在官方文档中提供了从 trace 生成 metric,并与 Loki 日志、Prometheus metric 相连的结构。开源栈的优点是,不被某个 SaaS 的界面锁住,可以自己设计信号的存储和连接方式。代价是 Collector、storage、retention、查询性能和升级都得自己运维。
执行成本的位置
从 trace 知道了某个 span 花了 2 秒,但可能不知道这段时间里 CPU 用在了哪里。profile 通过记录函数级的执行样本和 resource usage 来填补这个空白。
在这里,trace 和 profile 的问题也不一样。
- trace: 用户的请求经过了哪些服务和工作
- profile: 那段时间里哪些函数用了 CPU
Sentry 在 2025 年发布了与既有 profiling 产品相区分的 Continuous Profiling 和 UI Profiling。Continuous Profiling 看受支持服务器 runtime 的长时间 resource usage,UI Profiling 看用户会话的执行成本。起初以 iOS·macOS 和 Android 为中心,但从 2025 年 12 月起,Browser JavaScript 和 Electron 也支持 UI Profiling了。
即便如此,并非所有 runtime 都用同样的方式测量。在浏览器里,DevTools 的 CPU profile 和 Long Animation Frames 可能是更直接地深挖特定会话的工具。比起产品名,更该确认支持的 platform、sampling 方式、采集 overhead,以及与 trace 的关联范围。
会话的重构
当用户说"按钮点不动"时,仅凭错误和 trace 很难知道屏幕的状态。Session Replay 把 DOM 变化、输入、navigation、console、network 信息连成可回放的形式。
Sentry 的 Session Replay FAQ 解释说,replay 不是录制像素的视频,而是记录浏览器 DOM、事后重构的结果。所以它可能和原始画面不完全一致,canvas 和外部资源还带有额外条件。
这个差别从隐私角度看也很重要。DOM 里有输入值、账号信息、帖子内容。Sentry 的 Web Replay SDK 提供对 text 做 mask、对 media 做 block 的默认值,但应用的 DOM 结构和 custom component 并不会自动变得安全。request 和 response body 的采集,也应只对必要的 URL 显式放行。
打开 Replay 之前,应该先定好下面这些。
- 把哪些错误和 session 留作样本
- 对哪些 DOM 区域和输入做 mask 或 block
- 是否需要采集 network body 和 header
- 谁能看 replay,保留多长时间
- SDK 和 DOM serialization 的成本是否值得让用户承担
Replay 的上下文有多强,采集范围就有多强。可调试性与数据最小化之间的决定,不能只交给产品默认值。(这个博客不用 Replay。因为对一个加载性能就是搜索曝光前提的服务来说,我判断访客付出的成本大于采集换来的答案)
以缺席显形的失败
错误、trace、Replay 能深入展示已发生事件的上下文。但如果定时任务压根没有启动,连可以留下的事件都不存在。
Cron monitor 以 check-in 的形式接收任务的开始和完成状态,在预定时间没有信号到来时,可以生成 missed 状态。此时观测的对象不是代码抛出的错误,而是所期待事件的缺席。
对我来说这不是别人的故事。这个博客每周一自动采集 Search Console 数据,而哪一周那个任务悄悄没跑,我现在没有办法知道。因为它不是失败了,而是什么都没有发生,所以不会产生错误。收集观测数据的装置本身,就处在盲区里。
这个视角同样适用于 health check、queue consumer、数据采集 pipeline。仅凭"失败事件为 0 件"这个 metric,无法得知健康。必须同时看:有没有该处理的输入,最后一次成功是什么时候,处理量是否在平时的范围内。
让观测变难的,往往不是发生了的事件,而是没有发生的事件。而这句话,后面还会以我没有预料到的方式再回来一次。
成功响应里的失败
反过来,也有事件确实发生了、却因被归类为成功而看不见的失败。我刚接上插桩就遇到的,正是这一种。
最初的计划很简单。在统计 API route handler 的 catch 里放上错误上报,Google Analytics 查询失败时就能知道了。可是在本地生产构建中注入错误的服务账号密钥、故意让它失败后发现,错误根本没有到达路由的 catch。下面一层的统计查询模块里的四个 catch 块先把它接住并返回了默认值,响应就这样发了出去。
HTTP 200 OK
{ "slug": "/260610", "views": 0 }
访客看到的统计是 0,服务器却回答一切正常。只看路由的错误率和 uptime,什么都没发生。系统的成功条件和用户的成功条件不一样。(catch 该放在哪一层,我在错误处理里谈过;那时的问题是"该在哪里接住",这次遇到的是"接住了却没人知道")
于是我把插桩点从路由挪到了那四处,并加上了区分是哪个查询爆掉的标签。这个标签在后面起了决定性作用。
这种情况早已有了精确的名字。Microsoft 和 Azure 团队在 2017 年 HotOS 上发表的 Gray Failure 论文指出,云上的重大可用性事故大多不是完全停摆的那种,而是来自这种灰色地带,并这样界定它的核心特征。
我们主张,gray failure 的核心特征是 differential observability,也就是说,即使应用正在受到伤害,系统的失败检测器也可能察觉不到问题。
we argue that a key feature of gray failure is differential observability: that the system's failure detectors may not notice problems even when applications are afflicted by them.
一方正因失败而受损,另一方却感知不到那个失败,而问题在于后者恰恰是负责失败检测的一方。我把插桩点从路由下移到下层,正是填补那道认知落差的工作。
解决办法不是把所有默认值返回都改成失败。fallback 可以是守护用户体验的正确选择。取而代之的是,要把 fallback 被执行了这个事实、原调用的延迟、受影响的功能,作为单独的信号留下来。
try {
  return await fetchAnalyticsStats()
} catch (error) {
  captureException(error, { tags: { gaQuery: 'stats' } })

  return { totalPageViews: 0, todayVisitors: 0 }
}
需要观测的不是异常,而是系统偏离了正常路径这个事实。
挂起 65 秒的 GA 调用
挪完插桩点之后上来的第一个真实生产 issue,就是这个故事的下一幕。GA 调用在 65.877 秒后以 DEADLINE_EXCEEDED 失败。可由于上面看到的结构,响应仍然是 200。当时首页用动态渲染把统计区域以流式送出,页面本身立刻就出来了。只是那个位置长时间停留在加载状态,然后悄悄被 0 填满。
深挖原因,发现我用的 GA 客户端库的配置文件里写死了这个。
"RunReport": { "timeout_millis": 60000, "retry_params_name": "default" }库的默认 RPC 超时是 60 秒,而我的代码在五个调用点中任何一处都没有传超时。这不是只有我犯的错,而是被广泛警告过的那类错。Google SRE 的 Gráinne Sheerin 在 gRPC 官方博客的 deadline 文章里,标题下第一行就是"TL;DR: Always set a deadline",并解释说没有 deadline 时,进行中的请求会占着资源,一直挂到最大超时。我用的 GA 客户端也是基于 gRPC 的,同样的原理文档早已警告过,只是调用点没有遵守。
修复就是把超时固定为 5 秒,传给所有调用点。然后我架起一个不响应的本地 TCP 服务器,做了确定性的复现。
| 条件 | 经过时间 | 错误消息 |
|---|---|---|
| 未指定超时(修复前) | 60.04 秒 | Deadline exceeded after 60.000s |
timeout: 5000(修复后) |
5.00 秒 | Deadline exceeded after 5.000s |
数字按说明的那样动了,所以至少确认了超时设置能到达代码。有一点要说明,5 这个数字本身没有依据。我没有测过 GA 正常时的响应延迟分布,所以它实际上是任意选的值。不过方向上有可以依靠的东西。Google SRE 书的 Embracing Risk 说,100% 从来不是正确的可靠性目标。在这个博客里,访客数字是附加信息。与其精确地取回来,不如快点放弃、画出默认值,对访客体验更好。
修复之后重新测量的分布
到这里,本该是这次调查的结局。原因找到了,复现了,也修了。可我却发现,在部署了修复提交的 release 里,同一系列的 DEADLINE_EXCEEDED 已经堆了一百多件。
我取出最近的 100 件,看了上报时间的分布。先要指出的是,这个值不是 GA 实际用于响应的时间。它是从挂上 deadline 计时器的那一刻,到那个计时器实际响起的那一刻之间的 wall-clock time(实际经过时间)。
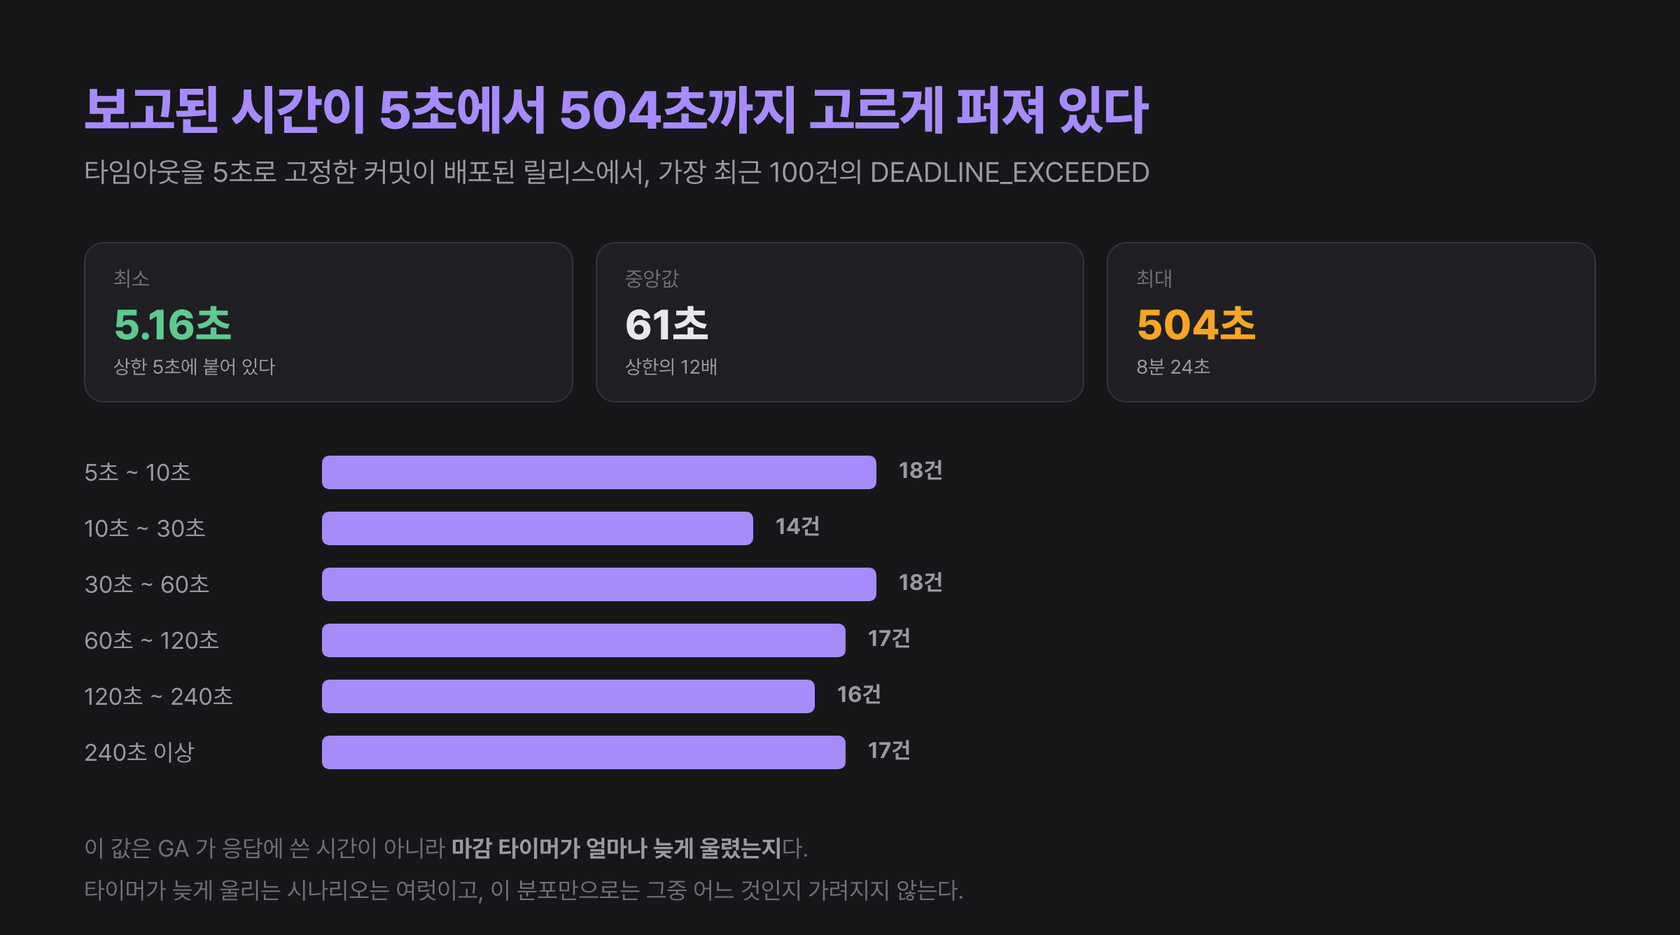
读下来是这样的。**下限守住了。**没有一件在比 5 秒更短处被切断,最短的是 5.16 秒,说明 5 秒这个设置本身到达了代码。可是往上一路爬到 8 分 24 秒,中位数是 61 秒。更奇怪的是,数值不向任何区间聚集。如果是 GA 真的变慢造成的延迟,应该堆在上限附近,但并没有。
标签告诉了我更多。100 件上打的标签只有 stats 和 popular 两个,而且大多两件成对出现。这两条路径的共同点是,都是躲在一小时缓存后面的再验证路径。相反,不经缓存、接到访客请求就当场调用 GA 的其余路径(page、pages),在这 100 件里一次都没出现。这意味着失败不是发生在处理访客请求的过程中,而是只发生在响应结束后重新填充缓存的工作里。
这个观察动摇了前面某一节里写下的一句话。我写过统计位置长时间停留在加载状态,但如果失败只发生在响应之后的路径上,访客也许根本没有等过那段时间。等于又多了一句没测就写下的话。
我立的假说是这样的。这个博客跑在 serverless 函数上,serverless 函数发送响应后,执行环境会冻结到下一次调用。如果这期间计时器也一起停住,等函数醒来时才迟迟触发,那么记录下来的可能不是实际等待的时间,而是按 wall-clock time 膨胀过的值。下限精确贴在 5 秒上,上方的值不向任何地方聚集,以及失败只出现在响应后工作里的观察,都与之相符。
不过这里必须小心。**分布与假说不矛盾,和分布支持假说,是两回事。**计时器迟迟触发的情形不止一种。除了 serverless 冻结,也可能是沉重的渲染咬住了事件循环,也可能是容器在压缩 CPU。库配置里重试总预算是 600 秒,观测到的最大值 504 秒落在其内,这一点我也留作了候选。它们全都能造出同样形状的分布,所以这张图并不能收窄候选。
能划掉一个候选的,是同一区间的 CPU 使用时间。如果 wall-clock time 过去 61 秒的同时,CPU 时间几乎为 0,"沉重的渲染咬住了事件循环"这个解释就被排除了。前面看到的 profile 信号所回答的,就是这个问题。
不过 CPU 时间并不能到此为止。因为真正等待响应的期间 CPU 时间也接近 0,等待的区间和停住的区间看起来是同一副模样。要把两者分开,得看那段区间内时间是否均匀流逝。比如挂一个以短间隔反复触发的计时器,看有没有间隔一下子被拉开的地方。如果执行环境冻结了,间隔会跳;如果是真的在等待,间隔会均匀流动。只在调用前后各测一次时刻是不行的。函数冻结期间 wall-clock time 照样流逝,那只是把已有的数字再造一遍。
顺带一提,这份 issue 列表、标签分布和时间值,我不是打开仪表盘看的,而是接上 Sentry 官方 MCP 服务器、向智能体提问后拿到的。下降的不只是接插桩的成本,翻看积累数据的成本也下降了。
停止发生的原因不是修复
写这篇文章时,我又查询了那个 issue。为了确认曾相信修好的东西,现在是否仍然是好的。
截至 2026 年 9 月 14 日,那一系列的 issue 停在总共 144 件。最后一次发生是 8 月 18 日,此后 27 天为 0 件。标签分布到最后也只有 stats 和 popular 这一对。只看发生图表,问题像是消失了。
可是这期间,前一节里写下的测量我一个也没有做。从未验证假说、从未据此修复,为什么停了?对照部署历史,答案在别处。最后一个事件被记录的那天提交的多语言改版,把访客统计和热门文章区域从首页拿掉了。调用 stats 和 popular 再验证路径的界面恰好就是那两个,所以那次改版部署到生产之后,会失败的代码根本没有被调用的机会。不是失败的代码被修好了,而是调用它的界面消失了。
所以这次故障不是被解决了,而是观测对象消失了。serverless 冻结假说仍然未经确认,在生产环境里重现那个分布的复现条件也随之消失。最早报出 65.877 秒的最初 issue 的原始事件,已过保留期,现在连打都打不开了。
我留下这一节是有理由的。issue 列表里的 resolved 不是原因查明的证明。发生数归零的路径有好几条。真的修好了,或者再没有人走那条路径了,或者插桩本身消失了。仅凭错误信号无法区分这三者。能区分它们的,是调用量和最后一次成功时间这类正常路径的信号,这也是前面那节说的"没有发生的事件"的观测之所以必要的又一个理由。如果说接插桩是一次性的工作,那么观测就是不断重新测量的工作。
采样的知识边界
trace、replay、profile 因为存储成本和 client overhead 而需要 sampling。问题在于,降低 sample rate 减少的不只是成本,能回答的问题也一起减少。
随机 10% 的 sampling 用来估计整体分布也许还行,但可能漏掉罕见的错误。这就是为什么需要这样的策略:只为出错的 session 额外保留 replay,或优先保存慢的 trace 和失败的 trace。
反过来,只留出错的请求,就失去了与正常用户比较的基准。无法判断慢请求是特别慢,还是整个系统都慢。
我也付过这笔代价。这个博客为了省钱,把 trace 样本设成只收 10%,而在上面的调查中,要判断被夸大的经过时间是不是真实等待,需要那段调用区间的开始和结束,样本太浅,问题请求的 trace 根本不存在。省下的是我的账单,失去的是能回答的问题。
sampling 应该是按问题制定的策略,而不是一个数字。
- 用于 baseline 的概率样本
- 用于错误和 latency threshold 的优先样本
- 用于调查特定 release 和功能的临时样本
- 隐私和成本都高的 replay·profile 的单独样本
没有存下的数据,事后连 AI 也无法复原。
AI 之后的插桩设计
AI 在系统观测中有用,是因为数据已经结构化了。issue、event、tag、span、trace、release 都能通过 API 查询,日志和 profile 也带有时间和标识符。我能在编辑器里向智能体询问、拿到 issue 的标签分布和发生停止的日期,也是托这个结构的福。
Sentry 在 2026 年 6 月扩充了 agent 和自动化所使用的 API 文档,包括 tracing、profiling、attachment 相关的 endpoint。这说明观测数据不仅是人在仪表盘上阅读的信息,也正被用作 agent 查询证据的接口。
AI 让下面这类探索变快。
- 找出最近 release 之后增加的 issue 与 tag 组合
- 总结特定 trace 的慢 span 和相关日志
- 找出多个事件中共同出现的 breadcrumb 和浏览器环境
- 把 profile 的 hot path 和相关 commit 候选连起来
- 提出复现假说和额外的插桩点
但没有被插桩的 domain state,agent 也无从得知。checkout.result、cache.status、fallback.reason 这类属性该留在什么位置,必须理解代码和用户的期待才能决定。在我的调查中,智能体之所以能立刻取出分布和标签,是因为先有了把插桩点下移到下层、打上标签的判断。
AI 可以提出 root cause,但把什么定义为失败、以什么成本观测哪些用户,是工程判断。
把信号连成一个事件
把 Sentry 的每个功能全部打开,不是本文的结论。应该能从错误出发,用 breadcrumb 看过去,用 trace 沿着请求路径走,用 metric 确认影响范围,必要时下钻到 replay 和 profile。在此之上,像 Cron monitor 那样对期待事件缺席的观测,以及被归类为正常响应的偏离,也必须进入同一条调查流程。
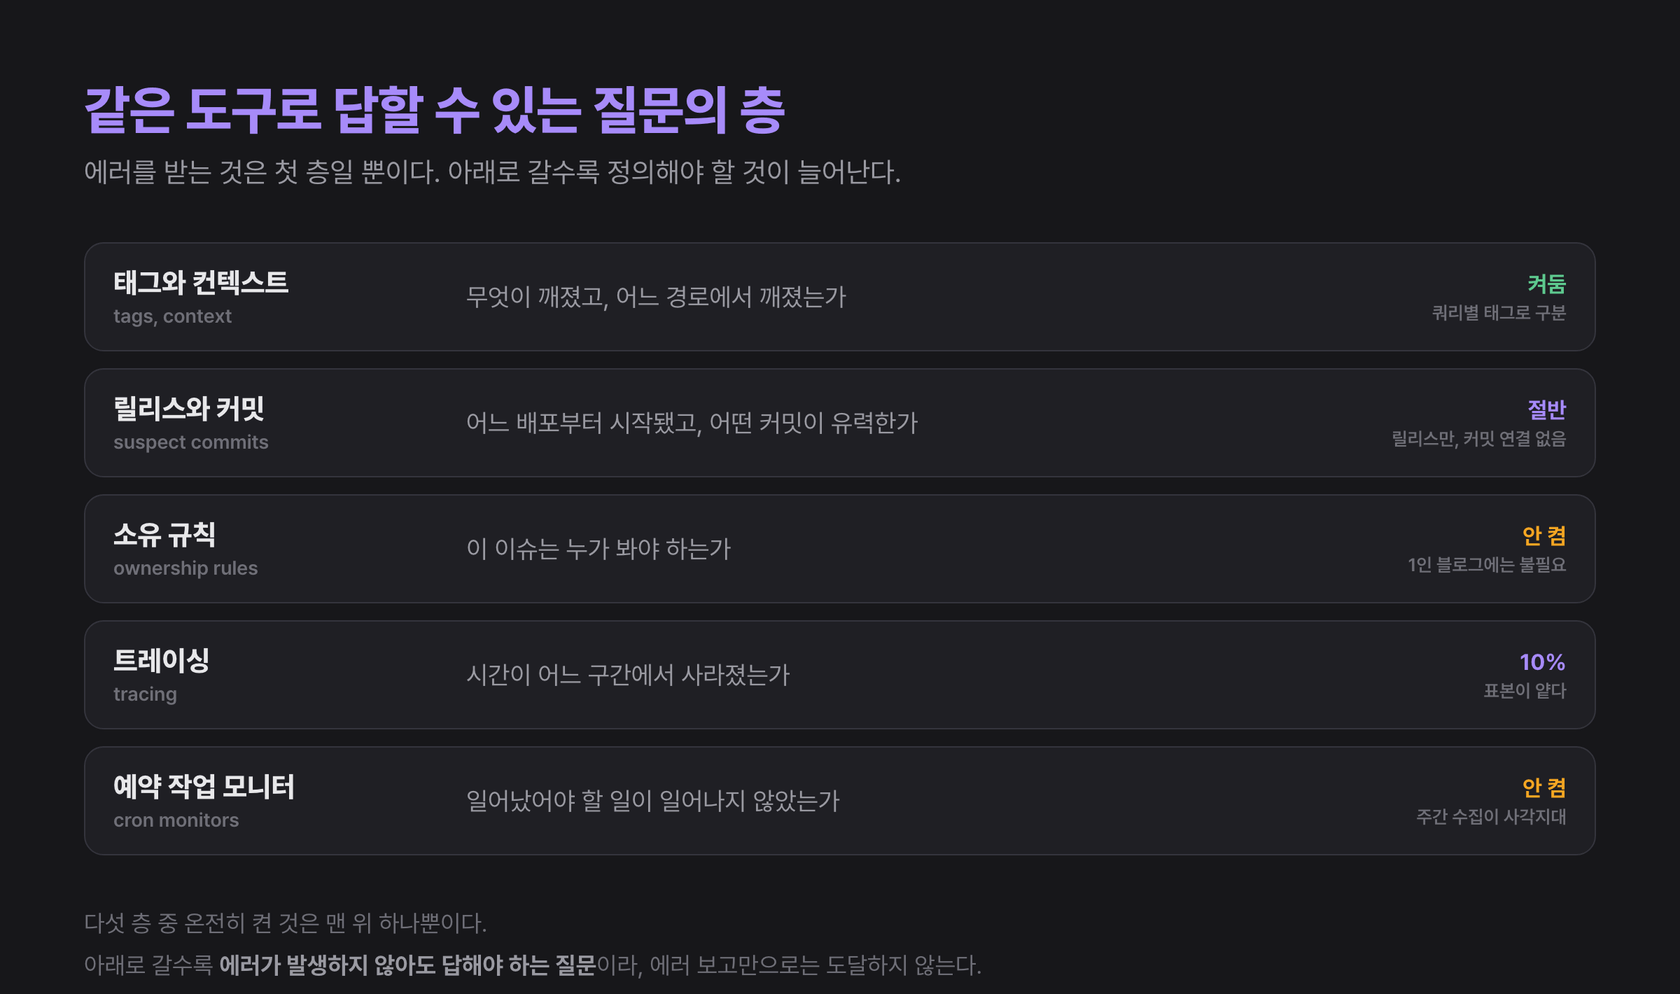
五层之中这个博客完整打开的只有一个标签,我不认为这是一份丢人的成绩单。因为打开哪一层不是靠翻功能列表决定的,只有先定好把什么视作失败,才能知道需要哪一层。只是这次调查里,trace 样本太浅和每周采集的盲区这两层空白变成了实际成本回到我身上,所以下一步要打开哪几层,已经定了。
OpenTelemetry 的 trace context 和 semantic convention 把这条移动路径扩展到特定产品之外。只是 JavaScript 的 browser instrumentation 仍是 experimental,profile 信号是 Alpha。被纳入标准这个事实,和在每个 runtime 上都能稳定使用这个事实,必须区分开。
AI 能很快找到搜索和连接这些信号的候选。但观测的深度不取决于产品的功能数量,而取决于能否在信号之间移动,是否表达出了偏离正常路径的状态。我的 200 响应在信号种下之前一次也没有说过失败,种下之后才显露出那曾经就是失败。
下一篇从观测到判断里,我想看看如何把这些系统信息与 GA4、Search Console 的用户数据放在一起解读。因为只是细看系统,无法决定该先修什么。在那之前,也希望读这篇文章的读者想起一个自己以 resolved 关掉的 issue。那个 issue 是因为修好了才停下的,还是只是再没有人重新测过?