관측에서 판단으로
이번 포스팅에서는 관측 데이터를 판단으로 바꾸는 방법에 대한 이야기를 해보려고 한다.
필자는 이 블로그에서 GA4와 Search Console을 몇 년째 직접 운영해왔다. 방문자가 어떤 검색어로 들어오는지 보고, 거기에 맞춰 글의 제목과 설명을 고치는 일을 반복해온 것이다. 그런데 데이터를 오래 봐온 것과 그 데이터로 좋은 판단을 내리는 것은 다른 문제였다. 이 글의 뒤에서 다루겠지만, 필자는 같은 글의 같은 지표를 두고 두 달 사이에 정반대의 결론을 내릴 뻔했다.
앞선 브라우저 관측에서는 브라우저가 만드는 성능 정보를, 시스템 관측에서는 시스템이 남기는 에러, 로그, trace를 살펴봤다. 이 정보가 충분히 쌓이면 서비스가 어떻게 동작하는지는 이전보다 훨씬 잘 보인다. 그런데 무엇을 먼저 고칠 것인지, 그 문제가 사용자에게 실제로 중요한지, 수정 이후 경험이 나아졌는지는 여전히 다른 질문이다.
이 글의 핵심은 데이터를 사용자 단위로 억지로 합치는 것이 아니라, 같은 제품 가설을 서로 다른 관측 단위로 확인하는 데 있다. 그리고 데이터 소스가 많아진다고 판단이 자동으로 좋아지지는 않는다. 서로 다른 표본과 집계 규칙을 가진 숫자를 한 그래프에 올리는 순간, 관계가 없는 변화도 그럴듯한 이야기로 묶일 수 있다. 관측의 마지막 단계에서 필요한 것은 더 많은 대시보드가 아니라 각 데이터가 무엇을 보았고 무엇을 보지 못했는지 구분하는 능력이다.
이 블로그가 관측하는 세 층
추상적인 이야기로 시작하는 대신 필자의 사례부터 펼쳐놓는 편이 낫겠다. 이 블로그는 결과적으로 세 층으로 관측하고 있다.
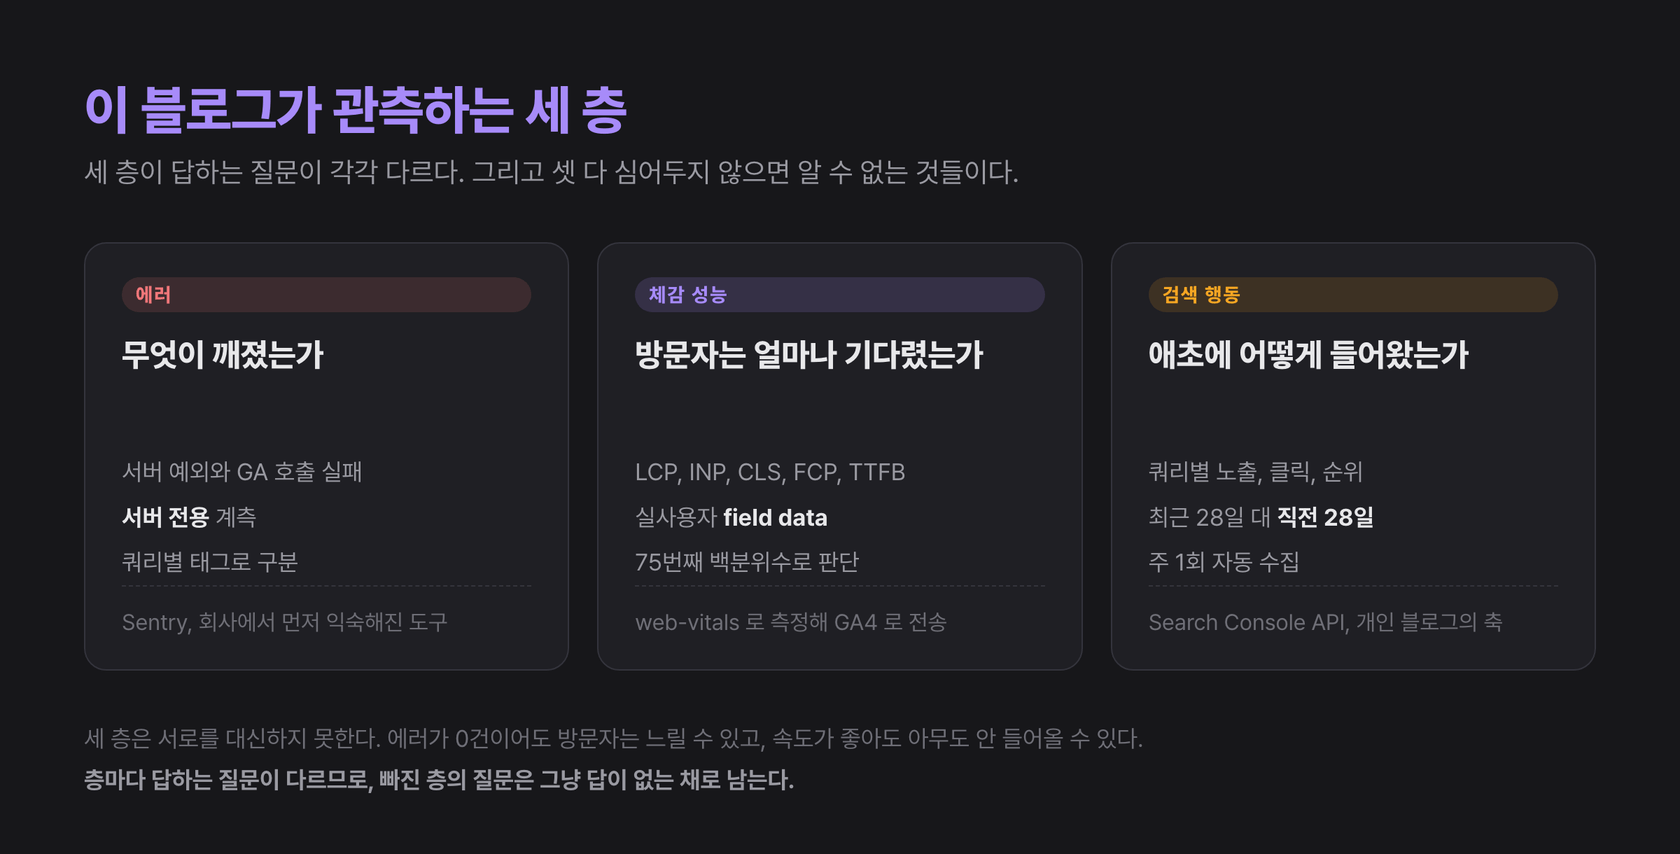
첫 층은 Sentry다. 서버 전용 계측으로 예외와 조용히 실패하는 GA 호출을 잡는다. 둘째 층은 실사용자의 체감 성능이다. 브라우저에서 잰 Web Vitals를 GA4로 보내 쌓는다. 셋째 층은 검색 행동이다. Search Console 데이터를 매주 자동 수집해 최근 28일과 직전 28일을 비교한다. 층마다 답하는 질문이 다르다. 무엇이 깨졌는가, 방문자가 얼마나 기다렸는가, 애초에 어떤 검색어로 들어왔는가.
세 층은 서로를 대신하지 못한다. 에러가 0건이어도 방문자는 느릴 수 있고, 속도가 좋아도 아무도 들어오지 않을 수 있다. 첫 두 층은 앞의 두 글에서 다뤘으니, 이 글의 무게는 셋째 층과, 세 층을 함께 읽는 방법에 있다.
솔직하게 적어두면 이 블로그의 GA4는 행동 분석 도구로 깊게 쓰이고 있지 않다. 페이지뷰와 web_vitals 이벤트의 저장소에 가깝다. 그래서 이 글의 GA4 부분은 필자가 운영하며 확인한 제약과, 공식 문서로 검증한 설계 기준을 함께 쓴다. 어디까지가 경험이고 어디부터가 조사인지는 절마다 구분하겠다.
서로 다른 관측 단위
브라우저 RUM, Sentry, GA4, Search Console을 모두 사용자 데이터라고 부르기 쉽지만 실제 관측 단위는 다르다.
| 층 | 대표 데이터 | 관측 단위 | 주로 답하는 질문 |
|---|---|---|---|
| 브라우저 경험 | LCP, INP, CLS, resource timing | 페이지 방문과 상호작용 | 사용자가 무엇을 얼마나 기다렸는가 |
| 시스템 상태 | error, span, trace, log, profile | 이벤트와 요청 | 어디에서 무엇이 실패하거나 느려졌는가 |
| 제품 행동 | GA4 event, session, key event | 행동과 세션 | 사용자가 서비스 안에서 무엇을 했는가 |
| 검색 의도 | query, impression, click, position | 검색 노출 | 사용자가 어떤 문제를 가지고 들어왔는가 |
같은 사람의 여정처럼 보여도 모든 층에서 동일한 사용자를 관측하는 것은 아니다. 광고 차단기는 GA와 Sentry 요청을 막을 수 있고, 개인정보 동의 상태에 따라 analytics 표본이 달라진다. Search Console은 개별 사용자가 아니라 검색 결과의 집계 데이터를 제공한다. CrUX는 일정 조건을 만족하는 Chrome 사용자의 field data다.
따라서 네 층의 숫자가 정확히 맞지 않는 것은 정상이다. 문제는 차이를 없애는 것이 아니라 어떤 표본의 어떤 질문에 답하는 숫자인지 기록하는 것이다.
GA4 이벤트 모델
GA4 event는 사용자의 상호작용을 이름과 parameter로 모델링한다. Google의 이벤트 설정 문서는 SDK가 자동으로 모으는 event, 설정으로 켜는 enhanced measurement, 정해진 이름과 parameter를 권하는 recommended event, 서비스가 직접 정의하는 custom event를 구분한다. 같은 'event'라도 누가 의미와 스키마를 소유하는지가 다르다.
처음에는 클릭과 화면 전환을 최대한 많이 보내고 싶어진다. 하지만 이벤트가 많다고 사용자 이해가 깊어지는 것은 아니다. button_click, button_click_2, main_button_clicked처럼 구현 위치를 이름으로 만들면 코드가 바뀔 때 분석 의미도 무너진다.
좋은 이벤트는 DOM 사건보다 사용자의 의도를 표현한다.
gtag('event', 'article_reference_open', {
  article_slug: '260916',
  reference_type: 'specification',
  link_position: 'body',
})
이 이벤트는 어떤 버튼 컴포넌트를 눌렀는지가 아니라 사용자가 글의 참고 자료를 열었다는 사실을 남긴다. UI를 바꿔도 분석 질문은 유지된다.
이벤트 설계 전에 다음을 먼저 적어보는 편이 좋다.
- 어떤 사용자 행동을 이해하려는가
- 그 행동이 일어났다고 판정할 사건은 무엇인가
- 분석에 필요한 최소 parameter는 무엇인가
- 이 숫자가 바뀌면 어떤 결정을 내릴 것인가
- 중복과 누락을 어떻게 검증할 것인가
마지막 두 질문에 답이 없다면 이벤트는 대시보드 장식이 되기 쉽다. (이 블로그의 GA4가 저장소에 머물러 있는 이유도 여기에 있다. 4번에 답할 수 있는 이벤트가 아직 web_vitals 하나뿐이다)
수집과 반영의 차이
GA4 Measurement Protocol을 사용하면 브라우저 밖의 서버나 offline system에서도 event를 보낼 수 있다. 하지만 Google의 Measurement Protocol reference는 중요한 제한을 명시한다. 수집 endpoint는 HTTP 요청을 받으면 2xx를 반환하며, payload가 잘못됐거나 데이터가 처리되지 않아도 오류 상태를 반환하지 않는다.
HTTP 2xx는 요청이 수신됐다는 뜻이지 event가 원하는 보고서에 정확히 들어갔다는 증거가 아니다. 시스템 관측 글에서 다룬 성공 응답 속 실패가 analytics 수집에도 존재하는 셈이다. 이 블로그에서 200 응답 뒤에 빈 통계가 숨어 있었던 것처럼, analytics도 전송 성공이 곧 반영 성공은 아니다.
그래서 배포 전에는 validation endpoint나 Event Builder로 payload를 확인하고, 배포 후 event pipeline은 적어도 세 단계로 검증해야 한다.
- 전송: client 또는 server가 요청을 보냈는가
- 수집: Realtime과 DebugView에서 event와 parameter가 보이는가
- 분석: 최종 보고서와 export schema에서 의도한 차원으로 조회되는가
데이터를 보낸 코드에 테스트가 있어도 수집 설정과 custom dimension 등록이 빠지면 분석 단계에서 값을 쓸 수 없다. analytics도 배포 이후 검증이 필요한 운영 시스템이다.
원시 이벤트가 여는 질문
GA4 기본 보고서는 raw event를 직접 다루지 않아도 자주 묻는 질문을 빠르게 보는 데 좋다. 하지만 event와 parameter를 자유롭게 결합하거나 다른 데이터와 조인하려면 한계가 생긴다.
BigQuery Export는 GA4의 raw event를 일별 또는 streaming 방식으로 내보낼 수 있게 한다. Standard property의 daily export에는 하루 100만 event 제한이 있다. Streaming export는 빠르지만 best-effort이고 신규 사용자 attribution을 포함하지 않으며, 기존 사용자 attribution도 완전히 처리되는 데 시간이 걸릴 수 있다. 당일 분석은 events_intraday_*, 안정된 일별 분석은 완성된 events_* table을 사용해야 하는 이유다.
raw event에 접근하면 다음과 같은 질문이 가능해진다.
- 느린 LCP를 겪은 세션에서 다음 페이지 이동 비율이 달라졌는가
- 특정 release 이후 오류가 난 세션의 핵심 행동 완료율이 변했는가
- 검색 query 유형에 따라 landing page 안에서 읽는 깊이가 달라지는가
- mobile과 desktop에서 같은 기능의 interaction pattern이 다른가
그러나 raw data는 해석의 자유와 함께 중복, late arrival, sessionization, timezone을 직접 다룰 책임도 준다. SQL을 쓸 수 있다는 사실이 올바른 사용자 모델을 보장하지는 않는다.
검색이 보여주는 의도
GA4는 사용자가 사이트에 들어온 뒤의 행동을 본다. Search Console은 그 전에 어떤 query와 search result를 통해 노출되고 클릭됐는지 보여준다.
Search Analytics API는 query, page, country, device, search appearance 같은 dimension으로 click, impression, CTR, position을 집계할 수 있다. 하지만 공식 API 문서는 모든 row를 보장하지 않고 내부 한계에 따라 상위 row를 반환한다고 설명한다. 작은 query의 합이 전체 합계와 정확히 맞지 않을 수 있다.
이 제약은 문서 속 경고가 아니라 필자의 CSV에서 매주 보이는 현상이다. 9월 11일에 수집한 최근 28일 데이터에서 page 차원의 클릭 합계는 47회인데, query 차원의 클릭 합계는 8회다. 같은 기간의 같은 사이트인데 클릭의 대부분이 query 차원에서는 보이지 않는다. 드물거나 익명화된 query가 row로 반환되지 않기 때문이다. query 데이터로 전체 유입을 설명하려 들면 이 빈 자리를 상상으로 채우게 된다.
평균 position도 단순한 순위표가 아니다. 여러 query, device, 국가, search appearance에서 발생한 노출을 집계한 값이다. query 구성이 바뀌면 개별 키워드의 순위가 그대로여도 평균이 움직일 수 있다.
순위가 내려갔는데 클릭이 늘었다
평균 position의 이런 성질을 필자는 이 블로그의 실제 데이터에서 만났다. Biome이 ESLint와 Prettier를 대체할 수 있을까?는 2024년 12월에 쓴 글인데, 노출에 비해 클릭이 이상할 만큼 적은 상태가 오래 이어졌다. 그래서 지난 6월에 이 글의 seoTitle을 실제 검색 쿼리 형태에 가깝게 다시 썼다. "Biome vs ESLint vs Prettier"로 시작하는 비교형 제목이다.
8월 초에 수집한 28일 비교에서 이 글의 수치는 이렇게 움직였다. 노출은 230회에서 204회로 11% 줄었고 평균 position은 8.9위에서 11.6위로 밀렸다. 두 지표만 보면 나빠진 글이다. 그런데 클릭은 2회에서 13회로 늘었고 CTR은 0.87%에서 6.37%가 됐다.
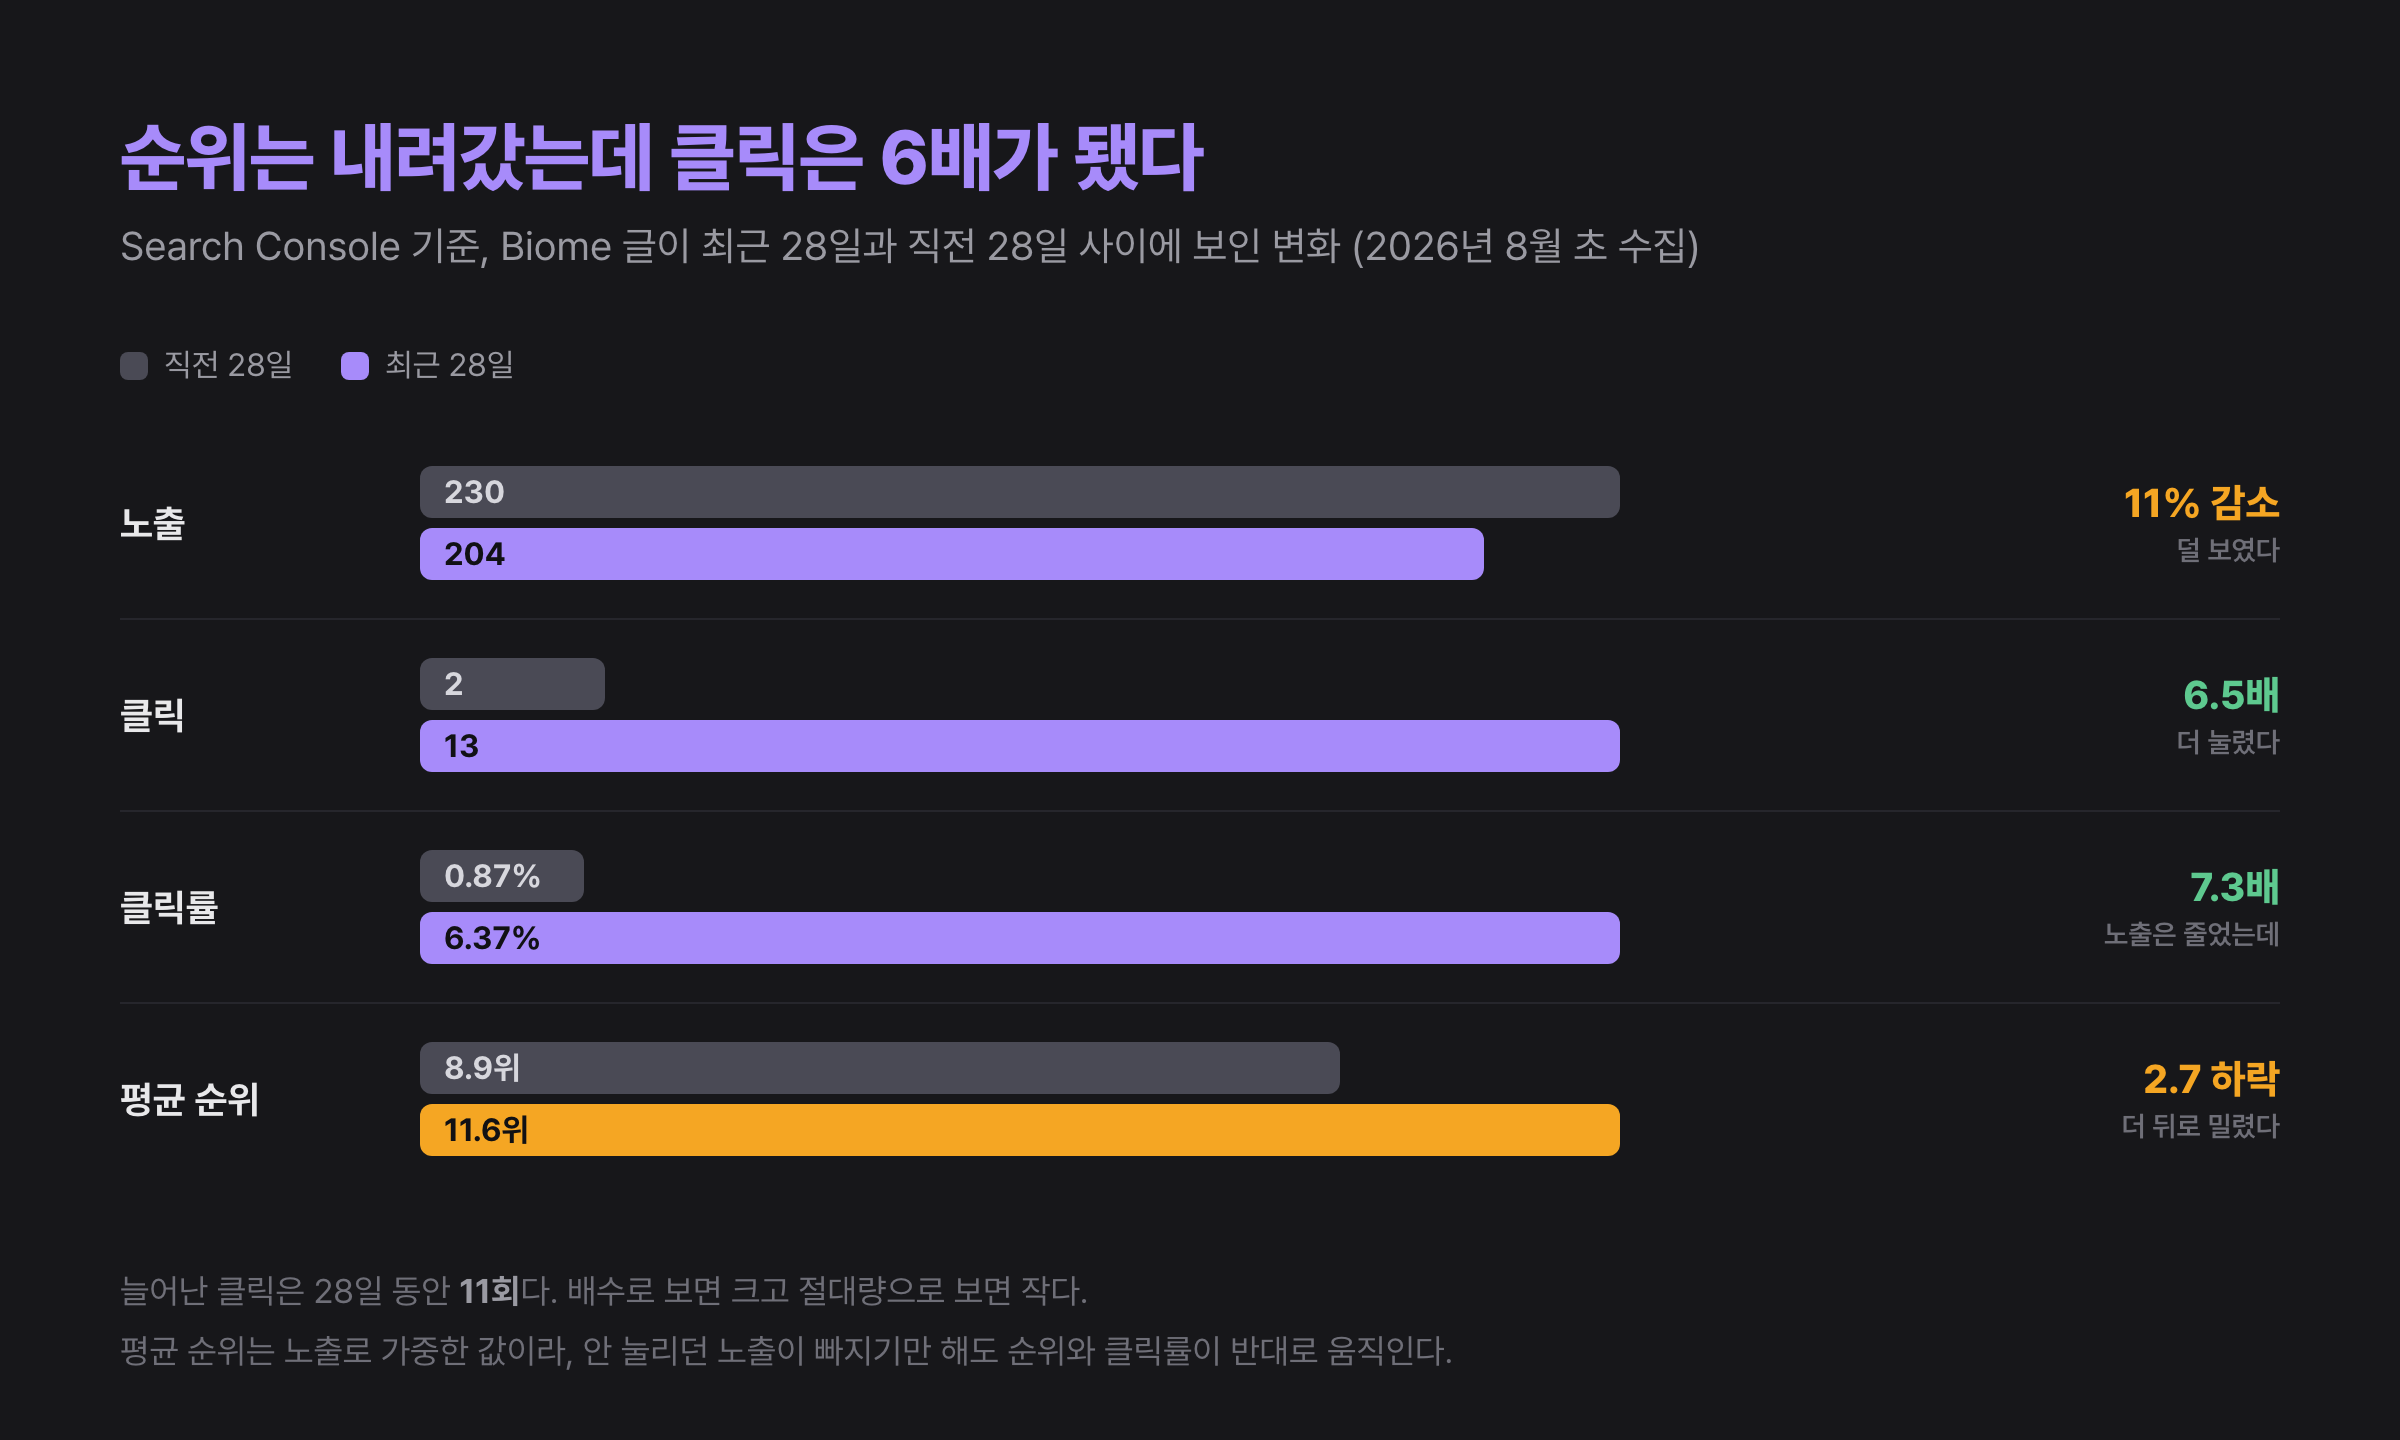
먼저 김을 빼두는 것이 정직하겠다. 이 수치는 제목 수정의 효과를 입증하지 않는다. 평균 position은 노출로 가중한 평균이라, 위쪽에 뜨지만 아무도 누르지 않던 노출이 빠지기만 해도 순위는 나빠지고 CTR은 기계적으로 올라간다. 기간별 query mix와 계절성도 달라질 수 있고, 늘어난 클릭의 절대량은 28일 동안 11회다. 배수로 보면 크고 절대량으로 보면 작다.
그걸 감안해도 남는 것이 있다. 순위를 성과로 보면 손봐야 할 글이고, 실제 유입을 성과로 보면 나아진 글이다. 무엇을 결과 지표로 선택하느냐가 같은 데이터의 결론을 바꾼다. 필자가 순위 하락만 보고 있었다면 잘 되기 시작한 글을 다시 뜯어고쳤을 것이다.
9월에 다시 조회한 숫자
이 시리즈를 정리하면서 같은 글의 지금 상태를 다시 조회했다. 과거의 작업을 글로 쓸 때는 그 상태가 지금도 유지되는지 확인하는 것이 필자의 규칙인데, 이번에도 확인해보길 잘했다.
9월 11일에 수집한 최근 28일에서 이 글은 노출 185회, 클릭 6회, CTR 3.24%, 평균 position 20.8위다. 클릭은 정점이던 13회에서 절반 아래로 내려왔고, 평균 position은 수집 시점 순서로 8.9 → 11.6 → 14.5 → 20.8로 여름 내내 밀렸다. 그러니까 "순위는 내려갔지만 클릭이 늘었다"는 반전 서사는 8월 초의 비교 구간에서 가장 선명했고, 다음 구간이 그 서사를 다시 흔들었다.
이 재조회가 앞 절의 결론을 뒤집는 것은 아니다. 지금도 클릭은 수정 전의 2회보다 많고, CTR도 0.87%보다 높다. 이 블로그에서 클릭이 잡힌 검색 query 여섯 개 중 다섯 개가 "eslint vs biome" 같은 이 글의 비교형 query이기도 하다. 다만 교훈이 하나 늘었다. 지표의 선택만이 아니라 비교 기간의 선택도 결론을 바꾼다. 28일 비교 하나로 서사를 완성하면 다음 28일이 그 서사를 부순다. 그리고 평균 position이 왜 계속 밀리는지는 아직 모른다. 노출되는 query 구성이 바뀌었을 수도, 경쟁 문서가 늘었을 수도 있다. 확인하기 전까지는 미해결로 둔다.
가설로 시작하는 연결
데이터를 연결한다고 하면 먼저 user id와 session id를 통일하려는 생각이 든다. 물론 trace id, release, route, timestamp 같은 공통 차원이 있으면 분석이 쉬워진다. 하지만 모든 데이터를 개인 단위로 조인하는 것이 목표가 되어서는 안 된다.
Search Console query는 개인과 연결할 수 없고 연결해서도 안 된다. 동의하지 않은 사용자의 GA event는 없을 수 있다. Sentry event에는 사용자를 식별할 필요가 없는 오류도 많다.
그래서 먼저 가설의 관측 단위를 정하는 편이 낫다.
| 가설 | 적절한 관측 단위 |
|---|---|
| 새 release 이후 결제 오류가 늘었다 | release별 error rate와 key event completion |
| mobile 사용자가 글을 늦게 읽기 시작한다 | device별 LCP 분포와 engagement event |
| 특정 검색 의도에 landing page가 맞지 않는다 | query cluster별 impression·CTR과 page별 행동 |
| fallback이 사용자에게 보이지 않게 반복된다 | fallback reason별 event와 영향을 받은 session 비율 |
가설이 먼저면 개인 식별자 없이도 집계 수준에서 충분히 답할 수 있는 경우가 많다. 앞의 Biome 글 사례도 그렇다. 필자에게 필요했던 것은 그 글을 누른 사용자 개개인이 아니라 query 구성과 클릭의 28일 단위 비교였다. 관측의 정밀함과 사용자 추적의 정밀함은 같은 말이 아니다.
상관관계의 한계
관측 데이터를 연결할 때 가장 흔한 실수는 같은 시기에 움직인 두 값을 인과관계로 읽는 것이다.
LCP가 나빠진 주에 전환율이 떨어졌다고 해보자. 성능이 원인일 수 있지만 campaign 유입, 가격 변경, 재고, 계절성, device mix 변화도 가능하다. 전체 평균끼리 비교하면 mobile 유입이 늘어난 것만으로 두 값이 함께 움직일 수도 있다. 필자가 seoTitle 수정과 클릭 증가를 곧바로 인과로 묶지 않은 것도 같은 이유다. 두 사건이 시간 순서로 이어졌다는 사실만으로는 부족하다.
다음 순서로 질문을 좁히면 성급한 결론을 줄일 수 있다.
- 같은 시간대에 변했는가
- 같은 사용자 환경과 route에서도 관계가 남는가
- 특정 release 또는 변경 시점과 맞물리는가
- 오류와 성능의 선후 관계를 event 수준에서 확인할 수 있는가
- 수정 또는 실험 이후 예상한 방향으로 되돌아오는가
관측 데이터는 원인 후보를 줄이는 데 강하다. 인과관계를 확정하려면 통제된 실험이나 자연 실험, 재현 가능한 변경이 추가로 필요하다.
분포와 비율
시스템과 사용자 경험은 평균으로 압축할수록 중요한 집단이 사라진다.
평균 LCP가 2초여도 일부 mobile 사용자가 8초를 겪을 수 있다. 전체 error rate가 낮아도 신규 release를 받은 특정 browser에서만 집중될 수 있다. CTR이 높아져도 impression이 급격히 줄었다면 도달한 사용자의 구성 자체가 달라졌을 수 있다. Biome 글의 CTR 6.37%가 정확히 이 경우였다.
그래서 다음과 같은 조합이 필요하다.
- 성능: median뿐 아니라 p75와 p95
- 오류: event count뿐 아니라 affected user와 session 비율
- 행동: event 수뿐 아니라 eligible user 대비 완료율
- 검색: CTR뿐 아니라 impression, click, query mix
- 배포: 전체 기간뿐 아니라 release 전후와 점진 배포 구간
비율의 분모도 함께 저장해야 한다. checkout error 100건만 보면 큰 문제처럼 보이지만 시도 100건 중 100건인지, 100만 건 중 100건인지에 따라 판단이 달라진다.
동의와 데이터 품질
사용자 관측을 깊게 다룰수록 개인정보와 동의 문제를 나중에 붙이는 법적 체크리스트로 취급하기 어렵다. 무엇을 수집할 수 있는지가 곧 어떤 분석이 가능한지를 결정하기 때문이다.
Google의 Consent Mode 공식 문서는 사용자의 동의 상태에 따라 tag와 SDK의 저장 및 전송 동작을 조정하는 방식을 설명한다. Basic mode는 동의 전 tag를 차단한다. Advanced mode는 기본 동의 상태에서 tag를 불러오고, 동의가 거부된 동안 cookie 없는 측정 신호를 보내 더 구체적인 modeling에 활용할 수 있다.
여기서 중요한 것은 modeled data와 observed data를 같은 것으로 보지 않는 일이다. 설정과 자격 조건에 따라 보고서에 behavioral 또는 key event modeling이 적용될 수 있으므로, 화면의 숫자가 언제나 직접 관측한 event의 단순 합계라고 가정해서는 안 된다.
관측 설계에는 다음 질문이 포함되어야 한다.
- 이 데이터가 의사결정에 정말 필요한가
- 개인 식별 없이 집계 수준으로 답할 수 있는가
- 사용자가 거부했을 때 무엇이 수집되지 않는가
- 삭제와 보존 기간을 운영할 수 있는가
- SDK 기본값이 우리 서비스의 정책과 일치하는가
데이터를 덜 모으면 분석 기회가 줄 수 있다. 동시에 불필요한 노이즈와 위험도 줄어든다. 좋은 관측은 최대 수집이 아니라 목적에 맞는 최소 수집에 가깝다.
실패와 성공의 정의
무엇을 최소한으로 수집할지는 결국 서비스가 성공과 실패를 어떻게 정의하는지에 달려 있다. 도구는 error count, latency, session, conversion, CTR을 계산해주지만, 어느 값이 서비스의 실패이고 어느 값이 성공인지 결정하지는 않는다.
HTTP 200을 반환했어도 핵심 데이터가 비어 있으면 실패일 수 있다. 반대로 외부 API가 실패했어도 빠르게 fallback을 보여주고 사용자가 목적을 달성했다면 서비스는 성공했을 수 있다. 검색 position이 떨어져도 원하는 사용자의 클릭이 늘었다면 제품 결과는 나아졌을 수 있다.
이 판단을 위해서는 기술 지표와 사용자 결과 사이에 명시적인 문장이 필요하다. 이 블로그에서 필자가 실제로 정한 문장은 이렇다.
- 사용자는 검색 결과에서 기대한 글을 찾을 수 있어야 한다.
- 글의 주요 콘텐츠는 mobile p75에서 정한 시간 안에 보여야 한다.
- 부가 통계가 실패해도 본문 읽기는 지연되지 않아야 한다.
- 예약된 수집 작업이 실행되지 않으면 운영 실패로 본다.
이 문장이 생기면 필요한 metric과 alert, event가 따라온다. 반대로 도구의 기본 dashboard부터 켜면 측정 가능한 것을 중요한 것으로 착각하기 쉽다.
관측 결과를 판단으로 바꾸는 엔지니어의 역할은 데이터를 가장 많이 아는 사람이 되는 것이 아니다. 사용자의 기대를 시스템이 검증할 수 있는 조건으로 번역하는 사람이 되는 것이다.
알림은 무엇에 걸어야 할까
실패의 정의가 문장으로 생기면 다음 질문이 바로 따라온다. 어디에 알림을 걸 것인가.
Google SRE 초기에 Rob Ewaschuk이 쓴 알림 철학 문서는 사람을 호출하는 알림이 긴급하고 중요하며 조치 가능하고 실재해야 한다고 못 박는다. 그리고 원인이 아니라 증상에 알림을 걸라고 권한다. 500 응답이나 사용자에게 보이는 오류처럼 겉으로 드러나는 신호에 걸라는 것이다.
그런데 이 원칙과 필자가 겪은 일 사이에는 미묘한 긴장이 있다. 시스템 관측 글에서 다뤘듯 이 블로그의 실패는 500이 아니라 200 응답과 빈 통계였다. 증상 기반 알림은 실패가 겉으로 드러난다는 전제 위에 서 있는데, 성공으로 분류된 실패가 바로 그 전제를 깬다.
그래서 필자는 이 원칙을 반박해야 한다고 생각하지 않는다. 오히려 무엇을 증상으로 정의할 것인가가 이 일의 진짜 어려운 부분이라는 결론에 도달했다. 이 블로그에서 증상은 상태 코드가 아니라 "통계 조회 함수가 기본값을 반환했다"였고, 그건 손으로 계측을 심어야만 증상이 될 수 있었다. 앞 절에서 실패와 성공을 문장으로 먼저 정하자고 한 이유가 여기에 있다. 그 문장이 있어야 알림을 걸 증상이 정해진다.
같은 문서가 덧붙이는 조언도 새겨둘 만하다. 시끄러운 알림은 지우는 쪽으로 기울라는 것이다. 과잉 모니터링이 과소 모니터링보다 풀기 어려운 문제이기 때문이다. 참고로 Google SRE 책은 사후 회고를 작성해야 하는 트리거 목록에 모니터링 실패 자체를 포함해 두었다. 관측 데이터를 모으는 장치가 조용히 멈추는 것도 실패다. 이 블로그라면 매주 도는 Search Console 수집이 어느 주에 돌지 않는 것이 그 목록에 들어간다.
데이터 사이의 번역
알림까지 걸고 나면 남는 일은 사용자의 기대를 브라우저 RUM, Sentry, GA4, Search Console의 서로 다른 query language와 schema로 옮기는 것이다. 이 지점에서 AI가 맡을 수 있는 역할은 결론 생성보다, 하나의 질문을 각 데이터 소스에서 검증 가능한 형태로 번역하는 일이다.
예를 들어 다음과 같은 흐름이 가능하다.
- 자연어 질문을 각 시스템의 API query와 SQL로 변환한다.
- 서로 다른 시간대와 dimension을 맞추는 변환을 만든다.
- 분포가 달라지는 segment와 예상 밖의 반례를 찾는다.
- 관련 release, code path, 공식 문서를 함께 모은다.
- 다음에 확인할 가설과 추가 계측 후보를 제안한다.
OpenTelemetry의 semantic convention이 중요한 이유도 여기에 있다. 같은 의미의 속성을 서비스마다 다른 이름으로 보내면 AI도 먼저 schema를 추측해야 한다. 공통 이름과 단위, stability를 지키면 도구와 사람이 신호를 연결하기 쉬워진다.
AI가 분석을 도와도 검증 절차는 줄어들지 않는다.
- 생성한 SQL이 중복 event와 timezone을 올바르게 처리하는지 확인한다.
- API가 전체 row를 반환하는지, top row만 반환하는지 확인한다.
- 평균과 백분위수, 사용자 수와 이벤트 수를 혼동하지 않았는지 확인한다.
- modeled data와 직접 관측된 데이터를 구분한다.
- 작은 표본의 우연한 변화에 과도한 설명을 붙이지 않는다.
즉 AI의 장점은 질문을 실행 가능한 query로 바꾸고 비교 축을 넓히는 데 있다. 결과가 어떤 표본과 집계 규칙에서 나왔는지 확인하는 책임은 그대로 남는다.
제품 역량으로서의 피드백 루프
질문을 query로 바꾸는 비용이 낮아지면 관측과 다음 변경 사이의 시간도 줄일 수 있다. 이때 중요한 것은 생성 속도만 높이지 않는 일이다.
Google Cloud가 발표한 2025 DORA 리포트는 전 세계 기술 실무자 약 5천 명의 설문을 바탕으로, AI 도입이 software delivery throughput과 product performance에는 긍정적인 관계를, delivery stability에는 부정적인 관계를 보였다고 정리한다. DORA는 별도 인사이트 글에서 그 메커니즘을 이렇게 설명한다. 생성 단계에서 절약한 시간이 검증 오버헤드로 재배치되고, 리뷰해야 할 코드가 만들어지는 속도 자체가 올라간다는 것이다. 리포트의 요약처럼 AI는 팀을 고쳐주기보다 이미 있는 것을 증폭한다. (2026년 4월에 갱신된 DORA의 ROI of AI-assisted Software Development 리포트도 도입 초기의 생산성 하락을 관리하는 문제를 정면으로 다룬다)
필자가 더 무겁게 받아들이는 근거는 따로 있다. METR이 2025년에 발표한 연구는 숙련된 오픈소스 개발자 16명에게 실제 이슈 246건의 AI 사용 허용 여부를 무작위로 배정했는데, AI가 허용된 이슈에서 완료가 19% 더 오래 걸렸다. 그런데 개발자들은 사전에 24% 빨라질 것이라 예상했고, 실제로 느려진 것을 경험한 뒤에도 20% 빨라졌다고 믿었다. 필자는 이 연구를 AI 프론트엔드 엔지니어에서 생산성 논의로 인용했는데, 이 글의 맥락에서는 다르게 읽힌다. 체감은 측정을 대신하지 못한다는 근거다. 체감을 믿을 수 없다면 재봐야 하고, 앞의 Biome 글 사례처럼 한 번 잰 값도 기간을 바꿔 다시 재봐야 한다.
생성 속도가 빨라지면 변경량이 늘어난다. 같은 비율로 결함이 발생해도 절대 건수가 늘고, 검토해야 할 코드와 사용자 영향도 빠르게 쌓인다. 이때 관측이 느리면 팀은 배포 속도만 높이고 학습 속도는 높이지 못한다.
빠른 feedback loop는 다음 단계를 짧게 잇는 능력이다.
- 변경을 배포한다.
- 시스템과 사용자에게 일어난 일을 관측한다.
- 예상과 실제의 차이를 찾는다.
- 원인 가설을 좁힌다.
- 다음 변경으로 검증한다.
AI는 3번과 4번의 탐색을 크게 도울 수 있다. 하지만 2번에서 필요한 신호가 없거나 1번의 release 정보와 연결되지 않으면 시작할 수 없다.
그래서 AI를 잘 쓰는 조직의 기반에는 테스트뿐 아니라 관측 가능한 시스템과 사용자 중심의 결과 지표가 필요하다. 생성 능력보다 feedback loop의 품질이 병목이 되는 것이다.
관측을 판단으로 바꾸기
이 시리즈의 세 글을 한 문장씩으로 접으면 이렇다. 브라우저 관측은 사용자가 무엇을 체감했는지 보여주고, 시스템 관측은 그 경험이 시스템 어디에서 만들어졌는지 보여주며, GA4와 Search Console은 사용자가 서비스 안에서 무엇을 했고 어떤 의도로 들어왔는지 보여준다. 이 신호들은 한 사람의 완전한 기록이 아니라 서로 다른 표본에서 같은 가설을 비추는 증거다.
따라서 연결의 기준은 데이터 양이나 개인 식별자의 정밀함이 아니다. 가설에 맞는 관측 단위를 선택하고, 분모와 누락을 기록하며, 상관관계를 수정이나 실험으로 다시 검증해야 한다. 개인정보와 동의로 보이지 않는 사용자도 분석의 한계에 포함해야 한다. 그리고 한 번의 비교로 얻은 결론은 기간을 바꿔 다시 확인해야 한다. 필자의 Biome 글 수치가 두 달 사이에 두 번 다른 이야기를 들려준 것처럼, 관측은 한 번의 조회가 아니라 계속 재보는 일이다.
관측의 대상 자체도 넓어지고 있다. OpenTelemetry는 생성형 AI와 MCP 호출을 위한 semantic convention을 별도 저장소에서 정리하는 중이다. 우리가 AI에게 더 많은 실행을 맡길수록 그 실행도 같은 원칙 아래의 관측 대상이 된다.
AI는 이 검증을 시작하는 비용을 낮추지만 성공과 실패의 기준을 정하지는 않는다. 어떤 경험을 지킬지 먼저 문장으로 정하고, 필요한 신호를 수집하고, 결과를 다음 변경으로 확인하는 일은 엔지니어의 몫이다. 이 순환이 짧고 정확할 때 관측은 대시보드가 아니라 제품 역량이 된다. 이 글을 읽는 독자 분들도 각자의 서비스에서 지표 하나를 골라, 무엇을 성과로 볼지 문장으로 적어보고, 한 번 내린 결론을 기간을 바꿔 다시 조회해보면 좋겠다. 필자의 경험상 두 번째 조회가 첫 번째보다 많은 것을 가르쳐준다.