시스템 관측
이번 포스팅에서는 시스템 관측에 대한 이야기를 해보려고 한다.
필자는 회사에서 Sentry 기반 에러 모니터링을 오래 다뤄왔다. 이슈가 올라오면 stack trace를 열고, release와 태그로 범위를 좁히고, 재현 조건을 찾는 일은 익숙한 작업이다. 그런데 정작 이 블로그에는 에러 모니터링이 없었고, 지난 8월에야 서버 전용 구성으로 Sentry를 붙였다. 그리고 붙이자마자 그 계측이 실제 장애 하나를 잡았다. 이 글의 후반부는 그 장애를 조사하고, 고쳤다고 믿고, 다시 재보면서 그 믿음이 틀렸다는 것을 확인한 기록이다.
브라우저 관측에서는 브라우저가 네트워크, 렌더링, 사용자 입력을 어떤 데이터로 남기는지 살펴봤다. 그런데 브라우저에서 느린 요청 하나를 발견해도 문제는 끝나지 않는다. 그 요청이 CDN에서 느렸는지, API 서버에서 기다렸는지, 데이터베이스 호출에서 막혔는지, 실패를 잡고 기본값을 반환했는지까지 따라가야 한다.
이 글은 한 에러 이벤트에서 시작해 각 신호가 앞선 신호로는 답하지 못한 질문을 어떻게 보완하는지 따라간다. breadcrumb로 직전의 시간을 복원하고, trace와 metric으로 경로와 영향 범위를 찾고, profile과 Replay로 실행 비용과 화면 맥락을 확인한다. 마지막에는 발생하지 않은 사건과 성공 응답 속 실패까지 포함해 무엇을 실패로 계측할 것인가로 질문을 넓힌다. 필자가 겪은 장애가 정확히 그 두 범주에 걸쳐 있었다.
프론트엔드 엔지니어에게 이 경계는 점점 흐려지고 있다. React 컴포넌트에서 시작된 요청이 Server Component, route handler, 외부 API, queue와 background job으로 이어진다. 화면에 나타난 증상은 브라우저에 있지만 원인은 시스템의 다른 층에 있을 수 있다.
예전에는 이 영역에 들어가려면 각 서버의 로그 형식과 운영 도구를 먼저 알아야 했다. 지금은 Sentry 같은 제품에서 에러와 관련 trace, profile, replay 사이를 오갈 수 있고, OpenTelemetry는 서로 다른 도구가 신호를 주고받을 공통 규약을 제공한다.
그렇다고 관측이 자동으로 완성되는 것은 아니다. 어떤 신호를 남길지, 어떤 식별자로 연결할지, 무엇을 실패라고 부를지는 시스템을 만든 사람이 정해야 한다.
에러 한 건의 맥락
가장 익숙한 출발점은 에러 이벤트다. 예외가 발생했을 때 메시지와 stack trace를 전송하면 어느 코드에서 실패했는지 알 수 있다. 하지만 실제로 디버깅에 필요한 것은 예외 객체 하나보다 그 주변의 문맥이다.
Sentry의 Issue Details 문서를 보면 한 이벤트에 stack trace뿐 아니라 breadcrumb, tag, context, release, trace, replay, attachment가 함께 붙을 수 있다. 각 요소가 답하는 질문은 다르다.
| 정보 | 답하는 질문 |
|---|---|
| stack trace | 어떤 코드 경로에서 예외가 발생했는가 |
| source map | 배포된 번들 위치를 원본 소스의 파일과 줄로 복원할 수 있는가 |
| breadcrumb | 예외 전까지 어떤 요청과 사용자 행동이 있었는가 |
| tag | 어떤 브라우저, release, route, 기능에서 반복되는가 |
| context | 해당 이벤트를 이해하는 데 필요한 구조화된 값은 무엇인가 |
| release·commit | 어느 배포에서 처음 나타났고 어떤 변경과 가까운가 |
| trace | 같은 요청 흐름의 다른 서비스와 span에서는 무슨 일이 있었는가 |
| replay | 사용자가 화면에서 실제로 어떤 상태를 거쳤는가 |
이 구분에서 중요한 것은 검색 가능성이다. Sentry의 tag는 UI에서 검색과 필터에 쓰도록 설계된 key-value이고, context는 구조화된 값을 이벤트 상세에서 읽기 위한 영역이라 UI 필터 대상이 아니다. 모든 것을 context에 넣으면 이벤트 한 건은 풍부해지지만 "어느 고객 유형에서 늘었는가" 같은 반복 질문에 답하기 어려워진다.
반대로 모든 값을 tag로 보내면 cardinality와 저장 비용이 커진다. 이메일, 전체 URL, 임의의 오류 메시지처럼 값의 종류가 끝없이 늘어나는 속성은 tag가 되기 어렵다. 계측 설계는 정보를 붙이는 일이면서 동시에 어떤 질문을 반복해서 검색할 것인지 정하는 일이다. 뒤에서 다룰 필자의 조사에서도 결정적인 역할을 한 것은 stack trace가 아니라 지나가듯 달아둔 태그 하나였다.
서버 전용으로 붙인 계측
이 블로그의 Sentry는 서버 전용이다. 브라우저 SDK 초기화 파일을 두지 않았다. 브라우저 계측이 늘리는 client 번들 비용을 사지 않기로 했기 때문인데, 도입 목적이 서버에서 조용히 실패하는 호출을 잡는 것이었고 그 부분은 사실상 공짜였다. 그래서 잡히는 것과 안 잡히는 것이 갈린다. 라우트 핸들러와 서버 컴포넌트의 에러, 그리고 서버에서 실행되는 Google Analytics 조회의 실패는 잡힌다. 클라이언트 컴포넌트의 이벤트 핸들러나 하이드레이션 불일치처럼 브라우저에서만 나는 에러는 잡히지 않는다.
이 구성에서 필자가 직접 확인해두고 싶었던 것이 두 가지 있었다.
하나는 자동 훅의 범위다. Next.js의 onRequestError 훅을 배선해두면 핸들링하지 않은 라우트 에러도 captureException을 직접 부르지 않고 잡힌다. Deploy Preview에 일부러 예외를 던지는 임시 라우트를 올려 확인했고, 이벤트에는 auto.function.nextjs.on_request_error라는 mechanism이 찍혀 들어왔다.
다른 하나는 소스맵이다. 적용 전 프로덕션 이벤트의 culprit은 y([root-of-the-server]__468aa3ae._)처럼 난독화된 번들 위치였다. 소스맵을 업로드한 뒤에는 같은 종류의 이벤트가 src/... 경로와 줄번호, 주변 소스 코드까지 해석됐다. 표의 두 번째 행이 답하는 질문이 실제로 갈리는 지점이다.
여기에 곁가지 하나를 적어둔다. 업로드한 뒤에는 빌드 산출물에서 .map 파일을 지워야 했다. Turbopack이 만드는 서버 소스맵이 57MB로 서버 JS(15MB)보다 커서, 그대로 두면 배포 함수 번들에 전부 실리기 때문이다. 마침 업로드 후 소스맵을 삭제해주는 deleteSourcemapsAfterUpload 옵션이 있어 켰는데, 실측해보니 업로드 직후에도 서버 .map이 57MB 그대로 남아 있었다. 그 옵션은 .next/static만 지우고 정작 용량을 차지하는 .next/server는 건드리지 않았다. 결국 삭제 대상 경로를 직접 지정하는 방식으로 바꿨고, 같은 이유로 업로드 로그도 항상 끄지 않고 조건부로 남기게 했다. 로그를 꺼두면 토큰 만료로 업로드가 통째로 실패해도 다음에 읽을 수 없는 stack trace를 볼 때까지 아무도 모른다. 문서를 읽고 옵션을 켠 것과, 그 옵션이 기대한 일을 했는지 확인한 것은 다른 일이다.
그룹과 원인의 차이
Sentry는 비슷한 이벤트를 하나의 issue로 묶는다. 기본 grouping에서는 stack trace가 핵심 신호이고 exception과 message 같은 정보도 사용된다. 필요하면 fingerprint로 묶이는 기준을 바꿀 수 있다.
다만 같은 issue가 반드시 같은 원인을 의미하지는 않는다. fetch()를 감싼 공통 함수 한 곳에서 네트워크 오류를 던진다면 DNS 실패, 인증 만료, upstream의 500 응답이 한 그룹에 섞일 수 있다. 반대로 동일한 원인이 여러 코드 경로에서 다른 예외를 만들면 여러 issue로 나뉜다.
issue는 조사해야 할 사건의 묶음이지 도메인 원인의 분류표가 아니다. grouping을 그대로 장애 건수나 제품 KPI로 사용하면 이 차이를 놓치게 된다.
필요하다면 fingerprint를 조정하거나 domain error code를 tag로 추가할 수 있다. 그러나 grouping 규칙을 너무 일찍 세밀하게 만들면 SDK의 기본 개선을 놓치고 운영 규칙만 늘어난다. 필자는 먼저 실제 이벤트 분포를 보고 기본 grouping이 어떤 질문을 막는지 확인하는 순서가 낫다고 본다.
실패의 시간축
에러는 대개 마지막 장면만 남긴다. breadcrumb는 그 앞에서 일어난 일을 시간 순서로 붙인다. 브라우저의 navigation, click, console message, HTTP request뿐 아니라 애플리케이션이 직접 기록한 상태 변화도 넣을 수 있다.
전통적인 로그와 닮았지만 목적은 조금 다르다. 로그 저장소는 서비스 전체의 이벤트를 검색하는 데 강하고, breadcrumb는 특정 에러 직전의 작은 시간축을 복원하는 데 강하다.
그래서 중요한 상태 변화는 두 곳에 모두 필요할 수 있다. 결제 상태가 pending에서 failed로 바뀌었다면 운영 로그에서는 전체 실패율을 집계하고, 에러 이벤트의 breadcrumb에서는 그 한 사용자의 순서를 본다. 같은 사실을 복사하는 것이 아니라 서로 다른 검색 단위를 만드는 것이다.
OpenTelemetry의 Logs 문서는 활성 trace와 span의 식별자를 기존 로그에 붙여 자동으로 연결하는 방식을 설명한다. 로그의 진짜 효용은 줄 수가 아니라 다른 신호와 이동할 수 있는 연결점에 있다.
지연이 생긴 경로
에러가 "무엇이 깨졌는가"에 답한다면 trace는 "한 요청이 어디를 지나며 시간을 사용했는가"에 답한다.
trace는 여러 span의 묶음이다. 브라우저의 문서 로드, fetch, 서버의 route handler, 외부 API 호출, 데이터베이스 쿼리와 background job이 각각 span이 될 수 있다. 같은 trace_id를 공유하면 하나의 요청 그래프로 복원할 수 있다.
이 연결이 자동으로 생기는 것은 아니다. 요청 경계를 넘을 때 trace context를 전달해야 한다. W3C의 Trace Context 표준은 traceparent와 tracestate 헤더의 형식을 정의한다. 공급자가 달라도 같은 요청을 이어 붙일 수 있게 만드는 최소 공통 언어다.
프론트엔드에서는 여기에도 조건이 있다.
- 모든 외부 도메인에 trace header를 보내면 정보 노출과 CORS 문제가 생길 수 있다.
- 브라우저 SDK가 허용된 API origin에만 context를 전달하도록 범위를 제한해야 한다.
- 서버와 upstream도 같은 header를 보존하거나 변환해야 한다.
- sampling 결정을 서비스마다 제각각 내리면 trace의 중간이 비게 된다.
trace가 끊겼을 때는 데이터가 없다고 끝내기보다 어느 경계에서 context가 사라졌는지 확인해야 한다. 브라우저에서 서버까지의 분산 추적은 SDK 설치보다 context propagation 설계에 달려 있다.
span에 담을 경계
자동 계측은 HTTP 요청, DB 호출, framework lifecycle처럼 라이브러리 경계를 잘 잡는다. OpenTelemetry의 Instrumentation 문서는 zero-code instrumentation이 시작점으로 유용하지만, 애플리케이션 내부의 판단을 보려면 code-based instrumentation이 필요하다고 설명한다.
예를 들어 주문 API 전체가 800ms 걸렸다는 자동 span만으로는 왜 느렸는지 알기 어렵다. 다음과 같은 도메인 span이 필요할 수 있다.
await tracer.startActiveSpan('checkout.calculate-discount', async (span) => {
  span.setAttribute('promotion.type', promotionType)

  try {
    return await calculateDiscount(cart)
  } finally {
    span.end()
  }
})
다만 함수마다 span을 만들면 trace가 코드 실행 기록으로 변한다. 관측의 목표는 모든 호출을 저장하는 것이 아니라 지연과 실패에 대한 가설을 구분하는 것이다.
좋은 span 경계는 대체로 다음 중 하나다.
- 네트워크, DB, queue처럼 실패 주체가 바뀌는 경계
- cache hit와 miss처럼 실행 경로가 갈리는 경계
- 결제 승인, 권한 판정처럼 도메인 결과가 갈리는 경계
- 지연 예산을 별도로 관리해야 하는 작업
한 span을 보고 누가 무엇을 얼마나 했는지 말할 수 없다면 경계나 이름을 다시 봐야 한다.
분포에서 사례로
trace를 전부 저장하면 비용이 빠르게 커진다. 그래서 시스템의 전체 상태는 metric으로 보고, 이상 구간의 구체적인 요청은 trace로 내려가는 방식이 일반적이다.
OpenTelemetry의 Signals 문서는 trace, metric, log, baggage를 서로 다른 telemetry signal로 구분한다. 별도 Profiles 문서에서 profile 신호는 2026년 9월 현재 Alpha로 표시되어 있다. 데이터 모델과 OTLP 전송 경로는 생겼지만 안정화된 신호와 같은 수준으로 가정해서는 안 된다.
각 신호의 강점은 다음과 같다.
| 신호 | 강점 | 약점 |
|---|---|---|
| metric | 전체 추세, 비율, 분포, 알림 | 개별 요청의 문맥이 적다 |
| trace | 요청 하나의 경로와 지연 | 전량 저장 비용이 크다 |
| log | 사건의 상세 기록과 자유로운 검색 | 형식과 cardinality가 쉽게 흐트러진다 |
| profile | CPU와 메모리를 사용한 코드 위치 | 요청과 연결하지 않으면 사용자 영향이 흐려진다 |
이 신호들은 경쟁 관계가 아니다. 예를 들어 latency histogram에서 p99가 나빠진 시간을 찾고, exemplar나 trace id로 느린 요청을 열고, 해당 span의 로그와 profile을 보는 식으로 이동한다.
Grafana Tempo는 공식 문서에서 trace에서 metric을 만들고 Loki 로그, Prometheus metric과 연결하는 구조를 제공한다. 오픈소스 스택의 장점은 특정 SaaS의 화면에 갇히지 않고 신호의 저장과 연결 방식을 설계할 수 있다는 점이다. 대신 Collector, storage, retention, query 성능과 업그레이드를 직접 운영해야 한다.
실행 비용의 위치
trace에서 어떤 span이 2초 걸렸다는 것은 알았지만 그 안에서 CPU가 어디에 쓰였는지는 모를 수 있다. profile은 함수 단위의 실행 표본과 resource usage를 기록해 이 빈칸을 채운다.
여기서도 trace와 profile의 질문은 다르다.
- trace: 사용자의 요청이 어떤 서비스와 작업을 거쳤는가
- profile: 그 시간 동안 어떤 함수가 CPU를 사용했는가
Sentry는 2025년에 Continuous Profiling과 UI Profiling을 기존 profiling 제품과 구분해 공개했다. Continuous Profiling은 지원되는 서버 runtime의 장시간 resource usage를 보고, UI Profiling은 사용자 세션의 실행 비용을 본다. 처음에는 iOS·macOS와 Android 중심이었지만 2025년 12월부터 Browser JavaScript와 Electron도 UI Profiling을 지원한다.
그래도 모든 runtime이 같은 방식으로 측정되는 것은 아니다. 브라우저에서는 DevTools CPU profile과 Long Animation Frames가 특정 세션을 더 직접적으로 파고드는 도구가 될 수 있다. 제품 이름보다 지원 platform, sampling 방식, 수집 overhead, trace와의 연결 범위를 확인해야 한다.
세션의 재구성
사용자가 "버튼이 안 눌렸다"고 말했을 때 에러와 trace만으로는 화면 상태를 알기 어렵다. Session Replay는 DOM 변화와 입력, navigation, console, network 정보를 재생 가능한 형태로 연결한다.
Sentry의 Session Replay FAQ는 replay가 픽셀을 녹화한 영상이 아니라 브라우저 DOM을 기록하고 나중에 재구성한 결과라고 설명한다. 그래서 원래 화면과 완전히 같지 않을 수 있고, canvas나 외부 리소스에는 별도 조건이 붙는다.
이 차이는 개인정보 관점에서도 중요하다. DOM에는 입력값, 계정 정보, 게시물 내용이 들어 있다. Sentry의 Web Replay SDK는 text를 mask하고 media를 block하는 기본값을 제공하지만, 애플리케이션의 DOM 구조와 custom component까지 자동으로 안전해지는 것은 아니다. request와 response body 수집도 필요한 URL만 명시적으로 허용해야 한다.
Replay를 켜기 전에는 다음을 먼저 정해야 한다.
- 어떤 오류와 session을 표본으로 남길 것인가
- 어떤 DOM 영역과 입력을 mask 또는 block할 것인가
- network body와 header를 수집할 필요가 있는가
- 누가 replay를 볼 수 있고 얼마 동안 보존할 것인가
- SDK와 DOM serialization 비용을 사용자가 부담할 가치가 있는가
Replay는 맥락이 강한 만큼 수집 범위도 강하다. 디버깅 가능성과 데이터 최소화 사이의 결정을 제품 기본값에만 맡기면 안 된다. (이 블로그는 Replay를 쓰지 않는다. 로딩 성능이 곧 검색 노출의 전제인 서비스라서, 수집이 주는 답보다 방문자가 내는 비용이 크다고 판단했다)
부재로 드러나는 실패
에러, trace, Replay는 발생한 사건의 맥락을 깊게 보여준다. 하지만 예약 작업이 아예 시작되지 않았다면 남길 사건 자체가 없다.
Cron monitor는 작업 시작과 완료 상태를 check-in으로 받고, 예정된 시간에 신호가 오지 않으면 missed 상태를 만들 수 있다. 이때 관측 대상은 코드가 던진 오류가 아니라 기대했던 사건의 부재다.
필자에게 이것은 남의 이야기가 아니다. 이 블로그는 매주 월요일에 Search Console 데이터를 자동으로 수집하는데, 어느 주에 그 작업이 조용히 돌지 않아도 지금은 알 방법이 없다. 실패한 것이 아니라 아무 일도 일어나지 않은 것이라서 에러가 나지 않기 때문이다. 관측 데이터를 모으는 장치 자체가 사각지대에 있는 셈이다.
이 관점은 health check, queue consumer, 데이터 수집 pipeline에도 적용된다. "실패 이벤트가 0건"이라는 metric만으로는 건강함을 알 수 없다. 처리해야 할 입력이 있었는지, 마지막 성공 시점은 언제인지, 처리량이 평소 범위에 있는지를 함께 봐야 한다.
관측을 어렵게 만드는 것은 발생한 사건보다 발생하지 않은 사건인 경우가 많다. 그리고 이 문장은 뒤에서 필자가 예상하지 못한 방식으로 한 번 더 돌아온다.
성공 응답 속 실패
반대로 사건은 발생했지만 성공으로 분류돼 보이지 않는 실패도 있다. 필자가 계측을 붙이자마자 마주친 것이 정확히 이 종류였다.
처음 계획은 단순했다. 통계 API 라우트 핸들러의 catch에 에러 보고를 넣으면 Google Analytics 조회가 실패할 때 알 수 있을 것이다. 그런데 로컬 프로덕션 빌드에서 잘못된 서비스 계정 키를 주입해 일부러 실패시켜 보니, 에러가 라우트의 catch에 도달하지 않았다. 한 층 아래에 있는 통계 조회 모듈의 catch 블록 네 곳이 먼저 잡아서 기본값을 반환하고 있었고, 응답은 이렇게 나갔다.
HTTP 200 OK
{ "slug": "/260610", "views": 0 }
방문자에게는 통계가 0으로 보이고, 서버는 정상이라고 답한다. 라우트의 에러율과 uptime만 보면 아무 일도 없다. 시스템의 성공 조건과 사용자의 성공 조건이 달랐던 것이다. (catch를 어느 계층에 둘 것인가는 에러 핸들링에서 다룬 적이 있는데, 그때는 "어디서 잡아야 하는가"였고 이번에는 "잡았는데 아무도 모른다"를 만난 셈이다)
그래서 계측 지점을 라우트가 아니라 그 네 곳으로 옮기고, 각각 어떤 쿼리에서 터진 것인지 구분하는 태그를 달았다. 이 태그가 뒤에서 결정적인 역할을 한다.
이런 상황에는 이미 정확한 이름이 붙어 있다. Microsoft와 Azure 팀이 2017년 HotOS에서 발표한 Gray Failure 논문은 클라우드의 큰 가용성 사고가 대개 완전히 멈추는 종류가 아니라 이런 회색 지대에서 온다고 말하며, 그 핵심 특징을 이렇게 규정한다.
우리는 gray failure의 핵심 특징이 differential observability, 즉 시스템의 실패 감지기가 애플리케이션이 피해를 보고 있는데도 문제를 알아차리지 못할 수 있다는 점이라고 주장한다.
we argue that a key feature of gray failure is differential observability: that the system's failure detectors may not notice problems even when applications are afflicted by them.
한 주체는 실패로 피해를 입고 있는데 다른 주체는 그 실패를 인지하지 못하고, 문제는 후자가 실패 감지를 책임지는 쪽이라는 것이다. 필자가 계측 지점을 라우트에서 아래 계층으로 내린 일이 정확히 그 인식의 격차를 메우는 작업이었다.
해결은 모든 기본값 반환을 실패로 바꾸는 것이 아니다. fallback은 사용자 경험을 지키는 올바른 선택일 수 있다. 대신 fallback이 실행됐다는 사실, 원래 호출의 지연, 영향을 받은 기능을 별도 신호로 남겨야 한다.
try {
  return await fetchAnalyticsStats()
} catch (error) {
  captureException(error, { tags: { gaQuery: 'stats' } })

  return { totalPageViews: 0, todayVisitors: 0 }
}
관측해야 하는 것은 예외가 아니라 시스템이 정상 경로에서 벗어난 사실이다.
65초 매달린 GA 호출
계측 지점을 옮기고 나서 처음 올라온 실제 프로덕션 이슈가 이 이야기의 다음 장면이다. GA 호출이 65.877초 후에 DEADLINE_EXCEEDED로 실패하고 있었다. 그런데 위에서 본 구조 때문에 응답은 여전히 200이었다. 당시 홈은 동적 렌더링에 통계 영역을 스트리밍으로 흘려보내고 있어서 페이지 자체는 바로 떴다. 대신 그 자리가 오래 로딩 상태로 남아 있다가 조용히 0으로 채워졌다.
원인을 파보니 사용하는 GA 클라이언트 라이브러리의 설정 파일에 이렇게 박혀 있었다.
"RunReport": { "timeout_millis": 60000, "retry_params_name": "default" }라이브러리 기본 RPC 타임아웃이 60초인데, 필자의 코드는 다섯 개 호출 지점 어디에도 타임아웃을 넘기지 않고 있었다. 이건 필자만의 실수가 아니라 널리 경고되어온 종류의 실수다. Google SRE의 Gráinne Sheerin이 쓴 gRPC 공식 블로그의 deadline 글은 제목 아래 첫 줄이 "TL;DR: Always set a deadline"이고, deadline이 없으면 진행 중인 요청이 자원을 붙들고 최대 타임아웃까지 매달릴 수 있다고 설명한다. 필자가 쓰는 GA 클라이언트도 gRPC 기반이니, 같은 원리를 문서가 이미 경고하고 있었는데 호출 지점에서 지키지 않은 것이다.
수정은 타임아웃을 5초로 고정해 호출 지점 전부에 넘기는 것이었다. 그리고 응답하지 않는 로컬 TCP 서버를 세워 결정적으로 재현했다.
| 조건 | 경과 시간 | 에러 메시지 |
|---|---|---|
| 타임아웃 미지정 (수정 전) | 60.04초 | Deadline exceeded after 60.000s |
timeout: 5000 (수정 후) |
5.00초 | Deadline exceeded after 5.000s |
숫자가 설명대로 움직였으니 타임아웃 설정이 코드에 닿는다는 것까지는 확인한 셈이다. 한 가지 밝혀두면 5라는 숫자 자체에 근거가 있는 것은 아니다. GA가 정상일 때의 응답 지연 분포를 재보지 않았으니 사실상 임의로 고른 값이다. 다만 방향에는 기댈 곳이 있었다. Google SRE 책의 Embracing Risk는 100%가 결코 옳은 신뢰성 목표가 아니라고 말한다. 이 블로그에서 방문자 수치는 부가 정보다. 정확하게 받아오는 것보다 빠르게 포기하고 기본값을 그려주는 편이 방문자 경험에 낫다.
고친 뒤에 다시 잰 분포
여기까지가 원래 이 조사의 결말이 될 예정이었다. 원인을 찾았고, 재현했고, 고쳤으니까. 그런데 수정 커밋이 배포된 릴리스에서 같은 계열의 DEADLINE_EXCEEDED가 백 건 넘게 쌓여 있는 것을 발견했다.
가장 최근 100건을 뽑아 보고된 시간의 분포를 봤다. 미리 짚어둘 것은 이 값이 GA가 실제로 응답에 쓴 시간이 아니라는 점이다. 마감 타이머를 걸어둔 순간부터 그 타이머가 실제로 울린 순간까지의 wall-clock time(실제 경과 시간)이다.
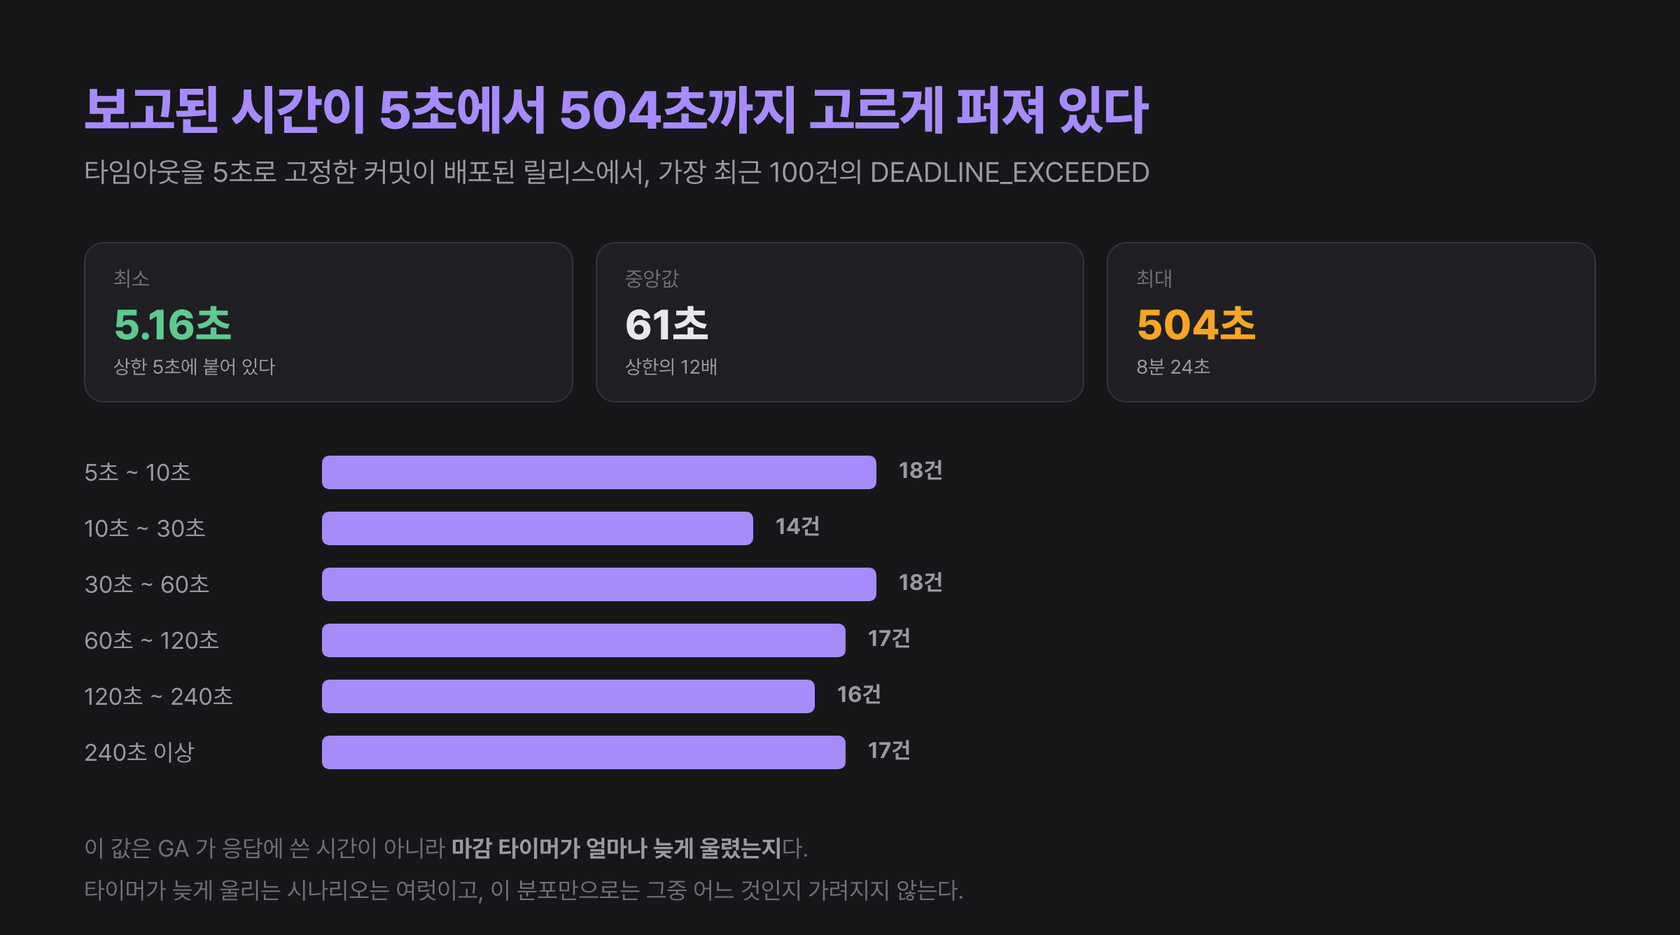
읽어보면 이렇다. 하한은 지켜졌다. 5초보다 짧게 끊긴 건이 하나도 없고 가장 짧은 것이 5.16초이니, 5초 설정 자체는 코드에 닿아 있다. 그런데 위로는 8분 24초까지 올라가고 중앙값이 61초다. 더 이상한 것은 값이 어느 구간에도 몰리지 않는다는 점이다. 실제로 GA가 느려서 생긴 지연이라면 상한 근처에 쌓여야 하는데 그렇지 않다.
태그가 더 많은 것을 알려줬다. 100건에 찍힌 태그는 stats와 popular 둘뿐이고 대체로 두 건이 쌍으로 올라온다. 이 두 경로의 공통점은 둘 다 한 시간짜리 캐시 뒤에 있는 재검증 경로라는 것이다. 반면 캐시 없이 방문자의 요청을 받아 그 자리에서 GA를 부르는 나머지 경로(page, pages)는 100건 안에 한 번도 등장하지 않는다. 실패가 방문자의 요청을 처리하는 중이 아니라 응답이 끝난 뒤 캐시를 다시 채우는 작업에서만 일어나고 있다는 뜻이다.
이 관찰은 앞 절에서 쓴 문장 하나를 흔든다. 통계 자리가 오래 로딩에 머문다고 썼는데, 실패가 응답 이후 경로에서만 난다면 방문자는 그 시간을 기다리지 않았을 수도 있다. 재보지 않고 쓴 문장이 하나 더 있었던 셈이다.
필자가 세운 가설은 이렇다. 이 블로그는 서버리스 함수 위에서 돌아가고, 서버리스 함수는 응답을 보내면 다음 호출까지 실행 환경이 얼어붙는다. 그동안 타이머도 함께 멈췄다가 함수가 깨어날 때 뒤늦게 발화한다면, 실제로 기다린 시간이 아니라 wall-clock time 기준으로 부풀려진 값이 찍힐 수 있다. 하한이 정확히 5초에 붙어 있는 것도, 위쪽 값이 아무 데도 몰리지 않는 것도, 실패가 응답 이후 작업에서만 나온다는 관찰과도 맞는다.
다만 여기서 조심해야 한다. 분포가 가설과 어긋나지 않는다는 것과 가설을 지지한다는 것은 다르다. 타이머가 뒤늦게 발화하는 시나리오는 여럿이다. 서버리스 동결 말고도 무거운 렌더링이 이벤트 루프를 물고 있었을 수도 있고, 컨테이너가 CPU를 조이고 있었을 수도 있다. 라이브러리 설정의 재시도 총예산이 600초라 관측된 최댓값 504초가 그 안에 들어온다는 점도 후보로 남겨뒀다. 전부 같은 모양의 분포를 만들 수 있으니 이 그래프는 후보를 좁혀주지 않는다.
후보를 하나 지워주는 것은 같은 구간의 CPU 사용 시간이다. wall-clock time으로 61초가 지나는 동안 CPU 시간이 거의 0이라면 무거운 렌더링이 이벤트 루프를 물고 있었다는 설명은 빠진다. 앞에서 본 profile 신호가 답하는 질문이 이것이다.
다만 CPU 시간으로 끝나지 않는다. 응답을 실제로 기다리는 동안에도 CPU 시간은 0에 가깝기 때문에, 기다린 구간과 멈춰 있던 구간이 같은 모양으로 보인다. 둘을 가르려면 그 구간 안에서 시간이 고르게 흘렀는지를 봐야 한다. 짧은 간격으로 반복 발화하는 타이머를 걸어두고 그 간격이 한 번에 벌어지는 지점이 있는지 보는 식이다. 실행 환경이 얼었다면 간격이 튀고, 실제로 기다린 것이라면 고르게 흐른다. 호출 직전과 직후의 시각만 재는 것으로는 안 된다. 함수가 얼어 있는 동안에도 wall-clock time은 그대로 흐르므로 이미 가진 숫자를 다시 만들 뿐이다.
덧붙이면 이 이슈 목록과 태그 분포와 시간 값을 필자는 대시보드를 열어서 본 것이 아니라 Sentry 공식 MCP 서버를 붙여 에이전트에게 물어서 받았다. 계측을 붙이는 비용만 내려간 것이 아니라 쌓인 데이터를 열어보는 비용도 내려갔다.
발생이 멈춘 이유는 수정이 아니었다
이 글을 쓰면서 그 이슈를 다시 조회했다. 고쳤다고 믿은 것이 지금도 고쳐져 있는지 확인하기 위해서다.
2026년 9월 14일 기준으로 그 계열의 이슈는 총 144건에서 멈춰 있었다. 마지막 발생은 8월 18일이고, 그 뒤 27일 동안 0건이다. 태그 분포는 마지막까지 stats와 popular 쌍뿐이었다. 발생 그래프만 보면 문제가 사라진 것처럼 보인다.
그런데 필자는 그 사이 앞 절에서 적은 측정을 하나도 하지 않았다. 가설을 검증해서 고친 적이 없는데 왜 멈췄을까. 배포 이력을 맞춰 보니 답은 다른 데 있었다. 마지막 이벤트가 기록된 그날 커밋된 다국어 개편이 홈에서 방문자 통계와 인기 글 영역을 뺐다. stats와 popular 재검증 경로를 부르는 화면이 정확히 그 둘이었으니, 그 개편이 프로덕션에 배포된 뒤로는 실패할 코드가 불릴 일 자체가 없다. 실패하던 코드가 고쳐진 것이 아니라, 그 코드를 부르는 화면이 사라진 것이다.
그러니 이 장애는 해결된 것이 아니라 관측 대상이 사라진 것이다. 서버리스 동결 가설은 확인되지 않은 채로 남았고, 프로덕션에서 그 분포를 다시 만들어볼 재현 조건도 함께 사라졌다. 처음 65.877초를 보고한 최초 이슈의 원본 이벤트는 보존 기간을 넘겨 이제 열리지도 않는다.
필자가 이 절을 남겨두는 이유가 있다. 이슈 목록의 resolved는 원인 규명의 증명이 아니다. 발생이 0이 되는 경로는 여럿이다. 실제로 고쳐졌거나, 아무도 그 경로를 밟지 않게 됐거나, 계측 자체가 사라졌거나. 에러 신호만으로는 이 셋을 구분할 수 없다. 구분해주는 것은 호출량과 마지막 성공 시점 같은 정상 경로의 신호이고, 그것이 앞 절에서 말한 "발생하지 않은 사건"의 관측이 필요한 또 하나의 이유다. 계측을 붙이는 일이 한 번의 작업이라면, 관측은 계속 재보는 일이다.
샘플링의 지식 한계
trace와 replay, profile은 저장 비용과 client overhead 때문에 sampling이 필요하다. 문제는 sample rate를 낮추면 비용만 줄어드는 것이 아니라 답할 수 있는 질문도 줄어든다는 점이다.
무작위 10% sampling은 전체 분포를 추정하기에는 괜찮을 수 있지만 드문 오류를 놓칠 수 있다. 오류가 발생한 session만 replay를 추가로 남기거나, 느린 trace와 실패 trace를 우선 보존하는 정책이 필요한 이유다.
반대로 오류가 난 요청만 남기면 정상 사용자와 비교할 기준이 사라진다. 느린 요청이 특별히 느린 것인지 시스템 전체가 느린 것인지 판단할 수 없다.
필자도 이 비용을 치렀다. 이 블로그는 비용을 아끼려고 trace 표본을 10%만 받도록 해뒀는데, 위의 조사에서 부풀려진 경과 시간이 실제 대기였는지 가르려면 해당 호출 구간의 시작과 끝이 필요했고, 표본이 얕아 문제의 요청에 대한 trace가 없었다. 아낀 것은 필자의 요금이었고 잃은 것은 답할 수 있는 질문이었다.
sampling은 하나의 숫자가 아니라 질문별 정책이어야 한다.
- baseline을 위한 확률 표본
- 오류와 latency threshold를 위한 우선 표본
- 특정 release와 기능을 조사하기 위한 임시 표본
- 개인정보와 비용이 큰 replay·profile의 별도 표본
데이터를 저장하지 않은 뒤에는 AI도 복원할 수 없다.
AI 이후의 계측 설계
AI가 시스템 관측에서 유용한 이유는 데이터가 이미 구조화되어 있기 때문이다. issue, event, tag, span, trace, release는 API로 조회할 수 있고, 로그와 profile도 시간과 식별자를 가진다. 필자가 이슈의 태그 분포와 발생이 멈춘 날짜를 에디터에서 에이전트에게 물어 받을 수 있었던 것도 이 구조 덕분이다.
Sentry는 2026년 6월 tracing, profiling, attachment 관련 endpoint를 포함해 agent와 자동화가 사용하는 API 문서를 확장했다. 관측 데이터가 사람이 대시보드에서 읽는 정보뿐 아니라, agent가 근거를 조회하는 인터페이스로도 사용되고 있음을 보여준다.
AI는 다음과 같은 탐색을 빠르게 만든다.
- 최근 release 이후 늘어난 issue와 tag 조합 찾기
- 특정 trace의 느린 span과 연관 로그 요약하기
- 여러 이벤트에서 공통으로 나타난 breadcrumb와 browser 환경 찾기
- profile의 hot path와 관련 commit 후보 연결하기
- 재현 가설과 추가 계측 지점 제안하기
하지만 계측되지 않은 domain state는 agent도 알 수 없다. checkout.result, cache.status, fallback.reason 같은 속성을 어떤 위치에 남겨야 하는지는 코드와 사용자의 기대를 이해해야 결정할 수 있다. 필자의 조사에서 에이전트가 분포와 태그를 즉시 뽑아줄 수 있었던 것은 계측 지점을 아래 계층으로 내리고 태그를 달아둔 판단이 먼저 있었기 때문이다.
AI가 root cause를 제안할 수는 있지만, 무엇을 실패라고 정의하고 어떤 비용으로 어떤 사용자를 관측할지는 엔지니어링 판단이다.
신호를 하나의 사건으로
Sentry의 각 기능을 전부 켜는 것이 이 글의 결론은 아니다. 에러에서 breadcrumb로 과거를 보고, trace로 요청 경로를 따라가고, metric으로 영향 범위를 확인하며, 필요할 때 replay와 profile로 내려갈 수 있어야 한다. 여기에 Cron monitor처럼 기대한 사건의 부재와 정상 응답으로 분류된 이탈까지 같은 조사 흐름에 들어와야 한다.
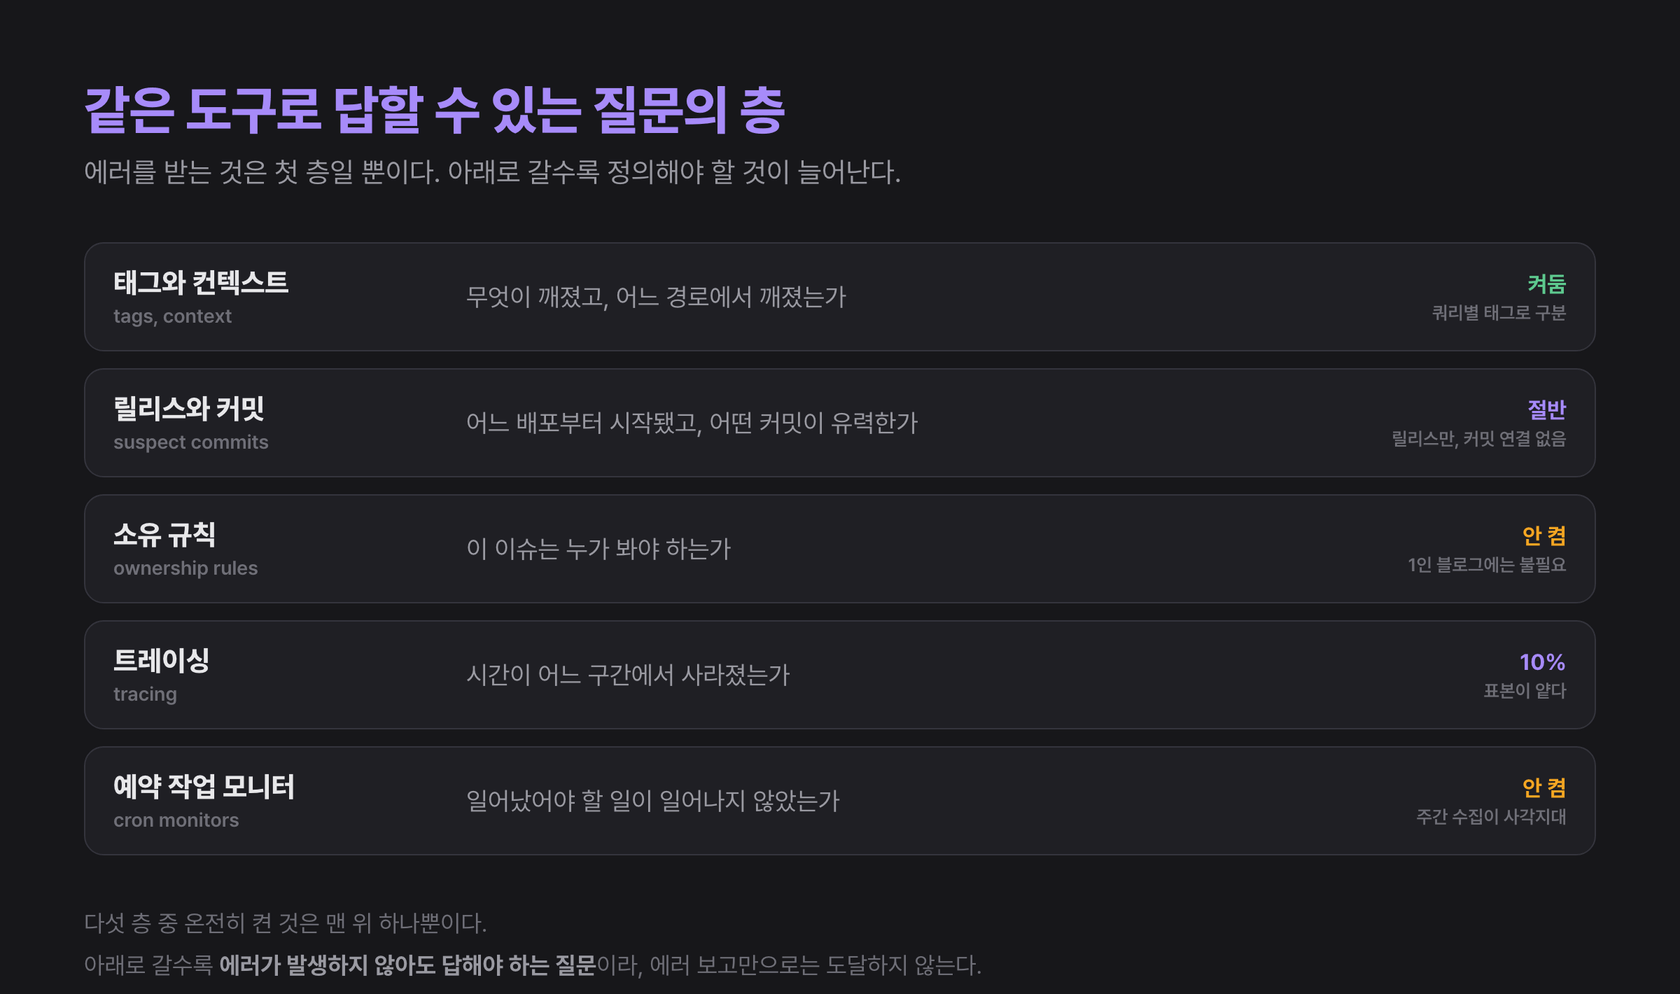
이 블로그가 다섯 층 중 온전히 켠 것이 태그 하나뿐이라는 사실이 부끄러운 성적표는 아니라고 생각한다. 어느 층을 켤지는 기능 목록을 훑어서 정해지지 않고, 무엇을 실패로 볼 것인가를 먼저 정해야 어느 층이 필요한지 알 수 있기 때문이다. 다만 이번 조사에서 trace 표본의 얕음과 주간 수집의 사각지대라는 두 층의 빈칸이 실제 비용으로 돌아왔으니, 다음에 켤 층은 정해진 셈이다.
OpenTelemetry의 trace context와 semantic convention은 이 이동 경로를 특정 제품 밖으로 확장한다. 다만 JavaScript browser instrumentation은 여전히 experimental이고 profile 신호는 Alpha다. 표준에 포함됐다는 사실과 각 runtime에서 안정적으로 쓸 수 있다는 사실을 구분해야 한다.
AI는 이 신호를 검색하고 연결할 후보를 빠르게 찾는다. 그러나 관측의 깊이는 제품의 기능 개수가 아니라 신호 사이를 이동할 수 있는가, 정상 경로를 벗어난 상태를 표현했는가에서 결정된다. 필자의 200 응답은 신호를 심기 전까지 실패를 한 번도 말하지 않았고, 심은 뒤에야 그것이 실패였다는 사실이 드러났다.
다음 글 관측에서 판단으로에서는 이 시스템 정보와 GA4, Search Console의 사용자 데이터를 어떻게 함께 해석할지 살펴보려고 한다. 시스템을 자세히 보는 것만으로는 무엇을 먼저 고쳐야 하는지 결정할 수 없기 때문이다. 그 전에 이 글을 읽는 독자분들도 resolved로 닫아둔 이슈 하나를 떠올려보면 좋겠다. 그 이슈는 고쳐져서 멈췄는가, 아니면 아무도 다시 재보지 않았을 뿐인가.