LLM 的校准与过度自信
这篇文章想聊聊模型的校准,以及 RLHF 之后出现的过度自信。本文写给想把模型返回的概率或确信度当作代码中判断标准的开发者。读完之后,你可以说明准确率和校准有什么不同、ECE 衡量的是什么、用人类偏好打磨过的模型给出的概率如何偏离实际命中率,以及这背后的原因目前弄清到了什么程度。
笔者在验证 TypeSafe AI 公开的决策模型 Jev 的说法时,必须先把这个概念理清楚。Jev 不返回句子,而是为每个选项返回概率,并把校准作为训练目标。要检验这个说法,得先知道校准是什么,以及它在现有模型中为什么会偏。
准确率与校准
首先必须区分准确率和校准。准确率是能答对百分之几,校准是知不知道自己能答对百分之几。把说过降水概率 70% 的那些天汇总起来,如果实际十次里下了七次雨,那这个预报就是校准良好的。它不代表准确率高。它代表预报知道自己的极限。只有 60% 正确率的模型,只要自己说 60%,校准就是满分。
刻度偏离的方向有两个。模型说出的概率高于实际命中率,叫作 overconfidence(过度自信);低于实际命中率,叫作 underconfidence。把说出的概率放在横轴,把该概率区间的实际命中率放在纵轴,两者在哪里分开就一目了然。这样画出的图叫作 reliability diagram。
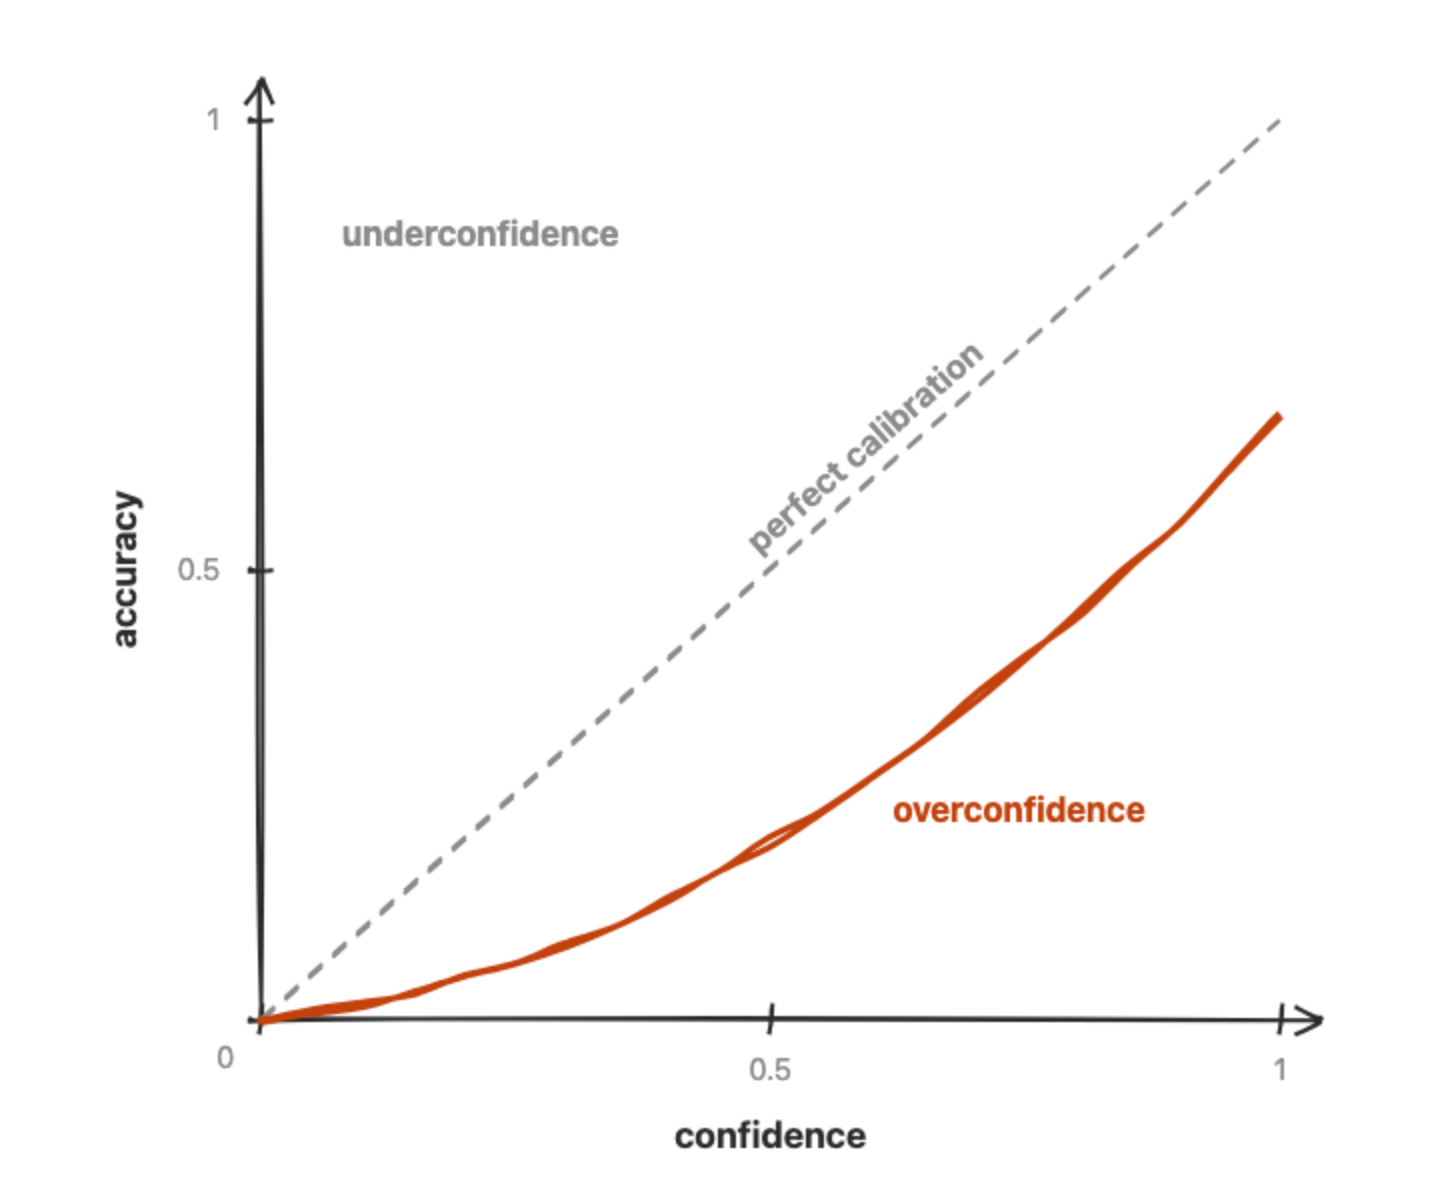
曲线贴着对角线,说明模型说多少就答对多少。越往对角线下方垂,相对于它说出的概率,答对得就越少。
衡量这种偏离的指标是 ECE(expected calibration error)。按照 Guo et al. 2017 的定义,它把每个概率区间里“说出口的概率”与“实际命中率”的差值,按该区间的样本比例加权平均,0 为完美。下面的代码把这个公式写了出来。它比较一个 10 道题答对 6 道的模型,在每次都说 0.6 和每次都说 0.95 时的情况。
// Guo et al. 2017 의 식 (3). 구간은 등간격 10개(논문 실험은 15개), 경계는 왼쪽 닫힘
function ece(preds, M = 10) {
  const bins = Array.from({ length: M }, () => ({ n: 0, hit: 0, conf: 0 }))
  for (const { p, correct } of preds) {
    const b = bins[Math.min(M - 1, Math.floor(p * M))]
    b.n++
    b.hit += correct ? 1 : 0
    b.conf += p
  }
  return bins.reduce(
    (sum, b) => (b.n ? sum + (b.n / preds.length) * Math.abs(b.hit / b.n - b.conf / b.n) : sum),
    0,
  )
}

// 10문제 중 6문제를 맞힌다
const answers = Array.from({ length: 10 }, (_, i) => ({ correct: i < 6 }))
console.log(ece(answers.map((a) => ({ ...a, p: 0.6 }))).toFixed(3)) // 매번 0.6 이라고 말할 때
console.log(ece(answers.map((a) => ({ ...a, p: 0.95 }))).toFixed(3)) // 매번 0.95 라고 말할 때
这是 2026-10-08 用 Node v24.16.0 运行的结果。
0.000
0.350
两种情况的准确率都是 0.6。只是说出的概率变了,ECE 就从 0 升到 0.35。不过公式里取了绝对值,所以 ECE 只衡量偏离的大小,不知道方向。每次都说 0.25、同样答对 6 道题的模型,ECE 也恰好是 0.35。究竟是 overconfidence 还是 underconfidence,要看 reliability diagram,或者平均确信度减去准确率的值才知道。
RLHF 的目标函数
那么,用人的反馈打磨过的模型,为什么这个刻度会偏呢。首先要看 RLHF(reinforcement learning from human feedback)在优化什么。用人的偏好比较来建立奖励模型这一骨架出自 Christiano et al. 2017,把它搬到语言模型上的早期工作是 Ziegler et al. 2019,InstructGPT 又把它用于指令跟随。这时被推高的值,是模仿人类偏好的奖励模型的分数。语言模型方面的工作会在奖励上加 KL penalty,让模型不要离开始强化学习之前的模型太远,InstructGPT 还混入了预训练数据的梯度(PPO-ptx),但推高的对象仍然是那个分数。
对聊天机器人来说,人的偏好是对的目标。问题在于这种偏好偏向回避流露不确定性的语气。Zhou et al. 2024 在四个公开偏好数据集上表明,标注者较少选择含有 "I'm not sure, maybe" 这类弱化表达的回答。差异很小,但显著。不过,他们并没有更多地选择含有强调确信的表达的回答。Leng et al. 2025 表明,奖励模型不管回答的实际质量如何,都会给写出高确信度分数的回答更高的分数。两者都不是关于 token 概率,而是关于文字中的确信表达(verbalized confidence)的结果。推出替代 RLHF 的训练方法的 TypeSafe,也在自家的入门文档中写道,RLHF 可能会奖励听起来很有把握的幻觉(confident-sounding hallucinations)。这是推销替代方案的一方的立场。
GPT-4 的校准曲线
在 token 概率上也观察到了同一方向的偏离。GPT-4 技术报告正文的 Figure 8 把预训练模型和 post-training 模型的 reliability diagram 并排放在一起,图注是这样写的。
Right: Calibration plot of the post-trained GPT-4 model on the same subset of MMLU. The post-training hurts calibration significantly.
横轴是模型给 MMLU 选择题的 A、B、C、D 每个选项分配的概率(logprob),纵轴是该区间的实际命中率。按 Figure 8 上标出的数字,预训练模型的 ECE 是 0.007,经过 PPO(RLHF 中朝着提高奖励模型分数的方向更新模型时使用的强化学习算法)的模型是 0.074。恶化了十倍以上。
在 Figure 8 右侧(PPO)的面板中,0.4 以上区间的柱子在对角线下方,但 0.1 到 0.3 之间的区间反而在对角线上方。0.1 到 0.9 之间的柱子平平地挤在实际命中率约 0.3 到 0.5,所以模型说出的概率升高了,命中率却几乎跟不上。0.074 里也混进了这些 underconfidence 的区间。而且正如 Guo et al. 指出的,reliability diagram 不显示每个区间有多少样本,所以不能认为柱子离对角线的距离和该区间对 ECE 贡献的大小成比例。
这块面板和上面的概念图有两点不同。首先,它不像概念图里的曲线那样只往对角线下方垂,而是穿过对角线一次。其次,它把四个选项的概率全都放进了区间,所以也和上面代码那样只用所选答案一个概率来衡量的定义不同。所以笔者不把 0.074 和上面代码的 0.35 放在同一把尺子上比较。
那么为什么会变差。报告正文只写了预训练模型校准得很好、post-training 之后校准下降,没有说原因。线索在 Anthropic 的 Kadavath et al. 2022 里。他们用自家语言模型训练出的 RLHF 策略,表面上看校准非常差。论文说这并不意外,因为 RL fine-tuning 往往会把预测往获得最多奖励的行为方向收拢。这不是论文的主题,而是顺带做的一个简短实验。然而,对所有评估都使用同一个温度 T=2.5 之后,三项评估中的校准问题大体上都解决了。温度是用来除 logit 的值,大于 1 时它保持答案的顺序不变,只把概率分布摊平。笔者把一个值就大体解决了问题这一结果,理解为偏离并不集中在某些区间,而是整个分布都往一边收窄了。论文也附上了一句保留:更强的 RL 训练可能会以这种方式无法修复的形式破坏校准。
这是 Anthropic 模型上的结果,所以不能直接搬来当作 Figure 8 的原因。前一节的研究处理的也是文字中的确信表达。笔者没能找到把“人回避不确定的语气”这一结果和 token 概率的偏离直接连起来的一手证据。
代码拿到的概率
Figure 8 里的概率是 token 的对数概率。要拿到同一类值,按照 OpenAI API 规范,在 Chat Completions 请求里把 logprobs 设为 true,再用 top_logprobs 在 0 到 20 之间决定每个 token 位置返回多少个候选。让模型在回答的同时用数字说出确信度,这样拿到的值是用文字说出的确信,和 token 概率是不同的值。
研究这两种值的论文比较的是不同的组合。Tian et al. 2023 报告说,在 ChatGPT、GPT-4、Claude 这样的 RLHF 模型内部,用文字说出的确信通常比条件概率校准得更好,在三个基准上常常把 ECE 相对降低约 50%。不过在这项比较中,权重未公开的模型的条件概率不是 API 的 token 概率,而是把同一个问题采样 10 次、按得出该答案的比例估计的值。前面提到的 Leng et al. 则报告说,与 RLHF 之前的模型相比,RLHF 模型在用文字说出的确信上更 overconfident。两个结果可以同时成立。而且 0.074 是 2023 年 GPT-4 post-training 模型在 MMLU 子集上得出的值,不能原样套用到你现在通过 API 调用的模型上。
总结
总结一下,校准不是能答对百分之几的问题,而是知不知道自己能答对百分之几的问题,ECE 是衡量这种偏离大小的数字。方向要看 reliability diagram,或者平均确信度减去准确率的值才知道。RLHF 推高模仿人类偏好的奖励模型的分数。Kadavath et al. 认为,这种优化往往会把预测往获得更多奖励的方向收窄。有研究表明,人较少选择流露不确定性的回答,而奖励模型不论质量如何,都会给写出高确信度分数的回答更高的分数。在 GPT-4 上,post-training 之后 ECE 从 0.007 变成了 0.074,但 OpenAI 并没有写出原因。代码拿到的概率是 token 概率还是文字中说出的确信,校准结果也会不同,所以不管是哪一种,都要在自己的数据上重新测一遍。
把校准作为训练目标的决策模型 Jev 的概率是否真的诚实,将在决策模型,Jev 与 Kev中讨论。
也希望读到这里的各位,在把模型返回的概率作为阈值写进代码之前,至少测一次:这个模型是以什么为目标训练的,在自己的数据上刻度准不准。