决策模型,Jev 与 Kev
这篇文章想聊聊一个不生成文本的模型。上周 TypeSafe AI 公开了 Jev。
最先映入眼帘的用途是浏览器自动化。Browserbase 提交了一个把 Jev 接进 Stagehand 的 act() 的 PR。结构是把页面的无障碍树作为 state 发过去,再以选项的形式问「下一步该点击哪个元素」。40 个任务里 act() 的中位数从 1.97 秒降到 0.46 秒,147 次操作中回退到 LLM 的只有 4 次。Playwright 脚本只要一个 selector 变了就会坏掉的那个位置,被一次只返回一个概率的调用填上了。写这篇文章的时候,这个 PR 还没有合并。
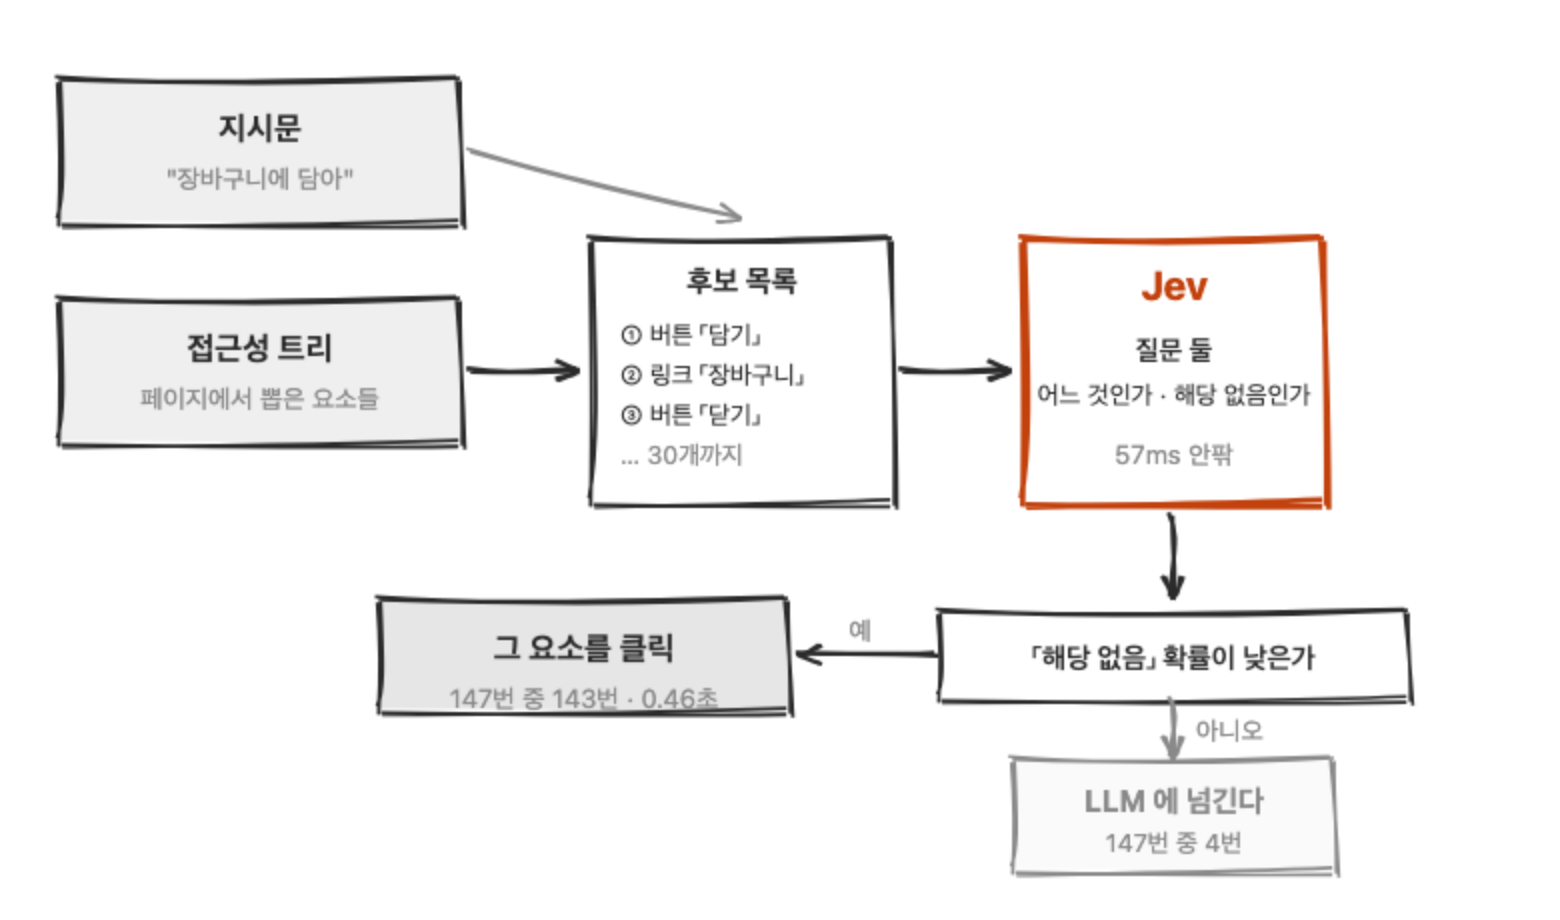
那个 PR 划的线,就是这篇文章的问题。它把接受 Jev 答案的标准放在概率 0.7,过不了就交给 LLM。能不能相信那个模型返回的概率,在代码里划一条线。
光看别人的基准测试没法判断,所以笔者想用自己的数据来验证。这个博客里有一道拦截音译外来词的闸门。规则是不写 피커 而写 picker,但正则只能抓住有把握的那一半,像 멀티스레드(멀티=multi + 스레드=thread)或 콜 스택(call stack)这种嵌在复合词里或者在韩语里早已定型的词,由笔者每次手工判断。答案只有「还原」和「保留」两个,懂的人一秒就能判断,而且要在构建脚本里、没有人复核的情况下决定通过还是失败。它和 Stagehand 的 selector 判断是同一种形状。
于是顺序就这样定了:Jev 返回什么,那个概率来自什么样的训练,把笔者的闸门交给它会得到什么数字,以及这些数字能用在哪里。
不生成文本的模型
公开日期是 2026 年 9 月 15 日。公司不把它叫作 LLM,而是归进 System One Model 这个新类别。本文称之为决策模型。创始人 Diogo Almeida 曾在 OpenAI 以第四作者的身份参与过InstructGPT 论文。他待过打造了 ChatGPT 直系祖先那套方法的团队,如今站在指出这套方法局限的一边。
Jev 不生成句子。预先给定答案的形状,它就从中挑选,并一并返回概率。问题类型只有三种。
| 类型 | 问什么 | 返回什么 |
|---|---|---|
choice |
是这其中的哪一个 | 选项、probabilities、confidence |
score |
处在哪个水平 | 分数、legend、probabilities、confidence |
noul |
是否为真 | 0 到 1 之间的一个概率 |
endpoint 也只有一个。向 POST /v1/systemone 发送 state(要评估的内容)、model、questions(问题映射)就会拿到答案。针对同一个 state 的多个问题可以装进一次请求,而且问题变多,响应时间也几乎不增加。
为什么快,可以用token 的原理一文中梳理过的 prefill 与 decode 的不对称来解释。LLM 慢的原因在于输出要一个 token 一个 token 地顺序挤出来,而 Jev 没有 decode 这个阶段。它并行读一次输入,直接把概率读出来。所以完全没有输出 token 的费用,只有输入按每百万 token $0.042 计费。
有一位叫 Archer Hume 的开发者调用 API 约一万次,从外部还原了它的行为,写成了一篇分析。输入 360 token 时中位数 57.5ms,29,835 token 时 218ms,塞进 1,500 个问题时是 610ms。其中最直接的证据,是选项有 200 个的响应与只有 2 个的响应以同样的速度返回这一观察。意思是写答案本身不花时间。
没人看的判断
速度和价格很显眼,但 Almeida 在公开发布文章里抛出的问题在另一边。模型在对话上已经超人好几年了,那自动化都去哪儿了。
他的回答是,这两类工作的种类不同。聊天机器人、copilot 和编码 agent,目标是让人在旁边看着觉得满意。在服务器上安静运行、没人看的判断则不是这样。如果把前者叫 assistant、后者叫 automation,那么到目前为止出现的模型全都是为前者造的。
笔者在梳理harness 设计时也做过类似的区分。agent 系统里有无数没人看的判断。这个请求要不要转交给人。这条命令可不可以执行。现在这些全都在问昂贵的 LLM。笔者的正则闸门盖不住的剩下那一半,也是这样的判断。
RLHF 留下的位置
那为什么需要新的训练方法呢。让现有的模型只答是/否不行吗。
答案在 RLHF(reinforcement learning from human feedback)的谱系里。用人的偏好比较来建立奖励模型这一骨架出自 Christiano 等人 2017 年的论文,Stiennon 等人在 2020 年把它用到了语言模型上,InstructGPT 又扩展到指令跟随。三篇论文共享的目标函数只有一个。给出人类评估者更偏好的输出。
这里必须区分准确率和校准。准确率是能答对百分之几,校准是知不知道自己能答对百分之几。把说过降水概率 70% 的那些天汇总起来,如果实际十次里下了七次雨,那这个预报就是校准良好的。它不代表准确率高。它代表预报知道自己的极限。只有 60% 正确率的模型,只要自己说 60%,校准就是满分。
衡量这种偏离的指标是 ECE(expected calibration error)。它把每个概率区间里“说出口的概率”与“实际命中率”的差值,按该区间的样本比例加权平均,0 为完美。
对聊天机器人来说,人的偏好是对的目标。问题在于,比起吞吞吐吐的回答,人更偏好有自信的回答。于是模型养成了含糊时也把话说死的习惯。TypeSafe 的文档把这叫作 mode dropping。意思是偏好优化把模型推向偏爱特定风格,同时压掉了其他可能输出的概率。
OpenAI 也把同样的事写进了自己的报告。GPT-4 技术报告的 Figure 8 把预训练模型和 post-training 模型的校准曲线并排放在一起,图注是这样的。
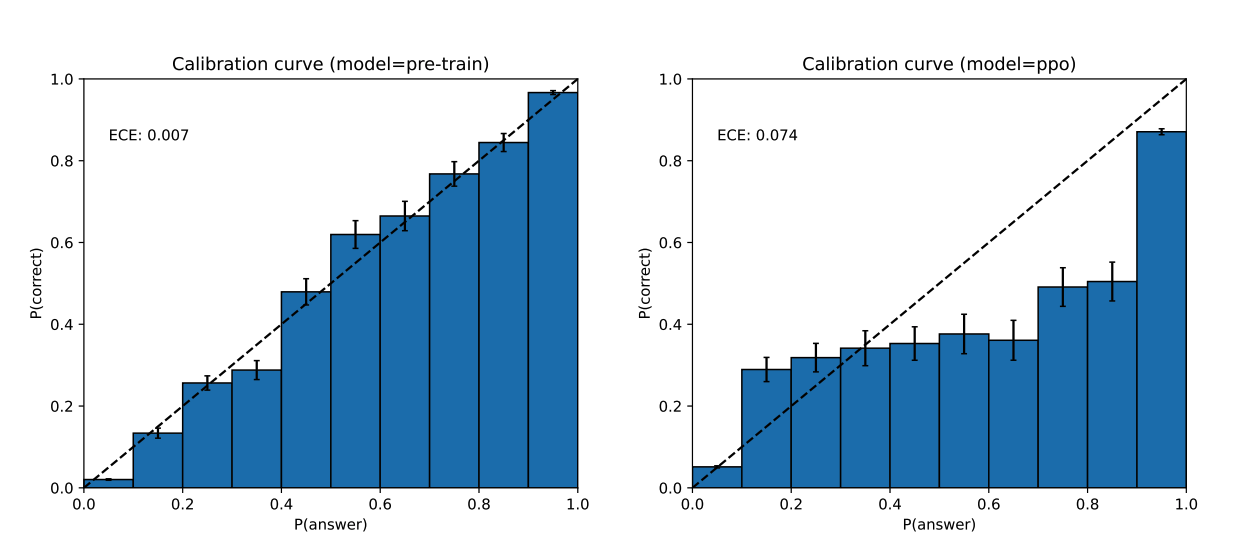
来源: OpenAI, GPT-4 Technical Report (arXiv:2303.08774), Figure 8.
Right: Calibration plot of the post-trained GPT-4 model on the same subset of MMLU. The post-training hurts calibration significantly.
按图上标出的数字,预训练模型的 ECE 是 0.007,经过 PPO 的模型是 0.074。差了十倍以上。在被打磨得讨人满意的过程中,知道自己能答对百分之几的能力被削掉了。
不过光靠 ECE 一个是不够的。 对所有输入都打 0.6 的常数预测器,只要实际命中率是 60%,ECE 也是 0。概率只是诚实、却不随案例分开,就没有划线的地方。所以除校准之外还要一起看概率是否真的分得开,后文要用的“在误差预算内可自动处理的比例”就是把这两者捆成一个数字的指标。
从软件的角度看,重要的是这一部分。概率既诚实又分得开,就能划线。于是有了超过 0.95 就自动处理、低于这个值就交给人的结构。
TypeSafe 说自己瞄准这个位置开出了第三条路。优化人类偏好的 RLHF,优化机器可判分的正确答案的 RLVR(reinforcement learning with verifiable rewards),以及声称优化校准后决策的 RLCD。
只是以 RLCD 名义公开出来的只有三行输出契约。截至写这篇文章的 2026 年 9 月 23 日,TypeSafe 的文档和发布文章里都没有论文或技术报告。另有一篇用同样缩写的 ICLR 2024 论文,那边是 reinforcement learning from contrastive distillation,是不同的方法。检索时注意别混在一起。
confidence 的真面目
那么 Jev 返回的数字诚实吗。回答之前先要看一件事。它返回的数字不止一个。
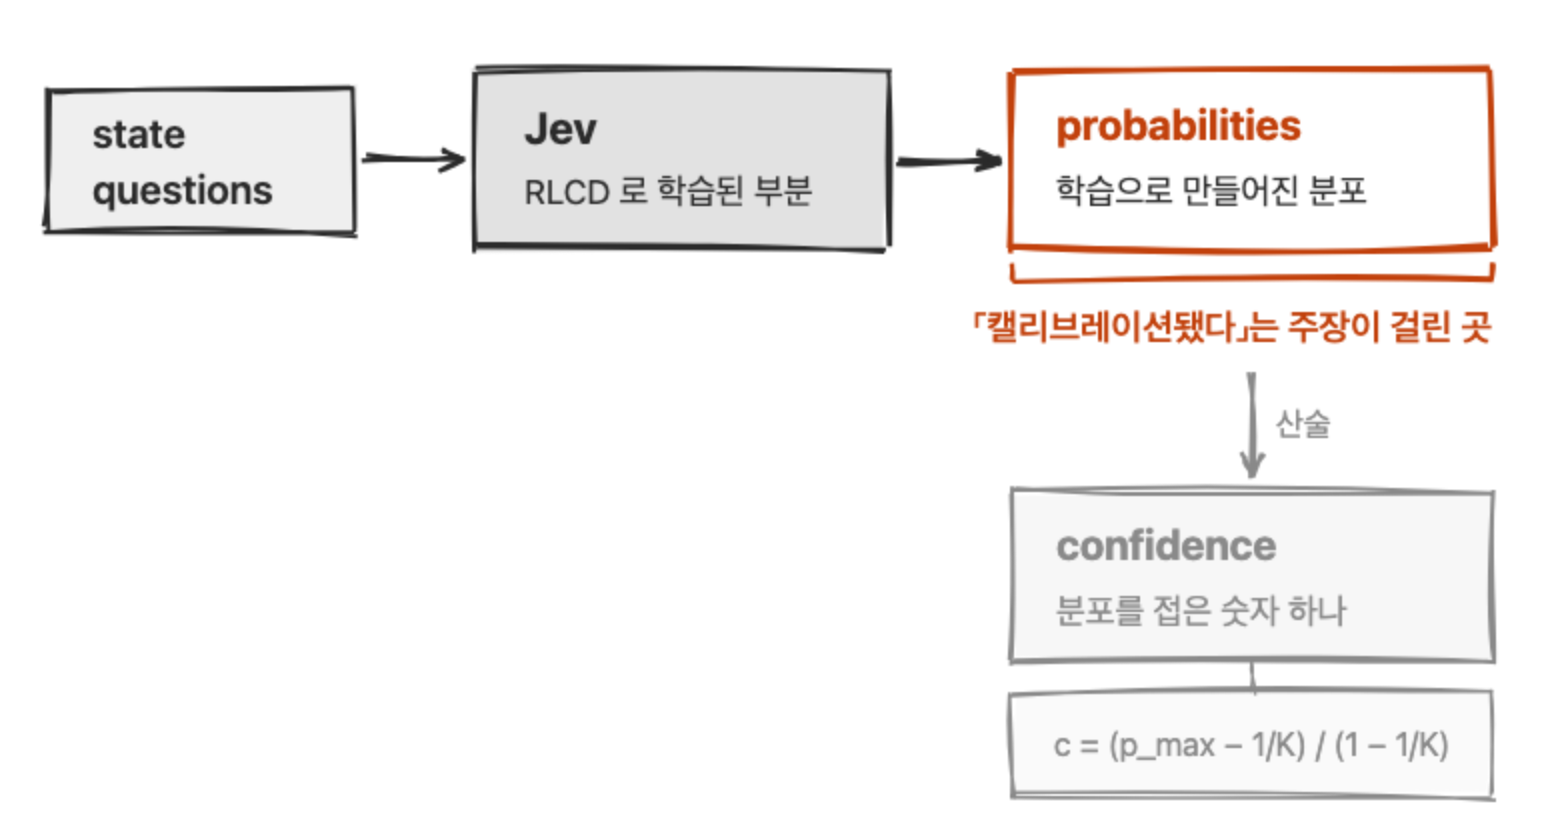
Choice 和 Score 的响应里同时装着 probabilities 和 confidence。前者是覆盖全部选项的概率分布,后者是 0 到 1 之间的一个数字。在代码里设阈值时,手先伸过去的是 confidence。
这个值不是模型造出来的。TypeSafe 组织公开的 system-one-adapter-python 里,_utils/confidence_metrics.py 总共 32 行,Choice 的部分是这样。
def choice_confidence(probs: list[float]) -> float:
    """Scale peak choice probability from uniform to certainty."""
    if len(probs) == 1:
        return 1.0

    normalized_probs = _normalize(probs)
    uniform_probability = 1.0 / len(normalized_probs)
    return (max(normalized_probs) - uniform_probability) / (1.0 - uniform_probability)
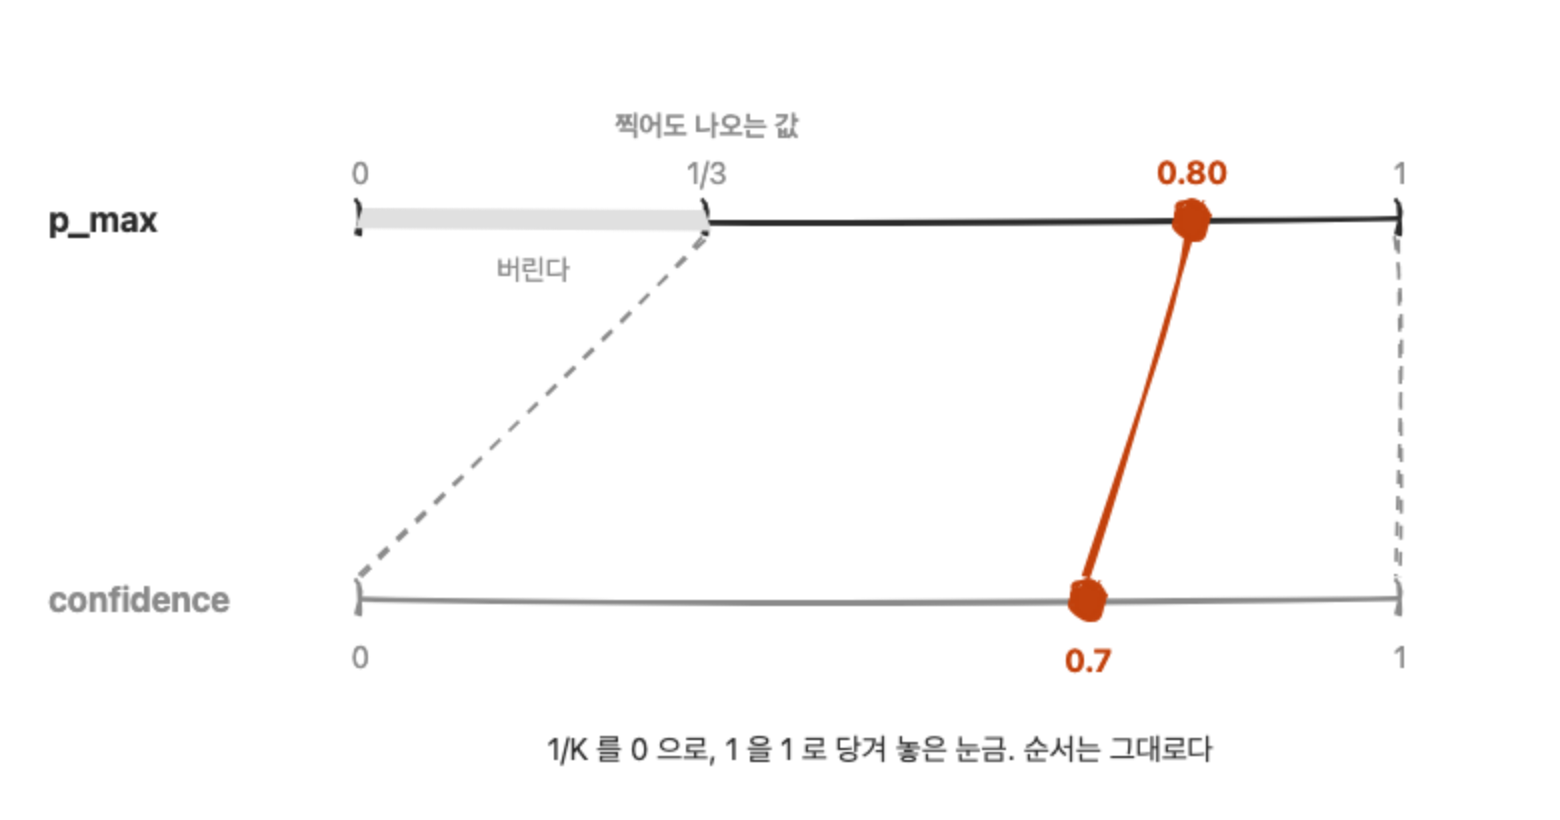
没有模型调用,也没有学出来的参数。进去的是一个 probabilities 向量,出来的是一个实数。写成式子就是 c = (p_max − 1/K) / (1 − 1/K),选项为三个、最大概率为 0.8 时得到 0.7。
这个仓库不是生产环境的 Jev 服务器,而是用 LLM 模仿同一套 API 的替代实现。所以只凭它还不能断言。不过还有两个指向同一个式子的证据。TypeSafe 官方文档的 confidence 页面把这个值写成 "a statistic computed from the probability distribution",演示代码里则放了一条标注为三选项近似式的 (3 × largest probability − 1) / 2。K 为 3 时与上式相同。另外主张审计账本记录了在真实 API 上,只给两个都错的选项时,响应中胜者为 0.52,confidence 返回的是 0.04。K 为 2 时 (0.52 − 0.5) / (1 − 0.5) = 0.04。与式子吻合。
在同一个仓库里,Score 用的干脆是另一个式子。把到众数水平的平均绝对距离除以均匀分布下的同一个量,然后用 1 减去它。文档没有公开 Score 的式子。也就是说,confidence 这一个名字底下有两套算式,类型不同时同一个数字含义也不同。Noul 没有 confidence 也是同样的理由。没有可折叠的分布。
文档也没有藏着这一点。它甚至写明,想用别的计算方式的话会把整个 probabilities 给你,你自己处理。这是写在文档里的内容,问题在于不读就用的那一方。
不过公开发布文章的对比表把两者并在一起写。上面写着 "Calibrated: higher confidence means higher accuracy"。读的人会理解为 confidence 是经过校准的值,而校准主张实际挂着的那一侧是 probabilities。
这个区分在数字上拉开多大,有测量可看。一位叫 scienthoon 的开发者公开的独立校准测量,单独测了把 confidence 读作“答对的概率”时的 ECE。OpenBookQA 上是 0.035,HellaSwag 上是 0.078,合成集合上是 0.18。同一批集合的原始概率分别是 0.024、0.029、0.107。三个集合里 confidence 一侧都更差。
为什么会变差,答案在式子里。K 固定时 c 是 p_max 的单调递增变换,顺序被保留。判别力原样不变,只要把阈值换算过去就行。坏掉的不是信息,是刻度。 K 随问题变化时,就多出一个问题。拉伸的倍率也跟着变。同样是 p_max 0.8,两个选项时变成 0.6,五个选项时变成 0.75。在选项数混杂的工作负载里用单一阈值的那一刻,这就成了问题。
随分布变化的校准
那么 probabilities 那一侧可以信吗。
实际调用 Jev 测过的记录是公开的。Jared Palmer 做的开源复现实现 Kev 的仓库里有 runs/jev-* directory,usage.json 以 "model": "typesafe-ai/jev" 记录着这是经由 Vercel AI Gateway 的真实调用。把六个 jev-* directory 的 usage.json 加起来,2026 年 9 月 18 日和 20 日两天共调用了 5,364 次,输入是 2,418,260 token。下面七个集合中的 scienthoon 是把那位开发者的结果文件转换后导入的,不在这个合计里。
价格确实只按输入计费这一点,可以在别处得到确认。钓鱼基准的作者看了 TypeSafe dashboard 记了下来。两次运行的 456 万 token 中,输入 366 万、输出 90 万,而账单是 $0.15,这个值与只按输入计算的结果吻合。
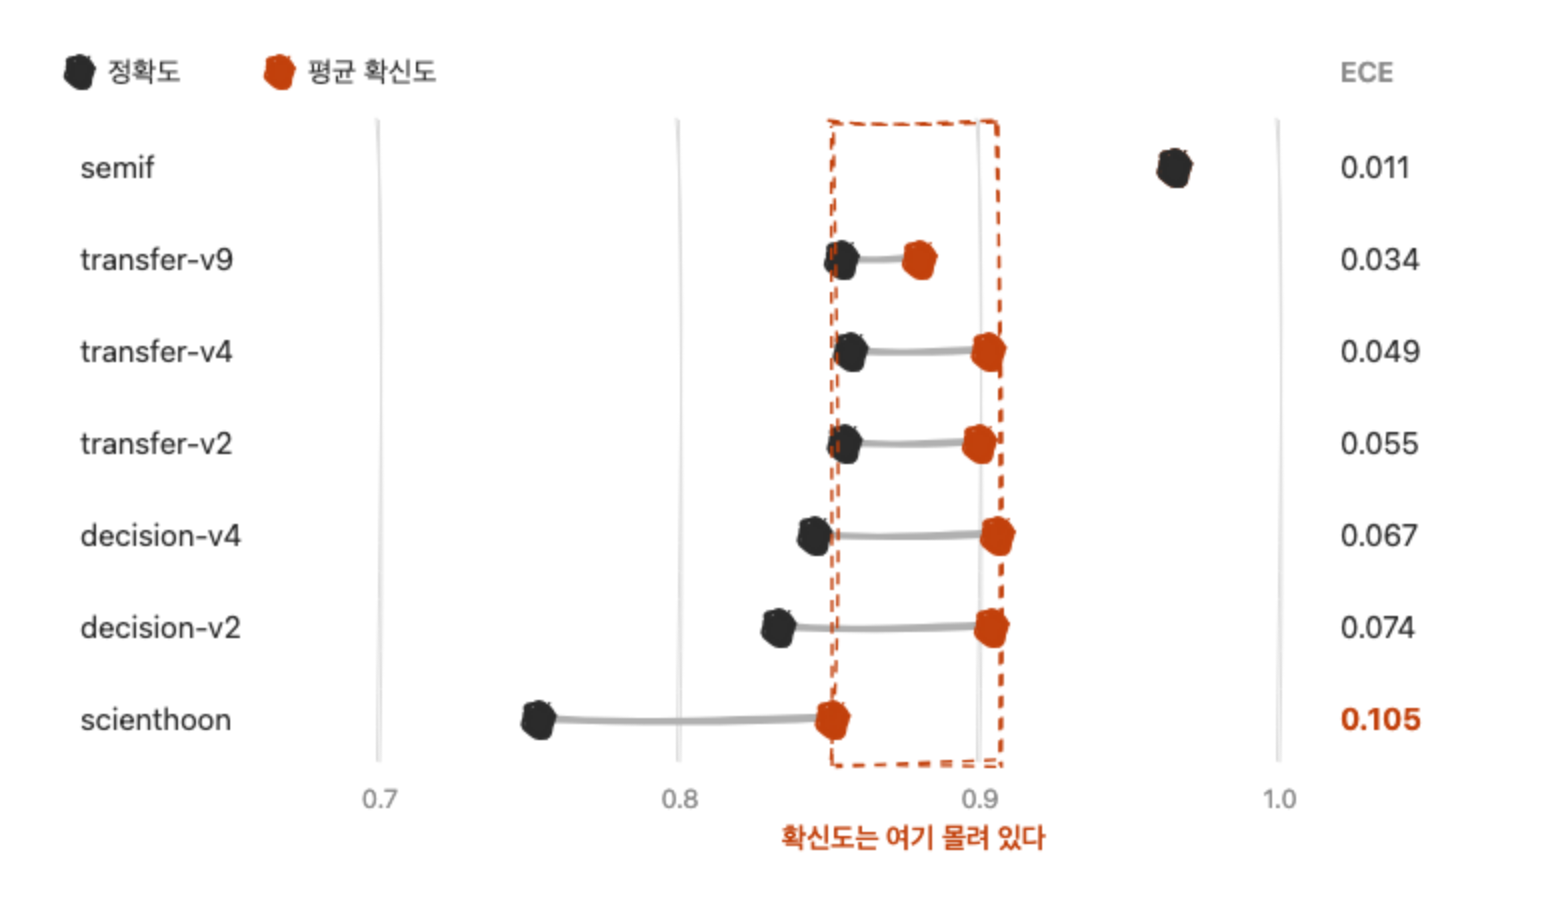
从同一个 directory 的 report.json 里取出七个评估集合的指标,整理出来是这样。下面的确信度不是 confidence 字段,而是 probabilities 的最大值。过度自信是 평균 확신도 − 정확도(平均确信度减准确率),共 5,743 条。删去判断依据的“无法判断”项,用的是将其排除在准确率评分之外的 clean 块的值。
| 评估集合 | n | 准确率 | 平均确信度 | 过度自信 | ECE |
|---|---|---|---|---|---|
| semif | 144 | 0.965 | 0.965 | -0.000 | 0.011 |
| transfer-v9 | 1,046 | 0.854 | 0.880 | +0.026 | 0.034 |
| transfer-v4 | 656 | 0.857 | 0.903 | +0.046 | 0.049 |
| transfer-v2 | 560 | 0.855 | 0.900 | +0.045 | 0.055 |
| decision-v4 | 1,264 | 0.845 | 0.906 | +0.061 | 0.067 |
| decision-v2 | 1,200 | 0.833 | 0.904 | +0.071 | 0.074 |
| scienthoon | 873 | 0.753 | 0.851 | +0.099 | 0.105 |
从中能读出两点。
第一,ECE 变动了将近十倍。 从 0.011 到 0.105。同一个评分器,同一个模型。“已校准”不是模型的性质,而是模型与分布之间的关系。分布一变校准就垮掉,这件事本身早已是已知的结果。这里新的地方在于,在把校准当作训练目标的模型上也出现了同样的形状。
ECE 最大的那个集合的 0.105,比前面看到的 post-RLHF GPT-4 的 0.074 还要大。不过不能把这两个读成排名。任务不同,而且 ECE 是一个会随着区间分成几份、样本挤在哪个区间而变动的估计量,把来自不同评分器的数字放在一起,比较并不成立。
第二,测得的 ECE 几乎全部由过度自信一项解释。 两列之差在七个集合上全都落在 0.002 到 0.011 之间。ECE 是各区间差距的加权平均,不可能小于整体的过度自信,而这个差几乎为 0,意味着各区间偏离的符号都朝一个方向倾斜。不是各区间互相交错抵消的噪声。
为什么会这样,竖着读就看得见。平均确信度除去 semif 之外,六个都挤在 0.851 到 0.906 之间。在同一段区间里,准确率却从 0.753 摆到 0.857,宽度是前者的两倍。确信度即使分布变了也几乎不动,动的只有准确率。剩下的差值就直接是 ECE。
这个性质在实务里怎么显现,另一个基准给出了答案。在 2,000 封钓鱼邮件上以 Claude Haiku 4.5 作对照组的测量中,Jev 的准确率是 62.6%,Haiku 是 81.3%。不过更显眼的是 ECE。仓库报告的 ECE 是 Jev 0.154、Haiku 0.097,而主张审计账本把 Jev 的 P(phishing) 值在 0 到 1 上按 10 个区间重新测算,得到 0.170。无论按哪种读法,把校准当作训练目标的模型,在校准上都输给了用 RLHF 造出来的 LLM。 同一位作者只用一条链接主机列表规则就拿到了 91.6%。
把同一个指标放到多个集合上看,幅度就更清楚。误差预算 5% 下可自动处理的比例,在 scienthoon 集合是 0.486,transfer-v9 是 0.695,semif 是 1.000。Kev 的评分器注明这个值是在样本内选取阈值得到的最大值,并不是部署后的误差保证。不能把其中任何一个当作模型的规格来引用。
音译判别闸门
读别人的基准和在自己的数据上测,是两回事。所以笔者把开头那道闸门实际交给它过了一遍。
笔者还没有 Jev 的 API key。于是改成在本地跑了前面提到的 Kev-9B。 它是在 Qwen3.5-9B-Base 上加了 rank-16 LoRA 和 pointer head 的复现实现,采用 Apache-2.0。下面的数字不是 Jev 的数字。Kev 的训练数据是英语决策任务,在同一位作者的测量里,Kev-9B 即使在英语任务上也不如 Jev。误差预算 5% 的自动化比例是 0.45 到 0.57,而 Jev 是 0.70;MMLU-Pro 是 0.52 对 0.84。而且 TypeSafe 文档也就 Jev 说明了英语是主要训练语言,CJK 并不对等。
评估集合取自本仓库的 18 篇韩语文章。标签的正确答案标准是本仓库一贯把那个词写成哪种形式。也就是说,它不是韩语技术文档社区的共识,而是这个博客的惯例;在两者分歧的词上,模型可能按社区标准是对的,按这个标准却是错的。
- 闸门集合 102 句。 是闸门已经认识的词。把正文里写成英文的
calendar、picker、adapter之类的词改回韩文音译的反事实句子为阳性 23 句,write-post.md明确列为例外的리렌더링(re-rendering)或콜 스택(call stack)实际出现的句子为阴性 79 句。在这里,现行的正则闸门按定义能答对 100%。 - 保留集合 60 句。 是闸门一次都没见过的词。 也就是机器学习里说的 held-out 集合。 把正文里只写英文的
loader、mutation、prefill改成音译的为阳性 30 句,正文里只写韩文的리듀서(reducer)、스냅샷(snapshot)、런타임(runtime)为阴性 30 句。在这里,正则一个阳性都抓不到。
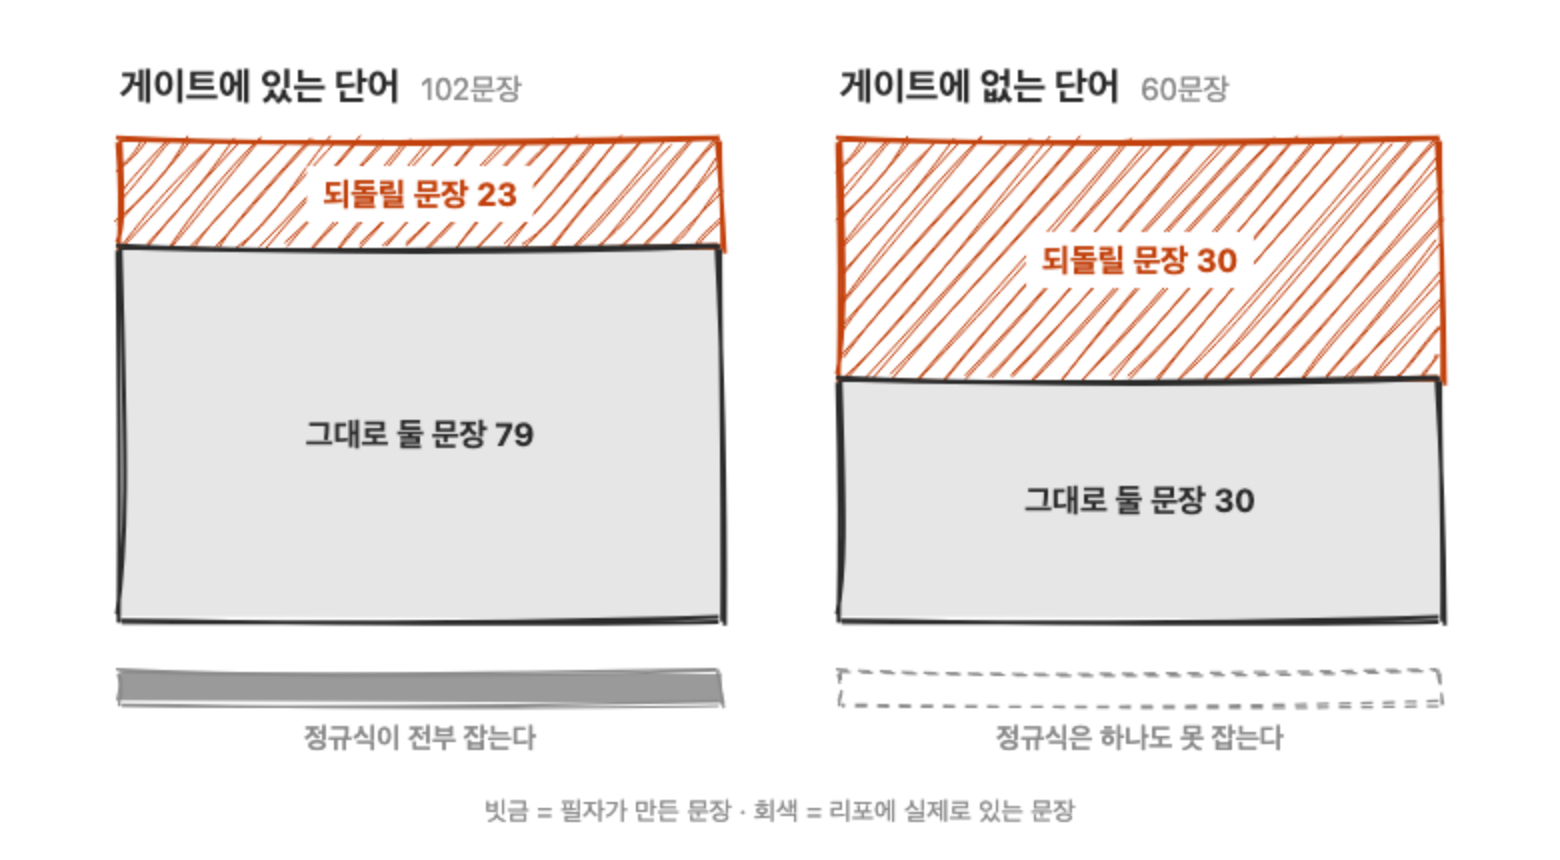
阳性是笔者造出来的反事实句子、阴性是真实句子,这个不对称先说明在前。而且有效样本不是句子数,而是词数。 标签是按词确定的,所以出现同一个词的那些句子并不是独立观测。闸门集合是 24 种,保留集合是 13 种。
下表只统计了问“这个词是否该还原成英文”的那一个 noul 问题。同一次请求里装了四个问题,但其余三个是否定式、Choice 变体,以及没能把标签立好的复合词判定,所以没有混进来。5% 预算自动化比例是指从确信度高的一侧往下切,使切点以上区间的误差不超过 5% 的最大比例。
| 闸门集合 | 保留集合 | |
|---|---|---|
| 句子 / 词 | 102 / 24 种 | 60 / 13 种 |
| 现行正则闸门 | 1.000 | 0.500 |
| Kev-9B 准确率 | 0.225 | 0.500 |
| 按词的准确率 | 6/24 | 7/13 |
| 多数类基线 | 0.775 | 0.500 |
| ECE | 0.664 | 0.336 |
| 平均确信度 | 0.876 | 0.821 |
| 确信度 0.9 以上的比例 | 0.490 | 0.317 |
| 该区间的实际命中 | 0.240 | 0.526 |
| 5% 预算自动化比例 | 0.010 | 0.000 |
多数类基线是不读句子、只押多数那一侧标签时的得分。模型在它之下。
最后一行就是这次实验的答案。在保留集合上,无论把阈值定得多高,能在 5% 误差内自动处理的决策一件都没有。
看预测分布,就知道发生了什么。模型对全部 162 句都答了“该还原”。 37 种词全部如此。阳性全对,阴性全错。所以保留集合的 0.500 不是实力,而是因为集合本身平衡才出来的数字。
与此同时平均确信度是 0.876。在闸门集合上确信度超过 0.9 的占 49%,而那个区间的实际命中是 0.240。
结构性恒等式也没有成立。把“是否该还原”和“是否该保持原样”的概率相加,在闸门集合上平均得到 1.655,102 句全部偏离 1 超过 0.1。
设计上就是如此。两个问题是彼此读不到对方的独立评估,TypeSafe 自己也在 jaggedness 页面上放了 refund 0.72 与 not_refund 0.47 相加得到 1.19 的例子。
实务上卡住的地方在这里。不能把按 Noul 调好的阈值搬到 Choice 上。 同一个判断而结论相左的句子占 14% 到 17%。
如果是问什么都答是的模型,这个结果就毫无意义。笔者先确认了这一点。
| 状态 / 问题 | 问了什么 | 答 |
|---|---|---|
| 韩语 / 韩语 | 这个句子是用英语写的吗? | 0.02 |
| 韩语 / 韩语 | 这个句子在讲菜谱吗? | 0.04 |
| 韩语 / 韩语 | 这个句子是用韩语写的吗? | 0.98 |
| 韩语 / 英语 | Is this sentence written in English? | 0.01 |
| 英语 / 英语 | Is this sentence about software? | 0.96 |
它读韩语,会说“不是”,并且把 0.02 和 0.98 分开。 这不是全局性的迎合偏差。能借此排除的也就到这里为止。闸门问题的措辞本身很差的可能性仍然留着。
把规则放进 state 的结果
那么,把判别所需的知识直接给它会不会不一样呢。TypeSafe 文档推荐的领域适配方式就是这个。不碰权重,把参考资料装进 state 发过去。
笔者把 write-post.md 里已经写好的规则段落一起放进 state,重新跑了一遍。输入从每句 100 token 增加到了 450 token。闸门集合是泄漏。 因为那份参考资料把闸门词和例外词逐个点名列了出来。所以那一侧是用来看“它到底读不读参考资料”的对照组,真正的考试是保留集合。
| 闸门(泄漏) | 闸门 +规则 | 保留 | 保留 +规则 | |
|---|---|---|---|---|
noul 准确率 |
0.225 | 0.676 | 0.500 | 0.500 |
| 按词的准确率 | 6/24 | 7/13 | 5/13 | |
| 阳性答对 | 23/23 | 1/23 | 30/30 | 8/30 |
| 阴性答对 | 0/79 | 68/79 | 0/30 | 22/30 |
| 5% 预算自动化比例 | 0.010 | 0.314 | 0.000 | 0.050 |
| 延迟中位数 | 2,924ms | 6,903ms | 2,908ms | 6,918ms |
延迟是在 M2 Max 上跑的本地推理,和前面看到的 Jev 的 API 延迟不在同一个轴上。这里要看的不是绝对值,而是放进参考资料之后的 2.4 倍。
在平衡的保留集合上,按句子的准确率从 0.500 到 0.500,完全没动。 按词来看反而从 7/13 降到了 5/13。
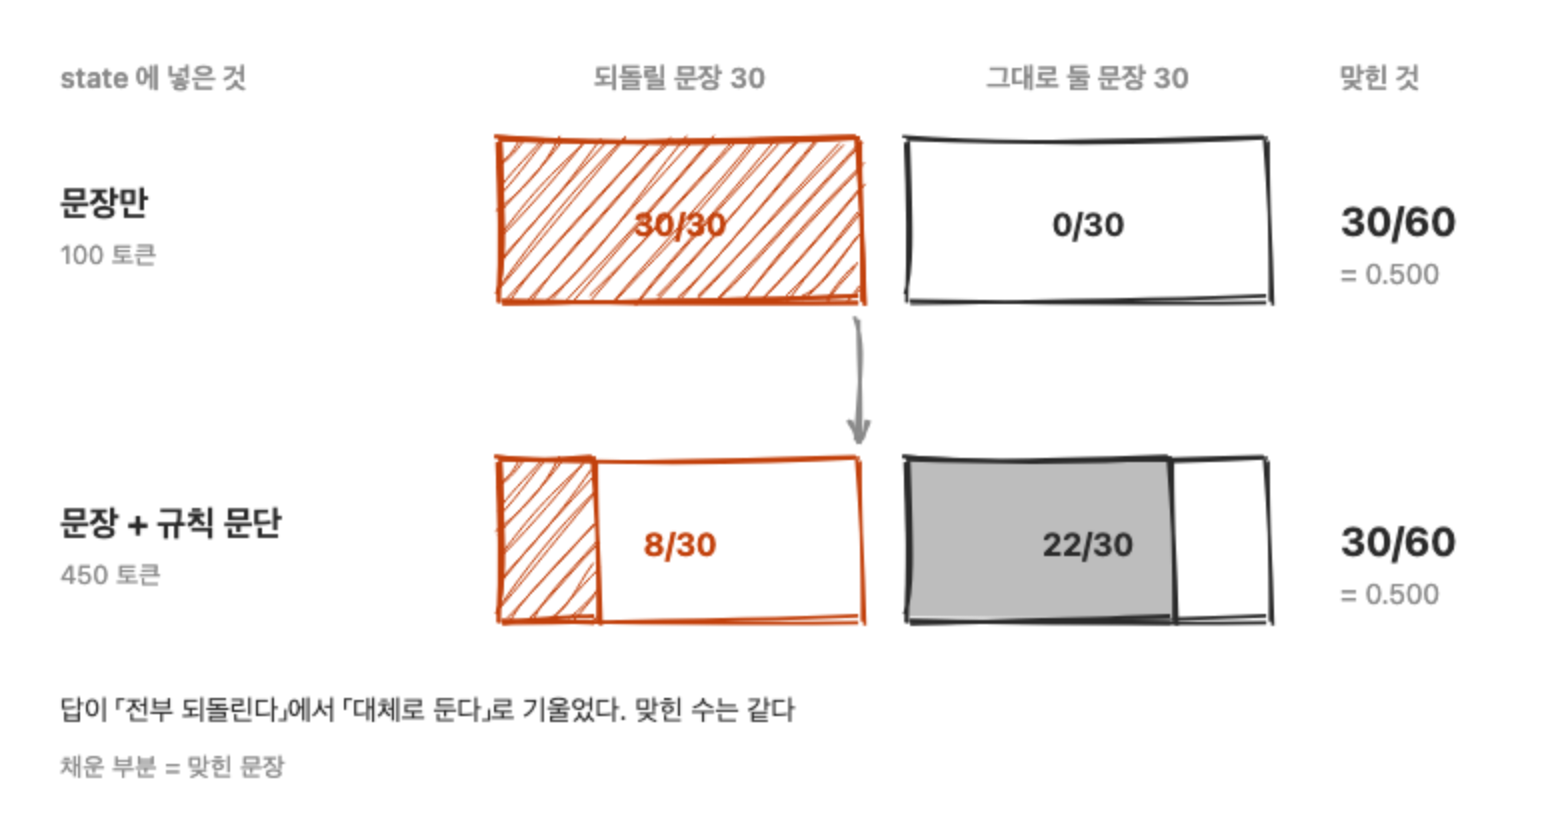
闸门集合从 0.225 到 0.676 并不是实力提升。之前它对 102 句全都说“还原”,给了参考资料之后只对 12 句这样回答。阴性从 0/79 升到了 68/79,但阳性从 23/23 崩到了 1/23。那个集合里阴性以 79 比 23 占多数,所以“大体上保持原样”这个常数自动就能拿到更高的分。它学到的不是区分,而是改变了倾斜。
这并不意味着模型不读句子。同一个词的同一批句子,给了参考资料之后,预测在句子之间散开了。로더(loader)的标准差从 0.096 增加到 0.217,뮤테이션(mutation)从 0.042 增加到 0.236。读是读了,只是分不出来。
而且这个结果也动摇了上一节的解读。如果仅凭一段 state 文本就能把输出整个翻过来,那么第一次运行时的“全都还原”,也可能不是模型的极限,而是问题措辞的不足。本文没能排除这个可能性。
有一点明显变好了。“还原”和“保持原样”的概率之和在保留集合上从 1.508 靠近到了 0.963,大幅偏离 1 的句子从 59 句减到了 18 句。但准确率没有动。 两个问题的概率彼此对得上,和那些概率本身是对的,是两回事。
决策模型的位置
看到这里很容易倾向于得出这类模型整体没用的结论,但把公开的基准并排放在一起看,并非如此。
| 任务 | n | Jev | 比较对象 |
|---|---|---|---|
| 垃圾邮件,分布内 | 18,514 | 98.3% | TF-IDF 回归 98.4% |
| 垃圾邮件,分布外 | 2,876 | 98.6% | TF-IDF 回归 73.0% |
| 钓鱼 | 2,000 | 62.6% | Haiku 4.5 81.3%、规则基线 91.6% |
| rerank 英语 8 种 | 1,617 | nDCG@10 0.692 | Cohere Rerank 4 Pro 0.691 |
只有 rerank 那一行是检索排序质量指标,与其他行的准确率不在同一个轴上。
在分布内,正则或调好的分类器要么赢要么打平。 这和笔者的闸门集合上正则以 1.000 对 0.225 获胜是同一个位置。只要能收集到标签,训练一个小模型更便宜、更快、也更准。那是很早以前就在做的事。
差距是在分布是新的、又没有标签的时候拉开的。 分布外的垃圾邮件上是 98.6% 对 73.0%。调好的分类器在自己没见过的形状面前垮掉,而这一侧撑住了。决策模型的位置,是无法收集数据、打上标签再训练的判断。每次情况都是新的所以收不到标签,判断却要以秒为单位做出的地方。
笔者的音译判别为什么失败,也能用这个框架解释。那个判断需要的不是一般性的推理,而是韩语技术文档里哪种说法已经定型这种特定领域的知识;对一个用英语决策任务训练出来的 9B 复现实现来说,那不是分布外,而是根本不存在的知识。把规则写成文字给它也不管用的原因就在这里。
在 TechCrunch 的报道里,做 Pi harness 的 Earendil 的 CTO Armin Ronacher 这样说。
At the end of the day, it delegates the hallucination problem a little bit to the user.
不是消除了幻觉,而是把判断交给了开发者。TypeSafe 文档也写着,校准是对一批预测才成立的性质,并不保证单个答案是对的;公开发布文章里幻觉率 0% 那根柱子下方的 Nuance 条目写着 "Our number is not empirical"。形式有保证,内容没有。
jevable 上的 194 个项目
在笔者的数据上失败了,于是去看别人把它用在了哪里。jevable.com 是一位叫 Nikunj 的开发者把 X 上出现的 Jev 项目逐个审核后汇集起来的独立策展站。截至 2026 年 9 月 23 日共 194 个,登记日期集中在 9 月 16 日到 20 日之间。其中 152 个是在 9 月 18 日一天之内进来的。那是公开三天之后。
| 类别 | 数量 |
|---|---|
| Games | 39 |
| Developer tools | 34 |
| Productivity | 31 |
| Agents | 19 |
| Experiments | 18 |
| Creative tools | 16 |
| Data & research, Finance, Browser extensions, Robotics, Marketing | 37 |
不按类别,而按“问什么”重新分组,就得到三种形状。下面的数字都是发帖人自己写在帖子里的值。
第一,分类与路由。 给 1,500 封邮件分类,给税务文件分类,19 秒花 $0.12 给 1,891 条竞品广告分类,对一个 PR diff 做 14 项 typed check,从 Android 通知里判别广告,2.9 秒给 26 张建筑图纸分类。和开头的音译闸门是同一种形状。正如前一节的表所说,这是标签每天都在累积的位置,时间一长,用自己的标签训练出来的小分类器会赢或者打平。Jev 的优势在于还没有标签的第一天。
第二,行动选择循环。 接在 Browser Use 上,7 秒花 $0.0039 完成机票搜索的 browser agent;用语音操作 Mac 的 computer use;每当 Mario 死掉就把 VM fork 成四路、挑活下来那一路继续的游戏;每条消息都要为 3D 角色的嘴、眉毛、视线等十个部位做决定的表情引擎。每一步的 action space 都在变,所以收不到标签,而判断要压到秒以下。这正是分布外垃圾邮件上差距被拉开的那个位置。Games 以 39 个成为最大类别,笔者认为原因也在这里。游戏是错了也能回退的行动选择循环。
第三,把概率直接展示给用户的 UI。 不给答案只给判定的 Ask Jev,用概率挑选下一个问题的分支表单 JevForm,用技术深度、戏剧性等六个滑块重新排列 Hacker News 首页的 Upweight。阈值不写进代码,而是由人来读概率,所以本文追究的校准要求在这里最低。
有一点很显眼。194 条说明文里写了成本的有 30 条,写了速度的有 53 条,而写了准确率或基准线的只有 7 条。说明文只收录原帖的开头部分,所以这是下限,但方向是明确的。快和便宜第一天就能知道,对不对却要测了才知道,而测的人很少。那 7 条里有一个是 jevcal。它说大家都在凭感觉挑阈值,于是做成一个工具:放进自己的数据和目标准确率,就返回阈值和可自动处理的比例。这正是把下一节要推荐的步骤原样做成了工具。
画线的步骤
本文的结论是这个。不要把模型返回的概率当作规格来读,而要在自己的数据上亲手测量,再去划线。
测量的步骤是这样。收集一百来条带标签的数据,做一张按概率区间划分的实际命中率表,然后把阈值从上往下降,看切点以上区间的错误率。定好误差预算之后,守得住这个预算的最大覆盖率就是可自动化的比例。笔者的实验里确信度 0.9 以上区间的实际命中是 0.240,这一点用 102 句就显露出来了。
刻度偏了大多是可以修的。 过度自信均匀铺在所有区间上时,一个温度参数就能把大部分对齐。Kev 也是这样把 ECE 从 0.106 降到 0.042 的。问题在于要调那个温度就需要该分布的标签,而生产环境里缺的恰恰是这个。何况温度改变不了概率的顺序,所以可自动化的比例并不会跟着上去。因此比起刻度,顺序更重要;比起 ECE,误差预算覆盖率是更实用的指标。
如果把文档示例里用的 0.9 原样写进代码,这道闸门会悄悄改错 38 处。因为不报错,所以是难以察觉的失败。TypeSafe 文档也在那段示例的正下方写了要用自己的数据试一试。写进代码的,通常不是下面那句话,而是上面那个数字。
就算没有 key,至少测量这一步今天就能做。Kev 以 Apache-2.0 公开着,在笔记本上就能跑。
希望各位数一数,现在运营的服务里只向大模型问是/否的调用有多少个。在把那些调用搬到决策模型之前,建议先测一测搬过去之后该把线划在哪里。笔者守住了这个顺序,才能定下不去动那道闸门。拿到 Jev 的 key 之后打算把同一批集合再跑一遍,那时如果结论变了,也会写下来。
참고 자료
[paper] Lambert 等人,Tulu 3:RLVR 的命名 [repo] themsquared/jev-benchmark,工具调用风险判定