Volver a abrir Sentry
En esta publicación quiero hablar de volver a abrir Sentry, una herramienta que llevo mucho tiempo usando.
En mi empresa he trabajado durante años con monitoreo de errores basado en Sentry. Cuando llega un issue, abrir el stack trace, acotar el alcance con releases y tags y buscar las condiciones de reproducción es un trabajo que hago de memoria. Pero, mirando atrás, las funciones que usaba siempre giraban alrededor de eso. Sabía que existían Logs, Crons, Uptime, los custom spans y el profiling, y aun así nunca los activé.
La razón no era el conocimiento, sino el costo de exploración. Para comprobar si una función encaja con mi problema, tengo que leer y cruzar documentación dispersa, diseñar un experimento, cablear la configuración e interpretar los resultados. Los días en que la respuesta a incidentes apremiaba, no había motivo para pagar ese costo. Desde que empecé a usar Sentry MCP conectado a Claude Code, buena parte de ese costo bajó y mi orden de trabajo cambió. Ahora, antes de activar una función, primero le pregunto a los datos reales de esta cuenta.
Este artículo es el primero de una serie de cuatro sobre observabilidad. Sigue una incidencia que captó la instrumentación de servidor de este blog, registra lo que salió a la luz al volver a abrir esos datos con MCP y da un veredicto sobre dónde usar cada función. La serie empieza en el servidor, pasa por el renderizado, la CPU y la memoria dentro del navegador y termina en los datos de búsqueda.
Un fallo dentro de una respuesta exitosa
Conecté Sentry a este blog en agosto de 2026, solo en el servidor. La decisión de dejar fuera el SDK del navegador la trato en la segunda parte; aquí solo veo qué intentaba capturar en el servidor. El objetivo era uno. El servidor llama a la Google Analytics Data API para dibujar las estadísticas de visitantes, y si esa llamada fallaba, no tenía forma de enterarme.
Al principio pensé que bastaría con poner un reporte en el catch de la ruta de la API de estadísticas. Pero cuando lo hice fallar en un build de producción local con una clave de cuenta de servicio inválida, el error nunca llegó a la ruta. El catch del módulo de estadísticas, una capa más abajo, lo atrapaba antes y devolvía un valor por defecto, y la respuesta era esta.
HTTP 200 OK
{ "slug": "/260610", "views": 0 }
El visitante ve las estadísticas en 0 y el servidor responde que todo está bien. Según la tasa de errores de la ruta, no pasó nada. El artículo sobre Gray Failure que investigadores de Microsoft Research y Microsoft Azure presentaron en HotOS 2017 define así el núcleo de este estado.
También sostenemos que una característica clave de la gray failure es la differential observability: los detectores de fallos del sistema pueden no notar los problemas incluso cuando las aplicaciones se ven afectadas por ellos.
We also argue that a key feature of gray failure is differential observability: that the system's failure detectors may not notice problems even when applications are afflicted by them.
Así que bajé el punto de instrumentación de la ruta a cuatro catch del módulo de estadísticas. El fallback en sí es la decisión correcta para proteger la experiencia del visitante, así que lo dejé tal cual y reporté por separado solo el hecho de que el fallback se ejecutó. En ese momento distinguía los cuatro lugares con un único tag, gaQuery.
// 2026-08 당시
Sentry.captureException(error, { tags: { gaQuery: 'stats' } })
En el código actual, el commit f348d4c del 17 de agosto reunió el reporte en un único captureServerException y, para que la cardinalidad no creciera, limitó las claves de tag a tres: locale, routeKind y operation.
// 현재 src/lib/google-analytics.ts
captureServerException(error, { routeKind: 'analytics', operation: 'stats' })
Hoy el módulo de estadísticas reporta desde tres catch y una ruta de credenciales ausentes. (La ruta popular la eliminé en septiembre, por razones que contaré más adelante) La ruta de credenciales no pasa por un catch y devuelve directamente el fallback, y por una lógica que suma un valor base de 10 a 40 al número de visitantes del día, en pantalla aparece una cifra verosímil. Aunque falten por completo las variables de entorno, es una ruta que el ojo humano no ve, así que hice que reportara solo una vez por proceso.
338 segundos tras un timeout de 5 segundos
Después de bajar la instrumentación, el issue de producción que llegó, JIHOON-BLOG-2, era una llamada a GA que falló con DEADLINE_EXCEEDED tras 65,877 segundos. La respuesta seguía siendo 200. La causa estaba en el archivo de configuración de la biblioteca cliente de GA. El timeout RPC por defecto de runReport es timeout_millis: 60000, y mi código no pasaba timeout en ninguno de sus cinco puntos de llamada. Es exactamente el error contra el que advierte desde la primera línea, con "Always set a deadline", el artículo sobre deadlines del blog oficial de gRPC escrito por Gráinne Sheerin, de Google SRE.
El commit de corrección 927c85b hizo que todas las llamadas pasaran un timeout de 5 segundos. Al reproducirlo con un servidor TCP local que nunca responde, el resultado coincidió con la explicación.
| Condición | Tiempo transcurrido | Mensaje de error |
|---|---|---|
| Sin timeout | 60,04 s | Deadline exceeded after 60.000s |
timeout: 5000 |
5,00 s | Deadline exceeded after 5.000s |
(El número 5 no tiene fundamento. No medí la distribución de respuestas normales de GA. Pero en este blog el número de visitantes es información complementaria, así que consideré que rendirse rápido era mejor dirección que esperar mucho) Ese issue ya no aparece en la lista de issues. El valor de 65,877 segundos es un registro que quedó en el mensaje del commit y en la documentación del repositorio.
Ahí debería haber terminado, pero en el release donde se desplegó la corrección empezó a acumularse un nuevo issue, JIHOON-BLOG-8. El mensaje era Deadline exceeded after 338.655s, y en el stack seguía estando el wrapper de timeout de google-gax. La configuración llegaba al código, pero el tiempo reportado era casi 70 veces el configurado.
Hacia el 18 de agosto saqué los 100 eventos más recientes de ese momento y dibujé la distribución.
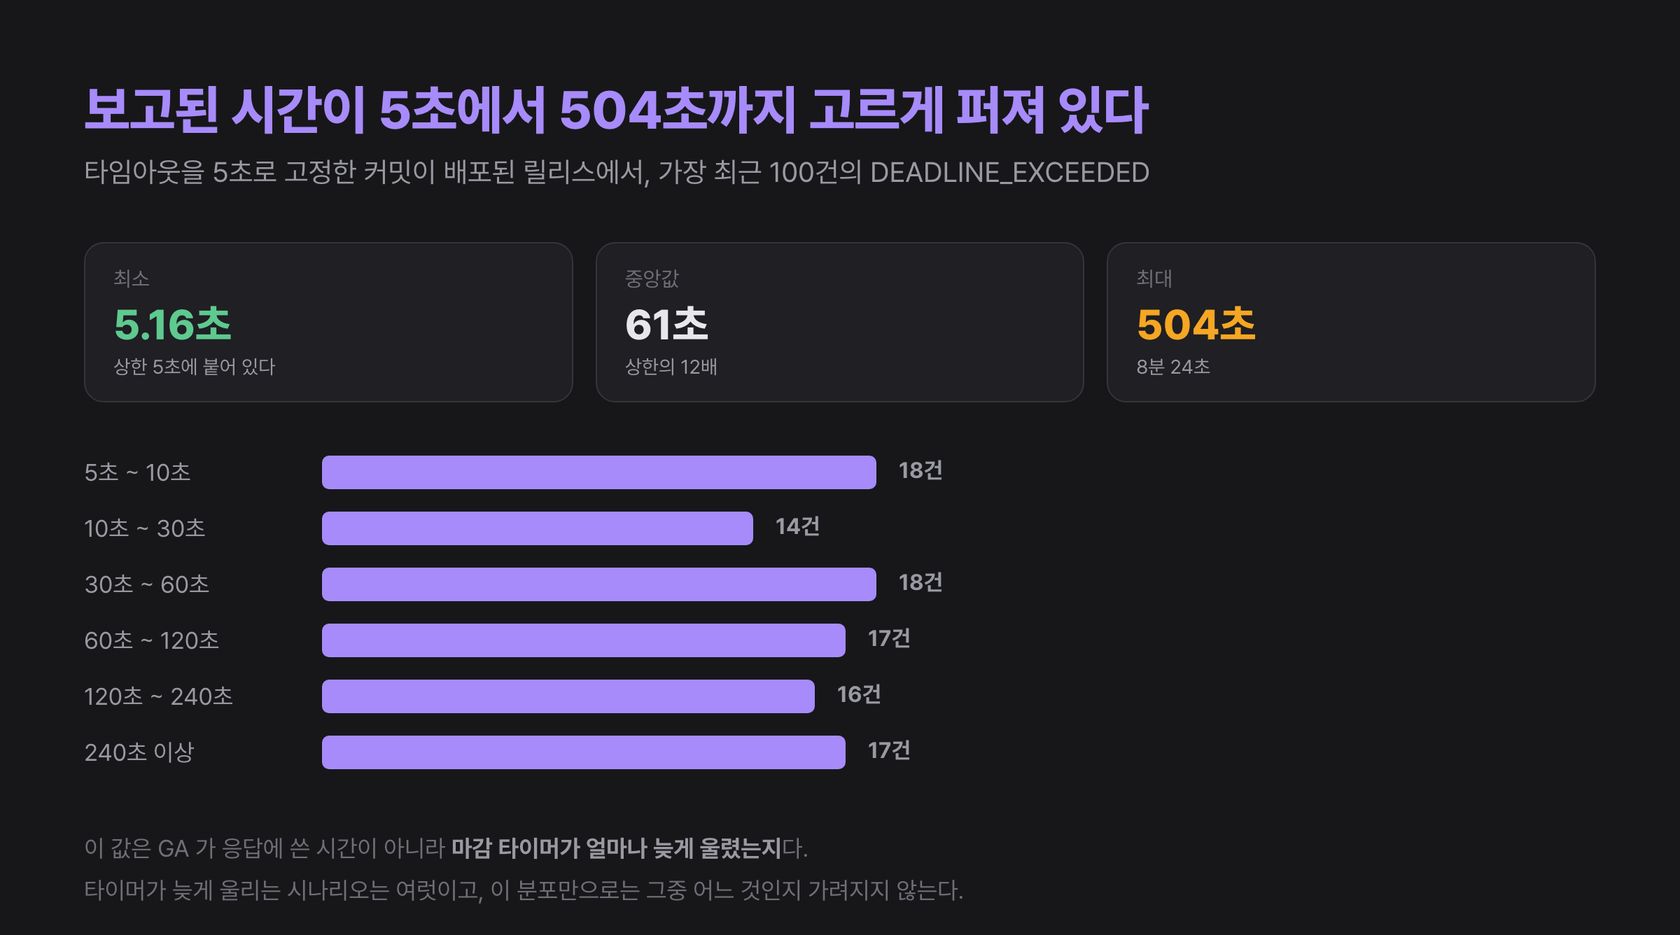
El mínimo era 5,16 segundos, pegado a la configuración; la mediana, 61 segundos, y el máximo, 504 segundos. Los valores no se concentraban en ningún tramo. (Este gráfico ya no se puede volver a dibujar. La razón aparece en la siguiente sección) El tag solo tenía dos valores, stats y popular, y casi siempre llegaban en pareja. Lo que comparten ambas rutas es que son rutas de revalidación detrás de un unstable_cache de una hora. page y pages, que llaman a GA en cada petición, no aparecieron ni una vez.
Así que formulé una hipótesis. En una función serverless, el entorno de ejecución puede congelarse tras enviar la respuesta hasta la siguiente invocación. Si durante ese tiempo los temporizadores también se detienen y solo se disparan al despertar, lo que se registra no es el tiempo realmente esperado, sino un wall-clock time (tiempo real transcurrido) que incluye el periodo congelado. Aun así, que la distribución no contradiga una hipótesis no es lo mismo que la respalde. La misma forma aparecería si un trabajo pesado hubiera estado acaparando el event loop.
Los datos, reabiertos con MCP
Mientras escribía este artículo, el 16 de septiembre de 2026, volví a consultar los mismos datos con Sentry MCP. Quería comprobar si lo que creía arreglado seguía estándolo, y lo que antes buscaba saltando entre pantallas de issues en el dashboard salió en unos pocos intercambios. A continuación separo los hechos confirmados con la consulta de las inferencias que saqué de ellos.
Por qué dejaron de ocurrir
La última ocurrencia de JIHOON-BLOG-8 fue el 18 de agosto a las 13:45 UTC, y desde entonces hay 0. Viendo solo el gráfico parece que el problema desapareció, pero yo nunca verifiqué la hipótesis ni lo arreglé. Ese mismo día, el commit 417d3b4 quitó de la portada las secciones de estadísticas de visitantes y de publicaciones populares como parte de la reforma multilingüe, y las pantallas que llamaban a stats y popular eran exactamente esas dos. El mensaje del commit 5752e09, que en septiembre eliminó la ruta de publicaciones populares que quedaba, lo describe así: "la razón directa por la que se detuvieron los eventos es que desaparecieron los puntos de llamada, no el timeout de 5 segundos". Sin embargo, al alinear las horas, ese commit se subió a main a las 22:07 UTC, más de ocho horas después del último evento. Con apenas unos diez eventos al día, un hueco de ocho horas no es raro en sí, y tampoco contradice que no haya habido ninguna ocurrencia desde el despliegue. Aun así, las horas por sí solas no permiten afirmar que quitar los puntos de llamada fue lo que lo detuvo, así que leo ese mensaje solo como la explicación más probable.
Que un issue esté resolved no prueba que se haya identificado la causa. Hay tres caminos para que las ocurrencias lleguen a 0: que se haya arreglado de verdad, que nadie pase ya por esa ruta o que la instrumentación haya desaparecido. La señal de error por sí sola no distingue entre los tres.
5 minutos y 39 segundos en los breadcrumbs
Saqué con MCP los breadcrumbs del último evento. Los breadcrumbs suelen asociarse a los clics y la navegación en el navegador, pero el SDK de servidor Node de este blog también registraba automáticamente las peticiones http y la salida de console.
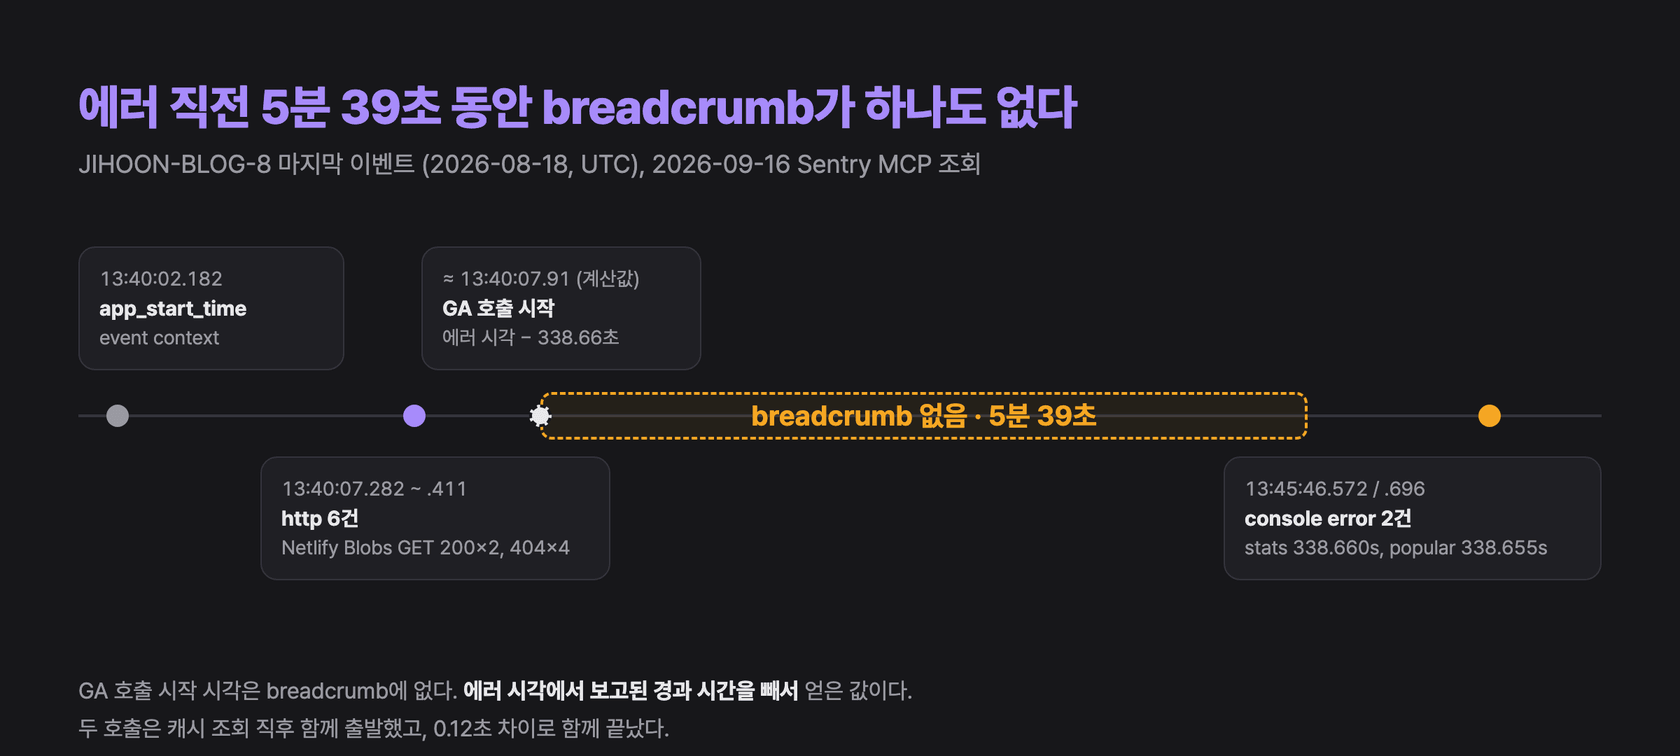
Los hechos son estos. La función empezó a las 13:40:02, y a las 13:40:07 hubo 6 consultas a la caché de Netlify Blobs. El siguiente registro son dos console error a las 13:45:46. Restando hacia atrás los 338,66 segundos reportados, la llamada a GA salió 0,5 segundos después de las consultas a la caché y unos 6 segundos después del cold start.
Lo que se puede extraer de aquí es limitado. Un temporizador que debía saltar a los 5 segundos saltó a los 5 minutos y 39 segundos, y entre medias esta petición no dejó ningún registro. No contradice la hipótesis del congelamiento, pero tampoco descarta la de un event loop acaparado. Aun así, apareció un dato que antes no tenía: la hora de inicio, que muestra que el fallo fue una llamada que salió de la revalidación de caché justo después de un cold start.
Eventos que borró la retención
El contador de ocurrencias del issue JIHOON-BLOG-8 marca 144. Si se agrega el mismo issue en el dataset errors a 90 días, salen solo 10 según una consulta del 16 de septiembre de 2026 a las 14:26 UTC. Esos 10 restantes van del 17 de agosto a las 15:03 al 18 a las 13:45 UTC, casi exactamente dentro de los 30 días previos a la consulta. Una consulta del mismo día a las 08:45 UTC devolvió 14, así que este número baja cada vez que se consulta.
Como inferencia, parece que el periodo de retención de eventos es de 30 días, así que los eventos antiguos se borraron y solo quedó el contador del issue. La página de precios de Sentry indica 30 días de consulta para Developer, el plan gratuito. Sin embargo, no verifiqué el tipo de plan de esta cuenta ni cómo se mantiene el contador. Lo seguro es el resultado. La distribución de 100 eventos de arriba no se puede volver a sacar, y ningún dato que no se guardó puede restaurarse con ninguna herramienta.
Un trace con cero spans
Al abrir el trace con el trace_id del mismo evento, hay 0 spans. El evento lleva client_sample_rate: 0.1. Pudo quedar fuera del muestreo del 10% o pudo superar el periodo de retención de spans, y no pude determinar cuál de las dos.
Agrupando por dominio los spans http.client de los últimos 30 días, tampoco apareció el dominio de la API de GA. La mayoría son consultas a Netlify Blobs. La explicación más probable es que en ese periodo casi no hubo llamadas a GA (la sección de estadísticas de la portada ya se había quitado). Todavía no comprobé si la instrumentación automática captura las llamadas gRPC como spans. Como nota, el count() de esta agregación es un valor extrapolado ponderado por el inverso del muestreo, pero la respuesta de MCP no traía esa advertencia. No leer el número como cantidad de peticiones sigue siendo tarea de una persona.
Verificación local mezclada con producción
JIHOON-BLOG-B, abierto el 16 de septiembre, es Google Analytics credentials missing: GA_PROPERTY_ID. Al abrir el evento, la URL era http://localhost:3117/api/analytics, el navegador era curl 8.7.1 y el nombre del servidor era mi MacBook. Y sin embargo el environment era production.
Es un evento que se generó cuando seguí el procedimiento de verificación local de la documentación del repositorio (pnpm build y luego pnpm start). src/lib/sentry-options.ts, si no hay SENTRY_ENVIRONMENT, determina el entorno a partir del CONTEXT de Netlify. Es un mecanismo creado para separar los Deploy Previews de producción, pero en local, donde no existe ninguno de los dos, no pasa ningún valor de entorno, y el evento terminó marcado como production. Bloqueó las previews, pero no el entorno local. Si configuro alertas basadas en production en este estado, mis experimentos harán sonar las alertas.
Por eso añadí SENTRY_ENVIRONMENT=local al comando de verificación de la documentación del repositorio. La razón por la que no cambié el valor por defecto en el código es que todavía no confirmé que CONTEXT sea siempre visible en el runtime de funciones de Netlify. Si pongo local como valor por defecto sin confirmarlo, esta vez los eventos de producción podrían esconderse bajo local.
Qué usar y dónde
Con el mismo método, revisé también a partir de los datos las funciones que no había activado. En los últimos 30 días había 0 logs, 0 profiles, 0 replays, 0 cron monitors y 0 uptime monitors. En lugar de leer los archivos de configuración y escribir "no está activado", confirmé que "es 0". La tabla de abajo resume el estado actual de cada función, revisado de nuevo con la documentación oficial y los changelogs el 16 de septiembre de 2026.
| Función | Pregunta que responde | Requisito | Costo | Veredicto para este blog |
|---|---|---|---|---|
| Issues y grouping | ¿Estos eventos son un mismo incidente? | SDK, source maps | Cuota de errores | En uso |
| Crons | ¿La tarea programada se ejecutó a tiempo? | Envío de check-ins | 1 incluido, los adicionales con PAYG en planes de pago | Activar |
| Uptime | ¿La URL da 2xx desde fuera? | Ninguno | 1 incluido, los adicionales con PAYG en planes de pago | Considerar como apoyo |
| Alerts | ¿Cuándo hay que despertar a alguien? | Separar environment | Sin cargo propio en la tarifa | Si ocurrió, no un umbral de cantidad |
| Logs | ¿Cuándo y cuánto se ejecutó el fallback? | Configuración del SDK | 5GB incluidos | Candidato para llamadas a GA |
| Application Metrics | ¿Cuál es la distribución sin depender del muestreo? | Versión compatible del SDK de JS | 5GB incluidos | Candidato para llamadas a GA |
| custom span | ¿Qué tramo de la petición fue lento? | tracing | Cuota de spans, muestreo del 10% | Candidato |
| Session Replay | ¿Qué vio el usuario? | SDK del navegador | Bundle, cuota de replays | Desactivado (parte 2) |
| User Feedback | ¿Qué dice el usuario que está mal? | SDK del navegador | Bundle | Desactivado |
| Profiling del navegador | ¿Qué función de JS bloqueó el hilo principal? | beta, Chromium, cabeceras | Horas de UI profile | Se decide en la parte 3 |
| Seer | ¿Cuál es la causa y la corrección de este issue? | Integración con GitHub/GitLab | $40/mes por colaborador activo | No lo ejecuté |
| Sentry MCP | ¿Cómo consultar datos desde el editor? | Conexión OAuth | Tokens del agente | En uso |
| Agent Tracing | Rastreo de llamadas a LLM y ejecución de tools | Integración con AI SDK | Cuota de spans | No aplica |
Lo que voy a activar: Crons
Lo primero que voy a activar es Crons. Este blog recolecta datos de Search Console todos los lunes con GitHub Actions, y si alguna semana esa tarea deja de ejecutarse en silencio, no se produce ni siquiera un error. Porque no es un fallo, sino la ausencia de un evento esperado. Tal como indica la documentación de Crons de Sentry CLI, si se envuelve el comando existente con la forma sentry-cli monitors run --schedule "<expected schedule>" <monitor-slug> -- <command>, el inicio y el fin se envían como check-ins, y la autenticación se hace con el DSN del proyecto. Según la documentación de precios, todos los planes incluyen un cron monitor y los adicionales solo se pueden comprar con el presupuesto PAYG de un plan de pago, pero para este uso basta con uno.
Uptime ofrece un contraste claro. Es una función que golpea periódicamente una URL desde fuera y, por defecto, da por buena cualquier respuesta 2xx, así que con la configuración por defecto no puede detectar el fallo dentro de una respuesta 200 que vimos antes. Con Verification, disponible para el programa Early Adopter, se puede comprobar incluso el cuerpo JSON, pero en este blog seguiría sirviendo de poco. La mayoría de los fallos salieron de la ruta de revalidación de caché y no de peticiones de visitantes, y ya ningún cliente llama a la ruta de la API de estadísticas. Tiene sentido como apoyo para cuando todo el sitio se cae, pero está en otra capa respecto de la incidencia que este blog vivió realmente.
Logs y Metrics para las llamadas a GA
Hay una razón por la que los eventos de error no bastan para las llamadas a GA. Como unstable_cache guarda en caché incluso los resultados fallidos durante una hora, los eventos de error de las rutas detrás de la caché son como máximo uno por hora. Leer el número de eventos como alcance del impacto lleva a subestimarlo sistemáticamente. Y, como vimos en la sección anterior, los eventos antiguos desaparecen y no se pudo volver a dibujar la distribución.
La documentación de breadcrumbs de Sentry para Next.js recomienda desde el principio usar Logs en lugar de breadcrumbs manuales. Logs pasó a GA en septiembre de 2025 y es adecuado para registrar cada ejecución del fallback junto con su tiempo transcurrido. Si el objetivo es la distribución en sí, Application Metrics, en GA desde mayo de 2026, es más directo. La documentación de span metrics también remite a Application Metrics para agregaciones que no se ven afectadas por el muestreo de traces. Los custom spans sirven para ver tramos dentro de una petición, pero al ser una muestra del 10% se pierden los fallos poco frecuentes. Todavía no activé ninguno de los tres, y si lo hago, empezaría mirando la distribución en Metrics.
Por la misma razón, no pongo alertas sobre cantidades. Un umbral de "N o más" sobre eventos aplastados a como mucho uno por hora se queda en silencio mientras subestima el impacto. Por eso el veredicto de este blog es si ocurrió o no. My Philosophy on Alerting, de Rob Ewaschuk, recomienda alertar sobre los síntomas que sufre el usuario y no sobre las causas, pero ese principio parte de la premisa de que el síntoma aparece en algún lado. En este blog el fallo queda oculto tras una respuesta 200 y un 0, así que solo al instrumentar el hecho de que se ejecutó el fallback aparece un síntoma sobre el que alertar.
Funciones que requieren el SDK del navegador
Session Replay y User Feedback dan por hecho el SDK del navegador. Este blog decidió no incluir ese SDK, así que el veredicto actual es "desactivado", y el fundamento del costo de bundle lo trato en la segunda parte. El profiling del navegador también necesita el SDK, además está en beta y trae varias condiciones; qué muestran realmente esas condiciones lo analizo en la tercera parte.
Funciones que no ejecuté
Según la documentación de precios, Seer es un complemento de pago que, además de una suscripción, cuesta $40 al mes por colaborador activo. Esta vez evalué ejecutarlo sobre el issue InvariantError interno de Next.js abierto el 11 de septiembre (JIHOON-BLOG-A), pero no lo hice porque requiere esa suscripción. No comprobé si esta cuenta la tiene. Por eso este artículo no contiene experiencia de primera mano con Seer. Agent Tracing pasó a GA el 11 de septiembre de 2026. Es un punto en el que es fácil equivocarse y escribir que está en beta si uno se apoya en la memoria de un modelo o en artículos antiguos, pero este blog no tiene rutas de llamadas a LLM, así que no aplica.
Lo que la IA redujo y lo que no
Los costos que la IA redujo en este trabajo son claros. Reunir condiciones desde documentación dispersa (si el profiling del navegador está en beta, las cabeceras, las restricciones de navegador), aprender la sintaxis de consultas para ir cambiando el group by, el cálculo de restar y sumar marcas de tiempo de breadcrumbs y el borrador de la tabla de funciones: todo se resolvió en unos pocos intercambios. Por ejemplo, la línea de tiempo de breadcrumbs salió de una sola llamada a get_issue_breadcrumbs, y confirmar que no había monitores llevó dos llamadas, find_monitors y find_uptime_monitors. Al bajar la barrera de la exploración, fue posible preguntar primero "qué dicen los datos actuales" antes de decidir "si lo activo o no".
Lo que no redujo es igual de claro.
- Datos que no se guardaron. De los 144 eventos, 134 (a las 14:26 UTC del 16 de septiembre) desaparecieron, y los spans que quedaron fuera de la muestra nunca existieron. Un agente no puede restaurar datos que no existen.
- Experimentos que requieren un despliegue. Si las llamadas gRPC se capturan como spans, o si se puede distinguir el congelamiento de un event loop acaparado, solo se sabe añadiendo instrumentación de verdad y desplegando.
- Las condiciones de interpretación. Ni la advertencia sobre los valores extrapolados ni el hecho de que un evento local quedara marcado como production aparecieron en las respuestas. Me di cuenta porque leí yo mismo la URL y el nombre del servidor del evento.
- El desfase entre fechas y herramientas. Con funciones como Agent Tracing, cuyo estado cambió cinco días antes, tuve que abrir el changelog para confirmarlo. Las herramientas de MCP también van por detrás del producto. Al poner
ORen una búsqueda de issues devolvió 400, y la herramienta de consulta de reglas de alerta devolvió 410This API no longer exists. - Qué considerar un fallo. Como antes existió la decisión de definir como fallo una respuesta 200 con estadísticas en 0 y bajar el punto de instrumentación, quedaron eventos que volver a abrir.
Para terminar
En resumen, la razón por la que dejé sin activar la mayoría de las funciones de Sentry no era desconocimiento, sino el costo de comprobarlas. La IA bajó mucho ese costo, y gracias a eso mi orden cambió: antes de activar funciones, primero le pregunto a los datos de esta cuenta. Los datos que reabrí así mostraron, antes que cualquier función nueva, algunos hechos incómodos. La incidencia que creía arreglada solo se detuvo sin que nadie la arreglara, la distribución de entonces ya no se puede dibujar porque superó el periodo de retención, y mi verificación local se estaba mezclando con los issues de production.
Por eso los próximos pasos de este blog no los decidió una lista de funciones, sino los huecos. Poner Crons en la recolección semanal, elegir para las llamadas a GA señales que dependan menos de la retención y el muestreo, y empezar por corregir el nombre del entorno local. Ojalá quienes leen este artículo piensen también en las funciones que nunca activaron en una herramienta que llevan mucho tiempo usando. Si esa función de verdad no hacía falta, o si simplemente comprobarlo salía caro, es algo que ahora se le puede preguntar directamente a los datos.
El próximo artículo pasa al lugar del SDK de navegador que este blog decidió no instalar y, en Observabilidad del navegador, mira cómo ver lo que ocurre en la pantalla del visitante.