システム観測
今回は、システム観測について書いてみたい。
私は会社でSentryベースのエラー監視を長く扱ってきた。イシューが上がればstack traceを開き、releaseとタグで範囲を絞り、再現条件を探す作業には慣れている。ところが肝心のこのブログにはエラー監視がなく、この8月になってようやくサーバー専用構成でSentryを取り付けた。そして取り付けた途端に、その計装が実際の障害をひとつ捕まえた。この記事の後半は、その障害を調査し、直したと信じ、測り直すことでその信念が間違っていたと確認した記録だ。
ブラウザ観測では、ブラウザがネットワーク、レンダリング、ユーザー入力をどんなデータとして残すのかを見た。しかしブラウザで遅いリクエストをひとつ見つけても、問題は終わらない。そのリクエストがCDNで遅かったのか、APIサーバーで待たされたのか、データベース呼び出しで詰まったのか、失敗を捕まえてデフォルト値を返したのかまで、たどる必要がある。
この記事は、ひとつのエラーイベントから出発し、各シグナルが前のシグナルでは答えられなかった質問をどう補うのかをたどる。breadcrumbで直前の時間を復元し、traceとmetricで経路と影響範囲を探し、profileとReplayで実行コストと画面の文脈を確認する。最後には、発生しなかった出来事と成功レスポンスの中の失敗まで含めて、何を失敗として計装するのかへと質問を広げる。私が経験した障害は、ちょうどその二つのカテゴリーにまたがっていた。
フロントエンドエンジニアにとって、この境界はますます曖昧になっている。Reactコンポーネントで始まったリクエストが、Server Component、route handler、外部API、queueとbackground jobへとつながっていく。画面に現れた症状はブラウザにあるが、原因はシステムの別の層にあるかもしれない。
かつてこの領域に入るには、各サーバーのログ形式と運用ツールをまず知る必要があった。今はSentryのような製品でエラーと関連するtrace、profile、replayの間を行き来でき、OpenTelemetryは異なるツール同士がシグナルをやり取りするための共通規約を提供する。
とはいえ、観測が自動で完成するわけではない。どのシグナルを残すのか、どの識別子でつなぐのか、何を失敗と呼ぶのかは、システムを作った人が決めなければならない。
エラー一件の文脈
最も馴染みのある出発点はエラーイベントだ。例外が発生したときにメッセージとstack traceを送れば、どのコードで失敗したのかが分かる。しかし実際にデバッグに必要なのは、例外オブジェクトひとつよりも、その周辺の文脈だ。
SentryのIssue Detailsドキュメントを見ると、ひとつのイベントにstack traceだけでなくbreadcrumb、tag、context、release、trace、replay、attachmentが一緒に付くことがある。各要素が答える質問は異なる。
| 情報 | 答える質問 |
|---|---|
| stack trace | どのコード経路で例外が発生したのか |
| source map | デプロイされたバンドル位置を元ソースのファイルと行に復元できるか |
| breadcrumb | 例外までにどんなリクエストとユーザー行動があったのか |
| tag | どのブラウザ、release、route、機能で繰り返されるのか |
| context | そのイベントを理解するのに必要な構造化された値は何か |
| release・commit | どのデプロイで初めて現れ、どの変更に近いのか |
| trace | 同じリクエストフローの別サービスとspanでは何が起きていたのか |
| replay | ユーザーが画面で実際にどんな状態を経たのか |
この区分で重要なのは検索可能性だ。SentryのtagはUIで検索とフィルターに使うよう設計されたkey-valueであり、contextは構造化された値をイベント詳細で読むための領域で、UIフィルターの対象ではない。すべてをcontextに入れればイベント一件は豊かになるが、「どの顧客タイプで増えたのか」のような繰り返しの質問に答えにくくなる。
逆にすべての値をtagとして送れば、cardinalityと保存コストが膨らむ。メール、完全なURL、任意のエラーメッセージのように値の種類が際限なく増える属性は、tagには向かない。計装の設計は情報を付ける仕事であると同時に、どの質問を繰り返し検索するのかを決める仕事でもある。後で扱う私の調査でも、決定的な役割を果たしたのはstack traceではなく、ついでのように付けておいたタグひとつだった。
サーバー専用で取り付けた計装
このブログのSentryはサーバー専用だ。ブラウザSDKの初期化ファイルを置いていない。ブラウザ計装が増やすclientバンドルのコストを払わないことにしたからで、導入の目的はサーバーで静かに失敗する呼び出しを捕まえることであり、その部分は実質タダだった。だから捕まるものと捕まらないものが分かれる。route handlerとサーバーコンポーネントのエラー、そしてサーバーで実行されるGoogle Analytics照会の失敗は捕まる。クライアントコンポーネントのイベントハンドラーやハイドレーション不一致のように、ブラウザでだけ起きるエラーは捕まらない。
この構成で、私が自分で確かめておきたかったことが二つあった。
ひとつは自動フックの範囲だ。Next.jsのonRequestErrorフックを配線しておけば、ハンドリングしていないrouteのエラーもcaptureExceptionを直接呼ばずに捕まる。Deploy Previewにわざと例外を投げる一時的なrouteを上げて確認したところ、イベントにはauto.function.nextjs.on_request_errorというmechanismが刻まれて届いた。
もうひとつはソースマップだ。適用前のプロダクションイベントのculpritは、y([root-of-the-server]__468aa3ae._)のように難読化されたバンドル位置だった。ソースマップをアップロードした後は、同じ種類のイベントがsrc/...のパスと行番号、周辺のソースコードまで解決された。表の二行目が答える質問が実際に分かれる地点だ。
ここでひとつ脇道を記しておく。アップロードした後は、ビルド成果物から.mapファイルを消す必要があった。Turbopackが作るサーバーソースマップは57MBで、サーバーJS(15MB)より大きく、そのままにするとデプロイ関数のバンドルに全部積まれてしまうからだ。ちょうどアップロード後にソースマップを削除してくれるdeleteSourcemapsAfterUploadオプションがあったのでオンにしたのだが、実測してみるとアップロード直後にもサーバーの.mapは57MBそのまま残っていた。そのオプションは.next/staticだけを消し、肝心の容量を占める.next/serverには触れていなかった。結局、削除対象のパスを直接指定する方式に変え、同じ理由でアップロードのログも常時オフにせず条件付きで残すことにした。ログを切っておくと、トークンの期限切れでアップロードが丸ごと失敗しても、次に読めないstack traceを見るまで誰も気づかない。ドキュメントを読んでオプションをオンにすることと、そのオプションが期待した仕事をしたか確認することは、別の仕事だ。
グループと原因の違い
Sentryは似たイベントをひとつのissueにまとめる。デフォルトのgroupingではstack traceが核心のシグナルで、exceptionやmessageのような情報も使われる。必要ならfingerprintでまとめる基準を変えられる。
ただし、同じissueが必ずしも同じ原因を意味するわけではない。fetch()を包んだ共通関数の一箇所でネットワークエラーを投げていれば、DNSの失敗、認証の期限切れ、upstreamの500レスポンスがひとつのグループに混ざり得る。逆に、同一の原因が複数のコード経路で異なる例外を作れば、複数のissueに分かれる。
issueは調査すべき出来事の束であって、ドメイン原因の分類表ではない。groupingをそのまま障害件数や製品KPIに使うと、この違いを見落とすことになる。
必要ならfingerprintを調整したり、domain error codeをtagとして追加したりできる。しかしgroupingのルールをあまりに早く細かく作り込むと、SDKのデフォルト改善を逃し、運用ルールだけが増えていく。私は、まず実際のイベント分布を見て、デフォルトのgroupingがどの質問を妨げているかを確認する順序の方が良いと考えている。
失敗の時間軸
エラーはたいてい最後の場面しか残さない。breadcrumbは、その前に起きたことを時系列で付け足す。ブラウザのnavigation、click、console message、HTTP requestだけでなく、アプリケーションが自分で記録した状態変化も入れられる。
伝統的なログと似ているが、目的は少し違う。ログストレージはサービス全体のイベントを検索するのに強く、breadcrumbは特定のエラー直前の小さな時間軸を復元するのに強い。
だから重要な状態変化は、両方の場所に必要なことがある。決済状態がpendingからfailedに変わったなら、運用ログでは全体の失敗率を集計し、エラーイベントのbreadcrumbではその一人のユーザーの順序を見る。同じ事実をコピーしているのではなく、互いに異なる検索単位を作っているのだ。
OpenTelemetryのLogsドキュメントは、アクティブなtraceとspanの識別子を既存のログに付けて自動的につなぐ方式を説明している。ログの本当の効用は行数ではなく、他のシグナルへ移動できる接続点にある。
遅延が生じた経路
エラーが「何が壊れたのか」に答えるなら、traceは「ひとつのリクエストがどこを通り、時間をどこに使ったのか」に答える。
traceは複数のspanの束だ。ブラウザのドキュメントロード、fetch、サーバーのroute handler、外部API呼び出し、データベースクエリとbackground jobが、それぞれspanになり得る。同じtrace_idを共有すれば、ひとつのリクエストグラフとして復元できる。
この接続は自動で生まれるわけではない。リクエストの境界を越えるとき、trace contextを渡さなければならない。W3CのTrace Context標準はtraceparentとtracestateヘッダーの形式を定義している。ベンダーが違っても同じリクエストをつなぎ合わせられるようにする、最小の共通言語だ。
フロントエンドでは、ここにも条件がある。
- すべての外部ドメインにtraceヘッダーを送ると、情報露出とCORSの問題が生じ得る。
- ブラウザSDKが許可されたAPI originにだけcontextを渡すよう、範囲を制限しなければならない。
- サーバーとupstreamも同じヘッダーを保存または変換しなければならない。
- sampling判断をサービスごとにバラバラに下すと、traceの中間が空く。
traceが途切れたときは、データがないと片付けるより、どの境界でcontextが消えたのかを確認すべきだ。ブラウザからサーバーまでの分散トレーシングは、SDKのインストールよりcontext propagationの設計にかかっている。
spanに込める境界
自動計装はHTTPリクエスト、DB呼び出し、frameworkのlifecycleのようなライブラリの境界をよく捉える。OpenTelemetryのInstrumentationドキュメントは、zero-code instrumentationは出発点として有用だが、アプリケーション内部の判断を見るにはcode-based instrumentationが必要だと説明している。
たとえば注文API全体が800msかかったという自動spanだけでは、なぜ遅かったのか分かりにくい。次のようなドメインspanが必要になるかもしれない。
await tracer.startActiveSpan('checkout.calculate-discount', async (span) => {
  span.setAttribute('promotion.type', promotionType)

  try {
    return await calculateDiscount(cart)
  } finally {
    span.end()
  }
})
ただし関数ごとにspanを作れば、traceはコードの実行記録に変わってしまう。観測の目標はすべての呼び出しを保存することではなく、遅延と失敗についての仮説を区別することだ。
良いspanの境界は、おおむね次のいずれかだ。
- ネットワーク、DB、queueのように失敗の主体が変わる境界
- cache hitとmissのように実行経路が分かれる境界
- 決済承認、権限判定のようにドメインの結果が分かれる境界
- 遅延予算を別途管理すべき作業
ひとつのspanを見て、誰が何をどれだけしたのか言えないなら、境界か名前を見直すべきだ。
分布から事例へ
traceを全部保存するとコストが急速に膨らむ。だからシステムの全体状態はmetricで見て、異常区間の具体的なリクエストはtraceへ降りていく方式が一般的だ。
OpenTelemetryのSignalsドキュメントは、trace、metric、log、baggageを互いに異なるtelemetry signalとして区分している。別のProfilesドキュメントでは、profileシグナルは2026年9月現在Alphaと表示されている。データモデルとOTLPの伝送経路はできたが、安定化したシグナルと同じ水準だと仮定してはいけない。
各シグナルの強みは次のとおりだ。
| シグナル | 強み | 弱み |
|---|---|---|
| metric | 全体の傾向、比率、分布、アラート | 個別リクエストの文脈が少ない |
| trace | リクエストひとつの経路と遅延 | 全量保存のコストが大きい |
| log | 出来事の詳細な記録と自由な検索 | 形式とcardinalityが崩れやすい |
| profile | CPUとメモリを使ったコード位置 | リクエストとつながないとユーザー影響がぼやける |
これらのシグナルは競争関係にない。たとえばlatency histogramでp99が悪化した時間を探し、exemplarやtrace idで遅いリクエストを開き、該当spanのログとprofileを見る、というように移動する。
Grafana Tempoは公式ドキュメントで、traceからmetricを作り、Lokiのログ、Prometheusのmetricとつなぐ構造を提供している。オープンソーススタックの利点は、特定SaaSの画面に閉じ込められずに、シグナルの保存と接続の方式を設計できることだ。その代わり、Collector、storage、retention、query性能とアップグレードを自分で運用しなければならない。
実行コストの位置
traceであるspanが2秒かかったことは分かっても、その中でCPUがどこに使われたのかは分からないことがある。profileは関数単位の実行サンプルとresource usageを記録して、この空白を埋める。
ここでもtraceとprofileの質問は異なる。
- trace: ユーザーのリクエストがどのサービスと作業を経たのか
- profile: その時間の間、どの関数がCPUを使ったのか
Sentryは2025年にContinuous ProfilingとUI Profilingを、既存のprofiling製品と区別して公開した。Continuous Profilingはサポートされるサーバーruntimeの長時間のresource usageを見て、UI Profilingはユーザーセッションの実行コストを見る。最初はiOS・macOSとAndroidが中心だったが、2025年12月からBrowser JavaScriptとElectronもUI Profilingをサポートしている。
それでも、すべてのruntimeが同じ方式で測定されるわけではない。ブラウザでは、DevToolsのCPU profileとLong Animation Framesの方が、特定セッションをより直接的に掘り下げる道具になり得る。製品名よりも、サポートされるplatform、samplingの方式、収集のoverhead、traceとの接続範囲を確認すべきだ。
セッションの再構成
ユーザーが「ボタンが押せなかった」と言ったとき、エラーとtraceだけでは画面の状態は分かりにくい。Session ReplayはDOMの変化と入力、navigation、console、networkの情報を、再生可能な形でつなぐ。
SentryのSession Replay FAQは、replayがピクセルを録画した映像ではなく、ブラウザのDOMを記録して後から再構成した結果だと説明している。だから元の画面と完全に同じとは限らず、canvasや外部リソースには別途の条件が付く。
この違いは個人情報の観点でも重要だ。DOMには入力値、アカウント情報、投稿の内容が入っている。SentryのWeb Replay SDKはtextをmaskし、mediaをblockするデフォルトを提供するが、アプリケーションのDOM構造とcustom componentまで自動で安全になるわけではない。requestとresponse bodyの収集も、必要なURLだけを明示的に許可すべきだ。
Replayをオンにする前に、次を先に決めるべきだ。
- どのエラーとsessionをサンプルとして残すのか
- どのDOM領域と入力をmaskまたはblockするのか
- network bodyとheaderを収集する必要があるのか
- 誰がreplayを見られて、どのくらいの期間保存するのか
- SDKとDOM serializationのコストをユーザーに負担させる価値があるのか
Replayは文脈が強い分、収集範囲も強い。デバッグ可能性とデータ最小化の間の決定を、製品のデフォルトに任せきりにしてはいけない。(このブログはReplayを使っていない。ロード性能がそのまま検索露出の前提になるサービスなので、収集がくれる答えより訪問者が払うコストの方が大きいと判断した)
不在として現れる失敗
エラー、trace、Replayは発生した出来事の文脈を深く見せてくれる。しかし予約された作業がそもそも始まらなかったら、残すべき出来事自体がない。
Cron monitorは作業の開始と完了の状態をcheck-inとして受け取り、予定の時刻にシグナルが来なければmissed状態を作れる。このとき観測の対象は、コードが投げたエラーではなく期待していた出来事の不在だ。
私にとってこれは他人事ではない。このブログは毎週月曜日にSearch Consoleのデータを自動収集しているが、ある週にその作業が静かに走らなくても、今は知る方法がない。失敗したのではなく、何も起きなかったのだから、エラーは出ないからだ。観測データを集める装置そのものが死角にあるわけだ。
この観点はhealth check、queue consumer、データ収集pipelineにも適用される。「失敗イベントが0件」というmetricだけでは健全さは分からない。処理すべき入力があったのか、最後の成功はいつなのか、処理量が普段の範囲にあるのかを、あわせて見なければならない。
観測を難しくするのは、発生した出来事よりも発生しなかった出来事であることが多い。そしてこの文は、後で私が予想しなかった形でもう一度戻ってくる。
成功レスポンスの中の失敗
逆に、出来事は発生したのに成功に分類されて見えない失敗もある。私が計装を取り付けた途端に出会ったのが、まさにこの種類だった。
最初の計画は単純だった。統計APIのroute handlerのcatchにエラー報告を入れれば、Google Analytics照会が失敗したときに分かるはずだ。ところがローカルのプロダクションビルドで誤ったサービスアカウントキーを注入してわざと失敗させてみると、エラーはrouteのcatchに到達しなかった。一層下にある統計照会モジュールのcatchブロック四箇所が先に捕まえてデフォルト値を返しており、レスポンスはこう出ていった。
HTTP 200 OK
{ "slug": "/260610", "views": 0 }
訪問者には統計が0と見え、サーバーは正常だと答える。routeのエラー率とuptimeだけを見れば何も起きていない。システムの成功条件とユーザーの成功条件が違っていたのだ。(catchをどの層に置くべきかはエラーハンドリングで扱ったことがあるが、あのときは「どこで捕まえるべきか」で、今回は「捕まえたのに誰も知らない」に出会ったわけだ)
そこで計装の地点をrouteではなくその四箇所に移し、それぞれどのクエリで弾けたのかを区別するタグを付けた。このタグが後で決定的な役割を果たす。
こうした状況には、すでに正確な名前が付いている。MicrosoftとAzureチームが2017年のHotOSで発表したGray Failure論文は、クラウドの大きな可用性事故はたいてい完全に止まる種類ではなく、この灰色地帯から来ると述べ、その核心的特徴をこう規定している。
私たちは、gray failureの核心的特徴がdifferential observability、すなわちアプリケーションが被害を受けていても、システムの失敗検出器が問題に気づかないかもしれないという点にあると主張する。
we argue that a key feature of gray failure is differential observability: that the system's failure detectors may not notice problems even when applications are afflicted by them.
一方の主体は失敗で被害を受けているのに、もう一方の主体はその失敗を認知しておらず、問題は後者が失敗検出を担う側だということだ。私が計装の地点をrouteから下の層へ降ろした仕事は、まさにその認識の格差を埋める作業だった。
解決は、すべてのデフォルト値返却を失敗に変えることではない。fallbackはユーザー体験を守る正しい選択であり得る。その代わり、fallbackが実行されたという事実、元の呼び出しの遅延、影響を受けた機能を、別のシグナルとして残すべきだ。
try {
  return await fetchAnalyticsStats()
} catch (error) {
  captureException(error, { tags: { gaQuery: 'stats' } })

  return { totalPageViews: 0, todayVisitors: 0 }
}
観測すべきなのは例外ではなく、システムが正常経路から外れたという事実だ。
65秒ぶら下がったGA呼び出し
計装の地点を移してから最初に上がってきた実際のプロダクションイシューが、この話の次の場面だ。GA呼び出しが65.877秒後にDEADLINE_EXCEEDEDで失敗していた。ところが上で見た構造のせいで、レスポンスは相変わらず200だった。当時ホームは動的レンダリングで統計領域をストリーミングで流していたので、ページ自体はすぐに表示された。その代わり、その場所が長くローディング状態のまま残り、やがて静かに0で埋まった。
原因を掘ってみると、使っているGAクライアントライブラリの設定ファイルにこう刻まれていた。
"RunReport": { "timeout_millis": 60000, "retry_params_name": "default" }ライブラリのデフォルトRPCタイムアウトが60秒なのに、私のコードは五つの呼び出し地点のどこにもタイムアウトを渡していなかった。これは私だけのミスではなく、広く警告されてきた種類のミスだ。Google SREのGráinne Sheerinが書いたgRPC公式ブログのdeadlineの記事は、タイトル下の最初の行が「TL;DR: Always set a deadline」で、deadlineがなければ進行中のリクエストがリソースを掴んだまま最大タイムアウトまでぶら下がり得ると説明している。私の使うGAクライアントもgRPCベースなのだから、同じ原理をドキュメントがすでに警告していたのに、呼び出し地点で守っていなかったのだ。
修正は、タイムアウトを5秒に固定して呼び出し地点すべてに渡すことだった。そして応答しないローカルTCPサーバーを立てて、決定的に再現した。
| 条件 | 経過時間 | エラーメッセージ |
|---|---|---|
| タイムアウト未指定(修正前) | 60.04秒 | Deadline exceeded after 60.000s |
timeout: 5000(修正後) |
5.00秒 | Deadline exceeded after 5.000s |
数字が説明どおりに動いたので、タイムアウト設定がコードに届いていることまでは確認できたわけだ。ひとつ明かしておくと、5という数字自体に根拠があるわけではない。GAが正常なときの応答遅延の分布を測っていないのだから、事実上任意に選んだ値だ。ただし方向には拠り所があった。Google SRE本のEmbracing Riskは、100%が正しい信頼性目標であることは決してないと述べている。このブログにおいて訪問者数値は付加情報だ。正確に取ってくることより、早く諦めてデフォルト値を描いてあげる方が、訪問者の体験には良い。
直した後に測り直した分布
ここまでが、本来この調査の結末になるはずだった。原因を見つけ、再現し、直したのだから。ところが、修正コミットがデプロイされたリリースで、同じ系列のDEADLINE_EXCEEDEDが百件以上積み上がっているのを発見した。
最新の100件を取り出し、報告された時間の分布を見た。先に押さえておきたいのは、この値がGAが実際に応答に使った時間ではないという点だ。deadlineのタイマーを掛けた瞬間から、そのタイマーが実際に鳴った瞬間までのwall-clock time(実際の経過時間)だ。
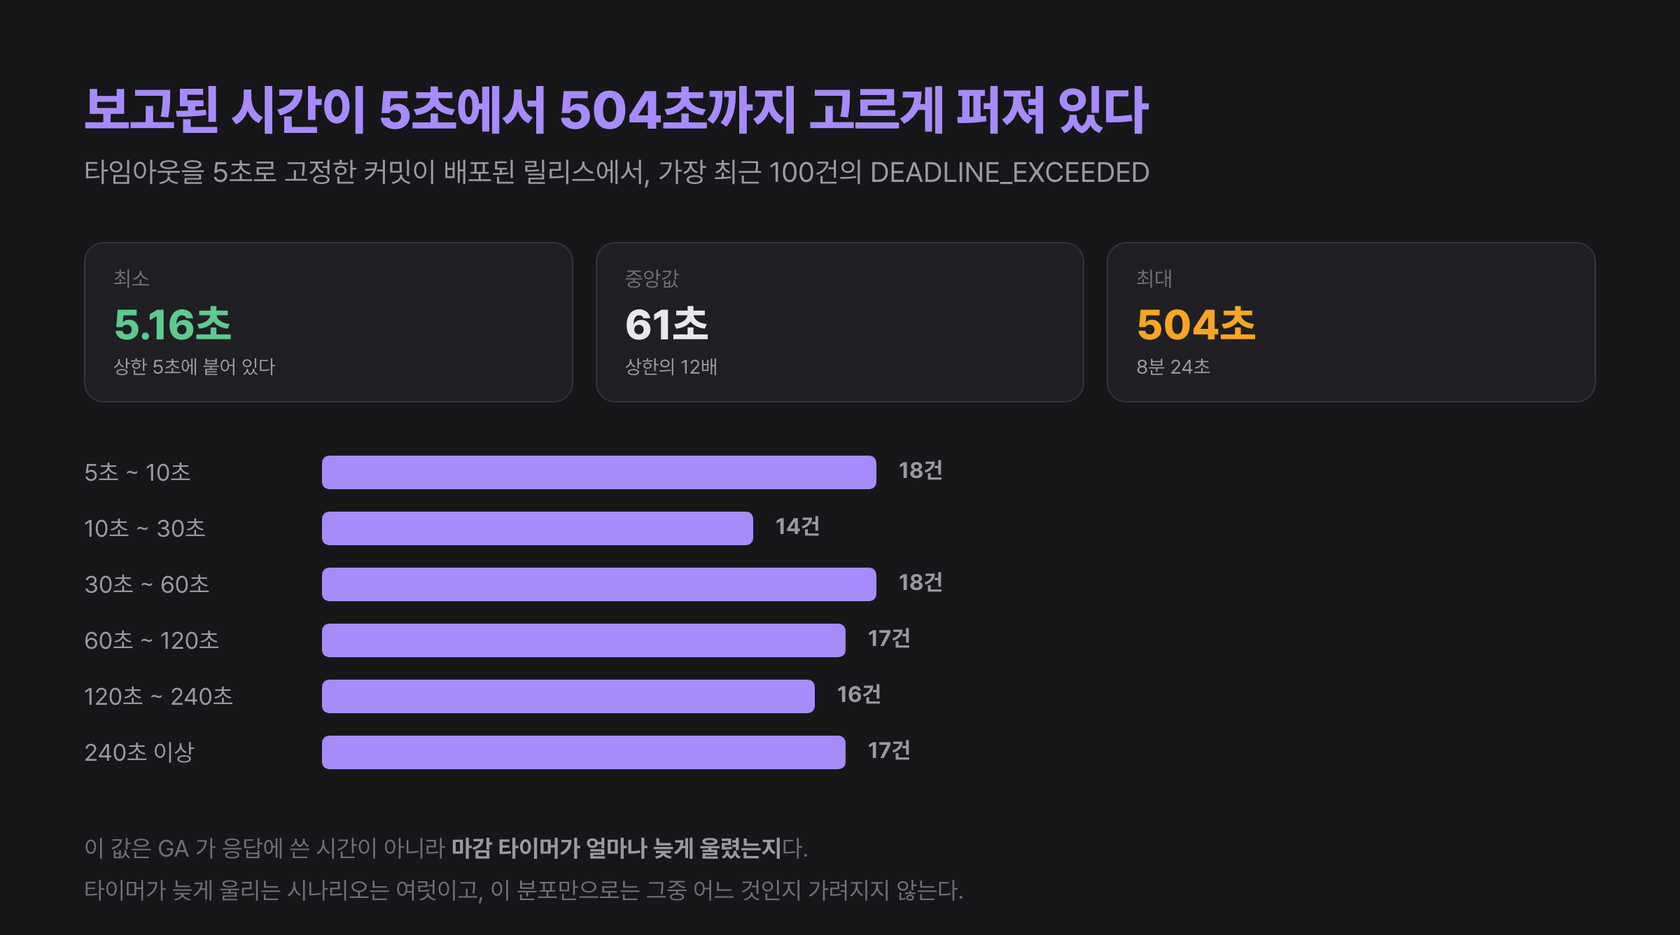
読み取るとこうなる。**下限は守られた。**5秒より短く切られた件がひとつもなく、最も短いものが5.16秒なのだから、5秒の設定自体はコードに届いている。ところが上は8分24秒まで登り、中央値は61秒だ。さらに奇妙なのは、値がどの区間にも寄っていないことだ。実際にGAが遅くて生じた遅延なら上限の近くに積み上がるはずだが、そうなっていない。
タグがより多くのことを教えてくれた。100件に刻まれたタグはstatsとpopularの二つだけで、おおむね二件が対で上がってくる。この二つの経路の共通点は、どちらも一時間のキャッシュの裏にある再検証経路だということだ。一方、キャッシュなしで訪問者のリクエストを受けてその場でGAを呼ぶ残りの経路(page、pages)は、100件の中に一度も登場しない。失敗が訪問者のリクエストを処理している最中ではなく、レスポンスが終わった後にキャッシュを埋め直す作業でだけ起きているという意味だ。
この観察は、前の節で書いた文をひとつ揺さぶる。統計の場所が長くローディングに留まると書いたが、失敗がレスポンス以後の経路でだけ起きるなら、訪問者はその時間を待っていなかったかもしれない。測らずに書いた文が、もうひとつあったわけだ。
私が立てた仮説はこうだ。このブログはサーバーレス関数の上で動いていて、サーバーレス関数はレスポンスを送ると次の呼び出しまで実行環境が凍りつく。その間タイマーも一緒に止まり、関数が目覚めるときに遅れて発火するなら、実際に待った時間ではなくwall-clock time基準で膨らんだ値が刻まれ得る。下限がきっちり5秒に張り付いていることも、上の値がどこにも寄らないことも、失敗がレスポンス以後の作業でだけ出るという観察とも合う。
ただし、ここで気をつけなければならない。**分布が仮説と矛盾しないことと、仮説を支持することは別だ。**タイマーが遅れて発火するシナリオは複数ある。サーバーレスの凍結以外にも、重いレンダリングがイベントループを掴んでいたのかもしれないし、コンテナがCPUを絞っていたのかもしれない。ライブラリ設定の再試行の総予算が600秒で、観測された最大値504秒がその中に収まるという点も、候補として残しておいた。すべて同じ形の分布を作り得るのだから、このグラフは候補を絞ってくれない。
候補をひとつ消してくれるのは同じ区間のCPU使用時間だ。wall-clock timeで61秒が過ぎる間、CPU時間がほぼ0なら、重いレンダリングがイベントループを掴んでいたという説明は外れる。先ほど見たprofileシグナルが答える質問がこれだ。
ただしCPU時間で終わりではない。応答を実際に待っている間もCPU時間は0に近いため、待っていた区間と止まっていた区間が同じ形に見える。二つを分けるには、その区間の中で時間が均等に流れたかを見なければならない。短い間隔で繰り返し発火するタイマーを掛けておき、その間隔が一度に開く地点があるかを見るやり方だ。実行環境が凍っていたなら間隔が跳び、実際に待っていたのなら均等に流れる。呼び出し直前と直後の時刻だけを測るのではだめだ。関数が凍っている間もwall-clock timeはそのまま流れるので、すでに持っている数字を作り直すだけになる。
付け加えると、このイシュー一覧とタグ分布と時間の値を、私はダッシュボードを開いて見たのではなく、Sentry公式MCPサーバーを取り付けてエージェントに尋ねて受け取った。計装を取り付けるコストが下がっただけでなく、積もったデータを開いて見るコストも下がった。
発生が止まった理由は修正ではなかった
この記事を書きながら、そのイシューをもう一度照会した。直したと信じたものが、今も直っているか確認するためだ。
2026年9月14日の時点で、その系列のイシューは合計144件で止まっていた。最後の発生は8月18日で、その後27日間0件だ。タグ分布は最後までstatsとpopularの対だけだった。発生グラフだけを見れば、問題は消えたように見える。
しかし私はその間、前の節に書いた測定をひとつもしていない。仮説を検証して直したことがないのに、なぜ止まったのか。デプロイ履歴を突き合わせてみると、答えは別のところにあった。最後のイベントが記録されたその日にコミットされた多言語化の改編が、ホームから訪問者統計と人気記事の領域を外していた。statsとpopularの再検証経路を呼ぶ画面がちょうどその二つだったのだから、その改編がプロダクションにデプロイされて以降は、失敗するコードが呼ばれること自体がない。失敗していたコードが直ったのではなく、そのコードを呼ぶ画面が消えたのだ。
つまりこの障害は解決されたのではなく、観測対象が消えたのだ。サーバーレス凍結の仮説は確認されないまま残り、プロダクションでその分布をもう一度作ってみる再現条件も一緒に消えた。最初に65.877秒を報告した最初のイシューの元イベントは、保存期間を過ぎてもう開くこともできない。
私がこの節を残しておく理由がある。イシュー一覧のresolvedは原因究明の証明ではない。発生が0になる経路は複数ある。実際に直ったか、誰もその経路を踏まなくなったか、計装そのものが消えたか。エラーシグナルだけでは、この三つを区別できない。区別してくれるのは呼び出し量や最後の成功時点のような正常経路のシグナルであり、それが前の節で述べた「発生しなかった出来事」の観測が必要なもうひとつの理由だ。計装を取り付けるのが一度きりの作業なら、観測は測り続ける仕事だ。
サンプリングの知識の限界
traceとreplay、profileは保存コストとclientのoverheadのためにsamplingが必要だ。問題は、sample rateを下げるとコストだけが減るのではなく、答えられる質問も減るという点だ。
無作為の10% samplingは全体分布を推定するには悪くないかもしれないが、稀なエラーを見逃し得る。エラーが発生したsessionだけreplayを追加で残したり、遅いtraceと失敗したtraceを優先的に保存したりする方針が必要な理由だ。
逆にエラーが出たリクエストだけを残すと、正常なユーザーと比較する基準が消える。遅いリクエストが特別に遅いのか、システム全体が遅いのか判断できない。
私もこのコストを払った。このブログはコストを節約しようとtraceのサンプルを10%だけ受けるようにしておいたのだが、上の調査で膨らんだ経過時間が実際の待機だったのかを分けるには該当呼び出し区間の開始と終了が必要で、サンプルが浅くて問題のリクエストに対するtraceがなかった。節約したのは私の料金で、失ったのは答えられる質問だった。
samplingはひとつの数字ではなく、質問ごとの方針であるべきだ。
- baselineのための確率サンプル
- エラーとlatency thresholdのための優先サンプル
- 特定のreleaseと機能を調査するための一時サンプル
- 個人情報とコストが大きいreplay・profileの別サンプル
保存しなかったデータは、後からAIでも復元できない。
AI以後の計装設計
AIがシステム観測で有用な理由は、データがすでに構造化されているからだ。issue、event、tag、span、trace、releaseはAPIで照会でき、ログとprofileも時間と識別子を持つ。私がイシューのタグ分布と発生が止まった日付を、エディターからエージェントに尋ねて受け取れたのも、この構造のおかげだ。
Sentryは2026年6月、tracing、profiling、attachment関連のendpointを含めてagentと自動化が使うAPIドキュメントを拡張した。観測データが、人がダッシュボードで読む情報だけでなく、agentが根拠を照会するインターフェースとしても使われていることを示している。
AIは次のような探索を速くする。
- 最近のrelease以後に増えたissueとtagの組み合わせを探す
- 特定traceの遅いspanと関連ログを要約する
- 複数のイベントに共通して現れたbreadcrumbとブラウザ環境を探す
- profileのhot pathと関連commit候補をつなぐ
- 再現仮説と追加の計装地点を提案する
しかし計装されていないdomain stateは、agentにも分からない。checkout.result、cache.status、fallback.reasonのような属性をどの位置に残すべきかは、コードとユーザーの期待を理解してこそ決められる。私の調査でエージェントが分布とタグを即座に取り出せたのは、計装地点を下の層へ降ろしてタグを付けておいた判断が先にあったからだ。
AIがroot causeを提案することはできるが、何を失敗と定義し、どんなコストでどのユーザーを観測するのかは、エンジニアリングの判断だ。
シグナルをひとつの出来事へ
Sentryの各機能を全部オンにすることが、この記事の結論ではない。エラーからbreadcrumbで過去を見て、traceでリクエスト経路をたどり、metricで影響範囲を確認し、必要なときにreplayとprofileへ降りていけるべきだ。ここにCron monitorのような期待した出来事の不在と、正常レスポンスに分類された逸脱までが、同じ調査の流れに入ってこなければならない。
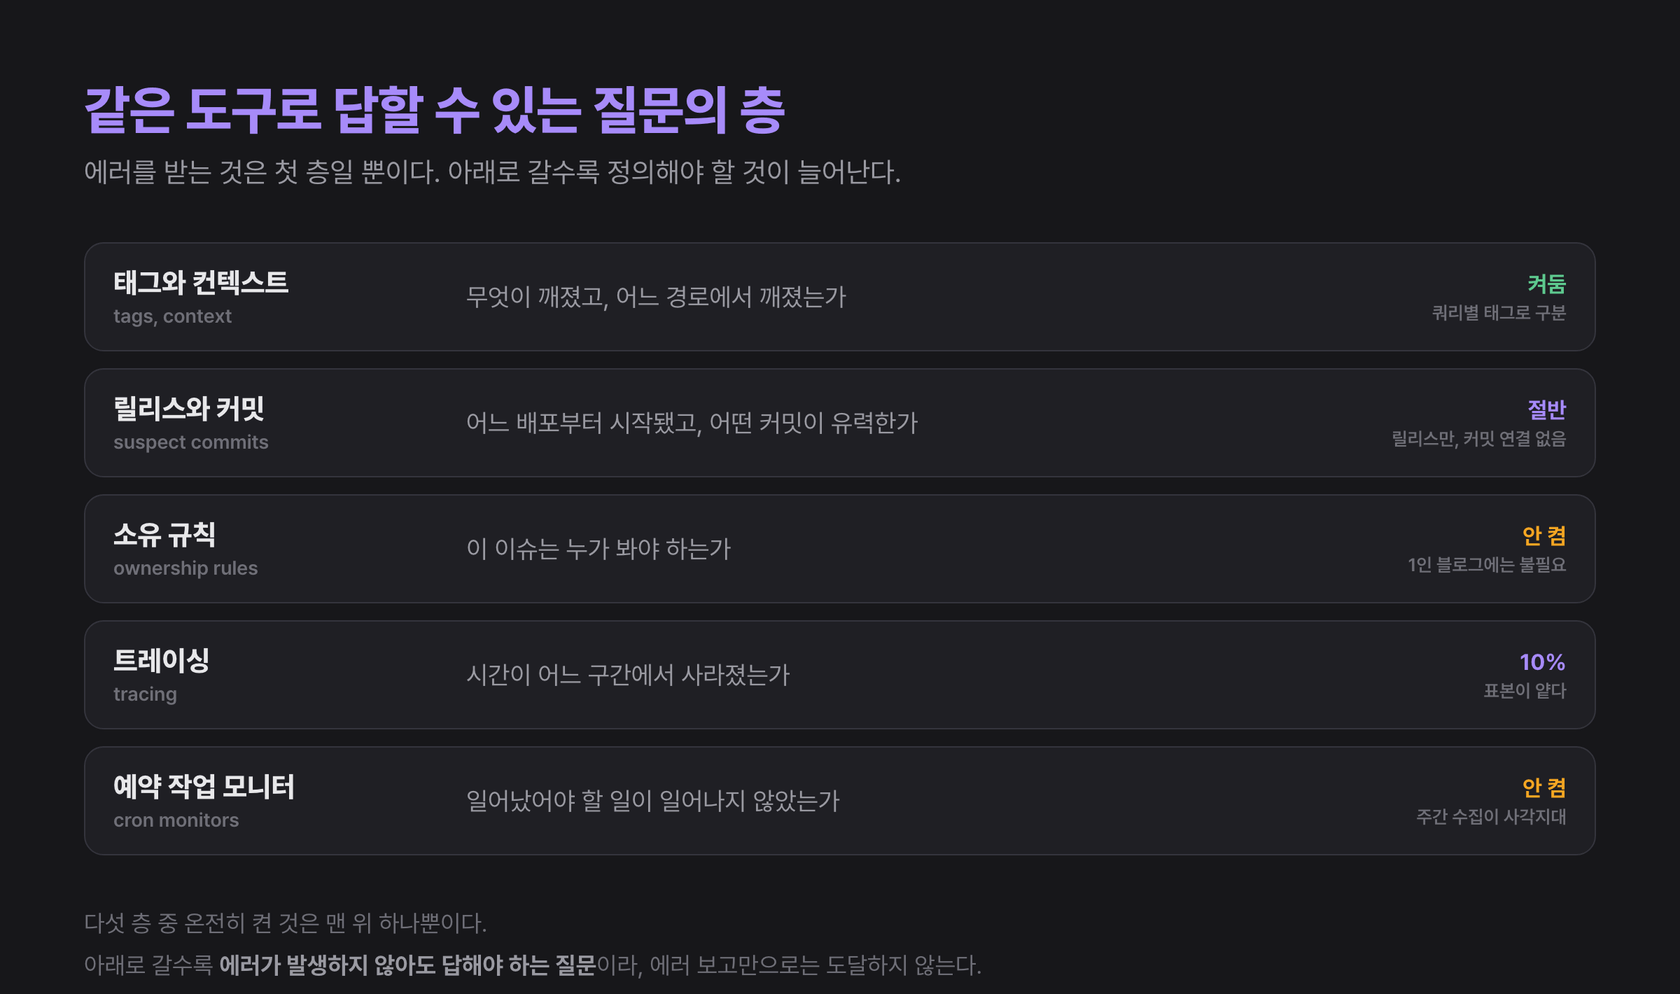
このブログが五つの層のうち、まるごとオンにしたのがタグひとつだけだという事実は、恥ずかしい成績表ではないと思っている。どの層をオンにするかは機能一覧を眺めて決まるのではなく、何を失敗と見るのかを先に決めてこそ、どの層が必要か分かるからだ。ただし今回の調査でtraceサンプルの浅さと週次収集の死角という二つの層の空白が実際のコストとして返ってきたのだから、次にオンにする層は決まったわけだ。
OpenTelemetryのtrace contextとsemantic conventionは、この移動経路を特定の製品の外へ拡張する。ただしJavaScriptのbrowser instrumentationは依然としてexperimentalで、profileシグナルはAlphaだ。標準に含まれたという事実と、各runtimeで安定して使えるという事実は、区別しなければならない。
AIはこのシグナルを検索してつなぐ候補を素早く見つける。しかし観測の深さは製品の機能の数ではなく、シグナルの間を移動できるか、正常経路から外れた状態を表現したかで決まる。私の200レスポンスは、シグナルを植えるまで失敗を一度も語らず、植えた後になって初めて、それが失敗だったという事実が明らかになった。
次の記事観測から判断へでは、このシステム情報とGA4、Search Consoleのユーザーデータをどう一緒に解釈するかを見ていこうと思う。システムを詳しく見るだけでは、何を先に直すべきか決められないからだ。その前に、この記事を読む読者のみなさんも、resolvedで閉じておいたイシューをひとつ思い浮かべてみてほしい。そのイシューは直ったから止まったのか、それとも誰も測り直していないだけなのか。