観測から判断へ
今回は、観測データを判断に変える方法について書いてみたい。
私はこのブログでGA4とSearch Consoleを数年にわたり自分で運用してきた。訪問者がどんな検索語で入ってくるかを見て、それに合わせて記事のタイトルや説明を直す作業を繰り返してきたのだ。ところが、データを長く見てきたことと、そのデータで良い判断を下すことは別の問題だった。この記事の後半で扱うが、私は同じ記事の同じ指標をめぐって、2か月の間に正反対の結論を出しかけた。
先行するブラウザ観測ではブラウザが生み出す性能情報を、システム観測ではシステムが残すエラー、ログ、traceを見てきた。この情報が十分に蓄積されれば、サービスがどう動いているかは以前よりはるかによく見える。しかし、何を先に直すのか、その問題がユーザーにとって本当に重要か、修正の後に体験が良くなったかは、依然として別の質問だ。
この記事の核心は、データをユーザー単位で無理に統合することではなく、同じプロダクト仮説を異なる観測単位で確かめることにある。そして、データソースが増えても判断が自動的に良くなるわけではない。異なる標本と集計ルールを持つ数字を一つのグラフに載せた瞬間、無関係な変化までもっともらしい物語に束ねられてしまう。観測の最終段階で必要なのは、より多くのダッシュボードではなく、各データが何を見て、何を見られなかったのかを区別する能力だ。
このブログが観測する三つの層
抽象的な話から始める代わりに、私の事例を先に広げておくほうがいいだろう。このブログは結果的に三つの層で観測している。
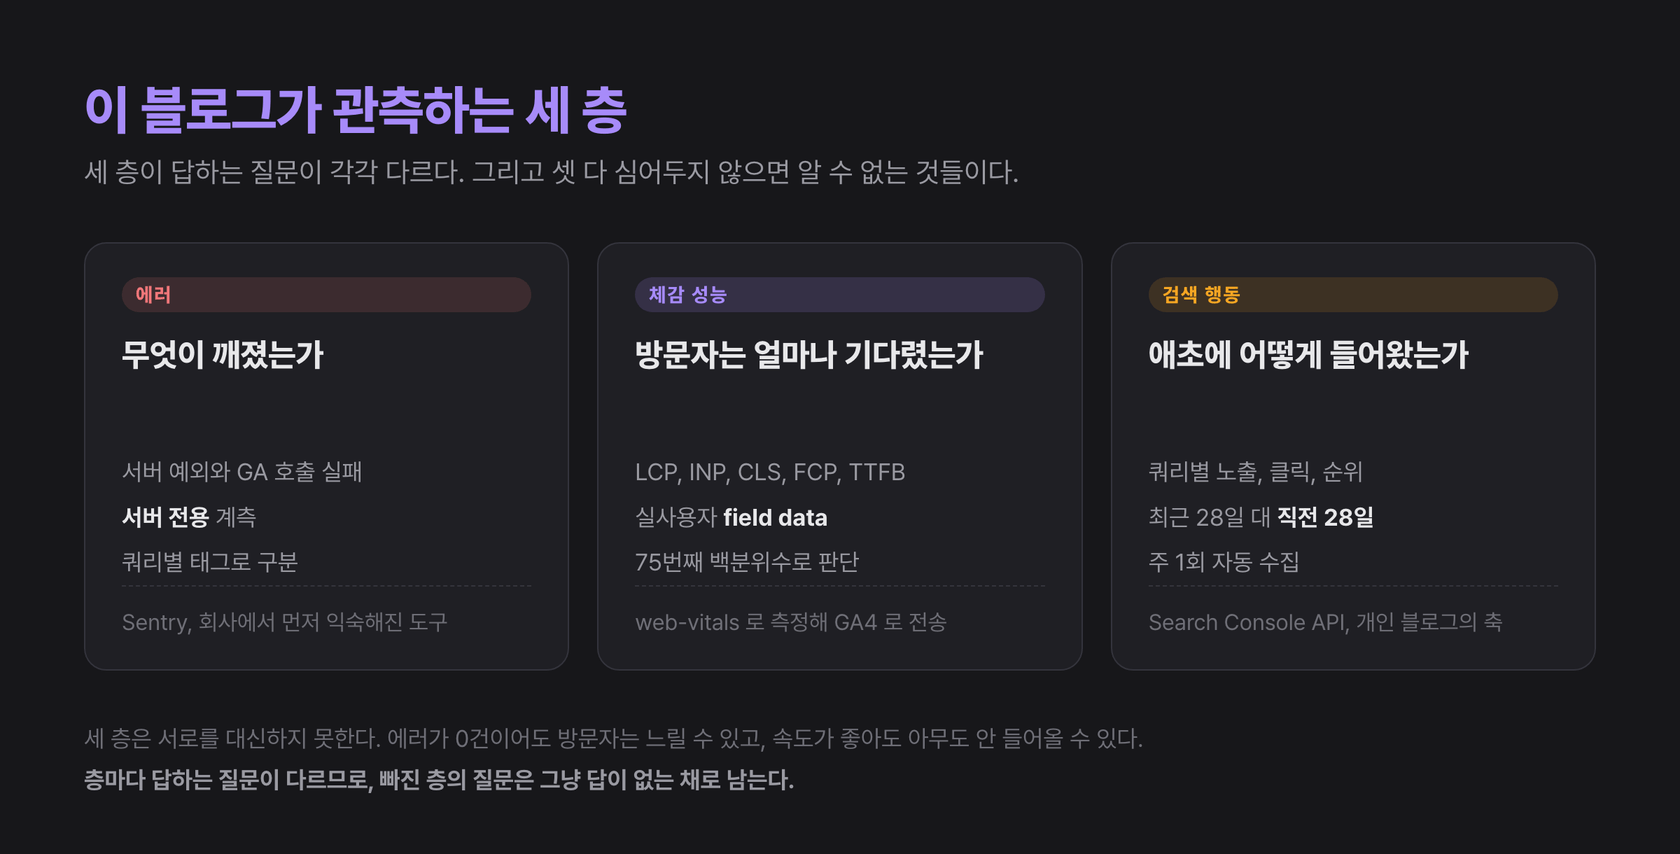
第一の層はSentryだ。サーバー専用の計測で、例外と静かに失敗するGA呼び出しを捕まえる。第二の層は実ユーザーの体感性能だ。ブラウザで測ったWeb VitalsをGA4に送って蓄積する。第三の層は検索行動だ。Search Consoleのデータを毎週自動収集し、直近28日とその前の28日を比較する。層ごとに答える質問が違う。何が壊れたのか、訪問者はどれだけ待ったのか、そもそもどんな検索語で入ってきたのか。
三つの層は互いの代わりにはならない。エラーが0件でも訪問者は遅さを感じているかもしれないし、速くても誰も来ないかもしれない。最初の二つの層は前の2本の記事で扱ったので、この記事の重心は第三の層と、三つの層を一緒に読む方法にある。
正直に書いておくと、このブログのGA4は行動分析ツールとして深く使われてはいない。ページビューとweb_vitalsイベントの保管庫に近い。だからこの記事のGA4のパートは、私が運用しながら確認した制約と、公式ドキュメントで検証した設計基準を併せて書く。どこまでが経験で、どこからが調査なのかは節ごとに区別する。
異なる観測単位
ブラウザRUM、Sentry、GA4、Search Consoleをすべてユーザーデータと呼びたくなるが、実際の観測単位は異なる。
| 層 | 代表的なデータ | 観測単位 | 主に答える質問 |
|---|---|---|---|
| ブラウザ体験 | LCP, INP, CLS, resource timing | ページ訪問と相互作用 | ユーザーは何をどれだけ待ったか |
| システム状態 | error, span, trace, log, profile | イベントとリクエスト | どこで何が失敗し、遅くなったか |
| プロダクト行動 | GA4 event, session, key event | 行動とセッション | ユーザーはサービスの中で何をしたか |
| 検索意図 | query, impression, click, position | 検索での表示 | ユーザーはどんな問題を抱えて来たか |
同じ人の旅程のように見えても、すべての層で同一のユーザーを観測しているわけではない。広告ブロッカーはGAとSentryのリクエストを遮断しうるし、プライバシー同意の状態によってanalyticsの標本は変わる。Search Consoleは個々のユーザーではなく、検索結果の集計データを提供する。CrUXは一定の条件を満たすChromeユーザーのfield dataだ。
したがって、四つの層の数字が正確に一致しないのは正常だ。問題は差をなくすことではなく、どの標本のどの質問に答える数字なのかを記録することだ。
GA4のイベントモデル
GA4 eventは、ユーザーの相互作用を名前とparameterでモデリングする。Googleのイベント設定ドキュメントは、SDKが自動で集めるevent、設定で有効にするenhanced measurement、決められた名前とparameterを推奨するrecommended event、サービスが自ら定義するcustom eventを区別している。同じ「event」でも、誰が意味とスキーマを所有するのかが違う。
最初はクリックや画面遷移をできるだけ多く送りたくなる。しかし、イベントが多いほどユーザー理解が深まるわけではない。button_click、button_click_2、main_button_clickedのように実装位置を名前にすると、コードが変わったときに分析上の意味も崩れる。
良いイベントは、DOMの出来事よりもユーザーの意図を表現する。
gtag('event', 'article_reference_open', {
  article_slug: '260916',
  reference_type: 'specification',
  link_position: 'body',
})
このイベントは、どのボタンコンポーネントが押されたかではなく、ユーザーが記事の参考資料を開いたという事実を残す。UIを変えても分析の質問は維持される。
イベント設計の前に、次のことを先に書いてみるのがよい。
- どのユーザー行動を理解しようとしているのか
- その行動が起きたと判定する出来事は何か
- 分析に必要な最小限のparameterは何か
- この数字が変わったら、どんな決定を下すのか
- 重複と欠落をどう検証するのか
最後の二つの質問に答えがなければ、イベントはダッシュボードの飾りになりやすい。(このブログのGA4が保管庫にとどまっている理由もここにある。4番に答えられるイベントは、まだweb_vitals一つだけだ)
収集と反映の違い
GA4 Measurement Protocolを使えば、ブラウザの外のサーバーやoffline systemからもeventを送れる。しかしGoogleのMeasurement Protocol referenceは重要な制限を明記している。収集endpointはHTTPリクエストを受け取ると2xxを返し、payloadが不正でも、データが処理されなくても、エラーステータスを返さない。
HTTP 2xxはリクエストが受信されたという意味であって、eventが意図したレポートに正しく入った証拠ではない。システム観測の記事で扱った、成功レスポンスの中の失敗が、analyticsの収集にも存在するわけだ。このブログで200レスポンスの裏に空の統計が隠れていたように、analyticsでも送信の成功は反映の成功ではない。
だからデプロイ前にはvalidation endpointやEvent Builderでpayloadを確認し、デプロイ後のevent pipelineは少なくとも三つの段階で検証すべきだ。
- 送信:clientまたはserverがリクエストを送ったか
- 収集:RealtimeとDebugViewでeventとparameterが見えるか
- 分析:最終レポートとexport schemaで、意図したディメンションで照会できるか
データを送るコードにテストがあっても、収集設定やcustom dimensionの登録が抜けていれば、分析の段階で値を使えない。analyticsもデプロイ後の検証が必要な運用システムだ。
生イベントが開く質問
GA4の基本レポートは、raw eventを直接扱わなくても、よくある質問を素早く見るのに向いている。しかし、eventとparameterを自由に組み合わせたり、他のデータとjoinしたりしようとすると限界が出てくる。
BigQuery Exportは、GA4のraw eventを日次またはstreaming方式でエクスポートできるようにする。Standard propertyのdaily exportには1日100万eventの制限がある。Streaming exportは速いがbest-effortで、新規ユーザーのattributionを含まず、既存ユーザーのattributionも完全に処理されるまで時間がかかることがある。当日の分析にはevents_intraday_*を、安定した日次分析には確定済みのevents_* tableを使うべき理由だ。
raw eventにアクセスできると、次のような質問が可能になる。
- 遅いLCPを経験したセッションで、次のページへの移動率は変わったか
- 特定のrelease以降、エラーが起きたセッションの主要行動の完了率は変わったか
- 検索queryのタイプによって、landing pageの中で読む深さは変わるか
- mobileとdesktopで、同じ機能のinteraction patternは違うか
しかしraw dataは、解釈の自由とともに、重複、late arrival、sessionization、timezoneを自分で扱う責任も与える。SQLが書けるという事実は、正しいユーザーモデルを保証しない。
検索が見せる意図
GA4は、ユーザーがサイトに入った後の行動を見る。Search Consoleは、その前にどんなqueryとsearch resultを通じて表示され、クリックされたのかを見せてくれる。
Search Analytics APIは、query、page、country、device、search appearanceといったdimensionでclick、impression、CTR、positionを集計できる。しかし公式APIドキュメントは、すべてのrowを保証せず、内部的な限界に従って上位のrowを返すと説明している。小さなqueryの合計が全体の合計と正確に一致しないことがある。
この制約はドキュメントの中の警告ではなく、私のCSVで毎週見える現象だ。9月11日に収集した直近28日のデータでは、page次元のクリック合計は47回なのに、query次元のクリック合計は8回だ。同じ期間の同じサイトなのに、クリックの大部分はquery次元では見えない。まれな、あるいは匿名化されたqueryはrowとして返されないからだ。queryデータで流入の全体を説明しようとすると、この空白を想像で埋めることになる。
平均positionも単純な順位表ではない。複数のquery、device、国、search appearanceで発生した表示を集計した値だ。queryの構成が変われば、個々のキーワードの順位がそのままでも平均は動きうる。
順位が下がったのにクリックが増えた
平均positionのこうした性質に、私はこのブログの実データで出会った。BiomeはESLintとPrettierを置き換えられるか?は2024年12月に書いた記事だが、表示に比べてクリックが不思議なほど少ない状態が長く続いていた。そこで去る6月に、この記事のseoTitleを実際の検索クエリの形に近づけて書き直した。「Biome vs ESLint vs Prettier」で始まる比較型のタイトルだ。
8月初めに収集した28日比較で、この記事の数値はこう動いた。表示は230回から204回へ11%減り、平均positionは8.9位から11.6位へ後退した。二つの指標だけ見れば悪くなった記事だ。ところがclickは2回から13回に増え、CTRは0.87%から6.37%になった。
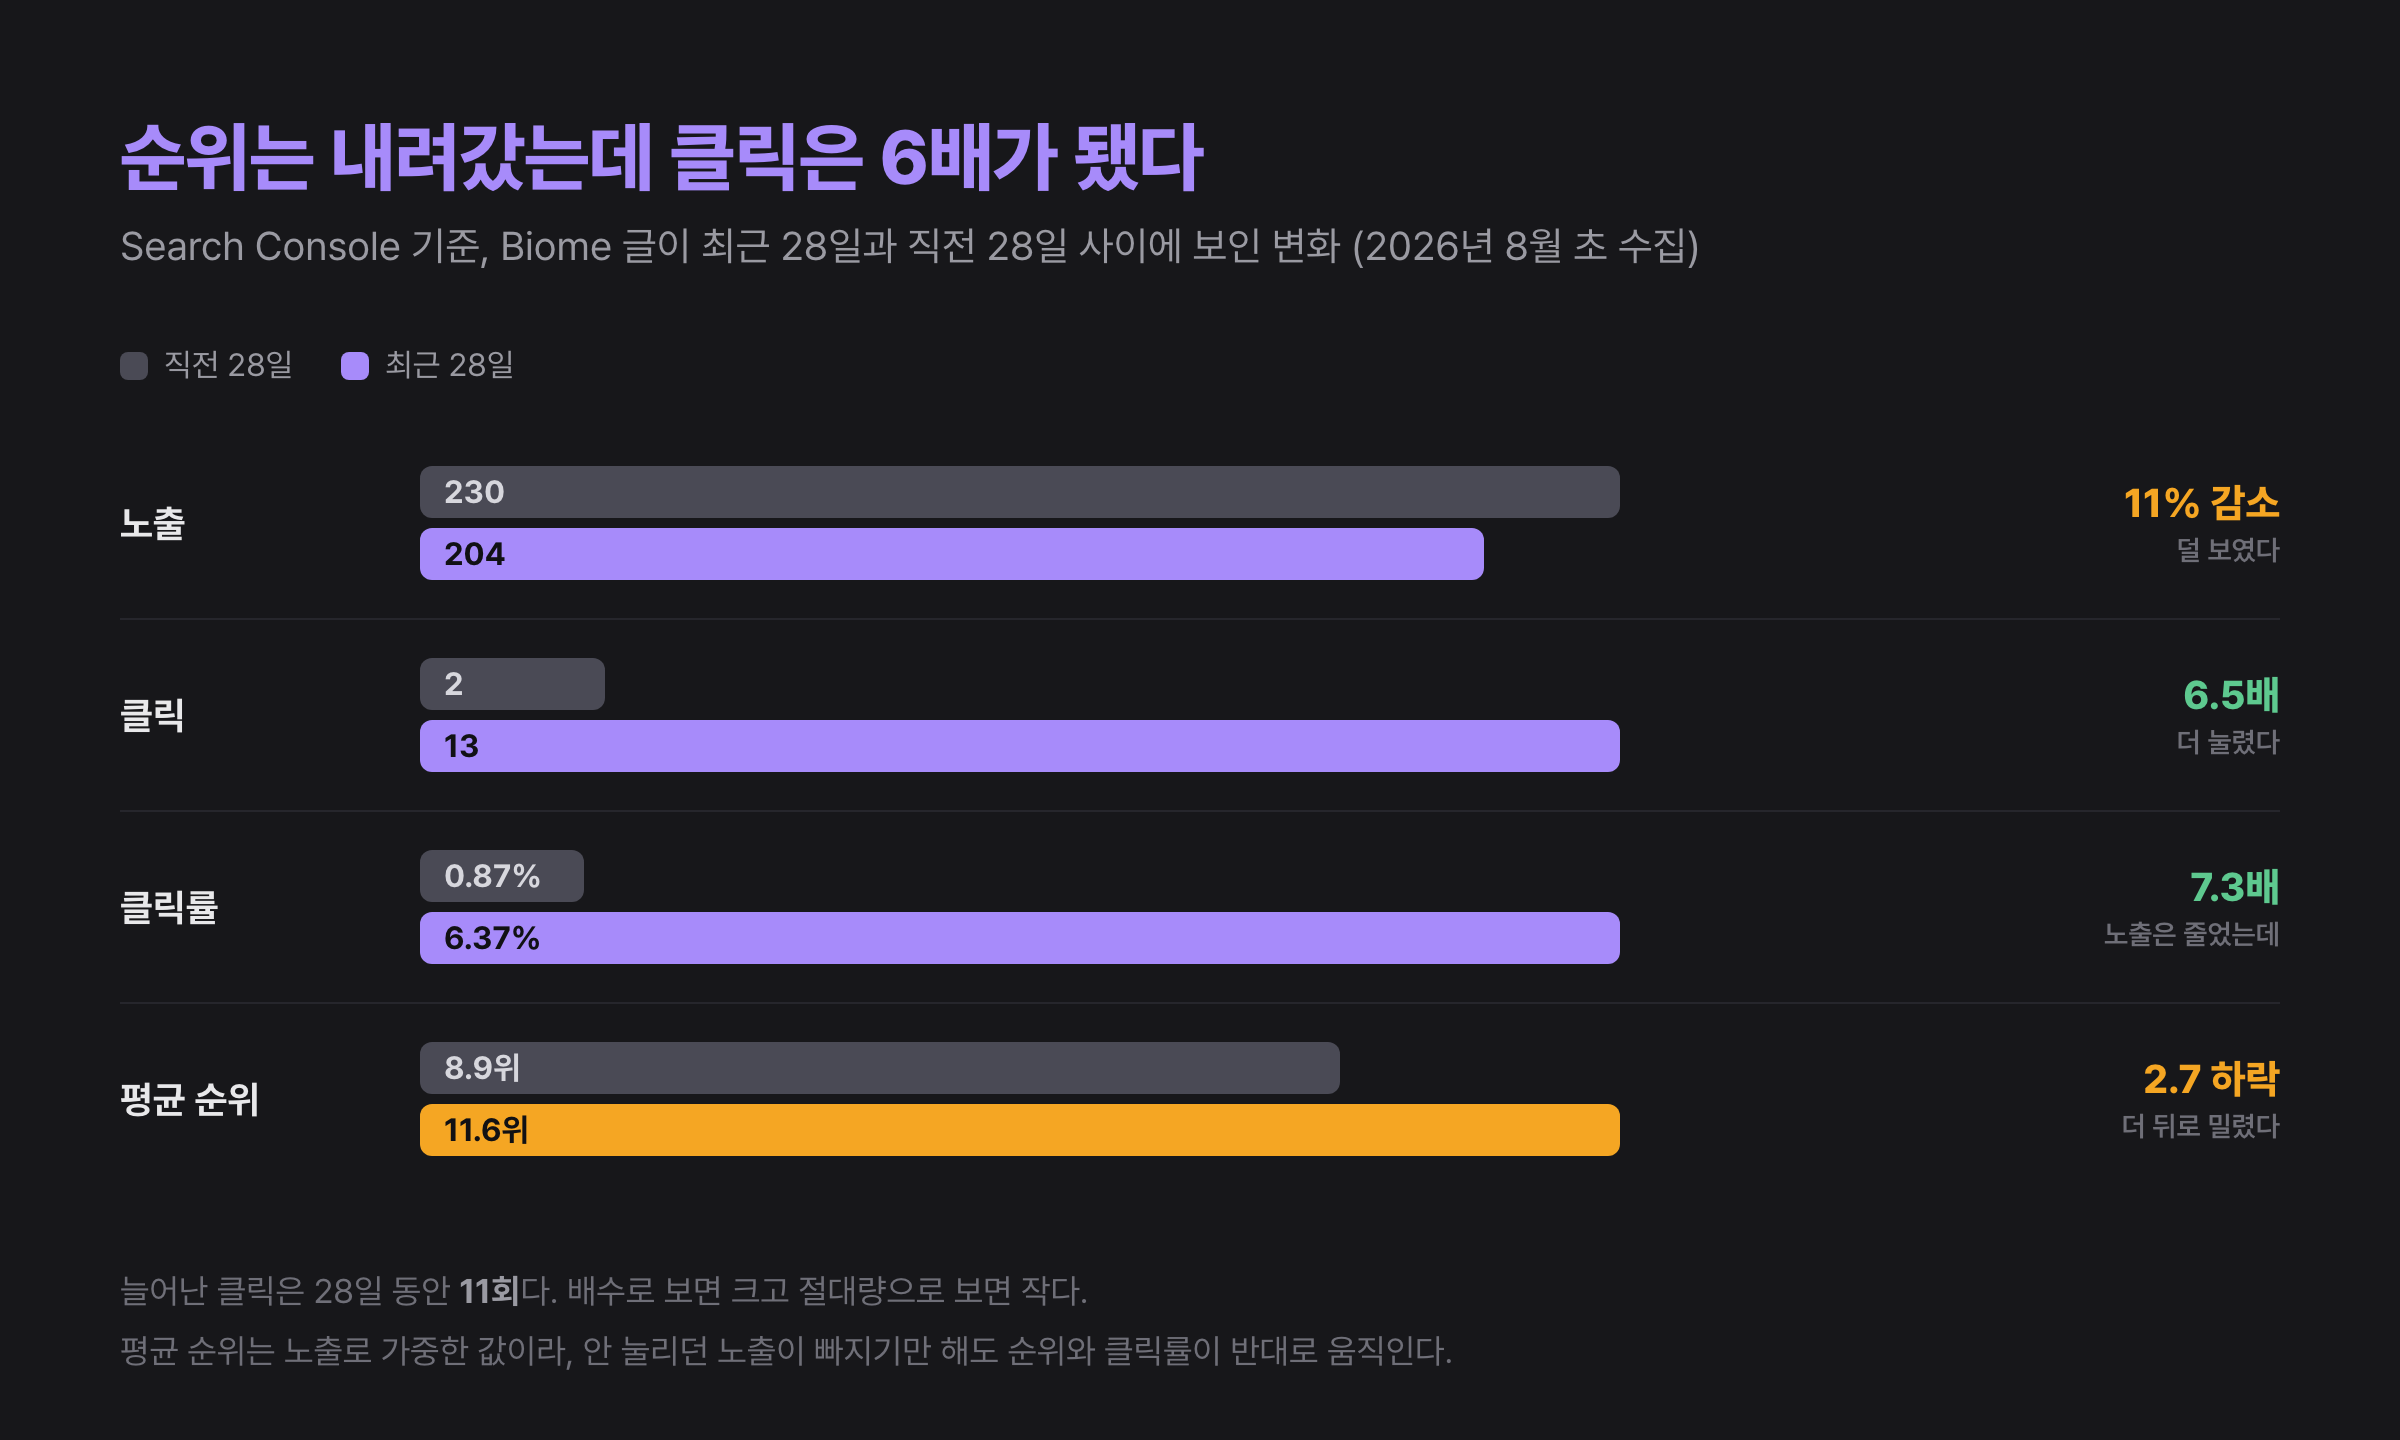
先に冷や水を浴びせておくのが正直だろう。この数値は、タイトル修正の効果を証明しない。平均positionは表示で重み付けした平均なので、上位に出ても誰もクリックしなかった表示が消えるだけで、順位は悪化しCTRは機械的に上がる。期間ごとのquery mixや季節性も変わりうるし、増えたクリックの絶対量は28日間で11回だ。倍率で見れば大きく、絶対量で見れば小さい。
それを踏まえても残るものがある。順位を成果と見るなら手を入れるべき記事で、実際の流入を成果と見るなら良くなった記事だ。**何を結果指標として選ぶかが、同じデータの結論を変える。**私が順位の下落だけを見ていたら、うまく回り始めた記事をまた作り直していただろう。
9月に再照会した数字
このシリーズをまとめながら、同じ記事の今の状態を再照会した。過去の作業を記事に書くときは、その状態が今も維持されているかを確認するのが私のルールなのだが、今回も確認してよかった。
9月11日に収集した直近28日で、この記事は表示185回、click 6回、CTR 3.24%、平均position 20.8位だ。クリックはピークだった13回から半分以下に下がり、平均positionは収集時点の順に8.9 → 11.6 → 14.5 → 20.8と、夏の間ずっと後退した。つまり「順位は下がったがクリックは増えた」という逆転の物語は8月初めの比較区間で最も鮮明で、次の区間がその物語を再び揺さぶった。
この再照会が前節の結論を覆すわけではない。今もクリックは修正前の2回より多く、CTRも0.87%より高い。このブログでクリックが記録された検索query六つのうち五つが、「eslint vs biome」のようなこの記事の比較型queryでもある。ただ、教訓が一つ増えた。指標の選択だけでなく、**比較期間の選択も結論を変える。**28日比較一つで物語を完成させれば、次の28日がその物語を壊す。そして、平均positionがなぜ後退し続けるのかは、まだ分からない。表示されるqueryの構成が変わったのかもしれないし、競合する文書が増えたのかもしれない。確認するまでは未解決のままにしておく。
仮説から始める接続
データをつなぐというと、まずuser idとsession idを統一しようという考えが浮かぶ。もちろん、trace id、release、route、timestampのような共通のディメンションがあれば分析は楽になる。しかし、すべてのデータを個人単位でjoinすることが目標になってはいけない。
Search Consoleのqueryは個人と結び付けられないし、結び付けてもいけない。同意していないユーザーのGA eventは存在しないかもしれない。Sentryのeventには、ユーザーを識別する必要のないエラーも多い。
だから、まず仮説の観測単位を決めるほうがよい。
| 仮説 | 適切な観測単位 |
|---|---|
| 新しいrelease以降、決済エラーが増えた | releaseごとのerror rateとkey event completion |
| mobileユーザーが記事を読み始めるのが遅い | deviceごとのLCP分布とengagement event |
| 特定の検索意図にlanding pageが合っていない | query clusterごとのimpression・CTRとpageごとの行動 |
| fallbackがユーザーに見えないまま繰り返される | fallback reasonごとのeventと影響を受けたsessionの比率 |
仮説が先にあれば、個人識別子がなくても集計レベルで十分に答えられる場合が多い。先のBiome記事の事例もそうだ。私に必要だったのは、その記事をクリックしたユーザー個々人ではなく、query構成とクリックの28日単位の比較だった。観測の精密さとユーザー追跡の精密さは同じ言葉ではない。
相関関係の限界
観測データをつなぐときに最もよくある間違いは、同じ時期に動いた二つの値を因果関係として読むことだ。
LCPが悪化した週に転換率が下がったとしよう。性能が原因かもしれないが、campaign流入、価格変更、在庫、季節性、device mixの変化もありうる。全体の平均同士を比較すると、mobile流入が増えただけでも二つの値は一緒に動きうる。私がseoTitleの修正とクリック増加をすぐに因果で結ばなかったのも同じ理由だ。二つの出来事が時間順に続いたという事実だけでは足りない。
次の順序で質問を絞れば、性急な結論を減らせる。
- 同じ時間帯に変化したか
- 同じユーザー環境とrouteでも関係が残るか
- 特定のreleaseや変更時点と噛み合うか
- エラーと性能の前後関係をeventレベルで確認できるか
- 修正または実験の後、予想した方向に戻るか
観測データは原因候補を絞るのに強い。因果関係を確定するには、統制された実験や自然実験、再現可能な変更が追加で必要だ。
分布と比率
システムとユーザー体験は、平均に圧縮するほど重要な集団が消える。
平均LCPが2秒でも、一部のmobileユーザーは8秒を経験しているかもしれない。全体のerror rateが低くても、新しいreleaseを受け取った特定のbrowserだけに集中しているかもしれない。CTRが上がっても、impressionが急減していれば、届いたユーザーの構成自体が変わったのかもしれない。Biome記事のCTR 6.37%が、まさにこのケースだった。
だから、次のような組み合わせが必要だ。
- 性能:medianだけでなくp75とp95
- エラー:event countだけでなくaffected userとsessionの比率
- 行動:event数だけでなくeligible userに対する完了率
- 検索:CTRだけでなくimpression、click、query mix
- デプロイ:全期間だけでなくrelease前後と段階的デプロイの区間
比率の分母も一緒に保存すべきだ。checkout error 100件だけを見ると大きな問題に見えるが、試行100件中の100件なのか、100万件中の100件なのかで判断は変わる。
同意とデータ品質
ユーザー観測を深く扱うほど、プライバシーと同意の問題を、後から付け足す法的チェックリストとして扱いにくくなる。何を収集できるかが、どんな分析が可能かを決めるからだ。
GoogleのConsent Modeの公式ドキュメントは、ユーザーの同意状態に応じてtagとSDKの保存および送信の動作を調整する方式を説明している。Basic modeは同意前にtagをブロックする。Advanced modeはデフォルトの同意状態でtagを読み込み、同意が拒否されている間はcookieなしの測定シグナルを送って、より具体的なmodelingに活用できる。
ここで重要なのは、modeled dataとobserved dataを同じものと見なさないことだ。設定と適格条件によってはレポートにbehavioralまたはkey event modelingが適用されうるので、画面の数字が常に直接観測したeventの単純な合計だと仮定してはいけない。
観測設計には、次の質問が含まれるべきだ。
- このデータは意思決定に本当に必要か
- 個人を識別せず、集計レベルで答えられるか
- ユーザーが拒否したとき、何が収集されなくなるか
- 削除と保持期間を運用できるか
- SDKのデフォルトは自分たちのサービスのポリシーと一致するか
集めるデータを減らせば、分析の機会は減るかもしれない。同時に、不要なノイズとリスクも減る。良い観測は最大限の収集ではなく、目的に合った最小限の収集に近い。
失敗と成功の定義
何を最小限に収集するかは、結局サービスが成功と失敗をどう定義するかにかかっている。ツールはerror count、latency、session、conversion、CTRを計算してくれるが、どの値がサービスの失敗で、どの値が成功なのかを決めてはくれない。
HTTP 200を返しても、核心のデータが空なら失敗かもしれない。逆に、外部APIが失敗しても、素早くfallbackを見せてユーザーが目的を達成したなら、サービスは成功したのかもしれない。検索positionが下がっても、望むユーザーのclickが増えたなら、プロダクトの結果は良くなったのかもしれない。
この判断のためには、技術指標とユーザーの結果の間に明示的な文章が必要だ。このブログで私が実際に決めた文章はこうだ。
- ユーザーは、検索結果から期待した記事を見つけられなければならない。
- 記事の主要コンテンツは、mobile p75で決めた時間内に表示されなければならない。
- 付随的な統計が失敗しても、本文を読むことが遅れてはならない。
- 予約された収集ジョブが実行されなければ、運用上の失敗と見なす。
この文章ができれば、必要なmetricとalert、eventが付いてくる。逆に、ツールのデフォルトのdashboardから点けると、測定可能なものを重要なものと錯覚しやすい。
観測の結果を判断に変えるエンジニアの役割は、データを最もよく知る人になることではない。ユーザーの期待を、システムが検証できる条件に翻訳する人になることだ。
アラートは何に掛けるべきか
失敗の定義が文章としてできると、次の質問がすぐに付いてくる。どこにアラートを掛けるのか。
GoogleのSRE初期にRob Ewaschukが書いたアラート哲学のドキュメントは、人を呼び出すアラートは緊急で、重要で、対処可能で、実在しなければならないと釘を刺している。そして、原因ではなく症状にアラートを掛けよと勧める。500レスポンスやユーザーに見えるエラーのような、外に現れるシグナルに掛けよということだ。
ところが、この原則と私が経験したことの間には微妙な緊張がある。システム観測の記事で扱ったように、このブログの失敗は500ではなく、200レスポンスと空の統計だった。症状ベースのアラートは、失敗が外に現れるという前提の上に立っているが、成功に分類された失敗はまさにその前提を破る。
だから私は、この原則に反論すべきだとは思わない。むしろ、何を症状として定義するかこそが、この仕事の本当に難しい部分だという結論に達した。このブログで症状はステータスコードではなく「統計照会関数がデフォルト値を返した」であり、それは手で計測を植え付けて初めて症状になりえた。前の節で、失敗と成功を先に文章で決めようと言った理由がここにある。その文章があって初めて、アラートを掛ける症状が決まる。
同じドキュメントが付け加える助言も心に留めておく価値がある。騒がしいアラートは消す方向に傾け、ということだ。過剰なモニタリングは、過少なモニタリングより解きにくい問題だからだ。ちなみに、GoogleのSRE本は、ポストモーテムを書くべきトリガーの一覧にモニタリングの失敗そのものを含めている。観測データを集める装置が静かに止まることも失敗だ。このブログなら、毎週回るSearch Consoleの収集が、ある週に回らないことがその一覧に入る。
データの間の翻訳
アラートまで掛け終えたら、残る仕事は、ユーザーの期待をブラウザRUM、Sentry、GA4、Search Consoleの異なるquery languageとschemaに移すことだ。この地点でAIが担える役割は、結論の生成よりも、一つの質問を各データソースで検証可能な形に翻訳することだ。
たとえば、次のような流れが可能だ。
- 自然言語の質問を、各システムのAPI queryとSQLに変換する。
- 異なるタイムゾーンとdimensionを合わせる変換を作る。
- 分布が変わるsegmentと、予想外の反例を探す。
- 関連するrelease、code path、公式ドキュメントを一緒に集める。
- 次に確認する仮説と、追加計測の候補を提案する。
OpenTelemetryのsemantic conventionが重要な理由もここにある。同じ意味の属性をサービスごとに違う名前で送れば、AIもまずschemaを推測しなければならない。共通の名前と単位、stabilityを守れば、ツールと人がシグナルをつなぎやすくなる。
AIが分析を手伝っても、検証の手続きは減らない。
- 生成したSQLが、重複eventとtimezoneを正しく処理しているか確認する。
- APIが全rowを返すのか、top rowだけを返すのか確認する。
- 平均と百分位数、ユーザー数とイベント数を混同していないか確認する。
- modeled dataと、直接観測されたデータを区別する。
- 小さな標本の偶然の変化に、過剰な説明を付けない。
つまり、AIの長所は、質問を実行可能なqueryに変え、比較の軸を広げることにある。結果がどの標本とどの集計ルールから出たのかを確認する責任は、そのまま残る。
プロダクト能力としてのフィードバックループ
質問をqueryに変えるコストが下がれば、観測と次の変更の間の時間も縮められる。このとき重要なのは、生成速度だけを上げないことだ。
Google Cloudが発表した2025 DORAレポートは、世界の技術実務者約5千人の調査をもとに、AIの導入がsoftware delivery throughputとproduct performanceには肯定的な関係を、delivery stabilityには否定的な関係を示したとまとめている。DORAは別のインサイト記事で、そのメカニズムをこう説明する。生成段階で節約した時間が検証のオーバーヘッドに再配置され、レビューすべきコードが作られる速度自体が上がるということだ。レポートの要約にあるように、AIはチームを直してくれるというより、すでにあるものを増幅する。(2026年4月に更新されたDORAのROI of AI-assisted Software Developmentレポートも、導入初期の生産性低下を管理する問題を正面から扱っている)
私がより重く受け止めている根拠は別にある。METRが2025年に発表した研究は、熟練したオープンソース開発者16人に、実際のイシュー246件でAI使用の可否を無作為に割り当てたのだが、AIが許可されたイシューでは完了が19%長くかかった。ところが開発者たちは、事前には24%速くなると予想し、実際に遅くなったのを経験した後でも20%速くなったと信じていた。私はこの研究をAIフロントエンドエンジニアで生産性の議論として引用したが、この記事の文脈では違う読み方になる。体感は測定の代わりにならないという根拠だ。体感が信じられないなら測るべきで、先のBiome記事の事例のように、一度測った値も期間を変えて測り直すべきだ。
生成速度が上がれば変更量が増える。同じ比率で欠陥が発生しても絶対数は増え、レビューすべきコードとユーザーへの影響も速く積み上がる。このとき観測が遅ければ、チームはデプロイ速度だけを上げ、学習速度は上げられない。
速いfeedback loopとは、次のステップを短くつなぐ能力だ。
- 変更をデプロイする。
- システムとユーザーに起きたことを観測する。
- 予想と実際の差を見つける。
- 原因の仮説を絞る。
- 次の変更で検証する。
AIは3番と4番の探索を大きく助けられる。しかし、2番で必要なシグナルがなかったり、1番のrelease情報とつながっていなかったりすれば、始めることができない。
だから、AIをうまく使う組織の基盤には、テストだけでなく、観測可能なシステムとユーザー中心の結果指標が必要だ。生成能力よりfeedback loopの品質がボトルネックになるのだ。
観測を判断に変える
このシリーズの3本の記事を一文ずつに畳むとこうなる。ブラウザ観測はユーザーが何を体感したかを見せ、システム観測はその体験がシステムのどこで作られたかを見せ、GA4とSearch Consoleはユーザーがサービスの中で何をし、どんな意図で入ってきたかを見せる。これらのシグナルは一人の完全な記録ではなく、異なる標本から同じ仮説を照らす証拠だ。
したがって、接続の基準はデータ量や個人識別子の精密さではない。仮説に合った観測単位を選び、分母と欠落を記録し、相関関係を修正や実験で再検証しなければならない。プライバシーと同意のために見えないユーザーも、分析の限界に含めるべきだ。そして、一度の比較で得た結論は、期間を変えてもう一度確認すべきだ。私のBiome記事の数値が2か月の間に二度、違う話を聞かせてくれたように、観測は一度の照会ではなく、測り続ける仕事だ。
観測の対象自体も広がっている。OpenTelemetryは、生成AIとMCP呼び出しのためのsemantic conventionを別のリポジトリで整理している最中だ。私たちがAIにより多くの実行を任せるほど、その実行も同じ原則の下の観測対象になる。
AIはこの検証を始めるコストを下げるが、成功と失敗の基準を決めてはくれない。どの体験を守るかをまず文章で決め、必要なシグナルを収集し、結果を次の変更で確認する仕事はエンジニアの持ち分だ。この循環が短く正確なとき、観測はダッシュボードではなくプロダクト能力になる。この記事を読んでいる読者の皆さんも、それぞれのサービスで指標を一つ選び、何を成果と見るかを文章に書いてみて、一度下した結論を期間を変えて再照会してみてほしい。私の経験では、二度目の照会は一度目より多くのことを教えてくれる。