Observabilidade do sistema
Neste post, quero falar sobre observabilidade de sistemas.
Na empresa, trabalho há muito tempo com monitoramento de erros baseado em Sentry. Quando um issue chega, abrir o stack trace, estreitar o escopo com releases e tags e procurar as condições de reprodução é um trabalho que me é familiar. No entanto, este blog não tinha monitoramento de erros, e só em agosto passado acoplei o Sentry em uma configuração só de servidor. E mal o fiz, essa instrumentação capturou um incidente real. A segunda metade deste post é o registro de investigar esse incidente, acreditar que estava corrigido, medir de novo e confirmar que essa crença estava errada.
Em Observabilidade do navegador, vimos que dados o navegador deixa sobre rede, renderização e entrada do usuário. Mas encontrar uma requisição lenta no navegador não encerra o problema. É preciso seguir se essa requisição foi lenta no CDN, esperou no servidor de API, travou em uma chamada ao banco de dados, ou capturou uma falha e devolveu um valor padrão.
Este post parte de um único evento de erro e acompanha como cada sinal complementa as perguntas que o sinal anterior não conseguia responder. Com breadcrumbs restauramos o tempo imediatamente anterior, com traces e metrics encontramos o caminho e o alcance do impacto, e com profiles e Replay confirmamos o custo de execução e o contexto na tela. No final, a pergunta se amplia para o que instrumentar como falha, incluindo os eventos que não aconteceram e as falhas dentro de respostas bem-sucedidas. O incidente que vivi ficava exatamente sobre essas duas categorias.
Para engenheiros de frontend, essa fronteira está cada vez mais borrada. Uma requisição que começa em um componente React continua para Server Components, route handlers, APIs externas, queues e background jobs. O sintoma que aparece na tela está no navegador, mas a causa pode estar em outra camada do sistema.
Antigamente, entrar nesse território exigia conhecer primeiro o formato de logs e as ferramentas operacionais de cada servidor. Hoje, em um produto como o Sentry dá para transitar entre um erro e seus trace, profile e replay relacionados, e o OpenTelemetry oferece um protocolo comum para que ferramentas diferentes troquem sinais.
Isso não significa que a observabilidade se complete sozinha. Quais sinais deixar, com quais identificadores conectá-los e o que chamar de falha são decisões que quem construiu o sistema precisa tomar.
O contexto de um único erro
O ponto de partida mais familiar é o evento de erro. Quando uma exceção acontece, enviar a mensagem e o stack trace permite saber em que código a falha ocorreu. Mas o que a depuração realmente precisa, mais do que o objeto da exceção, é o contexto ao redor dele.
A documentação de Issue Details do Sentry mostra que a um evento podem se juntar não só o stack trace, mas também breadcrumbs, tags, context, release, trace, replay e attachments. Cada elemento responde a uma pergunta diferente.
| Informação | Pergunta que responde |
|---|---|
| stack trace | Em qual caminho de código a exceção ocorreu |
| source map | A posição do bundle implantado pode ser restaurada para o arquivo e a linha do código original |
| breadcrumb | Que requisições e ações do usuário houve antes da exceção |
| tag | Em qual navegador, release, rota ou funcionalidade ela se repete |
| context | Quais valores estruturados são necessários para entender este evento |
| release·commit | Em qual deploy apareceu pela primeira vez e de qual mudança está perto |
| trace | O que aconteceu em outros serviços e spans do mesmo fluxo de requisição |
| replay | Por quais estados o usuário realmente passou na tela |
O que importa nessa distinção é a capacidade de busca. As tags do Sentry são pares key-value projetados para busca e filtro na UI, enquanto o context é uma área para ler valores estruturados no detalhe do evento e não é alvo de filtros na UI. Colocando tudo no context, cada evento individual fica rico, mas perguntas recorrentes como "em qual tipo de cliente isso aumentou" ficam difíceis de responder.
Ao contrário, enviando todo valor como tag, a cardinality e o custo de armazenamento crescem. Atributos cujos valores se multiplicam sem limite, como e-mails, URLs completas ou mensagens de erro arbitrárias, dificilmente servem como tags. Projetar a instrumentação é o trabalho de anexar informação e, ao mesmo tempo, o trabalho de decidir quais perguntas serão buscadas repetidamente. Na investigação minha que veremos adiante, o papel decisivo não foi de um stack trace, mas de uma única tag que eu tinha deixado quase de passagem.
Instrumentação acoplada só no servidor
O Sentry deste blog é só de servidor. Não coloquei o arquivo de inicialização do SDK de navegador. Decidi não pagar o custo de bundle de cliente que a instrumentação de navegador acrescenta; o objetivo da adoção era capturar chamadas que falham em silêncio no servidor, e essa parte era praticamente de graça. Por isso, o que é capturado e o que não é se separa. Erros de route handlers e componentes de servidor, e falhas das consultas ao Google Analytics executadas no servidor, são capturados. Erros que só acontecem no navegador, como event handlers de componentes de cliente ou divergências de hidratação, não são.
Nessa configuração, havia duas coisas que eu queria verificar por conta própria.
Uma é o alcance do hook automático. Se o hook onRequestError do Next.js estiver ligado, erros de rota não tratados também são capturados sem chamar captureException diretamente. Confirmei subindo em um Deploy Preview uma rota temporária que lançava uma exceção de propósito, e os eventos chegaram carimbados com o mechanism auto.function.nextjs.on_request_error.
A outra são os source maps. Antes de aplicá-los, o culprit de um evento de produção era uma posição de bundle ofuscada como y([root-of-the-server]__468aa3ae._). Depois de subir os source maps, o mesmo tipo de evento passou a se resolver até o caminho src/..., o número da linha e até o código-fonte ao redor. É o ponto em que a pergunta respondida pela segunda linha da tabela realmente se separa.
Deixo aqui uma nota lateral. Depois do upload, era preciso apagar os arquivos .map do resultado do build. Os source maps de servidor que o Turbopack produz têm 57MB, mais que o JS de servidor (15MB), e, se deixados lá, embarcam inteiros no bundle da função implantada. Havia justamente a opção deleteSourcemapsAfterUpload, que apaga os source maps depois do upload, então a ativei; mas, ao medir, mesmo logo depois do upload os .map de servidor continuavam lá, com os 57MB intactos. Essa opção só apaga .next/static e não toca em .next/server, que é onde está o volume de verdade. Acabei mudando para especificar diretamente os caminhos a apagar e, pelo mesmo motivo, deixei de silenciar sempre os logs de upload e os tornei condicionais. Com os logs desligados, se o upload falhar por inteiro porque um token expirou, ninguém fica sabendo até ver o próximo stack trace ilegível. Ler a documentação e ativar uma opção é uma coisa diferente de confirmar que essa opção fez o que se esperava.
A diferença entre grupo e causa
O Sentry agrupa eventos parecidos em um único issue. No grouping padrão, o stack trace é o sinal central, e informações como exception e message também são usadas. Se necessário, dá para mudar o critério de agrupamento com fingerprints.
Mas o mesmo issue não significa necessariamente a mesma causa. Se uma função comum que envolve fetch() lança os erros de rede a partir de um único lugar, uma falha de DNS, uma credencial expirada e uma resposta 500 do upstream podem se misturar em um mesmo grupo. Ao contrário, se a mesma causa produz exceções diferentes em vários caminhos de código, ela se divide em vários issues.
Um issue é um pacote de ocorrências a investigar, não uma tabela de classificação de causas de domínio. Usar o grouping como está para contagem de incidentes ou KPI de produto faz perder essa diferença.
Se necessário, dá para ajustar os fingerprints ou adicionar um domain error code como tag. Mas refinar cedo demais as regras de grouping significa perder as melhorias padrão do SDK enquanto só as regras operacionais se acumulam. Eu acho melhor a ordem de primeiro olhar a distribuição real de eventos e confirmar quais perguntas o grouping padrão está bloqueando.
A linha do tempo da falha
Um erro geralmente deixa só a última cena. O breadcrumb anexa, em ordem cronológica, o que aconteceu antes. Além de navigation, cliques, console messages e HTTP requests do navegador, também é possível incluir mudanças de estado registradas pela própria aplicação.
Parece com o log tradicional, mas o propósito é um pouco diferente. Um repositório de logs é forte para buscar eventos do serviço inteiro; o breadcrumb é forte para restaurar a pequena linha do tempo imediatamente anterior a um erro específico.
Por isso, uma mudança de estado importante pode ser necessária nos dois lugares. Se o estado de um pagamento mudou de pending para failed, nos logs operacionais agrega-se a taxa de falha geral, e nos breadcrumbs do evento de erro vê-se a sequência daquele único usuário. Não é copiar o mesmo fato, e sim criar unidades de busca diferentes.
A documentação de Logs do OpenTelemetry descreve como conectar automaticamente os logs existentes anexando os identificadores do trace e do span ativos. A verdadeira utilidade dos logs não está no número de linhas, mas nos pontos de conexão que permitem se mover para outros sinais.
O caminho onde a latência surgiu
Se o erro responde "o que quebrou", o trace responde "por onde uma requisição passou e onde usou o tempo".
Um trace é um conjunto de spans. O carregamento do documento no navegador, fetch, o route handler do servidor, chamadas a APIs externas, consultas ao banco de dados e background jobs podem, cada um, virar um span. Se compartilham o mesmo trace_id, podem ser reconstruídos como um único grafo da requisição.
Essa conexão não surge automaticamente. Ao cruzar a fronteira de uma requisição, é preciso repassar o trace context. O padrão Trace Context do W3C define o formato dos headers traceparent e tracestate. É a língua comum mínima que permite emendar a mesma requisição mesmo entre fornecedores diferentes.
No frontend, aqui também há condições.
- Enviar trace headers para todos os domínios externos pode gerar exposição de informação e problemas de CORS.
- É preciso limitar o escopo para que o SDK do navegador repasse o context apenas às API origins permitidas.
- O servidor e o upstream também precisam preservar ou transformar os mesmos headers.
- Se cada serviço tomar suas decisões de sampling por conta própria, o meio do trace fica vazio.
Quando um trace se rompe, em vez de concluir que não há dados, é preciso confirmar em qual fronteira o context desapareceu. O tracing distribuído do navegador até o servidor depende menos da instalação do SDK do que do design da context propagation.
Fronteiras que merecem um span
A instrumentação automática captura bem as fronteiras de biblioteca: HTTP requests, chamadas ao DB, o lifecycle do framework. A documentação de Instrumentation do OpenTelemetry explica que a zero-code instrumentation é útil como ponto de partida, mas que, para ver as decisões internas da aplicação, é preciso code-based instrumentation.
Por exemplo, só com um span automático dizendo que a API de pedidos inteira levou 800ms é difícil saber por que ficou lenta. Podem ser necessários spans de domínio como este.
await tracer.startActiveSpan('checkout.calculate-discount', async (span) => {
  span.setAttribute('promotion.type', promotionType)

  try {
    return await calculateDiscount(cart)
  } finally {
    span.end()
  }
})
Porém, se for criado um span por função, o trace vira um registro de execução do código. A meta da observabilidade não é armazenar todas as chamadas, e sim distinguir hipóteses sobre latência e falha.
Uma boa fronteira de span costuma ser uma destas.
- Fronteiras onde muda o responsável pela falha, como rede, DB ou queue
- Fronteiras onde o caminho de execução se bifurca, como cache hit e miss
- Fronteiras onde o resultado de domínio se bifurca, como aprovação de pagamento ou decisão de permissão
- Trabalhos cujo orçamento de latência precisa ser gerenciado à parte
Se, olhando um span, não dá para dizer quem fez o quê e quanto, é preciso rever a fronteira ou o nome.
Da distribuição ao caso
Guardar todos os traces encarece rápido. Por isso, o comum é ver o estado geral do sistema com metrics e descer ao trace para as requisições concretas do trecho anômalo.
A documentação de Signals do OpenTelemetry distingue trace, metric, log e baggage como telemetry signals diferentes. Na documentação de Profiles à parte, o sinal de profile aparece marcado como Alpha em setembro de 2026. O modelo de dados e a via de transporte OTLP já existem, mas não se deve presumir que esteja no mesmo nível dos sinais estabilizados.
As forças de cada sinal são estas.
| Sinal | Força | Fraqueza |
|---|---|---|
| metric | Tendência geral, taxas, distribuições, alertas | Pouco contexto da requisição individual |
| trace | O caminho e a latência de uma requisição | Guardar tudo custa caro |
| log | Registro detalhado dos fatos e busca livre | Formato e cardinality se degradam com facilidade |
| profile | A posição do código que usou CPU e memória | Sem conectar à requisição, o impacto no usuário se dilui |
Esses sinais não competem entre si. Por exemplo, encontra-se no latency histogram a faixa em que o p99 piorou, abre-se uma requisição lenta com um exemplar ou trace id, e olham-se os logs e o profile daquele span.
O Grafana Tempo, segundo sua documentação oficial, oferece uma estrutura que gera metrics a partir de traces e os conecta aos logs do Loki e às metrics do Prometheus. A vantagem da stack open source é poder projetar como os sinais são armazenados e conectados sem ficar preso às telas de um SaaS específico. Em troca, é preciso operar por conta própria o Collector, o storage, a retention, o desempenho das queries e as atualizações.
Onde mora o custo de execução
Pelo trace se soube que certo span levou 2 segundos, mas pode não se saber onde a CPU foi usada dentro dele. O profile preenche essa lacuna registrando amostras de execução por função e o resource usage.
Aqui também as perguntas do trace e do profile são diferentes.
- trace: por quais serviços e trabalhos a requisição do usuário passou
- profile: quais funções usaram a CPU durante esse tempo
Em 2025, o Sentry anunciou Continuous Profiling e UI Profiling, distinguindo-os do produto de profiling existente. O Continuous Profiling olha o resource usage de longa duração nos runtimes de servidor suportados, e o UI Profiling olha o custo de execução das sessões de usuário. No início, o foco era iOS·macOS e Android, mas desde dezembro de 2025 Browser JavaScript e Electron também suportam UI Profiling.
Ainda assim, nem todo runtime é medido do mesmo jeito. No navegador, o CPU profile do DevTools e os Long Animation Frames podem ser ferramentas mais diretas para escavar uma sessão específica. Mais do que o nome do produto, é preciso confirmar as platforms suportadas, o método de sampling, o overhead de coleta e o alcance da conexão com o trace.
A reconstrução da sessão
Quando um usuário diz "o botão não funcionou", só com erros e traces é difícil saber o estado da tela. O Session Replay conecta mudanças do DOM, entrada, navigation, console e informações de rede em uma forma reproduzível.
A FAQ de Session Replay do Sentry explica que o replay não é um vídeo que grava pixels, e sim o resultado de registrar o DOM do navegador e reconstruí-lo depois. Por isso, pode não ser exatamente igual à tela original, e canvas e recursos externos têm condições à parte.
Essa diferença também importa do ponto de vista da privacidade. No DOM há valores de entrada, informações de conta e conteúdo de publicações. O Web Replay SDK do Sentry traz como padrão mascarar texto e bloquear mídia, mas isso não torna automaticamente seguros a estrutura do DOM da aplicação e os custom components. A coleta de bodies de request e response também deve ser permitida explicitamente só para as URLs necessárias.
Antes de ligar o Replay, é preciso decidir primeiro o seguinte.
- Quais erros e sessions deixar como amostra
- Quais áreas do DOM e entradas mascarar ou bloquear
- Se é preciso coletar os network bodies e headers
- Quem pode ver os replays e por quanto tempo conservá-los
- Se o custo do SDK e da serialização do DOM vale a pena ser pago pelo usuário
Quanto mais forte o contexto do Replay, mais forte também o seu alcance de coleta. A decisão entre a capacidade de depuração e a minimização de dados não deve ser deixada só para os padrões do produto. (Este blog não usa Replay. Como é um serviço em que o desempenho de carregamento é a premissa da visibilidade na busca, julguei que o custo pago pelo visitante supera as respostas que a coleta daria.)
A falha que se revela pela ausência
Erros, traces e Replay mostram em profundidade o contexto dos fatos ocorridos. Mas, se um trabalho agendado nem sequer começou, não há fato algum a registrar.
Um cron monitor recebe como check-ins os estados de início e conclusão do trabalho e pode gerar um estado missed se o sinal não chegar no horário previsto. Aqui, o objeto de observação não é um erro lançado pelo código, e sim a ausência do evento esperado.
Para mim, isso não é história alheia. Este blog coleta automaticamente dados do Search Console toda segunda-feira, e, se em alguma semana esse trabalho silenciosamente não rodar, hoje não tenho como saber. Como não houve falha, e sim nada aconteceu, nenhum erro é gerado. O próprio dispositivo que reúne os dados de observação está em um ponto cego.
Essa perspectiva também se aplica a health checks, queue consumers e pipelines de coleta de dados. Só com a metric de "zero eventos de falha" não dá para saber se há saúde. É preciso olhar junto se havia entradas a processar, quando foi o último sucesso e se o volume processado está na faixa habitual.
O que torna a observação difícil costuma ser, mais do que os fatos ocorridos, os fatos que não ocorreram. E esta frase volta mais uma vez, adiante, de um jeito que eu não esperava.
A falha dentro da resposta bem-sucedida
Ao contrário, também há falhas em que o fato ocorreu, mas fica invisível por ter sido classificado como sucesso. O que encontrei assim que acoplei a instrumentação foi exatamente desse tipo.
O plano inicial era simples. Colocando o relatório de erros no catch do route handler da API de estatísticas, eu saberia quando a consulta ao Google Analytics falhasse. Mas, ao fazê-la falhar de propósito em um build de produção local injetando uma chave de conta de serviço inválida, o erro não chegava ao catch da rota. Os quatro blocos catch do módulo de consulta de estatísticas, uma camada abaixo, o capturavam primeiro e devolviam valores padrão, e a resposta saía assim.
HTTP 200 OK
{ "slug": "/260610", "views": 0 }
O visitante vê as estatísticas como 0, e o servidor responde que está tudo bem. Olhando só a taxa de erro e o uptime da rota, nada aconteceu. A condição de sucesso do sistema e a condição de sucesso do usuário eram diferentes. (Em qual camada colocar o catch eu já tratei em Tratamento de erros; naquela época a pergunta era "onde devemos capturar", e desta vez encontrei o "capturamos e ninguém fica sabendo".)
Então movi os pontos de instrumentação da rota para aqueles quatro lugares, e coloquei uma tag que distingue em qual consulta cada um estourou. Essa tag desempenha adiante um papel decisivo.
Essa situação já tem um nome preciso. O paper de Gray Failure, que a Microsoft e o time do Azure apresentaram na HotOS de 2017, diz que os grandes acidentes de disponibilidade na nuvem em geral não são do tipo que para por completo, e sim vêm dessa zona cinzenta, e define assim a sua característica central.
Sustentamos que uma característica-chave do gray failure é a differential observability: que os detectores de falha do sistema podem não perceber os problemas mesmo quando as aplicações estão sofrendo com eles.
we argue that a key feature of gray failure is differential observability: that the system's failure detectors may not notice problems even when applications are afflicted by them.
Um sujeito está sofrendo o dano da falha enquanto outro sujeito não a percebe, e o problema é que este último é o lado responsável por detectar a falha. Descer meu ponto de instrumentação da rota para a camada inferior foi exatamente o trabalho de fechar essa lacuna de percepção.
A solução não é transformar em falha toda devolução de valor padrão. O fallback pode ser a escolha certa para proteger a experiência do usuário. Em vez disso, é preciso deixar como sinais separados o fato de o fallback ter rodado, a latência da chamada original e a funcionalidade afetada.
try {
  return await fetchAnalyticsStats()
} catch (error) {
  captureException(error, { tags: { gaQuery: 'stats' } })

  return { totalPageViews: 0, todayVisitors: 0 }
}
O que precisa ser observado não é a exceção, e sim o fato de o sistema ter saído do seu caminho normal.
A chamada ao GA pendurada por 65 segundos
O primeiro issue real de produção que chegou depois de mover os pontos de instrumentação é a próxima cena desta história. Uma chamada ao GA estava falhando com DEADLINE_EXCEEDED depois de 65,877 segundos. Mas, pela estrutura vista acima, a resposta continuava sendo 200. Na época, a home usava renderização dinâmica e transmitia por streaming a área de estatísticas, então a página em si aparecia na hora. Em vez disso, aquele espaço ficava muito tempo em estado de carregamento e depois se enchia de zeros em silêncio.
Escavando a causa, no arquivo de configuração da biblioteca cliente do GA que uso estava gravado isto.
"RunReport": { "timeout_millis": 60000, "retry_params_name": "default" }O timeout RPC padrão da biblioteca é de 60 segundos, e meu código não passava timeout em nenhum dos cinco pontos de chamada. Não é um erro só meu, e sim um tipo de erro sobre o qual se alerta amplamente. O artigo sobre deadlines do blog oficial do gRPC, escrito por Gráinne Sheerin, do Google SRE, tem como primeira linha abaixo do título "TL;DR: Always set a deadline", e explica que, sem deadline, uma requisição em andamento pode segurar recursos e ficar pendurada até o timeout máximo. O cliente do GA que uso também é baseado em gRPC, então a documentação já alertava sobre o mesmo princípio, mas os pontos de chamada não o estavam respeitando.
A correção foi fixar o timeout em 5 segundos e passá-lo a todos os pontos de chamada. E reproduzi de forma determinística levantando um servidor TCP local que não responde.
| Condição | Tempo decorrido | Mensagem de erro |
|---|---|---|
| Sem timeout (antes da correção) | 60,04 segundos | Deadline exceeded after 60.000s |
timeout: 5000 (depois da correção) |
5,00 segundos | Deadline exceeded after 5.000s |
Como os números se moveram conforme o descrito, ficou confirmado ao menos que a configuração do timeout chega ao código. Esclareço uma coisa: o número 5 em si não tem fundamento. Como não medi a distribuição de latência de resposta do GA quando saudável, é na prática um valor escolhido arbitrariamente. Mas a direção tinha onde se apoiar. Embracing Risk, do livro do Google SRE, diz que 100% nunca é a meta de confiabilidade correta. Neste blog, os números de visitantes são informação acessória. Para a experiência do visitante, é melhor desistir rápido e desenhar os valores padrão do que trazê-los com exatidão.
A distribuição medida de novo depois da correção
Até aqui seria o desfecho original desta investigação. Encontrei a causa, reproduzi e corrigi. Mas descobri que, na release em que o commit da correção foi implantado, mais de cem DEADLINE_EXCEEDED da mesma família tinham se acumulado.
Puxei os 100 mais recentes e olhei a distribuição dos tempos reportados. Algo a apontar de antemão: esse valor não é o tempo que o GA realmente usou para responder. É o wall-clock time do momento em que o temporizador do deadline foi armado até o momento em que esse temporizador de fato disparou.
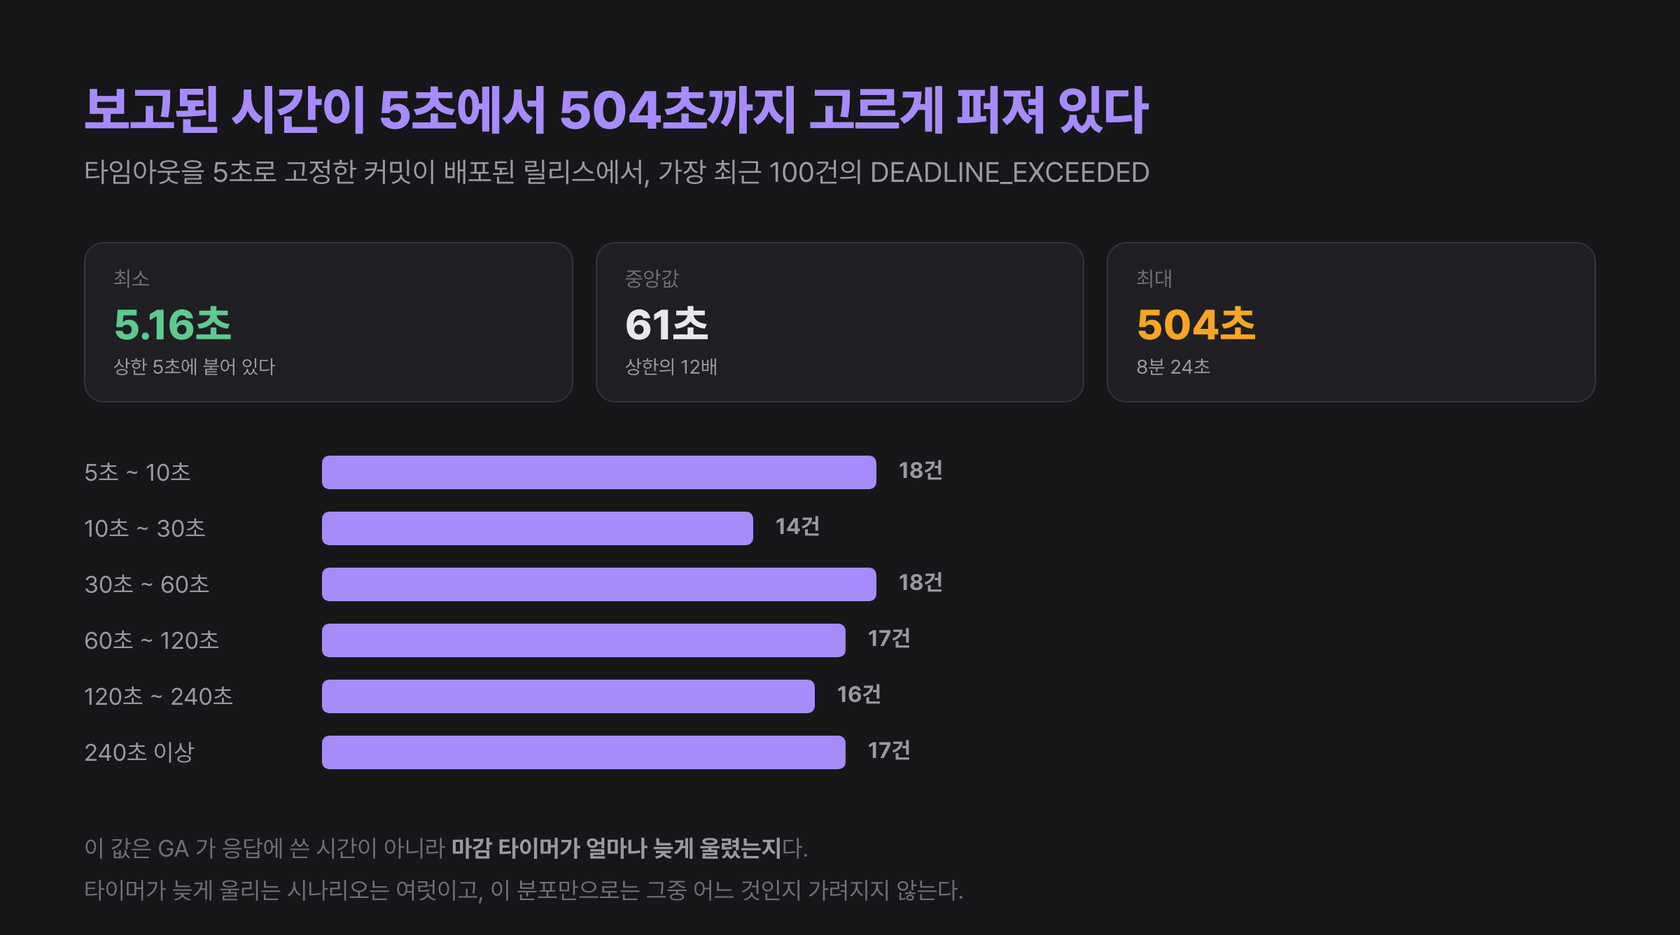
A leitura é esta. O limite inferior foi respeitado. Não há um único caso cortado antes de 5 segundos, e o mais curto é de 5,16 segundos, então a configuração de 5 segundos em si está chegando ao código. Mas, para cima, sobe até 8 minutos e 24 segundos, e a mediana é de 61 segundos. Mais estranho ainda é que os valores não se concentram em nenhuma faixa. Se fossem atrasos causados por um GA de fato lento, deveriam se acumular perto do teto, e não é o caso.
As tags me disseram mais. As únicas tags carimbadas nos 100 casos são stats e popular, e em geral chegam aos pares. O que esses dois caminhos têm em comum é que ambos são rotas de revalidação atrás de um cache de uma hora. Já as rotas restantes, que recebem a requisição do visitante e chamam o GA na hora, sem cache (page, pages), não aparecem nem uma vez entre os 100. Significa que a falha não acontece enquanto a requisição do visitante é atendida, e sim apenas no trabalho que reabastece o cache depois que a resposta termina.
Essa observação abala uma frase que escrevi em uma seção anterior. Escrevi que o espaço das estatísticas ficava muito tempo carregando, mas, se a falha só ocorre no caminho posterior à resposta, o visitante pode nunca ter esperado esse tempo. Havia mais uma frase escrita sem medir.
A hipótese que formulei é esta. Este blog roda sobre funções serverless, e uma função serverless, ao enviar a resposta, congela o ambiente de execução até a próxima invocação. Se nesse meio-tempo o temporizador também para e dispara atrasado quando a função acorda, pode ficar registrado um valor inflado em termos de wall-clock time, e não o tempo realmente esperado. Combina com o limite inferior grudado exatamente nos 5 segundos, com os valores superiores não se concentrarem em lugar nenhum, e também com a observação de que a falha só sai do trabalho posterior à resposta.
Mas aqui é preciso cuidado. A distribuição não contradizer a hipótese e a distribuição apoiar a hipótese são coisas diferentes. Há vários cenários em que um temporizador dispara atrasado. Além do congelamento serverless, uma renderização pesada pode ter segurado o event loop, ou o contêiner pode ter estrangulado a CPU. Também deixei como candidato o fato de o orçamento total de novas tentativas da configuração da biblioteca ser de 600 segundos, e o máximo observado de 504 segundos caber dentro dele. Todos podem produzir uma distribuição com essa mesma forma, então este gráfico não estreita os candidatos.
O que risca um candidato é o tempo de CPU do mesmo intervalo. Se, enquanto passam 61 segundos de wall-clock time, o tempo de CPU é quase 0, cai a explicação de que uma renderização pesada estava segurando o event loop. Esta é a pergunta que o sinal de profile visto antes responde.
Mas o tempo de CPU não encerra a questão. Como, mesmo enquanto se espera de verdade por uma resposta, o tempo de CPU também fica perto de 0, um intervalo de espera e um intervalo parado aparecem com a mesma forma. Para separá-los, é preciso olhar se o tempo fluiu de maneira uniforme dentro desse intervalo. Por exemplo, armando um temporizador que dispara repetidamente em intervalos curtos e vendo se há um ponto em que esse intervalo se abre de uma vez. Se o ambiente de execução congelou, os intervalos saltam; se foi espera de verdade, fluem de maneira uniforme. Medir o relógio só logo antes e logo depois da chamada não resolve. O wall-clock time continua correndo mesmo enquanto a função está congelada, então isso só recriaria o número que já se tem.
Acrescento que essa lista de issues, a distribuição de tags e os valores de tempo eu não vi abrindo um dashboard: acoplei o servidor MCP oficial do Sentry e pedi a um agente. Não foi só o custo de acoplar a instrumentação que caiu; o custo de abrir os dados acumulados também caiu.
O motivo de ter parado não foi a correção
Enquanto escrevia este post, consultei aquele issue de novo. Para confirmar se o que acreditei ter corrigido continua corrigido agora.
Em 14 de setembro de 2026, os issues daquela família estavam parados em 144 casos no total. A última ocorrência foi em 18 de agosto, e desde então são 0 casos em 27 dias. A distribuição de tags foi, até o fim, só o par stats e popular. Olhando só o gráfico de ocorrências, o problema parece ter sumido.
Mas eu, nesse meio-tempo, não fiz nenhuma das medições descritas na seção anterior. Nunca validei a hipótese nem corrigi nada, então por que parou? Cruzando com o histórico de deploys, a resposta estava em outro lugar. A reforma multilíngue commitada no mesmo dia em que o último evento foi registrado tirou da home as áreas de estatísticas de visitantes e de posts populares. As telas que chamam as rotas de revalidação de stats e popular eram exatamente essas duas, então, desde que essa reforma foi implantada em produção, o código que falhava simplesmente não tem ocasião de ser chamado. Não foi o código que falhava que se corrigiu; a tela que o chamava é que desapareceu.
Portanto, este incidente não foi resolvido: o objeto de observação desapareceu. A hipótese do congelamento serverless ficou sem confirmação, e as condições de reprodução para recriar aquela distribuição em produção desapareceram junto. O evento original do primeiro issue, que reportou os 65,877 segundos, passou do período de retenção e já nem abre mais.
Tenho um motivo para deixar esta seção. O resolved da lista de issues não é prova de esclarecimento da causa. Há vários caminhos para as ocorrências chegarem a 0. Foi de fato corrigido, ou ninguém mais pisa naquele caminho, ou a própria instrumentação desapareceu. Só com o sinal de erro não dá para distinguir esses três. O que os distingue são os sinais do caminho normal, como o volume de chamadas e o momento do último sucesso, e essa é mais uma razão pela qual é preciso a observação dos "eventos que não aconteceram" da seção anterior. Se acoplar a instrumentação é um trabalho de uma vez só, observar é o trabalho de continuar medindo.
O limite de conhecimento do sampling
Traces, replays e profiles precisam de sampling por causa do custo de armazenamento e do overhead no cliente. O problema é que, ao baixar o sample rate, não é só o custo que diminui: as perguntas que se podem responder também diminuem.
Um sampling aleatório de 10% pode ser razoável para estimar a distribuição geral, mas pode perder erros raros. É por isso que são necessárias políticas que deixem replays adicionais só para as sessions com erro, ou que preservem com prioridade os traces lentos e os traces com falha.
Ao contrário, se só as requisições com erro forem guardadas, some a base de comparação com os usuários normais. Não dá para julgar se uma requisição lenta é especialmente lenta ou se o sistema inteiro está lento.
Eu também paguei esse custo. Este blog, para economizar, estava configurado para receber só 10% das amostras de trace, e, na investigação acima, para dirimir se os tempos decorridos inflados eram espera real, eram necessários o início e o fim do trecho daquela chamada, e a amostra era rasa demais para conter um trace das requisições problemáticas. O que economizei foi a minha fatura, e o que perdi foi uma pergunta que eu podia responder.
O sampling deve ser uma política por pergunta, não um único número.
- Uma amostra probabilística para o baseline
- Uma amostra prioritária para erros e latency thresholds
- Uma amostra temporária para investigar uma release ou funcionalidade específica
- Uma amostra à parte para replay·profile, onde privacidade e custo pesam mais
Dados que não foram guardados nem a IA consegue restaurar depois.
O design de instrumentação depois da IA
A razão de a IA ser útil na observação de sistemas é que os dados já estão estruturados. Issue, event, tag, span, trace e release podem ser consultados por API, e logs e profiles também têm tempo e identificadores. Eu ter conseguido a distribuição de tags de um issue e a data em que as ocorrências pararam perguntando a um agente do editor também se deve a essa estrutura.
Em junho de 2026, o Sentry expandiu a documentação da API que agents e automações usam, incluindo endpoints relacionados a tracing, profiling e attachments. Mostra que os dados de observação estão sendo usados não só como informação que pessoas leem em dashboards, mas também como interface pela qual agents consultam evidências.
A IA acelera explorações como estas.
- Encontrar combinações de issue e tag que cresceram depois de uma release recente
- Resumir os spans lentos de um trace específico e os logs associados
- Encontrar breadcrumbs e ambientes de navegador comuns a vários eventos
- Conectar os hot paths de um profile a commits candidatos
- Propor hipóteses de reprodução e pontos adicionais de instrumentação
Mas o domain state que não foi instrumentado o agent também não tem como conhecer. Onde deixar atributos como checkout.result, cache.status e fallback.reason só pode ser decidido entendendo o código e as expectativas do usuário. Na minha investigação, o agente só conseguiu puxar na hora a distribuição e as tags porque antes existiu a decisão de descer os pontos de instrumentação de camada e colocar as tags.
A IA pode propor root causes, mas o que definir como falha, e quais usuários observar a que custo, é um julgamento de engenharia.
Os sinais em um único incidente
Ligar todas as funções do Sentry não é a conclusão deste post. A partir de um erro, é preciso poder olhar o passado com breadcrumbs, seguir o caminho da requisição com o trace, confirmar o alcance do impacto com metrics e descer a replay e profile quando necessário. A isso devem se somar, no mesmo fluxo de investigação, a ausência de eventos esperados, como no cron monitor, e os desvios classificados como respostas normais.
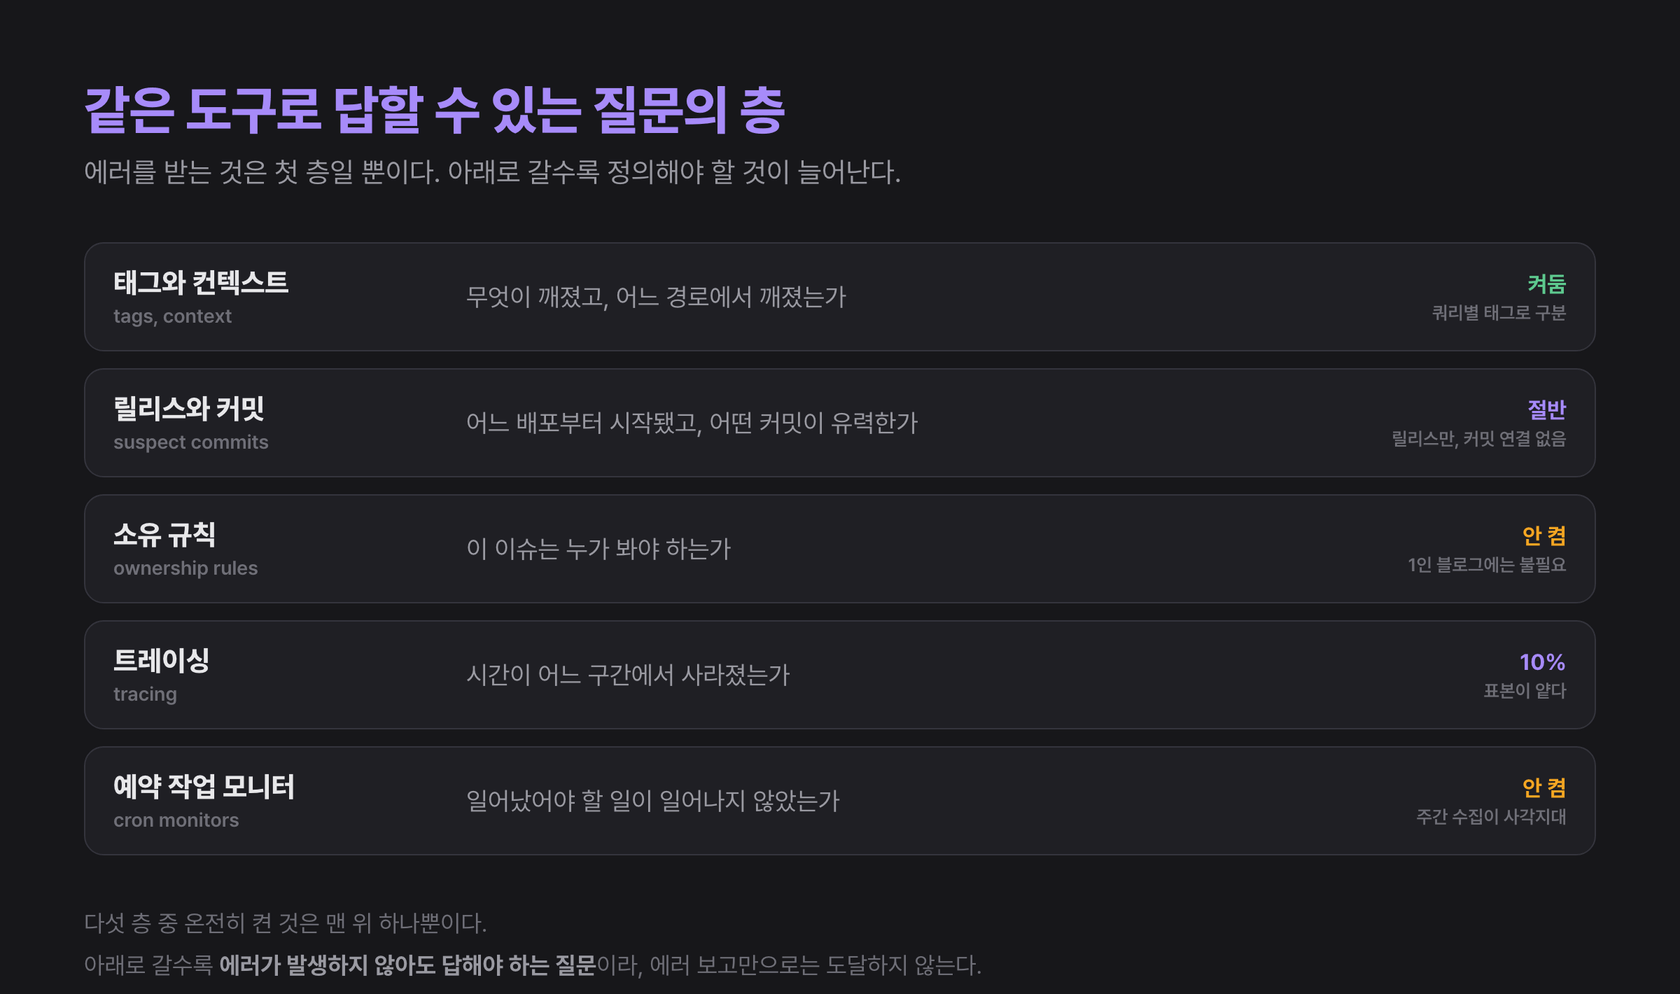
Não acho que seja um boletim vergonhoso o fato de que, das cinco camadas, a única coisa que este blog ligou por inteiro foi uma única tag. Qual camada ligar não se decide folheando a lista de funções: só depois de decidir o que será considerado falha é que se sabe qual camada é necessária. Dito isso, nesta investigação os vazios de duas camadas, a amostra rasa de traces e o ponto cego da coleta semanal, voltaram como custos reais, então as próximas camadas a ligar já ficaram decididas.
O trace context e as semantic conventions do OpenTelemetry estendem esse caminho de navegação para fora de um produto específico. Porém, a browser instrumentation de JavaScript continua experimental e o sinal de profile é Alpha. É preciso distinguir entre o fato de estar incluído no padrão e o fato de poder ser usado de forma estável em cada runtime.
A IA encontra rápido candidatos para buscar e conectar esses sinais. Mas a profundidade da observação não é decidida pelo número de funções do produto, e sim por conseguir se mover entre os sinais e ter expressado o estado que saiu do caminho normal. Minhas respostas 200 não falaram de falha nem uma vez até eu plantar o sinal, e só depois de plantá-lo se revelou que aquilo tinha sido uma falha.
No próximo artigo, Da observação ao julgamento, quero ver como interpretar juntas essa informação de sistema e os dados de usuário do GA4 e do Search Console. Porque só olhar o sistema em detalhe não decide o que corrigir primeiro. Antes disso, gostaria que quem lê este post lembrasse de um issue fechado como resolved. Esse issue parou porque foi corrigido, ou simplesmente ninguém voltou a medir?