Da observação ao julgamento
Neste post, quero falar sobre como transformar dados de observação em julgamento.
Há alguns anos eu mesmo opero o GA4 e o Search Console neste blog. Vejo com quais consultas de busca os visitantes chegam e, com base nisso, corrijo o título e a descrição dos posts, repetidamente. No entanto, descobri que acompanhar os dados por muito tempo e tomar boas decisões com esses dados são problemas diferentes. Como vou contar mais adiante neste post, quase cheguei a duas conclusões opostas sobre as mesmas métricas do mesmo post em um intervalo de dois meses.
No post anterior sobre observação do navegador, vimos as informações de desempenho que o navegador produz, e em observação do sistema, os erros, logs e traces que o sistema deixa. Quando essas informações se acumulam o suficiente, como o serviço se comporta fica muito mais visível do que antes. Mas o que corrigir primeiro, se esse problema realmente importa para os usuários e se a experiência melhorou depois da correção continuam sendo perguntas diferentes.
O núcleo deste post não está em juntar os dados à força no nível do usuário, mas em verificar a mesma hipótese de produto com unidades de observação diferentes. E ter mais fontes de dados não melhora o julgamento automaticamente. No momento em que você coloca em um mesmo gráfico números com amostras e regras de agregação diferentes, até mudanças sem relação podem ser amarradas em uma história plausível. O que a última etapa da observação precisa não é de mais dashboards, e sim da capacidade de distinguir o que cada dado viu e o que não pôde ver.
As três camadas que este blog observa
Em vez de começar com abstrações, é melhor abrir primeiro o meu próprio caso. Este blog acabou observando em três camadas.
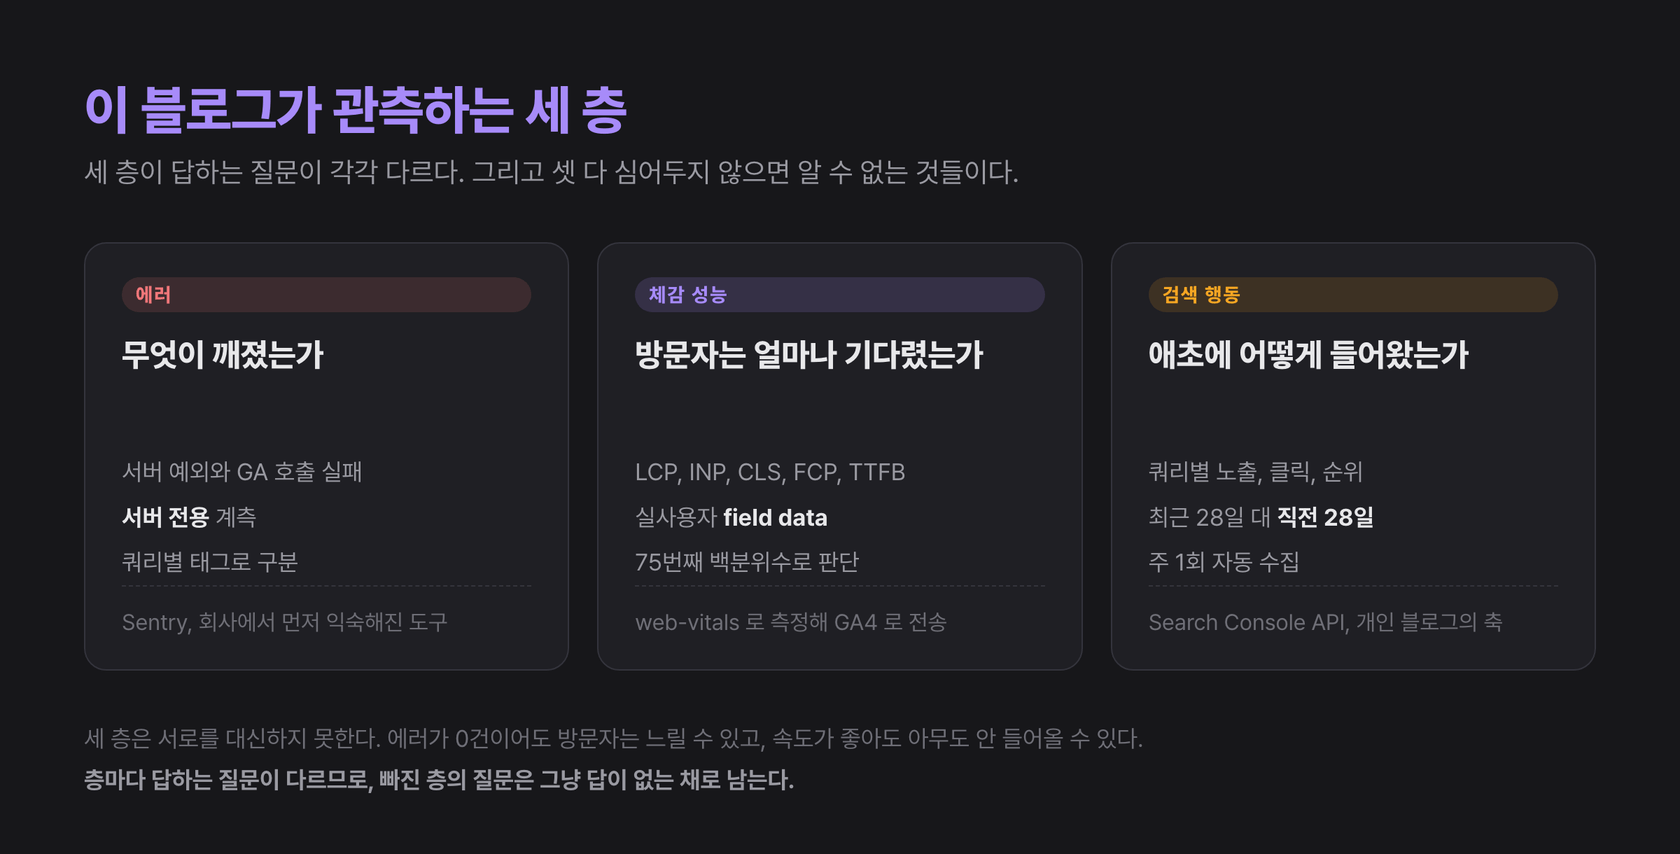
A primeira camada é o Sentry. Com instrumentação apenas de servidor, captura exceções e chamadas ao GA que falham em silêncio. A segunda camada é o desempenho percebido pelos usuários reais. Os Web Vitals medidos no navegador são enviados ao GA4 e acumulados. A terceira camada é o comportamento de busca. Os dados do Search Console são coletados automaticamente toda semana, comparando os últimos 28 dias com os 28 anteriores. Cada camada responde a uma pergunta diferente. O que quebrou, quanto os visitantes esperaram e, para começar, com quais consultas eles chegaram.
As três camadas não substituem umas às outras. Mesmo com zero erros, os visitantes podem estar sofrendo com lentidão, e um site rápido pode ser um site que ninguém visita. As duas primeiras camadas foram tratadas nos dois posts anteriores, então o peso deste está na terceira camada e em como ler as três juntas.
Sendo honesto, o GA4 deste blog não é usado a fundo como ferramenta de análise de comportamento. Ele está mais para um depósito de page views e eventos web_vitals. Por isso, a parte de GA4 deste post combina as restrições que confirmei operando-o com critérios de design verificados na documentação oficial. Vou distinguir, seção por seção, até onde vai a experiência e de onde começa a pesquisa.
Unidades de observação diferentes
É fácil chamar o RUM do navegador, o Sentry, o GA4 e o Search Console de dados de usuário, mas as unidades reais de observação diferem.
| Camada | Dados representativos | Unidade de observação | Pergunta que responde principalmente |
|---|---|---|---|
| Experiência do navegador | LCP, INP, CLS, resource timing | Visitas de página e interações | O que o usuário esperou e por quanto tempo |
| Estado do sistema | error, span, trace, log, profile | Eventos e requisições | Onde algo falhou ou ficou lento |
| Comportamento de produto | GA4 event, session, key event | Ações e sessões | O que o usuário fez dentro do serviço |
| Intenção de busca | query, impression, click, position | Impressões de busca | Com que problema o usuário chegou |
Mesmo que pareça a jornada de uma mesma pessoa, nem todas as camadas observam o mesmo usuário. Bloqueadores de anúncios podem barrar as requisições do GA e do Sentry, e a amostra de analytics muda conforme o estado do consentimento de privacidade. O Search Console fornece dados agregados dos resultados de busca, não usuários individuais. O CrUX é field data de usuários do Chrome que atendem a certas condições.
Portanto, é normal que os números das quatro camadas não batam exatamente. O problema não é eliminar as diferenças, e sim registrar a qual pergunta de qual amostra cada número responde.
O modelo de eventos do GA4
Um GA4 event modela uma interação do usuário com um nome e parâmetros. A documentação de configuração de eventos do Google distingue os eventos que o SDK coleta automaticamente, a enhanced measurement ativada por configuração, os recommended events com nomes e parâmetros prescritos, e os custom events que o próprio serviço define. A mesma palavra event difere em quem é o dono do significado e do esquema.
No começo dá vontade de enviar o máximo possível de cliques e transições de tela. Mas ter muitos eventos não aprofunda a compreensão do usuário. Se você transforma o local da implementação em nome, como button_click, button_click_2 e main_button_clicked, o significado analítico desmorona sempre que o código muda.
Um bom evento expressa a intenção do usuário mais do que um acontecimento do DOM.
gtag('event', 'article_reference_open', {
  article_slug: '260916',
  reference_type: 'specification',
  link_position: 'body',
})
Esse evento registra o fato de que o usuário abriu uma referência do artigo, não qual componente de botão foi pressionado. Mesmo mudando a UI, a pergunta de análise se mantém.
Antes de projetar eventos, vale escrever primeiro o seguinte.
- Qual comportamento do usuário se quer entender
- Qual acontecimento determina que esse comportamento ocorreu
- Quais são os parâmetros mínimos de que a análise precisa
- Que decisão será tomada quando esse número mudar
- Como duplicações e omissões serão verificadas
Se as duas últimas perguntas não têm resposta, o evento facilmente vira decoração de dashboard. (Aqui também está a razão de o GA4 deste blog permanecer um depósito. O único evento que consegue responder à pergunta 4 ainda é o web_vitals.)
A diferença entre receber e refletir
Com o GA4 Measurement Protocol, é possível enviar eventos de servidores ou offline systems fora do navegador. Mas a referência do Measurement Protocol do Google explicita uma limitação importante. O endpoint de coleta retorna 2xx ao receber uma requisição HTTP, e não retorna um status de erro mesmo que o payload esteja malformado ou os dados não sejam processados.
Um HTTP 2xx significa que a requisição foi recebida; não é prova de que o evento entrou corretamente no relatório desejado. A falha dentro de uma resposta de sucesso, tratada no post de observação do sistema, também existe na coleta de analytics. Assim como neste blog havia estatísticas vazias escondidas atrás de respostas 200, em analytics o sucesso do envio também não é o sucesso do reflexo nos relatórios.
Por isso, antes do deploy, verifique o payload com o validation endpoint ou o Event Builder, e depois do deploy o event pipeline deve ser verificado em pelo menos três etapas.
- Envio: o client ou o server enviou a requisição?
- Coleta: o evento e seus parâmetros aparecem no Realtime e no DebugView?
- Análise: dá para consultar com as dimensões pretendidas nos relatórios finais e no export schema?
Mesmo que o código que envia os dados tenha testes, se faltar a configuração de coleta ou o registro de uma custom dimension, o valor não pode ser usado na etapa de análise. Analytics também é um sistema operacional que precisa de verificação pós-deploy.
As perguntas que os eventos brutos abrem
Os relatórios padrão do GA4 são bons para ver rapidamente as perguntas frequentes sem lidar diretamente com raw events. Mas surgem limites quando você quer combinar eventos e parâmetros livremente ou juntá-los com outros dados.
O BigQuery Export permite exportar os raw events do GA4 diariamente ou em modo streaming. O daily export de uma standard property tem um limite de um milhão de eventos por dia. O streaming export é rápido mas best-effort, não inclui a attribution de novos usuários, e a attribution de usuários existentes pode levar tempo para ser processada por completo. É por isso que a análise do mesmo dia deve usar events_intraday_* e a análise diária estável deve usar as tabelas events_* finalizadas.
Com acesso aos raw events, perguntas como estas se tornam possíveis.
- A taxa de navegação para a próxima página mudou nas sessões que sofreram LCP lento?
- A taxa de conclusão das ações principais mudou nas sessões com erros depois de uma release específica?
- A profundidade de leitura dentro da landing page varia conforme o tipo de query de busca?
- O interaction pattern do mesmo recurso difere entre mobile e desktop?
Mas os raw data entregam, junto com a liberdade de interpretação, a responsabilidade de lidar por conta própria com duplicação, late arrival, sessionization e fusos horários. Saber escrever SQL não garante um modelo de usuário correto.
A intenção que a busca revela
O GA4 olha o comportamento do usuário depois que ele entra no site. O Search Console mostra, antes disso, com quais queries e resultados de busca ele foi exposto e clicado.
A Search Analytics API pode agregar clicks, impressions, CTR e position por dimensões como query, page, country, device e search appearance. Mas a documentação oficial da API explica que ela não garante todas as rows e retorna as rows superiores conforme limites internos. A soma das queries pequenas pode não bater exatamente com o total geral.
Essa restrição não é um aviso que vive só na documentação; é um fenômeno visível toda semana nos meus CSVs. Nos dados dos últimos 28 dias coletados em 11 de setembro, a soma de cliques na dimensão page é 47, enquanto a soma de cliques na dimensão query é 8. Mesmo site, mesmo período, e ainda assim a maior parte dos cliques é invisível na dimensão query. Queries raras ou anonimizadas simplesmente não são retornadas como rows. Se você tentar explicar todo o tráfego com os dados de query, acaba preenchendo essa lacuna com imaginação.
A position média também não é uma simples tabela de classificação. É um valor agregado de impressões geradas em múltiplas queries, devices, países e search appearances. Se a composição de queries mudar, a média pode se mover mesmo que o ranking de cada palavra-chave continue igual.
O ranking caiu, mas os cliques subiram
Encontrei essa propriedade da position média nos dados reais deste blog. O Biome pode substituir o ESLint e o Prettier? é um post de dezembro de 2024, e por muito tempo ele teve estranhamente poucos cliques em relação às impressões. Então, em junho passado, reescrevi o seoTitle dele aproximando-o da forma das consultas de busca reais. É um título comparativo que começa com "Biome vs ESLint vs Prettier".
Na comparação de 28 dias coletada no início de agosto, os números do post se moveram assim. As impressões caíram 11%, de 230 para 204, e a position média recuou de 8.9 para 11.6. Olhando só essas duas métricas, é um post que piorou. Mas os cliques subiram de 2 para 13, e o CTR foi de 0.87% para 6.37%.
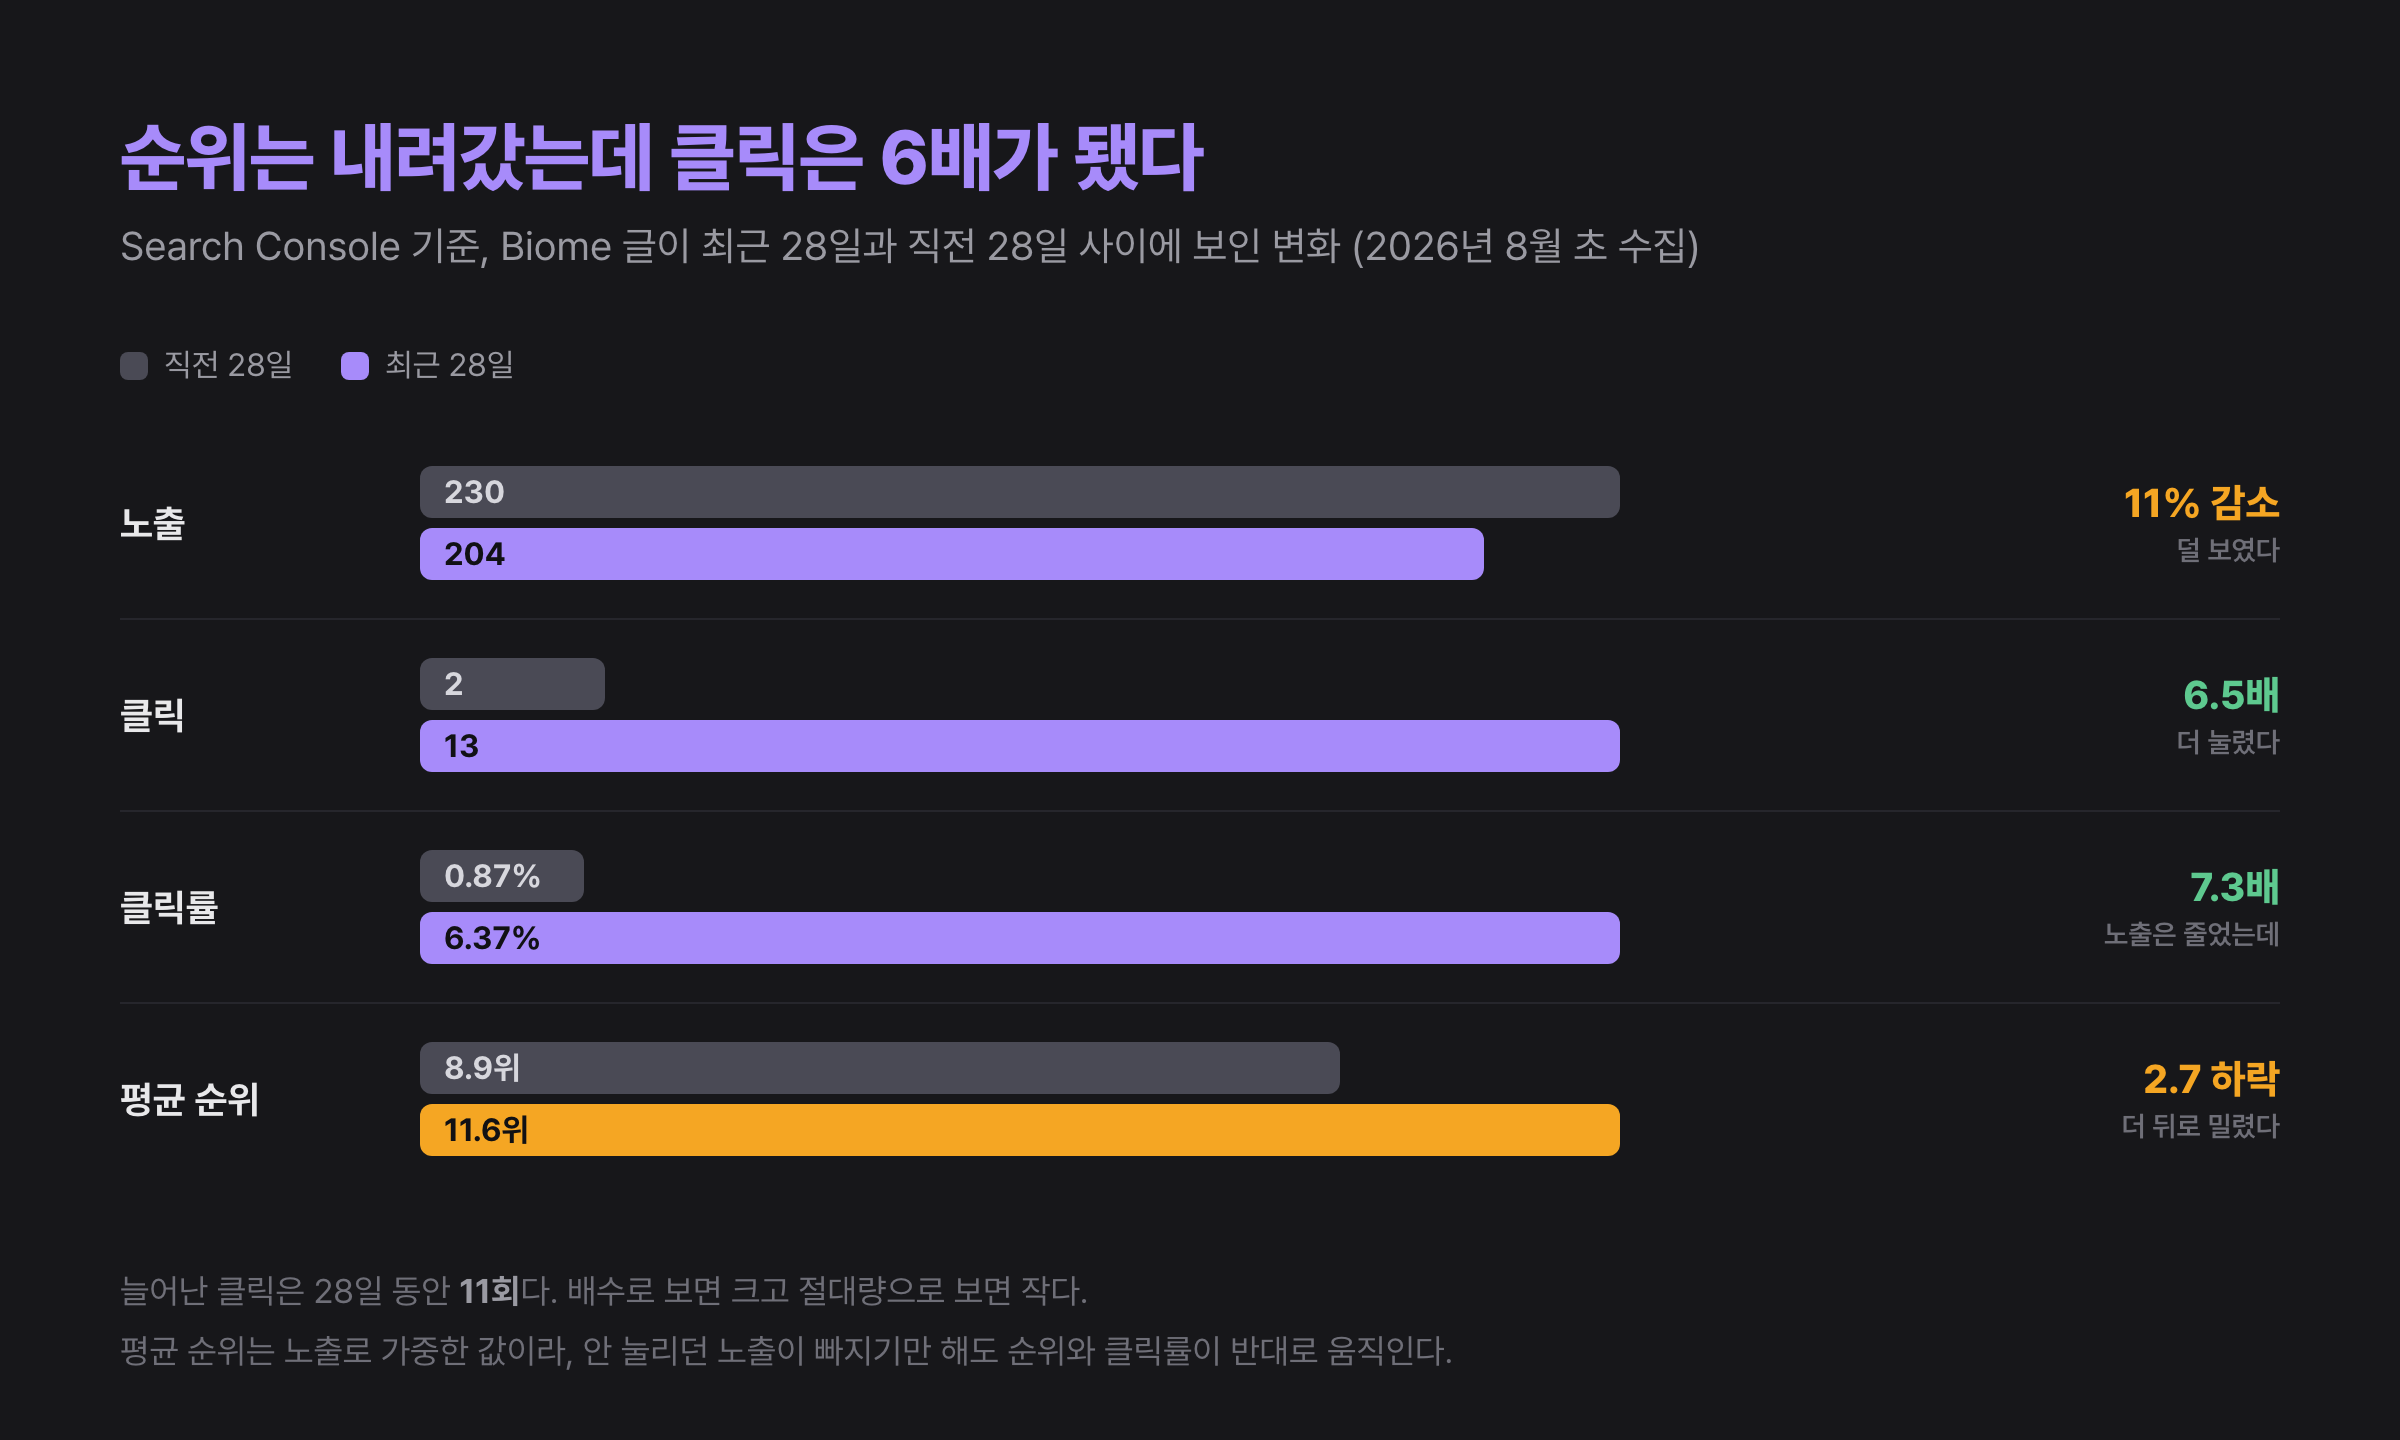
O honesto é esvaziar o entusiasmo primeiro. Esses números não provam o efeito da mudança de título. A position média é uma média ponderada por impressões, então basta sumirem impressões que apareciam no alto mas que ninguém clicava para a posição piorar e o CTR subir mecanicamente. O query mix e a sazonalidade também podem variar entre períodos, e o aumento absoluto de cliques é de 11 em 28 dias. Grande como múltiplo, pequeno em termos absolutos.
Mesmo levando isso em conta, algo permanece. Se você toma o ranking como resultado, é um post que precisa de reparo; se toma o tráfego real como resultado, é um post que melhorou. Qual métrica de resultado você escolhe muda a conclusão dos mesmos dados. Se eu estivesse olhando só a queda do ranking, teria desmontado de novo um post que começava a funcionar.
Os números consultados de novo em setembro
Enquanto organizava esta série, consultei de novo o estado atual do mesmo post. Quando escrevo sobre trabalho passado, minha regra é verificar se aquele estado ainda se mantém, e desta vez também fiquei feliz por ter verificado.
Nos últimos 28 dias coletados em 11 de setembro, este post tem 185 impressões, 6 cliques, CTR de 3.24% e position média de 20.8. Os cliques desceram para menos da metade do pico de 13, e a position média recuou o verão inteiro, 8.9 → 11.6 → 14.5 → 20.8 na ordem de coleta. Ou seja, a narrativa da virada, o ranking caiu mas os cliques subiram, foi mais nítida na janela de comparação do início de agosto, e a janela seguinte sacudiu essa narrativa de novo.
Essa nova consulta não derruba a conclusão da seção anterior. Os cliques ainda estão acima dos 2 de antes da mudança, e o CTR ainda está acima de 0.87%. Além disso, cinco das seis queries de busca com cliques registrados neste blog são queries comparativas deste post, como "eslint vs biome". Mas uma lição foi acrescentada. Não só a escolha da métrica: a escolha do período de comparação também muda a conclusão. Se você completa uma narrativa com uma única comparação de 28 dias, os próximos 28 dias a quebram. E eu ainda não sei por que a position média continua recuando. Pode ser que a composição das queries em que o post aparece tenha mudado, ou que os documentos concorrentes tenham aumentado. Até verificar, fica como não resolvido.
Conexões que começam por uma hipótese
Quando se fala em conectar dados, o primeiro pensamento é unificar user id e session id. Claro, ter dimensões comuns como trace id, release, route e timestamp facilita a análise. Mas juntar todos os dados no nível individual não deve virar o objetivo.
As queries do Search Console não podem ser vinculadas a indivíduos e nem devem ser. Os GA events de usuários que não consentiram podem não existir. Nos eventos do Sentry há muitos erros que não precisam identificar o usuário.
Por isso é melhor decidir primeiro a unidade de observação da hipótese.
| Hipótese | Unidade de observação apropriada |
|---|---|
| Os erros de pagamento aumentaram depois da nova release | Error rate e key event completion por release |
| Usuários de mobile começam a ler os posts tarde | Distribuição de LCP e engagement events por device |
| A landing page não corresponde a certa intenção de busca | Impression e CTR por query cluster e comportamento por page |
| Um fallback se repete sem que o usuário veja | Eventos por fallback reason e proporção de sessions afetadas |
Com a hipótese em primeiro lugar, muitas vezes dá para responder bem no nível agregado, sem identificadores pessoais. O caso anterior do post sobre Biome também é assim. O que eu precisava não eram os usuários individuais que clicaram naquele post, e sim uma comparação em janelas de 28 dias da composição de queries e dos cliques. Precisão de observação e precisão de rastreamento de usuários não são a mesma coisa.
Os limites da correlação
O erro mais comum ao conectar dados de observação é ler como causa e efeito dois valores que se moveram no mesmo período.
Suponha que a conversão caiu na semana em que o LCP piorou. O desempenho pode ser a causa, mas tráfego de campaign, mudanças de preço, estoque, sazonalidade e mudanças no device mix também são possíveis. Se você compara médias globais, basta o tráfego mobile aumentar para os dois valores se moverem juntos. Pela mesma razão, eu não amarrei de imediato a mudança do seoTitle e o aumento de cliques como causa e efeito. O fato de dois acontecimentos se seguirem no tempo não basta.
Estreitar a pergunta nesta ordem reduz conclusões precipitadas.
- Mudaram na mesma janela de tempo?
- A relação permanece no mesmo ambiente de usuário e route?
- Coincide com uma release ou um ponto de mudança específico?
- A ordem entre erro e desempenho pode ser confirmada no nível do evento?
- Depois de uma correção ou um experimento, volta na direção esperada?
Dados de observação são fortes para estreitar os candidatos a causa. Para confirmar a causalidade, são necessários, além disso, experimentos controlados, experimentos naturais ou mudanças reproduzíveis.
Distribuições e proporções
Quanto mais o sistema e a experiência do usuário são comprimidos em médias, mais os grupos importantes desaparecem.
Com um LCP médio de 2 segundos, alguns usuários de mobile podem estar vivenciando 8. Mesmo com um error rate global baixo, ele pode estar concentrado só em um browser específico que recebeu a nova release. Mesmo com o CTR subindo, se as impressions caíram bruscamente, a própria composição dos usuários alcançados pode ter mudado. O CTR de 6.37% do post sobre Biome era exatamente esse caso.
Por isso são necessárias combinações como estas.
- Desempenho: não só a median, mas também p75 e p95
- Erros: não só o event count, mas também os affected users e a proporção de sessions
- Comportamento: não só o número de eventos, mas também a taxa de conclusão sobre eligible users
- Busca: não só o CTR, mas também impression, click e query mix
- Deploys: não só o período inteiro, mas também o antes e depois da release e o trecho de rollout gradual
O denominador das proporções também deve ser armazenado. 100 checkout errors sozinhos parecem um grande problema, mas o julgamento muda conforme sejam 100 em 100 tentativas ou 100 em um milhão.
Consentimento e qualidade dos dados
Quanto mais a fundo se trata a observação de usuários, mais difícil fica tratar privacidade e consentimento como uma checklist legal anexada depois. Porque o que se pode coletar determina quais análises são possíveis.
A documentação oficial do Consent Mode do Google descreve como tags e SDKs ajustam seu comportamento de armazenamento e envio conforme o estado de consentimento do usuário. O modo Basic bloqueia as tags antes do consentimento. O modo Advanced carrega as tags com o estado de consentimento padrão e, enquanto o consentimento está negado, envia sinais de medição sem cookies que podem ser aproveitados para um modeling mais específico.
O importante aqui é não tratar modeled data e observed data como a mesma coisa. Conforme a configuração e os requisitos de elegibilidade, behavioral ou key event modeling podem ser aplicados aos relatórios, então não se deve presumir que o número na tela é sempre a simples soma dos eventos observados diretamente.
O design da observação deve incluir estas perguntas.
- Esses dados são realmente necessários para a decisão?
- Dá para responder no nível agregado, sem identificar indivíduos?
- O que deixa de ser coletado quando o usuário recusa?
- Conseguimos operar a exclusão e os períodos de retenção?
- Os padrões do SDK coincidem com a política do nosso serviço?
Coletar menos dados pode reduzir as oportunidades de análise. Ao mesmo tempo, reduz o ruído desnecessário e o risco. Uma boa observação está mais próxima da coleta mínima adequada ao propósito do que da coleta máxima.
A definição de falha e de sucesso
O que coletar minimamente depende, no fim, de como o serviço define sucesso e falha. As ferramentas calculam error count, latency, sessions, conversion e CTR, mas não decidem qual valor é a falha do serviço e qual é o sucesso.
Retornar HTTP 200 pode ser uma falha se os dados centrais estiverem vazios. Ao contrário, mesmo que uma API externa falhe, se um fallback apareceu rápido e o usuário alcançou seu objetivo, o serviço pode ter tido sucesso. Mesmo que a position de busca caia, se os cliques dos usuários que você quer aumentaram, o resultado de produto pode ter melhorado.
Para esse julgamento, são necessárias frases explícitas entre as métricas técnicas e os resultados de usuário. As frases que eu de fato defini para este blog são estas.
- O usuário deve conseguir encontrar nos resultados de busca o post que esperava.
- O conteúdo principal do post deve aparecer dentro do tempo definido no p75 de mobile.
- Mesmo que as estatísticas acessórias falhem, a leitura do corpo do texto não deve atrasar.
- Se um trabalho de coleta agendado não for executado, considera-se uma falha operacional.
Quando essas frases existem, as metrics, alerts e eventos necessários vêm atrás. Ao contrário, se você começa ligando os dashboards padrão da ferramenta, é fácil confundir o que é mensurável com o que é importante.
O papel do engenheiro que transforma a observação em julgamento não é virar a pessoa que mais conhece os dados. É virar a pessoa que traduz as expectativas do usuário em condições que o sistema pode verificar.
Em que os alertas devem ser colocados
Quando a definição de falha existe em frases, a próxima pergunta vem logo em seguida. Onde colocar os alertas?
O documento de filosofia de alertas que Rob Ewaschuk escreveu nos primórdios do SRE do Google crava que um alerta que chama uma pessoa deve ser urgente, importante, acionável e real. E recomenda colocar os alertas nos sintomas, não nas causas: em sinais que aparecem por fora, como respostas 500 ou erros visíveis ao usuário.
No entanto, entre esse princípio e o que eu vivi há uma tensão sutil. Como tratado no post de observação do sistema, a falha deste blog não foi um 500, e sim uma resposta 200 com estatísticas vazias. O alerta baseado em sintomas se apoia na premissa de que a falha vem à tona, e uma falha classificada como sucesso quebra exatamente essa premissa.
Por isso não acho que esse princípio precise ser rebatido. Na verdade, cheguei à conclusão de que definir o que conta como sintoma é a parte realmente difícil desse trabalho. Neste blog, o sintoma não foi um código de status, e sim "a função de consulta de estatísticas retornou seu valor padrão", e isso só pôde virar sintoma plantando instrumentação à mão. Aqui está a razão de, na seção anterior, eu propor definir primeiro em frases a falha e o sucesso. Só com essas frases fica decidido em quais sintomas colocar alertas.
O conselho que o mesmo documento acrescenta também merece ser guardado. Incline-se a apagar os alertas barulhentos. Porque o excesso de monitoramento é um problema mais difícil de resolver do que a falta de monitoramento. Como referência, o livro de SRE do Google inclui a própria falha do monitoramento na lista de gatilhos para escrever um postmortem. O mecanismo que coleta os dados de observação parar em silêncio também é uma falha. Neste blog, a coleta semanal do Search Console não rodar em alguma semana entra nessa lista.
A tradução entre os dados
Com os alertas colocados, o que resta é transportar as expectativas do usuário para as diferentes query languages e esquemas do RUM do navegador, do Sentry, do GA4 e do Search Console. Nesse ponto, o papel que a AI pode assumir é menos gerar conclusões e mais traduzir uma pergunta para uma forma verificável em cada fonte de dados.
Por exemplo, um fluxo como este se torna possível.
- Converter uma pergunta em linguagem natural nas API queries e no SQL de cada sistema.
- Criar transformações que alinhem fusos horários e dimensões diferentes.
- Encontrar os segments cuja distribuição muda e os contraexemplos inesperados.
- Reunir juntas as releases relacionadas, os code paths e a documentação oficial.
- Propor as próximas hipóteses a verificar e candidatos a instrumentação adicional.
Aqui também está a razão de as semantic conventions do OpenTelemetry importarem. Se cada serviço envia o mesmo significado com nomes de atributo diferentes, até a AI precisa adivinhar o esquema primeiro. Se nomes, unidades e stability comuns forem respeitados, fica mais fácil para ferramentas e pessoas conectarem os sinais.
Mesmo com a AI ajudando na análise, as etapas de verificação não diminuem.
- Verificar se o SQL gerado trata corretamente eventos duplicados e fusos horários.
- Verificar se a API retorna todas as rows ou só as top rows.
- Verificar se médias e percentis, número de usuários e número de eventos não foram confundidos.
- Distinguir modeled data de dados observados diretamente.
- Não colocar explicações excessivas em variações casuais de amostras pequenas.
Em resumo, a vantagem da AI está em transformar perguntas em queries executáveis e em ampliar os eixos de comparação. A responsabilidade de verificar de qual amostra e com quais regras de agregação o resultado saiu permanece intacta.
O feedback loop como capacidade de produto
Quando o custo de transformar perguntas em queries cai, o tempo entre a observação e a próxima mudança também pode encurtar. O importante nesse momento é não aumentar só a velocidade de geração.
O relatório DORA 2025 publicado pelo Google Cloud, com base em uma pesquisa com cerca de 5 mil profissionais de tecnologia do mundo todo, resume que a adoção de AI mostrou uma relação positiva com o software delivery throughput e o product performance, e uma relação negativa com a delivery stability. O DORA explica o mecanismo em um artigo de insights à parte assim. O tempo economizado na etapa de geração é realocado para a sobrecarga de verificação, e a própria velocidade com que o código a ser revisado é produzido aumenta. Como diz o resumo do relatório, a AI amplifica o que o time já tem, mais do que conserta o time. (O relatório ROI of AI-assisted Software Development do DORA, atualizado em abril de 2026, também enfrenta de frente o problema de gerenciar a queda de produtividade no início da adoção.)
A evidência que eu levo mais a sério é outra. Um estudo que a METR publicou em 2025 sorteou, em 246 issues reais de 16 desenvolvedores open source experientes, se o uso de AI era permitido ou não, e nas issues em que a AI foi permitida, a conclusão levou 19% mais tempo. No entanto, os desenvolvedores esperavam de antemão ser 24% mais rápidos, e mesmo depois de vivenciar a lentidão real, acreditavam ter sido 20% mais rápidos. Citei esse estudo em Engenheiro frontend de AI como parte de uma discussão sobre produtividade, mas no contexto deste post ele se lê de outro jeito. É evidência de que a percepção não substitui a medição. Se não dá para confiar na percepção, é preciso medir, e como mostra o caso anterior do post sobre Biome, até um valor já medido precisa ser medido de novo mudando a janela.
Se a geração acelera, a quantidade de mudança aumenta. Mesmo que os defeitos ocorram na mesma proporção, o número absoluto cresce, e o código a revisar e o impacto nos usuários se acumulam rápido. Se nesse momento a observação for lenta, o time aumenta só a velocidade de deploy, não a velocidade de aprendizado.
Um feedback loop rápido é a capacidade de encadear em curto os passos seguintes.
- Fazer o deploy de uma mudança.
- Observar o que aconteceu com o sistema e com os usuários.
- Encontrar a diferença entre o esperado e o real.
- Estreitar as hipóteses de causa.
- Verificar com a próxima mudança.
A AI pode ajudar muito na exploração dos passos 3 e 4. Mas ela não consegue começar se os sinais necessários no passo 2 estiverem faltando ou não estiverem conectados às informações de release do passo 1.
Por isso, a base de uma organização que usa bem a AI precisa não só de testes, mas também de sistemas observáveis e métricas de resultado centradas no usuário. A qualidade do feedback loop, mais do que a capacidade de geração, vira o gargalo.
Transformar a observação em julgamento
Dobrando os três posts desta série em uma frase cada, fica assim. A observação do navegador mostra o que o usuário percebeu, a observação do sistema mostra em que parte do sistema essa experiência foi produzida, e o GA4 e o Search Console mostram o que o usuário fez dentro do serviço e com que intenção chegou. Esses sinais não são o registro completo de uma pessoa, e sim evidências que iluminam a mesma hipótese a partir de amostras diferentes.
Portanto, o critério para conectá-los não é o volume de dados nem a precisão dos identificadores pessoais. É preciso escolher a unidade de observação que combina com a hipótese, registrar denominadores e omissões, e reverificar as correlações com correções ou experimentos. Os usuários invisíveis por causa da privacidade e do consentimento também devem ser incluídos entre os limites da análise. E a conclusão obtida de uma comparação deve ser confirmada de novo mudando o período. Assim como os números do meu post sobre Biome contaram duas histórias diferentes em dois meses, a observação não é uma consulta única, e sim um medir contínuo.
O próprio objeto da observação também está se ampliando. O OpenTelemetry está organizando as semantic conventions para AI generativa e chamadas MCP em um repositório à parte. Quanto mais execução confiarmos à AI, mais essa execução também vira objeto de observação sob os mesmos princípios.
A AI baixa o custo de começar essa verificação, mas não define os critérios de sucesso e falha. Decidir primeiro em frases qual experiência proteger, coletar os sinais necessários e confirmar os resultados com a próxima mudança continua sendo trabalho do engenheiro. Quando esse ciclo é curto e preciso, a observação vira uma capacidade de produto, e não um dashboard. Aos leitores deste post, proponho também escolher uma métrica do próprio serviço, escrever em uma frase o que vão considerar resultado, e consultar de novo, com outro período, uma conclusão já tomada. Na minha experiência, a segunda consulta ensina mais que a primeira.