Calibração e excesso de confiança em LLMs
Neste post quero falar sobre a calibração de modelos e o excesso de confiança que aparece depois do RLHF. É para desenvolvedores que querem usar no código, como critério de decisão, a probabilidade ou a confiança que um modelo devolve. Ao final, você vai conseguir explicar como acurácia e calibração diferem, o que o ECE mede, como as probabilidades de um modelo lapidado com preferência humana se afastam da taxa real de acerto e até onde a causa é conhecida.
Precisei organizar esses conceitos primeiro enquanto testava as afirmações do Jev, um modelo de decisão lançado pela TypeSafe AI. Em vez de frases, o Jev devolve uma probabilidade para cada opção e apresenta a calibração como objetivo de treino. Para avaliar essa afirmação, eu precisava saber antes o que é calibração e por que ela sai do lugar nos modelos existentes.
Acurácia e calibração
Primeiro é preciso separar acurácia de calibração. Acurácia é quantos por cento você acerta; calibração é saber quantos por cento você vai acertar. Se, juntando só os dias em que a previsão disse 70% de chance de chuva, choveu de fato em sete de cada dez, aquela previsão está bem calibrada. Isso não quer dizer que a acurácia seja alta. Quer dizer que ela conhece o próprio limite. Um modelo que acerta só 60%, se disser de si mesmo que acerta 60%, tira nota máxima em calibração.
A escala pode sair do lugar em duas direções. Quando a probabilidade que o modelo declara é maior que a taxa real de acerto, isso se chama overconfidence; quando é menor, underconfidence. Pondo a probabilidade declarada no eixo horizontal e a taxa real de acerto de cada faixa de probabilidade no eixo vertical, dá para ver de relance onde as duas se separam. Um gráfico desenhado assim se chama reliability diagram.
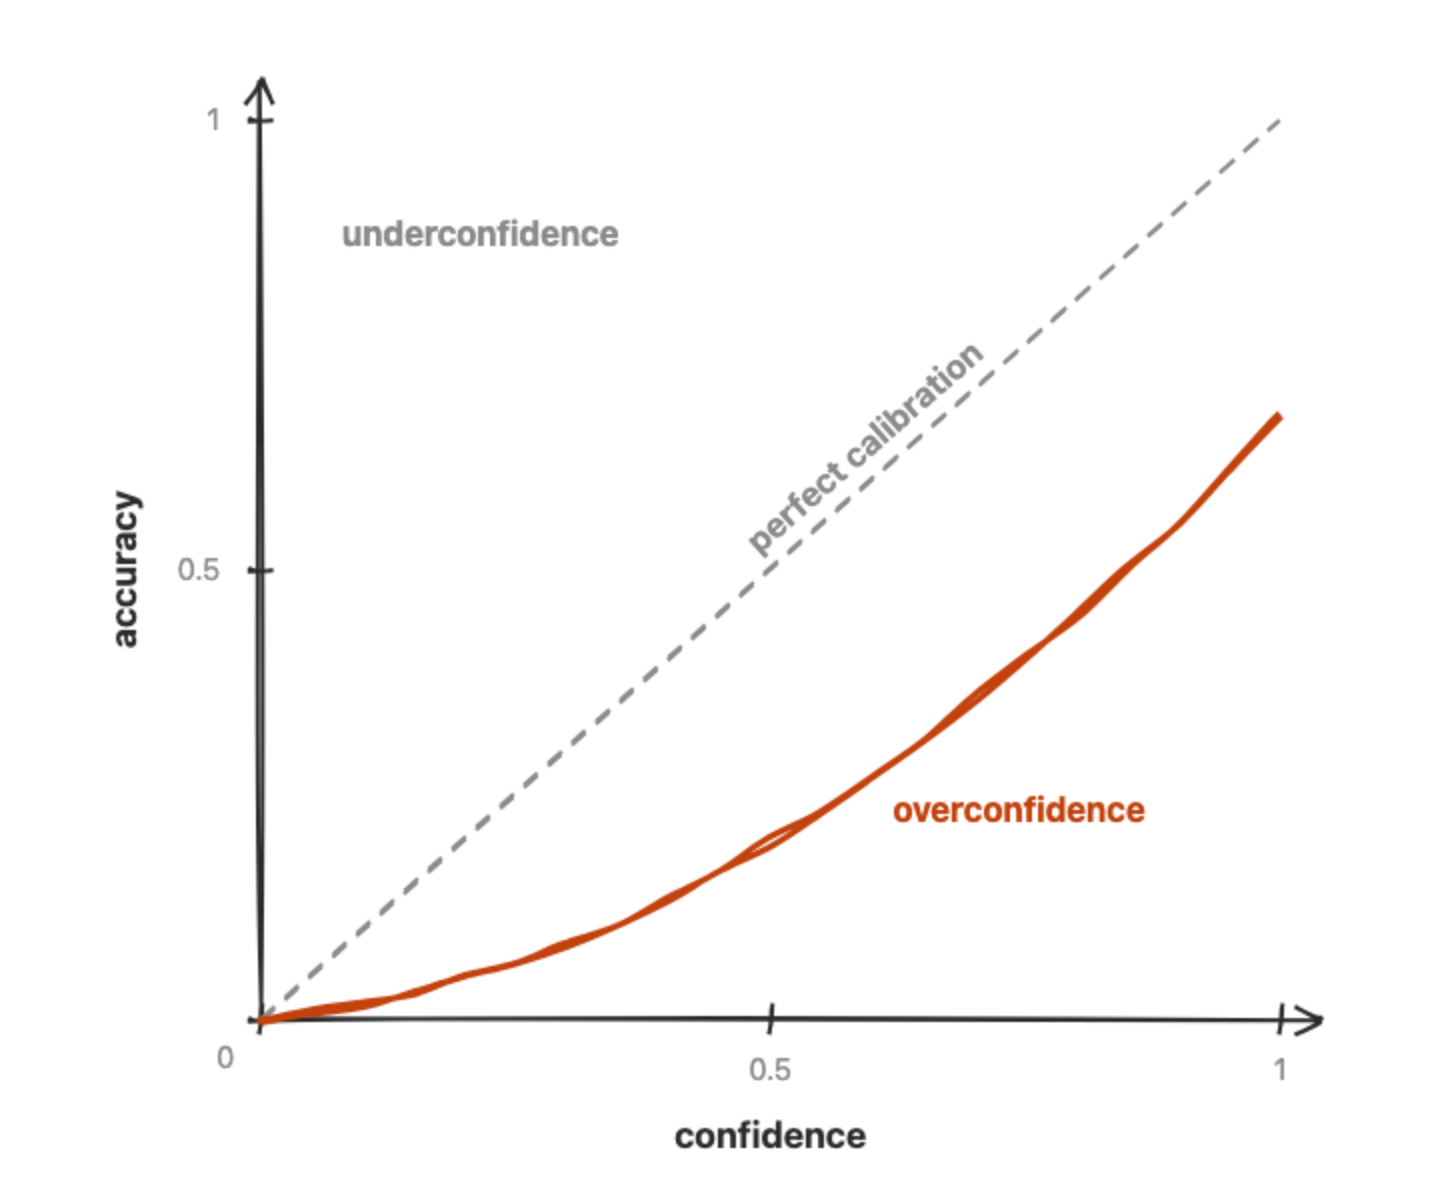
Se a curva fica sobre a diagonal, o modelo acertou tanto quanto disse. Quanto mais ela cai abaixo da diagonal, menos ele acerta em relação à probabilidade que declara.
O indicador que mede esse descompasso é o ECE (expected calibration error). Pela definição de Guo et al. 2017, é a média, ponderada pela fração de amostras de cada faixa, da diferença entre “a probabilidade declarada” e “a taxa real de acerto” em cada faixa de probabilidade, e 0 é o valor perfeito. O código abaixo transcreve essa fórmula. Ele compara um modelo que acerta 6 de 10 questões quando diz 0.6 toda vez e quando diz 0.95 toda vez.
// Guo et al. 2017 의 식 (3). 구간은 등간격 10개(논문 실험은 15개), 경계는 왼쪽 닫힘
function ece(preds, M = 10) {
  const bins = Array.from({ length: M }, () => ({ n: 0, hit: 0, conf: 0 }))
  for (const { p, correct } of preds) {
    const b = bins[Math.min(M - 1, Math.floor(p * M))]
    b.n++
    b.hit += correct ? 1 : 0
    b.conf += p
  }
  return bins.reduce(
    (sum, b) => (b.n ? sum + (b.n / preds.length) * Math.abs(b.hit / b.n - b.conf / b.n) : sum),
    0,
  )
}

// 10문제 중 6문제를 맞힌다
const answers = Array.from({ length: 10 }, (_, i) => ({ correct: i < 6 }))
console.log(ece(answers.map((a) => ({ ...a, p: 0.6 }))).toFixed(3)) // 매번 0.6 이라고 말할 때
console.log(ece(answers.map((a) => ({ ...a, p: 0.95 }))).toFixed(3)) // 매번 0.95 라고 말할 때
Este é o resultado de rodá-lo com Node v24.16.0 em 2026-10-08.
0.000
0.350
A acurácia é 0.6 nos dois casos. Só a probabilidade declarada mudou, e mesmo assim o ECE sobe de 0 para 0.35. Mas como a fórmula usa valor absoluto, o ECE mede só o tamanho do descompasso, não a direção. Um modelo que diz 0.25 toda vez e ainda acerta 6 questões também fica com ECE de exatamente 0.35. Para saber se é overconfidence ou underconfidence, é preciso olhar o reliability diagram ou a confiança média menos a acurácia.
A função objetivo do RLHF
Então por que essa escala sai do lugar num modelo lapidado com feedback humano? Primeiro precisamos ver o que o RLHF (reinforcement learning from human feedback) otimiza. O esqueleto de construir um modelo de recompensa a partir de comparações de preferência humana veio de Christiano et al. 2017; um dos primeiros trabalhos a levá-lo para modelos de linguagem foi Ziegler et al. 2019, e o InstructGPT o aplicou ao seguimento de instruções. O que é empurrado para cima é a nota de um modelo de recompensa que imita a preferência humana. Os trabalhos com modelos de linguagem somam à recompensa uma KL penalty que impede o modelo de se afastar demais de como estava antes do aprendizado por reforço, e o InstructGPT ainda misturou gradientes dos dados de pré-treino (PPO-ptx), mas o que ele empurra para cima continua sendo essa nota.
Para um chatbot, a preferência humana é o objetivo certo. O problema é que essa preferência pende para evitar o tom que revela incerteza. Zhou et al. 2024 mostraram, em quatro conjuntos públicos de dados de preferência, que os anotadores escolhem menos as respostas com atenuadores como "I'm not sure, maybe". A diferença era pequena, mas significativa. Por outro lado, eles não escolheram mais as respostas com expressões que reforçam a certeza. Leng et al. 2025 mostraram que modelos de recompensa dão nota maior a respostas que declaram um número de confiança alto, independentemente da qualidade real. Os dois resultados tratam de expressões de confiança dentro do texto (verbalized confidence), não de probabilidades de tokens. A TypeSafe, que propõe um método de treino para substituir o RLHF, também observa no seu próprio guia introdutório que o RLHF pode recompensar alucinações que soam confiantes (confident-sounding hallucinations). É a posição de quem vende a alternativa.
As curvas de calibração do GPT-4
Nas probabilidades dos tokens também se observou um descompasso na mesma direção. A Figure 8 do corpo do relatório técnico do GPT-4 coloca lado a lado os reliability diagrams do modelo pré-treinado e do modelo post-training, e a legenda diz:
Right: Calibration plot of the post-trained GPT-4 model on the same subset of MMLU. The post-training hurts calibration significantly.
O eixo horizontal é a probabilidade (logprob) que o modelo atribuiu a cada uma das alternativas A, B, C e D em questões de múltipla escolha do MMLU, e o eixo vertical é a taxa real de acerto naquela faixa. Pelos números impressos na Figure 8, o ECE do modelo pré-treinado é 0.007 e o do modelo que passou por PPO (o algoritmo de aprendizado por reforço usado no RLHF para atualizar o modelo na direção de notas mais altas do modelo de recompensa) é 0.074. Piorou mais de dez vezes.
No painel direito (PPO) da Figure 8, as barras de 0.4 para cima ficam abaixo da diagonal, mas as faixas entre 0.1 e 0.3 ficam, ao contrário, acima dela. As barras entre 0.1 e 0.9 se amontoam planas numa taxa real de acerto de cerca de 0.3 a 0.5, então, mesmo que a probabilidade que o modelo declara suba, a taxa de acerto quase não acompanha. No 0.074 também estão misturadas essas faixas de underconfidence. E, como Guo et al. apontam, um reliability diagram não mostra quantas amostras caem em cada faixa, de modo que não dá para supor que a distância de uma barra até a diagonal seja proporcional ao quanto aquela faixa contribui para o ECE.
Este painel difere do diagrama conceitual acima em dois pontos. Primeiro, não apenas cai abaixo da diagonal como a curva do diagrama conceitual, mas a cruza uma vez. Segundo, coloca nas faixas as probabilidades das quatro alternativas, então também difere da definição do código acima, que mede a probabilidade da única resposta escolhida. Por isso não comparo o 0.074 com o 0.35 do código acima na mesma escala.
Então por que piorou? O corpo do relatório diz apenas que o modelo pré-treinado estava bem calibrado e que a calibração diminuiu depois do post-training; não aponta uma causa. Uma pista está em Kadavath et al. 2022, da Anthropic. As políticas RLHF que eles treinaram a partir dos próprios modelos de linguagem pareciam, à primeira vista, muito mal calibradas. O artigo disse que isso não surpreendia, porque o RL fine-tuning tende a concentrar as previsões nos comportamentos que recebem mais recompensa. Foi um experimento curto acrescentado à margem, não o tema central. Ainda assim, ao aplicar uma única temperatura, T=2.5, a todas as avaliações, os problemas de calibração foram em grande parte resolvidos em três avaliações. A temperatura é um valor que divide os logits; quando é maior que 1, mantém a ordem das respostas e só achata a distribuição de probabilidade. Eu leio o fato de um único valor ter resolvido em grande parte o problema como sinal de que o descompasso não estava concentrado em poucas faixas, e sim era a distribuição inteira estreitada para um lado. O artigo também acrescentou a ressalva de que um treino de RL mais intenso poderia distorcer a calibração de formas que não se corrigem assim.
Esse é um resultado sobre modelos da Anthropic, então não dá para transportá-lo diretamente como causa da Figure 8. Os estudos da seção anterior também tratavam de expressões de confiança dentro do texto. Não encontrei uma fonte primária que ligue diretamente o resultado de que as pessoas evitam o tom incerto ao descompasso nas probabilidades dos tokens.
A probabilidade que seu código recebe
A probabilidade da Figure 8 é a log-probabilidade de um token. Para receber um valor do mesmo tipo, conforme a especificação da API da OpenAI, você define logprobs como true numa requisição de Chat Completions e usa top_logprobs para escolher, entre 0 e 20, quantos candidatos receber em cada posição de token. O valor que você obtém pedindo ao modelo que diga um número de confiança junto com a resposta é confiança expressa em palavras, e é um valor diferente da probabilidade do token.
Os estudos sobre esses dois valores comparam pares diferentes. Tian et al. 2023 relataram que, dentro de modelos RLHF como ChatGPT, GPT-4 e Claude, a confiança expressa em palavras costumava ser mais bem calibrada que as probabilidades condicionais, muitas vezes reduzindo o ECE em cerca de 50% relativo em três benchmarks. Mas, nessa comparação, a probabilidade condicional dos modelos cujos pesos não são públicos não era a probabilidade de tokens da API, e sim uma estimativa: a fração de vezes que a resposta saiu ao amostrar a mesma pergunta 10 vezes. Leng et al., vistos acima, relataram que, comparados a modelos anteriores ao RLHF, os modelos RLHF mostram mais overconfidence na confiança que expressam em palavras. Os dois resultados podem valer ao mesmo tempo. E 0.074 é o valor que o modelo post-training do GPT-4 de 2023 obteve num subconjunto do MMLU, então não dá para transportá-lo como está para os modelos que você chama hoje pela API.
Para fechar
Resumindo, calibração não é sobre quantos por cento você acerta, e sim sobre saber quantos por cento vai acertar, e o ECE é o número que mede o tamanho desse descompasso. Para ver a direção, é preciso olhar o reliability diagram ou a confiança média menos a acurácia. O RLHF empurra para cima a nota de um modelo de recompensa que imita a preferência humana. Kadavath et al. entendem que essa otimização tende a estreitar as previsões na direção do que recebe mais recompensa. Há pesquisas mostrando que as pessoas escolhem menos as respostas que revelam incerteza e que modelos de recompensa dão nota maior a respostas que declaram um número de confiança alto, independentemente da qualidade. No GPT-4, o ECE ficou registrado indo de 0.007 para 0.074 depois do post-training, mas a OpenAI não chegou a escrever a causa. Como a calibração também sai diferente conforme a probabilidade que o seu código recebe seja uma probabilidade de tokens ou uma confiança dita em palavras, seja qual for, você precisa medi-la de novo nos seus próprios dados.
Se as probabilidades do Jev, um modelo de decisão que apresenta a calibração como objetivo de treino, são de fato honestas é o tema de Modelos de decisão, Jev e Kev.
Espero que você também, antes de cravar no código como limiar a probabilidade que um modelo devolve, verifique ao menos uma vez com que objetivo esse modelo foi treinado e se a escala dele se sustenta nos seus próprios dados.