Modelos de decisão, Jev e Kev
Neste post quero falar sobre um modelo que não gera texto. Na semana passada, a TypeSafe AI lançou o Jev.
O primeiro uso que me chamou atenção foi a automação de navegador. A Browserbase abriu um PR que liga o Jev ao act() do Stagehand. A estrutura era mandar a árvore de acessibilidade da página como state e perguntar, com alternativas fechadas, "qual é o próximo elemento a clicar". Em 40 tarefas, a mediana do act() caiu de 1,97 segundo para 0,46, e de 147 ações só 4 voltaram para um LLM. O ponto onde um script de Playwright quebra assim que um selector muda foi preenchido por uma chamada que devolve uma única probabilidade. Enquanto escrevo, o PR ainda não foi mesclado.
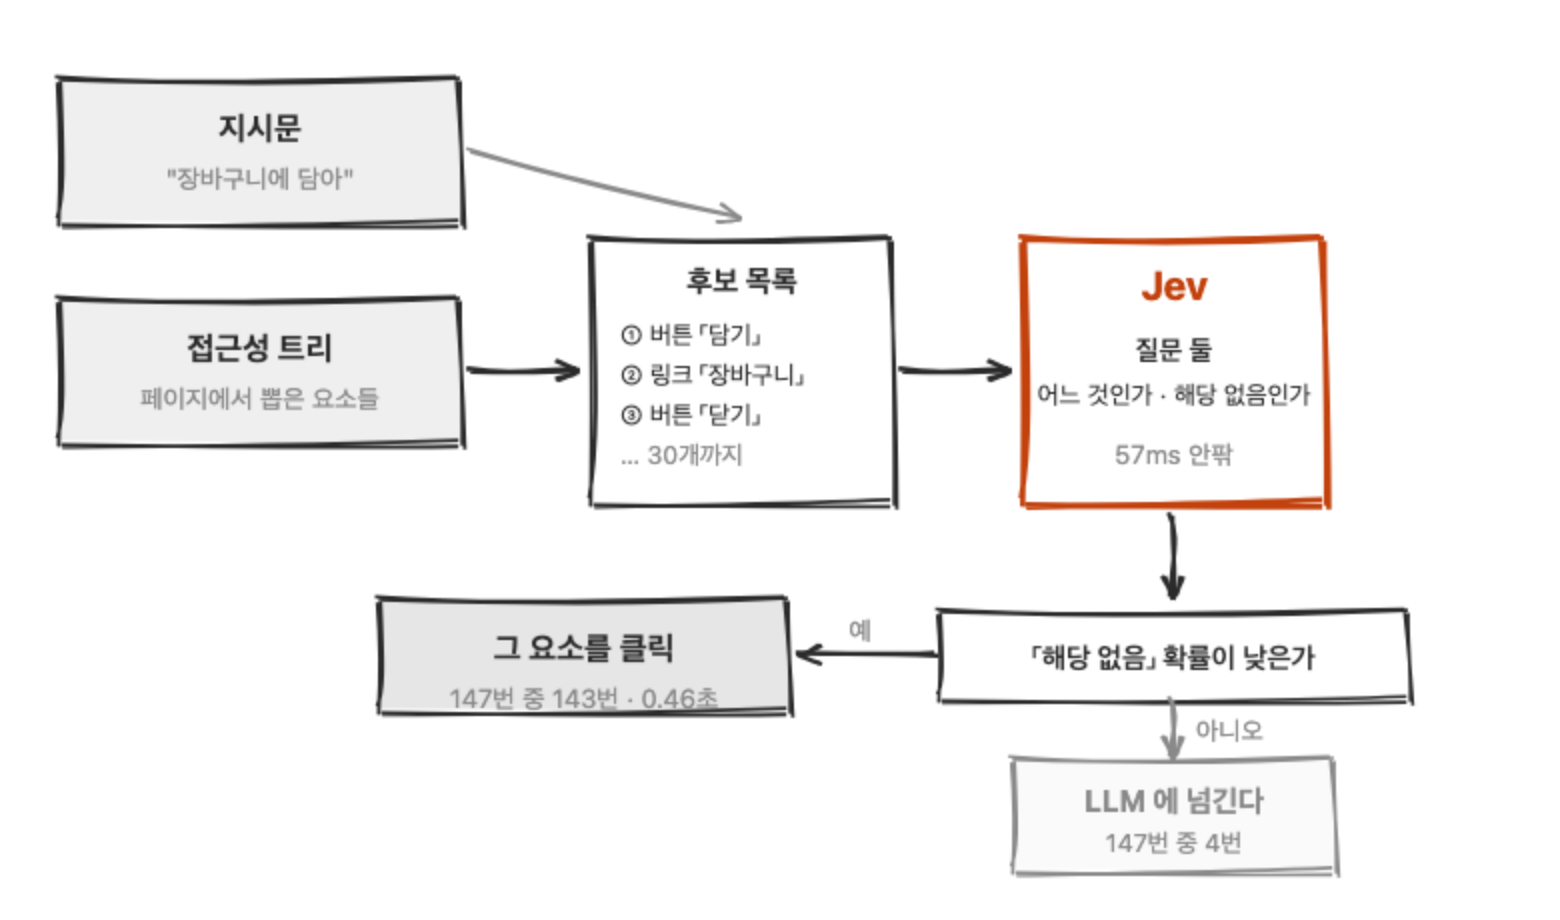
A linha que esse PR traçou é a pergunta deste texto. Ele aceita a resposta do Jev a partir de uma probabilidade de 0,7 e, abaixo disso, repassa para um LLM. Dá para confiar na probabilidade que esse modelo devolve e traçar um limiar no código?
O benchmark dos outros não basta para decidir, então quero verificar com os meus próprios dados. Este blog tem um gate que barra estrangeirismos transliterados. A regra manda escrever 피커 como picker, mas a regex só pega a metade certa, e palavras que aparecem dentro de um composto ou já estão consolidadas em coreano, como 멀티스레드 ou 콜 스택, eu julgo à mão toda vez. Há só duas respostas, reverter ou manter, quem sabe decide em um segundo, e o passa ou falha precisa ser decidido dentro de um script de build sem ninguém conferindo. É o mesmo formato da decisão de selector do Stagehand.
Então a ordem é esta: o que o Jev devolve, de que treinamento sai essa probabilidade, que números aparecem quando entrego meu gate a ele e onde esses números podem ser usados.
Um modelo que não gera texto
A data de lançamento é 15 de setembro de 2026. A empresa não chama isso de LLM, mas de System One Model, uma categoria nova. Neste texto, chamo isso de modelos de decisão. O fundador, Diogo Almeida, foi o quarto autor do artigo do InstructGPT na OpenAI. Ele esteve no time que criou o método que se tornou o ancestral direto do ChatGPT e hoje está do lado que aponta os limites desse método.
O Jev não gera frases. Você define de antemão o formato da resposta, ele escolhe dentro dele e devolve a probabilidade junto. Só existem três tipos de pergunta.
| Tipo | O que pergunta | O que devolve |
|---|---|---|
choice |
Qual destes é | a escolha, probabilities, confidence |
score |
Em que nível está | a nota, legend, probabilities, confidence |
noul |
É verdadeiro | uma única probabilidade entre 0 e 1 |
O endpoint também é um só. Um POST /v1/systemone com state (o conteúdo a avaliar), model e questions (o mapa de perguntas) traz a resposta. Várias perguntas sobre o mesmo state cabem em uma requisição, e aumentar o número de perguntas quase não aumenta o tempo de resposta.
Por que é rápido se explica pela assimetria entre prefill e decode que organizei em o princípio dos tokens. O LLM é lento porque espreme a saída um token por vez, em sequência; o Jev não tem essa etapa de decode. Ele lê a entrada uma vez, em paralelo, e lê a probabilidade direto. Por isso não existe cobrança por token de saída: só a entrada, a $0.042 por milhão de tokens.
Há uma análise de um desenvolvedor chamado Archer Hume que chamou a API cerca de dez mil vezes e reconstruiu o comportamento de fora. Com 360 tokens de entrada, mediana de 57.5ms; com 29,835 tokens, 218ms; com 1,500 perguntas, 610ms. A evidência mais direta ali é a observação de que uma resposta com 200 alternativas voltou na mesma velocidade que uma com 2. Ou seja, escrever a resposta não custa tempo.
A decisão que ninguém vê
Velocidade e preço chamam atenção, mas a pergunta que Almeida lançou no texto de anúncio era outra: se os modelos são sobre-humanos em conversa há anos, para onde foi toda a automação?
A resposta dele é que são dois tipos de trabalho diferentes. Chatbots, copilots e agentes de código têm como objetivo satisfazer alguém que está olhando ao lado. A decisão que roda em silêncio no servidor, sem ninguém olhando, não. Se chamarmos a primeira de assistant e a segunda de automation, todos os modelos lançados até agora foram feitos para a primeira.
Fiz uma distinção parecida quando organizei o texto sobre design de harness. Dentro de um sistema de agentes há incontáveis decisões que ninguém observa. Passo esta requisição para uma pessoa? Posso executar este comando? Hoje perguntamos tudo isso a um LLM caro. A outra metade que a regex do meu gate não cobre também é uma decisão desse tipo.
O lugar que o RLHF deixou
Mas por que foi preciso um método de treino novo? Não dá para simplesmente pedir sim ou não a um modelo existente?
A resposta está na linhagem do RLHF (reinforcement learning from human feedback). O esqueleto de montar um modelo de recompensa a partir de comparações de preferência humana veio do artigo de Christiano et al., de 2017; Stiennon et al., em 2020, aplicaram isso a modelos de linguagem; e o InstructGPT estendeu para seguir instruções. Os três artigos compartilham uma única função objetivo: produzir a saída que o avaliador humano prefere.
Aqui é preciso separar acurácia de calibração. Acurácia é quantos por cento você acerta; calibração é saber quantos por cento você vai acertar. Se, juntando só os dias em que a previsão disse 70% de chance de chuva, choveu de fato em sete de cada dez, aquela previsão está bem calibrada. Isso não quer dizer que a acurácia seja alta. Quer dizer que ela conhece o próprio limite. Um modelo que acerta só 60%, se disser de si mesmo que acerta 60%, tira nota máxima em calibração.
O indicador que mede esse descompasso é o ECE (expected calibration error). É a média, ponderada pela fração de amostras de cada faixa, da diferença entre “a probabilidade declarada” e “a taxa real de acerto” em cada faixa de probabilidade, e 0 é o valor perfeito.
Para um chatbot, a preferência humana é o alvo certo. O problema é que as pessoas preferem respostas confiantes a respostas hesitantes. Então o modelo adquire o hábito de falar em tom categórico mesmo quando a situação é ambígua. A documentação da TypeSafe chama isso de mode dropping: a otimização por preferência empurra o modelo a favorecer um estilo específico e achata a probabilidade das outras saídas possíveis.
A OpenAI também escreveu a mesma coisa no próprio relatório. A Figure 8 do relatório técnico do GPT-4 põe lado a lado as curvas de calibração do modelo pré-treinado e do modelo pós-treinado, e a legenda diz o seguinte.
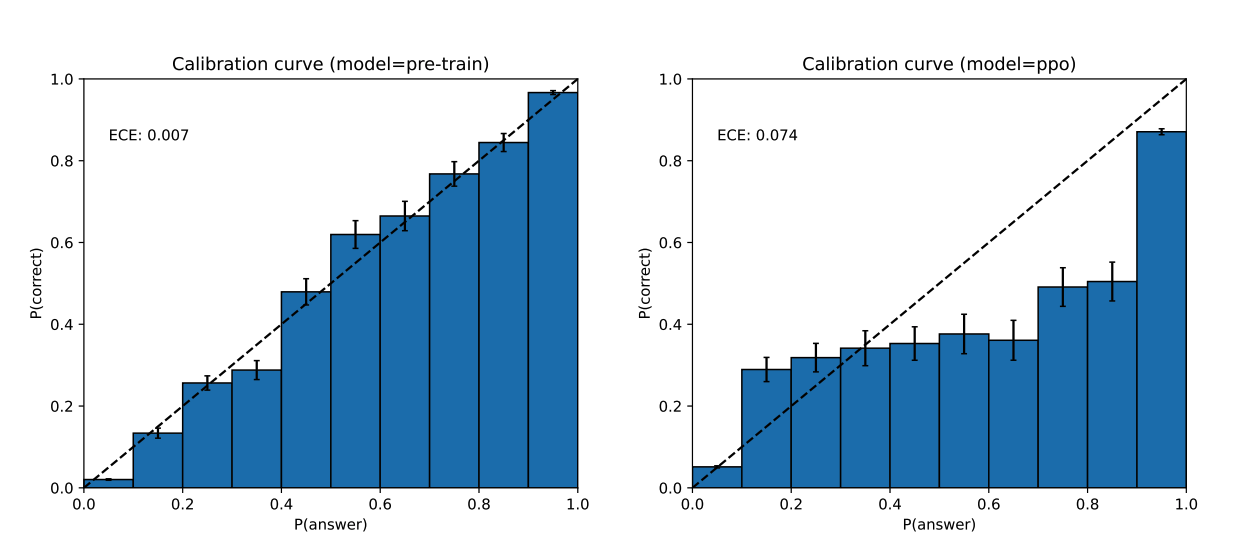
Fonte: OpenAI, GPT-4 Technical Report (arXiv:2303.08774), Figure 8.
Right: Calibration plot of the post-trained GPT-4 model on the same subset of MMLU. The post-training hurts calibration significantly.
Pelos números impressos no gráfico, o ECE do modelo pré-treinado é 0.007 e o do modelo que passou por PPO é 0.074. Piorou mais de dez vezes. No processo de ser lapidado para agradar pessoas, a capacidade de saber quantos por cento ia acertar foi aparada.
Só que o ECE sozinho não basta. Um preditor constante que estampa 0.6 em qualquer entrada também tem ECE 0 se a taxa real de acerto for 60%. Se a probabilidade é apenas honesta e não varia de caso para caso, não há onde traçar a linha. Por isso, além da calibração, é preciso olhar se a probabilidade de fato se separa, e a “fração que dá para tratar automaticamente dentro de um orçamento de erro”, que uso adiante, é o indicador que junta essas duas coisas num número só.
Do ponto de vista do software, o que importa é esta parte. Se a probabilidade é honesta e se separa, dá para traçar uma linha. Sai uma estrutura em que acima de 0.95 vai para o automático e abaixo disso vai para uma pessoa.
A TypeSafe diz ter aberto um terceiro caminho mirando esse lugar. O RLHF otimiza a preferência humana; o RLVR (reinforcement learning with verifiable rewards) otimiza respostas que a máquina consegue corrigir; e o RLCD, dizem, otimiza decisões calibradas.
Só que tudo o que foi divulgado sobre o RLCD são três linhas de contrato de saída. Até 23 de setembro de 2026, data em que escrevo este texto, não há artigo nem relatório técnico em lugar nenhum da documentação e do texto de anúncio da TypeSafe. Existe um artigo do ICLR 2024 que usa a mesma sigla, mas ali ela significa reinforcement learning from contrastive distillation, um método diferente. Cuidado para não misturar os dois na hora de pesquisar.
O que o confidence é de fato
Então o número que o Jev devolve é honesto? Antes de responder, há uma coisa a ver primeiro. Não é um número só.
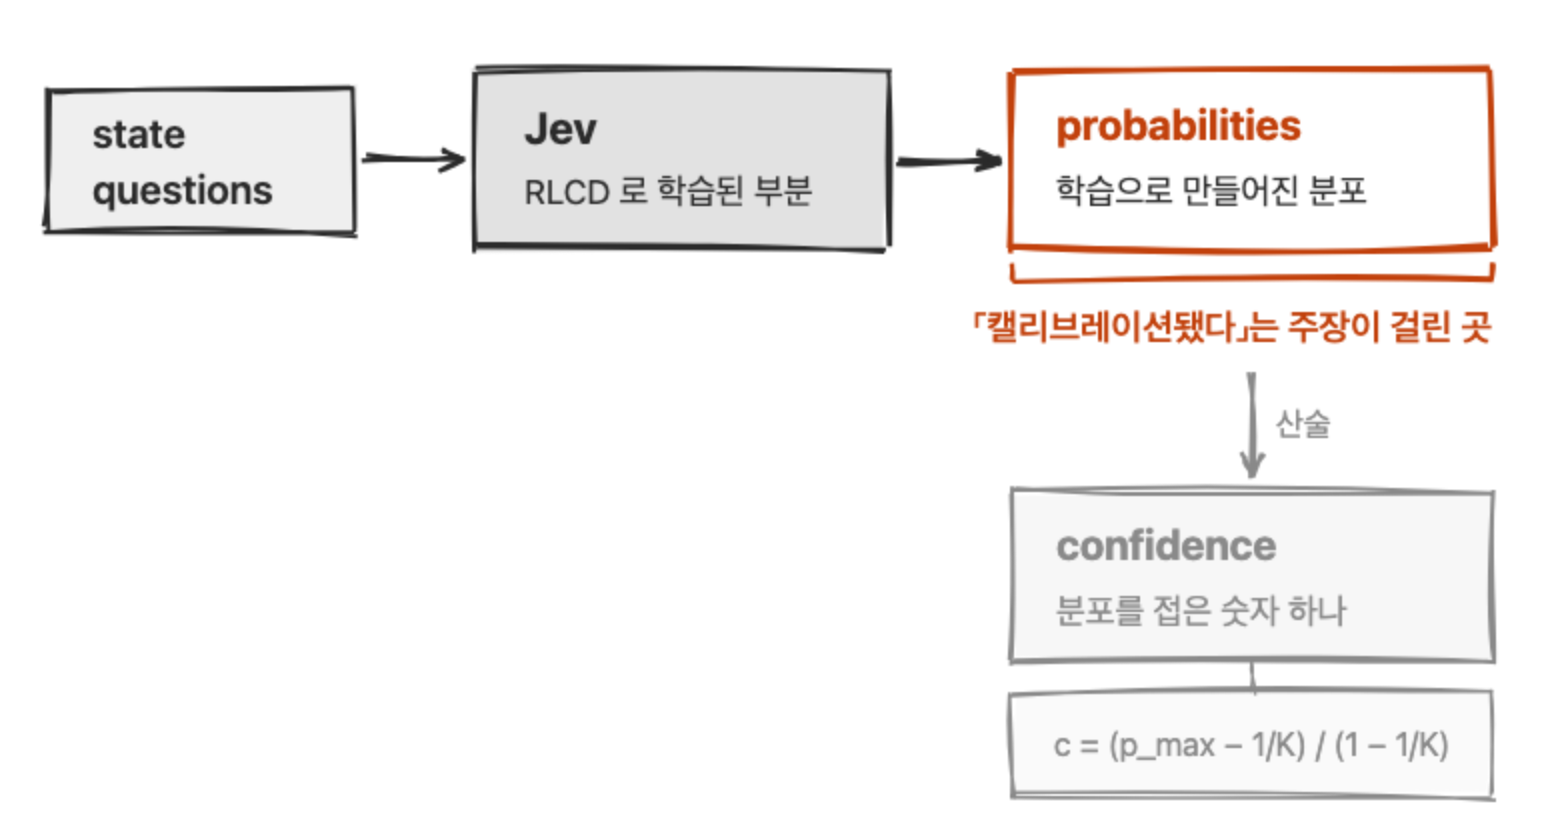
As respostas de Choice e Score trazem probabilities e confidence juntos. O primeiro é a distribuição de probabilidade sobre todas as alternativas; o segundo é um único número entre 0 e 1. Na hora de pôr um limiar no código, a mão vai primeiro para o confidence.
Esse valor não foi feito pelo modelo. O arquivo _utils/confidence_metrics.py do system-one-adapter-python, publicado pela organização TypeSafe, tem 32 linhas ao todo, e a parte de Choice é esta.
def choice_confidence(probs: list[float]) -> float:
    """Scale peak choice probability from uniform to certainty."""
    if len(probs) == 1:
        return 1.0

    normalized_probs = _normalize(probs)
    uniform_probability = 1.0 / len(normalized_probs)
    return (max(normalized_probs) - uniform_probability) / (1.0 - uniform_probability)
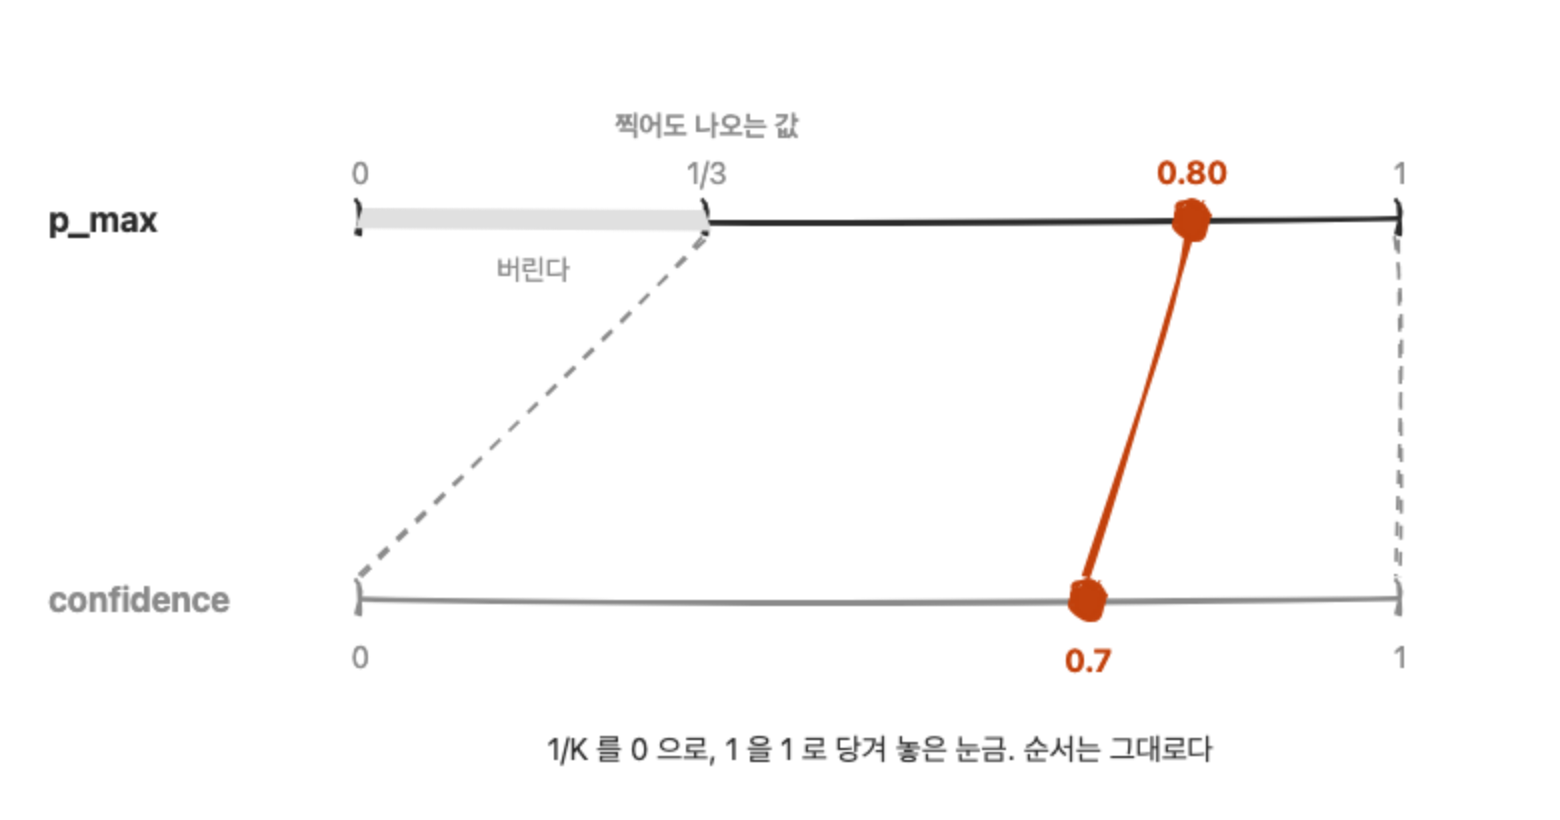
Não há chamada de modelo nem parâmetro aprendido. Entra um vetor probabilities e sai um número real. Em fórmula, c = (p_max − 1/K) / (1 − 1/K); com três alternativas e probabilidade máxima de 0.8, dá 0.7.
Esse repositório não é o servidor Jev de produção, e sim uma implementação alternativa que imita a mesma API com um LLM. Então não dá para cravar nada só com isso. Mas há outras duas evidências apontando para a mesma fórmula. A página sobre confidence da documentação oficial da TypeSafe descreve o valor como "a statistic computed from the probability distribution" e, no código de demonstração, traz (3 × largest probability − 1) / 2 como aproximação para três alternativas. Com K igual a 3, é a mesma fórmula acima. E o registro de auditoria de afirmações anotou que, na API real, numa resposta em que só foram dadas duas alternativas, ambas erradas, quando o vencedor era 0.52 o confidence veio 0.04. Com K igual a 2, (0.52 − 0.5) / (1 − 0.5) = 0.04. Bate com a fórmula.
No mesmo repositório, Score usa uma fórmula completamente diferente: a distância absoluta média a partir do nível de moda, dividida pela mesma quantidade sob distribuição uniforme, e então subtraída de 1. A documentação não publica a fórmula do Score. Ou seja, sob o mesmo nome confidence existem duas fórmulas, e em tipos diferentes o mesmo número quer dizer coisas diferentes. Noul não ter confidence é pela mesma razão: não há distribuição para dobrar.
A documentação também não esconde isso. Chega a orientar que, se você quiser outro cálculo, ela entrega o probabilities inteiro para você fazer como preferir. É conteúdo que está escrito; o problema é quem usa sem ler.
Mas a tabela comparativa do texto de anúncio cola as duas coisas. Lá está escrito "Calibrated: higher confidence means higher accuracy". Quem lê entende que o confidence é o valor calibrado, mas o lado em que a afirmação de calibração de fato se apoia é o probabilities.
Quanto essa distinção abre em números, existe medição. Um desenvolvedor chamado scienthoon publicou uma medição independente de calibração que calculou à parte o ECE obtido ao ler o confidence como “probabilidade de estar certo”. Deu 0.035 no OpenBookQA, 0.078 no HellaSwag e 0.18 no conjunto sintético. As probabilidades originais dos mesmos conjuntos foram, respectivamente, 0.024, 0.029 e 0.107. Nos três conjuntos, o lado do confidence é pior.
Por que piora está na fórmula. Se K é fixo, c é uma transformação monotonicamente crescente de p_max, então a ordem é preservada. O poder discriminativo continua o mesmo; basta reescrever o limiar. O que quebra não é a informação, é a escala. Se K varia de pergunta para pergunta, surge mais um problema: o fator de esticamento também varia. O mesmo p_max de 0.8 vira 0.6 com duas alternativas e 0.75 com cinco. No momento em que você usa um único limiar numa carga de trabalho com número de alternativas misturado, isso vira problema.
A calibração muda conforme a distribuição
Então dá para confiar no lado do probabilities?
Existe um registro público de chamadas reais ao Jev. O repositório do Kev, implementação open source de reprodução feita por Jared Palmer, tem o diretório runs/jev-*, e o usage.json registra "model": "typesafe-ai/jev", atestando que foram chamadas reais passando pelo Vercel AI Gateway. Somando, nos seis diretórios jev-*, os arquivos usage.json, foram 5,364 chamadas entre 18 e 20 de setembro de 2026 e 2,418,260 tokens de entrada. Dos sete conjuntos abaixo, o scienthoon foi importado convertendo o arquivo de resultados daquele desenvolvedor, então não entra nessa soma.
Que a cobrança é de fato só pela entrada se confirma em outro lugar. O autor do benchmark de phishing anotou isso olhando o dashboard da TypeSafe. Dos 4.56 milhões de tokens de duas rodadas, 3.66 milhões foram de entrada e 0.9 milhão de saída, e a cobrança foi de $0.15, valor que bate com o cálculo feito só sobre a entrada.
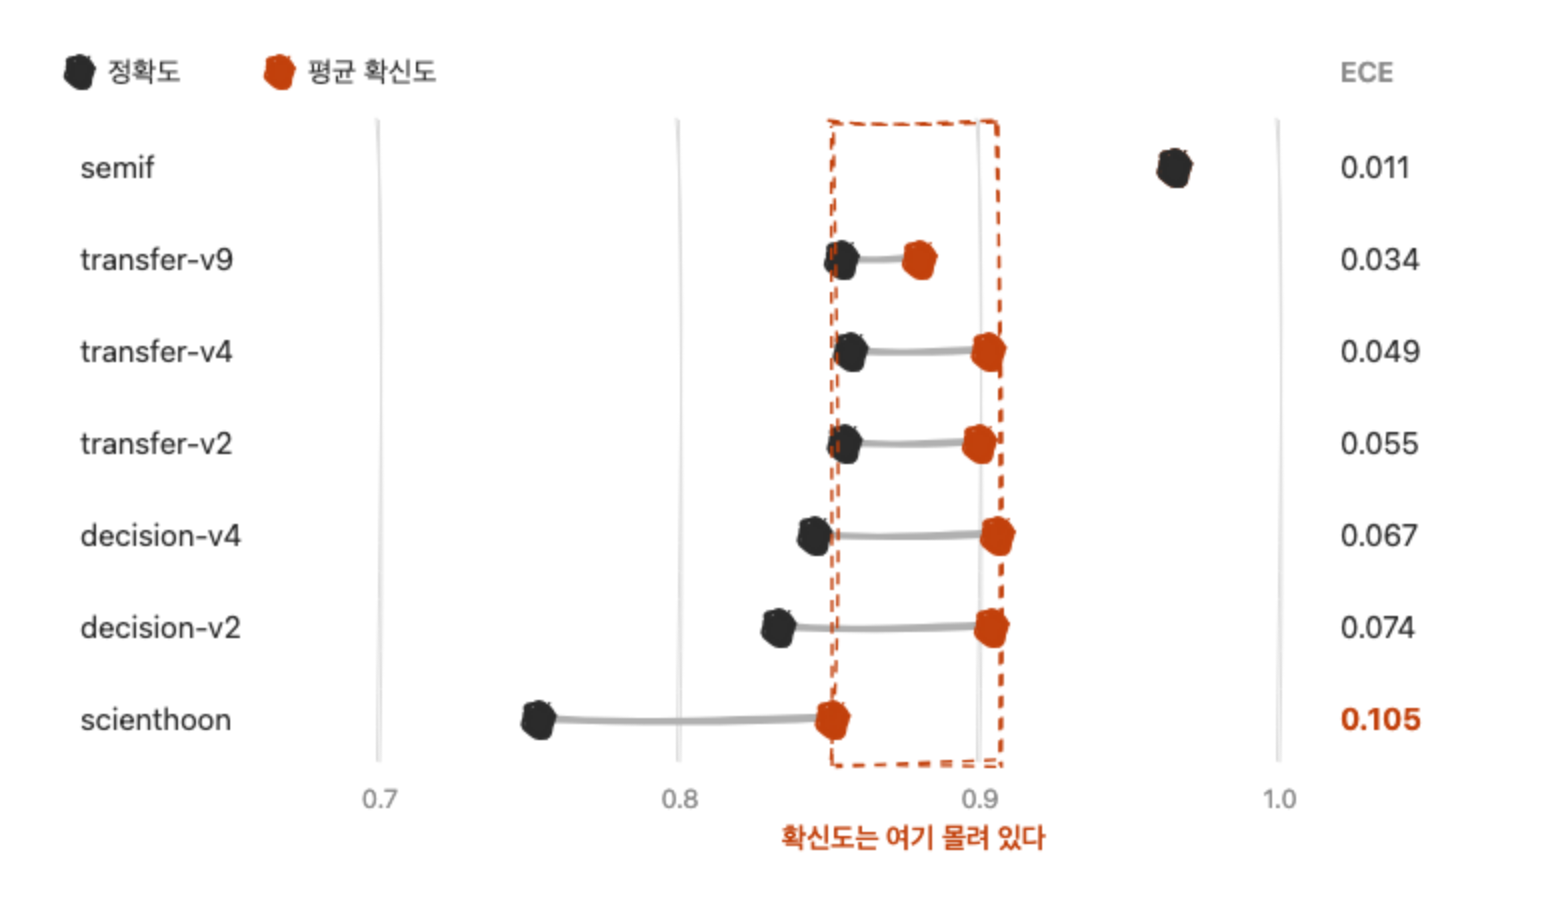
Tirando do report.json do mesmo diretório os indicadores dos sete conjuntos de avaliação, fica assim. Abaixo, a certeza não é o campo confidence, e sim o valor máximo de probabilities. O excesso de certeza é 평균 확신도 − 정확도, isto é, a certeza média menos a acurácia, e são 5,743 casos no total. Os valores são os do bloco clean, que deixa fora da pontuação de acurácia os itens “desconhecidos”, cuja base de julgamento foi apagada.
| Conjunto de avaliação | n | Acurácia | Certeza média | Excesso | ECE |
|---|---|---|---|---|---|
| semif | 144 | 0.965 | 0.965 | -0.000 | 0.011 |
| transfer-v9 | 1,046 | 0.854 | 0.880 | +0.026 | 0.034 |
| transfer-v4 | 656 | 0.857 | 0.903 | +0.046 | 0.049 |
| transfer-v2 | 560 | 0.855 | 0.900 | +0.045 | 0.055 |
| decision-v4 | 1,264 | 0.845 | 0.906 | +0.061 | 0.067 |
| decision-v2 | 1,200 | 0.833 | 0.904 | +0.071 | 0.074 |
| scienthoon | 873 | 0.753 | 0.851 | +0.099 | 0.105 |
Duas coisas se leem aqui.
Primeira, o ECE varia quase dez vezes. De 0.011 a 0.105. Mesmo corretor, mesmo modelo. “Ser calibrado” não é uma propriedade do modelo, mas da relação entre o modelo e a distribuição. Que a calibração desmorone quando a distribuição muda já é um resultado conhecido. O que há de novo aqui é que o mesmo padrão aparece num modelo que ergueu a calibração como objetivo de treino.
Os 0.105 do conjunto com maior ECE são até maiores que os 0.074 do GPT-4 pós-RLHF que vimos antes. Mas esses dois não devem ser lidos como um ranking. As tarefas são diferentes, e o ECE é um estimador cujo valor se move conforme o número de faixas em que você divide e conforme a faixa em que as amostras se concentram, de modo que confrontar números vindos de corretores diferentes não constitui comparação.
Segunda, o ECE medido é explicado quase inteiramente pelo excesso de certeza. A diferença entre as duas colunas fica entre 0.002 e 0.011 nos sete conjuntos. Como o ECE é a média ponderada das defasagens por faixa, ele não pode ser menor que o excesso global; essa diferença ser quase 0 significa que o sinal do desvio de cada faixa está todo inclinado para o mesmo lado. Não é ruído que se alterna entre faixas e se cancela.
Por que é assim se vê lendo na vertical. A certeza média, tirando o semif, tem seis valores grudados entre 0.851 e 0.906. No mesmo intervalo, a acurácia se move duas vezes mais largo, de 0.753 a 0.857. A certeza quase não se move quando a distribuição muda; só a acurácia se move. A diferença que sobra é o próprio ECE.
Como essa propriedade aparece na prática, outro benchmark mostra. Numa medição com 2,000 e-mails de phishing e o Claude Haiku 4.5 como grupo de controle, a acurácia do Jev foi 62.6% e a do Haiku, 81.3%. Mas o que mais chama atenção é o ECE. O ECE reportado pelo repositório é 0.154 para o Jev e 0.097 para o Haiku, e quando o registro de auditoria de afirmações remede o P(phishing) do Jev em 10 faixas de 0 a 1, dá 0.170. Lido de qualquer dos dois jeitos, o modelo que ergueu a calibração como objetivo de treino perdeu em calibração para um LLM feito com RLHF. O mesmo autor tirou 91.6% só com a regra da lista de hosts dos links.
Olhando o mesmo indicador em vários conjuntos, a amplitude fica ainda mais clara. A fração que dá para tratar automaticamente com orçamento de erro de 5% é 0.486 no conjunto scienthoon, 0.695 no transfer-v9 e 1.000 no semif. O corretor do Kev anota que esse valor é o máximo obtido escolhendo o limiar dentro da amostra, e não uma garantia de erro depois do deploy. Nenhum desses deve ser citado como se fosse a especificação do modelo.
O gate de detecção de transliteração
Ler o benchmark dos outros é diferente de medir nos meus dados. Então passei de verdade pelo gate da abertura.
Eu ainda não tenho uma chave de API do Jev. Em vez disso, rodei localmente o Kev-9B mencionado antes. É uma implementação de reprodução que põe um LoRA rank-16 e uma pointer head sobre o Qwen3.5-9B-Base, sob Apache-2.0. Os números abaixo não são números do Jev. Os dados de treino do Kev são tarefas de decisão em inglês, e na medição do próprio autor o Kev-9B fica atrás do Jev até em tarefas em inglês. A taxa de automação com orçamento de erro de 5% vai de 0.45 a 0.57, contra 0.70 do Jev, e no MMLU-Pro é 0.52 contra 0.84. Além disso, a documentação da TypeSafe também declara, sobre o Jev, que o inglês é a língua principal de treino e o CJK não está no mesmo nível.
O conjunto de avaliação saiu de 18 posts em coreano deste repositório. O critério de verdade dos rótulos é qual grafia este repositório usa de forma consistente para aquela palavra. Ou seja, não é o consenso da comunidade de documentação técnica em coreano, e sim o costume deste blog; nas palavras em que os dois divergem, o modelo pode estar certo pelo critério da comunidade e errado por este.
- Conjunto do gate, 102 frases. São palavras que o gate já conhece. Há 23 positivos, que são frases contrafactuais em que palavras escritas em inglês no texto original, como
calendar,pickereadapter, foram revertidas para a transliteração coreana, e 79 negativos, que são frases em que de fato aparecem palavras marcadas como exceção pelowrite-post.md, como리렌더링ou콜 스택. Aqui o gate de regex atual acerta 100% por definição. - Conjunto pendente, 60 frases. São palavras que o gate nunca viu. É o que em machine learning se chama conjunto held-out. Há 30 positivos, em que
loader,mutationeprefill, que o texto só escreve em inglês, foram revertidos para transliteração, e 30 negativos com리듀서,스냅샷e런타임, que o texto só escreve em coreano. Aqui a regex não pega um único positivo.
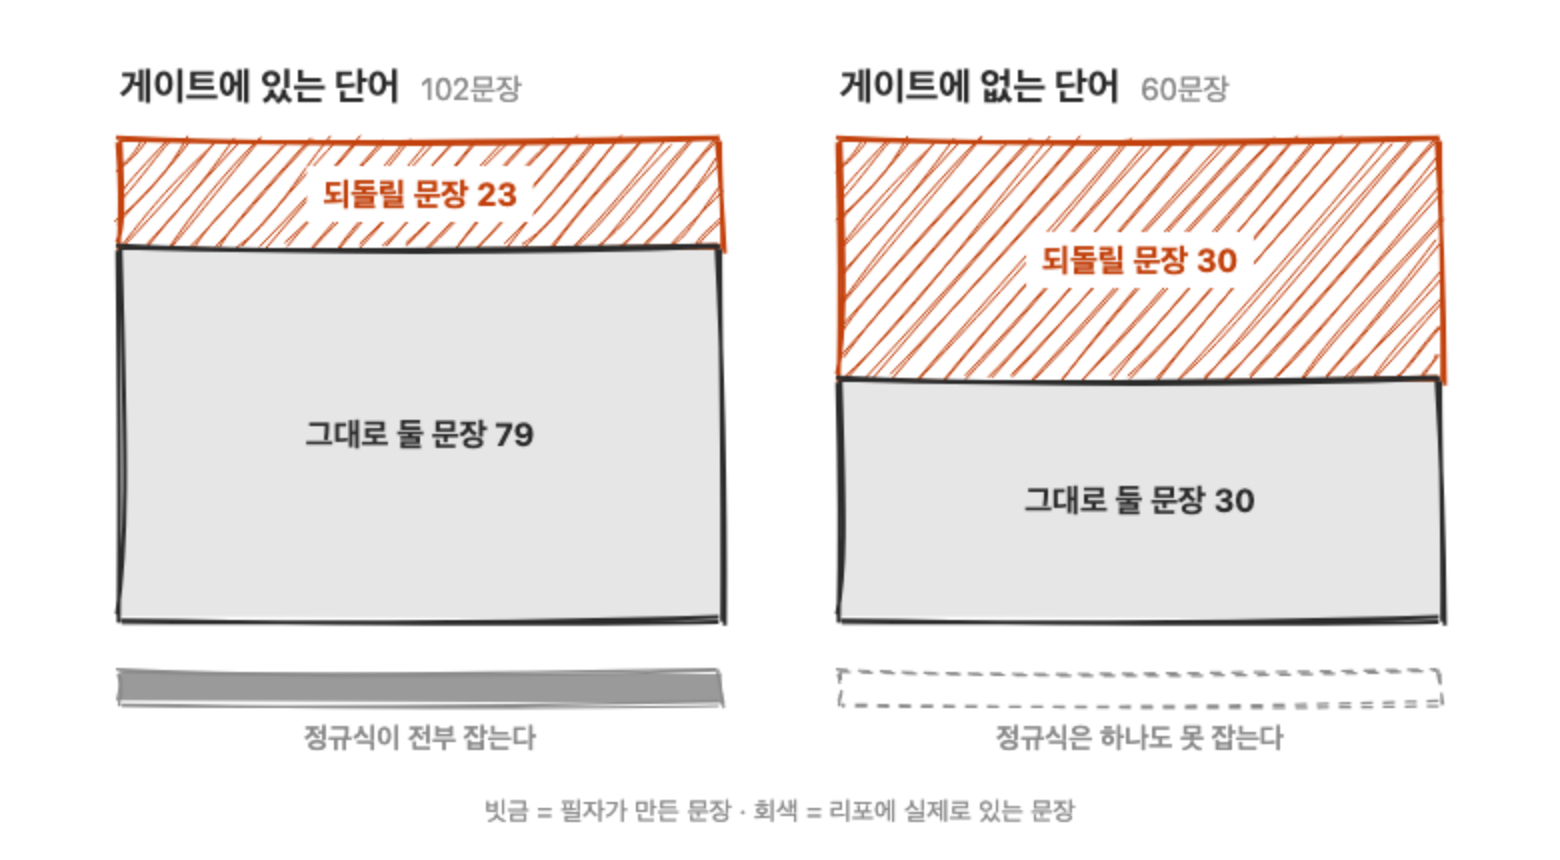
Deixo claro desde já a assimetria de que os positivos são frases contrafactuais que eu mesmo construí e os negativos são frases reais. E a amostra efetiva não é o número de frases, e sim o número de palavras. Como o rótulo é definido por palavra, as frases que contêm a mesma palavra não são observações independentes. O conjunto do gate tem 24 tipos e o conjunto pendente, 13.
A tabela abaixo agrega apenas uma pergunta noul, a que pergunta “esta palavra deve ser revertida para o inglês?”. Coloquei quatro perguntas na mesma requisição, mas as outras três eram a forma negativa, uma variante em Choice e um julgamento sobre compostos cujos rótulos eu não consegui definir direito, então não as misturei aqui. A fração de automação com orçamento de 5% é a maior fração tal que, cortando de cima para baixo pela certeza, o erro da faixa acima do corte não passa de 5%.
| Conjunto do gate | Conjunto pendente | |
|---|---|---|
| Frases / palavras | 102 / 24 tipos | 60 / 13 tipos |
| Gate de regex atual | 1.000 | 0.500 |
| Acurácia do Kev-9B | 0.225 | 0.500 |
| Acurácia por palavra | 6/24 | 7/13 |
| Baseline da classe majoritária | 0.775 | 0.500 |
| ECE | 0.664 | 0.336 |
| Certeza média | 0.876 | 0.821 |
| Fração com certeza 0.9 ou mais | 0.490 | 0.317 |
| Acerto real nessa faixa | 0.240 | 0.526 |
| Automação com orçamento de 5% | 0.010 | 0.000 |
O baseline da classe majoritária é a nota de quem não lê a frase e chuta sempre o rótulo mais frequente. O modelo está abaixo disso.
A última linha é a resposta deste experimento. No conjunto pendente, por mais alto que eu colocasse o limiar, não houve uma única decisão que desse para tratar automaticamente dentro de 5% de erro.
Olhando a distribuição das predições, aparece o que aconteceu. O modelo respondeu “deve ser revertida” a todas as 162 frases. A todos os 37 tipos de palavra. Todos os positivos certos, todos os negativos errados. Por isso o 0.500 do conjunto pendente não é competência: é o número que sai porque o conjunto está balanceado.
E, ainda assim, a certeza média foi 0.876. No conjunto do gate, 49% passaram de 0.9 de certeza, e o acerto real dessa faixa é 0.240.
A identidade estrutural também não se sustentou. Somando as probabilidades de “deve ser revertida” e “deve ficar como está”, a média no conjunto do gate deu 1.655, e todas as 102 frases se afastaram de 1 por mais de 0.1.
É assim por design. As duas perguntas são avaliações separadas que não leem uma à outra, e a própria TypeSafe publicou na página sobre jaggedness um exemplo em que refund 0.72 e not_refund 0.47 somam 1.19.
O ponto que pega na prática é este. Um limiar calibrado para Noul não deve ser transferido para Choice. As frases em que o julgamento é o mesmo mas a conclusão diverge foram de 14% a 17%.
Se fosse um modelo que diz sim a qualquer coisa, este resultado seria sem sentido. Comecei checando isso.
| Estado / pergunta | O que perguntei | Resposta |
|---|---|---|
| Coreano / coreano | Esta frase está escrita em inglês? | 0.02 |
| Coreano / coreano | Esta frase explica uma receita de cozinha? | 0.04 |
| Coreano / coreano | Esta frase está escrita em coreano? | 0.98 |
| Coreano / inglês | Is this sentence written in English? | 0.01 |
| Inglês / inglês | Is this sentence about software? | 0.96 |
Ele lê coreano, diz “não” e separa 0.02 de 0.98. Não é um viés global de concordância. O que isso descarta vai só até aí. Continua de pé a possibilidade de que o enunciado da própria pergunta do gate seja ruim.
O resultado de pôr as regras no state
E se eu der diretamente o conhecimento necessário para distinguir? O método de adaptação de domínio que a documentação da TypeSafe recomenda é esse: sem tocar nos pesos, você manda material de referência dentro do state.
Peguei o parágrafo de regras que já está escrito no write-post.md, coloquei junto no state e rodei de novo. A entrada subiu de 100 tokens por frase para 450. O conjunto do gate é vazamento, porque esse material de referência lista pelo nome as palavras do gate e as palavras de exceção. Então aquele lado é um grupo de controle para ver “ele ao menos lê o material de referência?”, e o teste de verdade é o conjunto pendente.
| Gate (vazamento) | Gate +regras | Pendente | Pendente +regras | |
|---|---|---|---|---|
Acurácia em noul |
0.225 | 0.676 | 0.500 | 0.500 |
| Acurácia por palavra | 6/24 | 7/13 | 5/13 | |
| Positivos corretos | 23/23 | 1/23 | 30/30 | 8/30 |
| Negativos corretos | 0/79 | 68/79 | 0/30 | 22/30 |
| Automação com orçamento de 5% | 0.010 | 0.314 | 0.000 | 0.050 |
| Latência mediana | 2,924ms | 6,903ms | 2,908ms | 6,918ms |
A latência é inferência local rodada num M2 Max, então não está no mesmo eixo da latência de API do Jev vista antes. O que interessa aqui não é o valor absoluto, e sim o fator de 2.4 vezes ao incluir o material de referência.
No conjunto pendente, que é balanceado, a acurácia por frase foi de 0.500 para 0.500: não se moveu em nada. Por palavra, chegou a cair de 7/13 para 5/13.
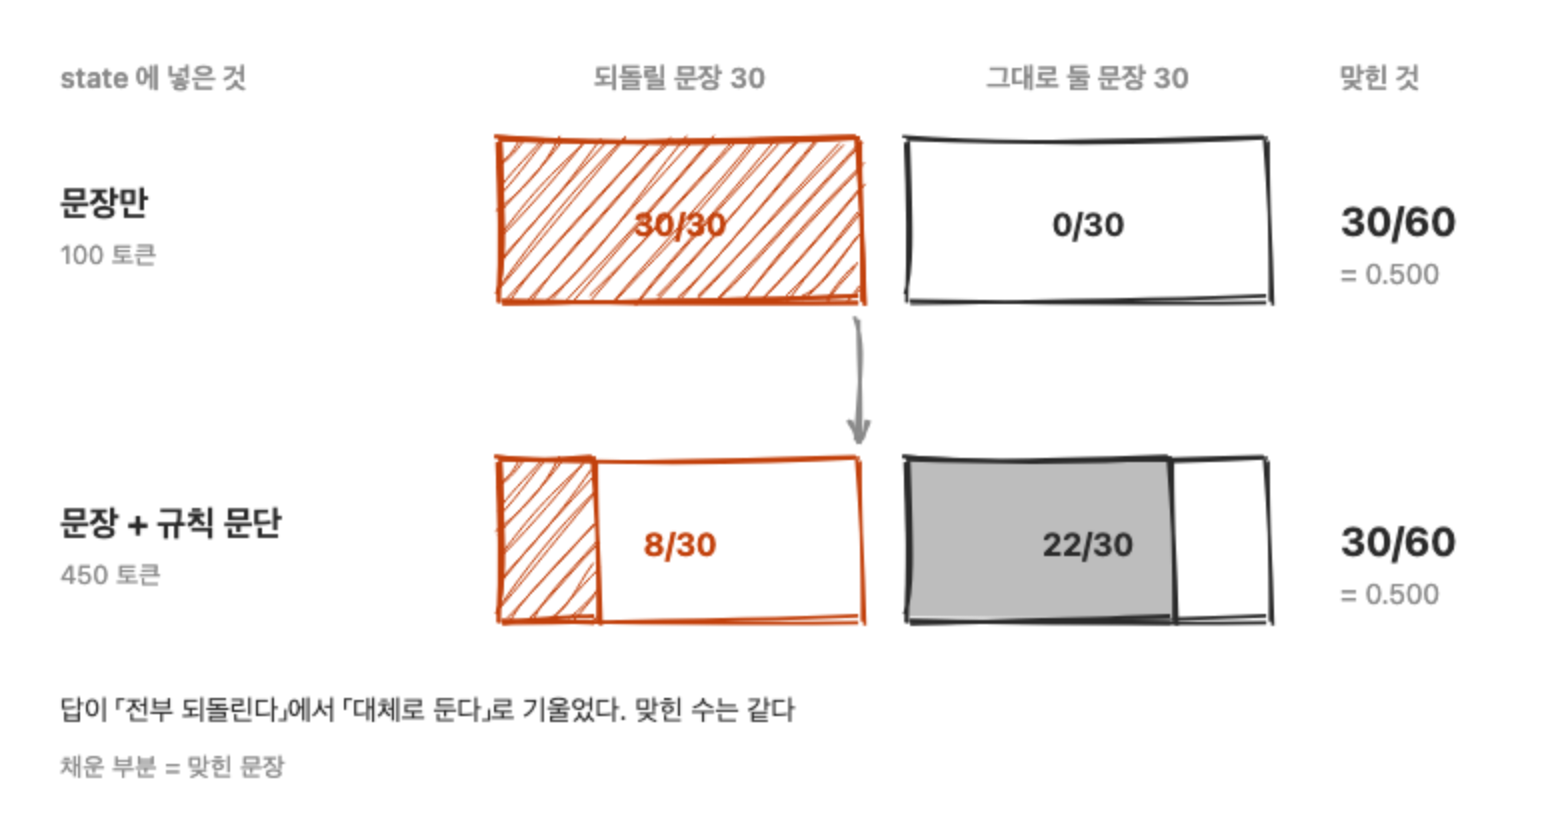
O salto de 0.225 para 0.676 no conjunto do gate não é ganho de competência. Antes, ele dizia “reverter” para todas as 102 frases; com o material de referência, passou a responder isso em apenas 12. Os negativos subiram de 0/79 para 68/79, mas os positivos desabaram de 23/23 para 1/23. Como naquele conjunto os negativos são 79 contra 23, uma constante do tipo “em geral, deixe como está” recebe automaticamente uma nota mais alta. Não aprendeu a distinguir; mudou a inclinação.
Isso não quer dizer que o modelo não leia a frase. São as mesmas frases das mesmas palavras, e ao receber o material de referência as predições se espalharam frase a frase. O desvio padrão de 로더 foi de 0.096 para 0.217, e o de 뮤테이션, de 0.042 para 0.236. Ele lê, mas não consegue distinguir.
E este resultado também abala a interpretação da seção anterior. Se um único texto no state vira a saída inteira do avesso, o “reverte tudo” da primeira execução também pode não ser limite do modelo, e sim insuficiência do enunciado da pergunta. Este texto não conseguiu descartar essa possibilidade.
Uma coisa melhorou visivelmente. A soma das probabilidades de “reverter” e “deixar” no conjunto pendente se aproximou, de 1.508 para 0.963, e as frases muito afastadas de 1 caíram de 59 para 18. Só que a acurácia não se moveu. Uma coisa é as probabilidades das duas perguntas baterem entre si; outra é essas probabilidades estarem certas.
O lugar dos modelos de decisão
Chegando até aqui é fácil pender para a conclusão de que essa categoria inteira de modelo é inútil, mas pôr os benchmarks públicos lado a lado mostra que não é bem assim.
| Tarefa | n | Jev | Comparação |
|---|---|---|---|
| Spam, dentro da distribuição | 18,514 | 98.3% | regressão TF-IDF 98.4% |
| Spam, fora da distribuição | 2,876 | 98.6% | regressão TF-IDF 73.0% |
| Phishing | 2,000 | 62.6% | Haiku 4.5 81.3%, baseline de regras 91.6% |
| rerank, 8 conjuntos em inglês | 1,617 | nDCG@10 0.692 | Cohere Rerank 4 Pro 0.691 |
Só a linha de rerank é um indicador de qualidade de ranking de busca, então está num eixo diferente da acurácia das outras linhas.
Dentro da distribuição, a regex ou um classificador ajustado ganham ou empatam. É o mesmo lugar em que a regex ganhou por 1.000 a 0.225 no meu conjunto do gate. Se dá para juntar rótulos, treinar um modelo pequeno sai mais barato, mais rápido e mais preciso. Isso é o que já se faz há muito tempo.
A distância se abre quando a distribuição é nova e não há rótulos. No spam fora da distribuição, 98.6% contra 73.0%. O classificador ajustado desmorona diante de um formato que nunca viu, e este lado aguenta. O lugar dos modelos de decisão é a decisão para a qual não dá para juntar dados, rotular e treinar. É onde a situação é nova toda vez, os rótulos não se acumulam e mesmo assim a decisão precisa sair em segundos.
Por que a minha detecção de transliteração falhou também se explica por esse quadro. O que aquele julgamento exige não é raciocínio geral, e sim um conhecimento de domínio específico: que palavras se consolidaram na documentação técnica em coreano. Para uma implementação de reprodução de 9B treinada em tarefas de decisão em inglês, isso não está fora da distribuição: simplesmente não existe ali. É aí que está a razão de dar as regras por escrito também não ter funcionado.
Numa matéria do TechCrunch, Armin Ronacher, CTO da Earendil, que faz o harness Pi, disse o seguinte.
At the end of the day, it delegates the hallucination problem a little bit to the user.
Não é que a alucinação tenha sido eliminada: o julgamento foi passado para quem desenvolve. A documentação da TypeSafe também escreve que calibração é uma propriedade que vale para um conjunto de predições, e não uma garantia de que uma resposta individual está certa, e no item Nuance, abaixo da barra de 0% de alucinação do texto de anúncio, está escrito "Our number is not empirical". A forma é garantida; o conteúdo, não.
Os 194 projetos do jevable
Como nos meus dados o Jev falhou, fui ver onde as outras pessoas o estão usando. O jevable.com é uma curadoria independente montada por um desenvolvedor chamado Nikunj, que examina os projetos com Jev publicados no X e os reúne. Em 23 de setembro de 2026 eram 194, e as datas de registro se concentram entre 16 e 20 de setembro de 2026. 152 entraram num único dia, 18 de setembro. Três dias depois do lançamento.
| Categoria | Quantidade |
|---|---|
| Games | 39 |
| Developer tools | 34 |
| Productivity | 31 |
| Agents | 19 |
| Experiments | 18 |
| Creative tools | 16 |
| Data & research, Finance, Browser extensions, Robotics, Marketing | 37 |
Se, em vez de por categoria, reagrupamos por “o que se pergunta”, saem três formas. Os números abaixo são todos os que cada autor escreveu na própria publicação.
Primeira, classificação e roteamento. Classificar 1,500 e-mails, classificar documentos fiscais, classificar 1,891 anúncios de concorrentes em 19 segundos por $0.12, 14 typed checks num único diff de PR, detectar propaganda em notificações do Android, classificar 26 plantas de construção em 2.9 segundos. É a mesma forma do gate de transliteração do início. Como a tabela da seção anterior mostrou, é um lugar onde rótulos se acumulam todo dia, então, com o tempo, um classificador pequeno treinado nos próprios rótulos vence ou empata. A vantagem do Jev está no primeiro dia, quando ainda não há rótulos.
Segunda, loops de escolha de ação. Um browser agent acoplado ao Browser Use que terminou uma busca de passagens aéreas em 7 segundos por $0.0039, um computer use que controla o Mac por voz, um jogo que, cada vez que o Mario morre, faz fork da VM em quatro ramos e escolhe o que sobrevive, um motor de expressões faciais que decide dez coisas a cada mensagem, como boca, sobrancelhas e olhar de um personagem 3D. Como o action space muda a cada passo, não dá para juntar rótulos, e o julgamento precisa descer para abaixo de um segundo. É o mesmo lugar em que a diferença se abriu no spam fora da distribuição. Acho que é também por isso que Games, com 39, é a maior categoria. Jogo é um loop de escolha de ação em que errar pode ser desfeito.
Terceira, UIs que mostram a probabilidade ao usuário. O Ask Jev, que devolve só o veredito em vez de uma resposta; o JevForm, formulário ramificado que escolhe a próxima pergunta por probabilidade; o Upweight, que reordena a primeira página do Hacker News com seis sliders como profundidade técnica e drama. Como o limiar não fica cravado no código e é uma pessoa que lê a probabilidade, é onde a exigência de calibração que este texto questionou é mais baixa.
Uma coisa salta aos olhos. Das 194 descrições, 30 mencionam custo e 53 mencionam velocidade, mas só 7 mencionam acurácia ou uma linha de base. Como os resumos só trazem o começo de cada post, isso é um piso, mas a direção é clara. Que é rápido e barato dá para saber no primeiro dia; se está certo, só dá para saber medindo, e quem mede é raro. Um desses 7 é o jevcal. Partindo de que todo mundo escolhe o limiar no chute, é uma ferramenta que recebe os seus dados e a acurácia alvo e devolve o limiar e a fração de processamento automático. É exatamente o procedimento que a próxima seção recomenda, transformado em ferramenta.
Como traçar a linha
A conclusão deste texto é esta. Não leia a probabilidade que o modelo devolveu como se fosse especificação: meça você mesmo nos seus dados e trace a linha ali.
O procedimento para medir é este. Junte uns 100 casos rotulados, monte a tabela de taxa real de acerto por faixa de probabilidade e vá baixando o limiar de cima para baixo, olhando a taxa de erro da faixa acima dele. Se você definiu um orçamento de erro, a cobertura máxima que respeita esse orçamento é a fração que dá para automatizar. No meu experimento, que o acerto real da faixa acima de 0.9 de certeza fosse 0.240 apareceu com 102 frases.
Uma escala desalinhada quase sempre dá para consertar. Se o excesso de certeza está espalhado de forma uniforme por todas as faixas, uma única temperatura acerta a maior parte. Foi assim que o Kev baixou o ECE de 0.106 para 0.042. O problema é que ajustar essa temperatura exige os rótulos daquela distribuição, e é exatamente isso que não existe em produção. Além do mais, a temperatura não muda a ordem das probabilidades, então a fração automatizável não sobe na mesma medida. Por isso a ordem vale mais que a escala, e a cobertura dentro do orçamento de erro é um indicador mais prático que o ECE.
Se eu tivesse cravado no código o 0.9 que a documentação usa no exemplo, este gate teria corrigido 38 casos errados em silêncio. É uma falha difícil de perceber, porque não dá erro. A documentação da TypeSafe também escreve, logo abaixo daquele exemplo, que você deve testar nos seus próprios dados. O que acaba cravado no código costuma ser o número de cima, não a frase de baixo.
Mesmo sem a chave, medir já dá para começar hoje. O Kev está publicado sob Apache-2.0 e roda em um notebook.
Seria bom contar quantas chamadas, no serviço que você opera hoje, só perguntam sim ou não a um modelo grande. Antes de mover essas chamadas para um modelo de decisão, recomendo medir primeiro onde deve ficar a linha depois da mudança. Foi por ter seguido essa ordem que eu pude decidir não mexer no gate. Quando eu conseguir uma chave do Jev penso em rodar o mesmo conjunto de novo, e se a conclusão mudar eu escrevo isso também.