Observabilidad del sistema
En este post quiero hablar de la observabilidad del sistema.
En mi empresa llevo mucho tiempo trabajando con monitoreo de errores basado en Sentry. Cuando llega un issue, abrir el stack trace, acotar el alcance con releases y tags, y buscar las condiciones de reproducción es un trabajo que me resulta familiar. Sin embargo, este blog no tenía monitoreo de errores, y recién en agosto pasado le acoplé Sentry en una configuración solo de servidor. Y apenas lo hice, esa instrumentación atrapó un incidente real. La segunda mitad de este post es el registro de investigar ese incidente, creer que estaba arreglado, medir de nuevo y confirmar que esa creencia era errónea.
En Observabilidad del navegador vimos qué datos deja el navegador sobre la red, el renderizado y la entrada del usuario. Pero encontrar una solicitud lenta en el navegador no termina el problema. Hay que seguir si esa solicitud fue lenta en el CDN, esperó en el servidor de API, se atascó en una llamada a la base de datos, o atrapó un fallo y devolvió un valor por defecto.
Este post parte de un solo evento de error y sigue cómo cada señal complementa las preguntas que la señal anterior no podía responder. Con breadcrumbs se restaura el tiempo inmediatamente anterior, con traces y metrics se encuentra el camino y el alcance del impacto, y con profiles y Replay se confirma el costo de ejecución y el contexto en pantalla. Al final, la pregunta se amplía hacia qué instrumentar como fallo, incluyendo los eventos que no ocurrieron y los fallos dentro de respuestas exitosas. El incidente que viví estaba exactamente a caballo entre esas dos categorías.
Para los ingenieros de frontend esta frontera se vuelve cada vez más difusa. Una solicitud que empieza en un componente de React continúa hacia Server Components, route handlers, APIs externas, queues y background jobs. El síntoma que aparece en pantalla está en el navegador, pero la causa puede estar en otra capa del sistema.
Antes, entrar en este terreno exigía conocer primero el formato de logs y las herramientas operativas de cada servidor. Hoy, en un producto como Sentry se puede ir y venir entre un error y su trace, profile y replay relacionados, y OpenTelemetry ofrece un protocolo común para que herramientas distintas intercambien señales.
Eso no significa que la observabilidad se complete sola. Qué señales dejar, con qué identificadores conectarlas y a qué llamar fallo son decisiones que debe tomar quien construyó el sistema.
El contexto de un solo error
El punto de partida más familiar es el evento de error. Cuando ocurre una excepción, enviar el mensaje y el stack trace permite saber en qué código falló. Pero lo que la depuración necesita en realidad, más que el objeto de la excepción, es el contexto que lo rodea.
La documentación de Issue Details de Sentry muestra que a un evento pueden adjuntarse no solo el stack trace sino también breadcrumbs, tags, context, release, trace, replay y attachments. Cada elemento responde una pregunta distinta.
| Información | Pregunta que responde |
|---|---|
| stack trace | En qué ruta de código ocurrió la excepción |
| source map | Puede restaurarse la posición del bundle desplegado al archivo y la línea del código original |
| breadcrumb | Qué solicitudes y acciones del usuario hubo antes de la excepción |
| tag | En qué navegador, release, ruta o funcionalidad se repite |
| context | Qué valores estructurados hacen falta para entender este evento |
| release·commit | En qué despliegue apareció por primera vez y a qué cambio está cerca |
| trace | Qué pasó en otros servicios y spans del mismo flujo de solicitud |
| replay | Por qué estados pasó realmente el usuario en pantalla |
Lo importante en esta distinción es la capacidad de búsqueda. Los tags de Sentry son pares key-value diseñados para buscar y filtrar en la UI, mientras que context es un área para leer valores estructurados en el detalle del evento y no es objeto de filtros en la UI. Si se mete todo en context, cada evento individual se enriquece, pero se vuelve difícil responder preguntas recurrentes como "¿en qué tipo de cliente aumentó?".
Al revés, si se envía todo valor como tag, crecen la cardinality y el costo de almacenamiento. Los atributos cuyos valores se multiplican sin límite, como emails, URLs completas o mensajes de error arbitrarios, difícilmente sirven como tags. Diseñar la instrumentación es adjuntar información y, al mismo tiempo, decidir qué preguntas se van a buscar repetidamente. En la investigación mía que veremos más adelante, el papel decisivo no lo jugó un stack trace sino un tag que había dejado casi de pasada.
Instrumentación acoplada solo en el servidor
El Sentry de este blog es solo de servidor. No puse el archivo de inicialización del SDK de navegador. Decidí no pagar el costo de bundle de cliente que agrega la instrumentación del navegador; el propósito de la adopción era atrapar llamadas que fallan en silencio en el servidor, y esa parte era prácticamente gratis. Por eso se divide lo que se atrapa y lo que no. Los errores de route handlers y componentes de servidor, y los fallos de las consultas a Google Analytics que se ejecutan en el servidor, se atrapan. Los errores que solo ocurren en el navegador, como los event handlers de componentes de cliente o los desajustes de hidratación, no.
Había dos cosas que quería verificar por mí mismo en esta configuración.
Una es el alcance del hook automático. Si se cablea el hook onRequestError de Next.js, los errores de ruta no manejados también se capturan sin llamar directamente a captureException. Lo confirmé subiendo a un Deploy Preview una ruta temporal que lanzaba una excepción a propósito, y los eventos llegaron marcados con el mechanism auto.function.nextjs.on_request_error.
La otra son los source maps. Antes de aplicarlos, el culprit de un evento de producción era una posición de bundle ofuscada como y([root-of-the-server]__468aa3ae._). Después de subir los source maps, el mismo tipo de evento se resolvía hasta la ruta src/..., el número de línea e incluso el código fuente circundante. Es el punto donde la pregunta que responde la segunda fila de la tabla realmente se separa.
Dejo aquí una nota lateral. Después de subirlos, había que borrar los archivos .map del resultado del build. Los source maps de servidor que produce Turbopack pesan 57MB, más que el JS de servidor (15MB), y si se dejan ahí se embarcan enteros en el bundle de la función desplegada. Justo existía la opción deleteSourcemapsAfterUpload, que borra los source maps después de subirlos, así que la activé; pero al medirlo, incluso justo después de la subida los .map de servidor seguían ahí, con sus 57MB intactos. Esa opción solo borra .next/static y no toca .next/server, que es donde está el volumen de verdad. Terminé cambiando a especificar directamente las rutas a borrar, y por la misma razón dejé de silenciar siempre los logs de subida y los hice condicionales. Con los logs apagados, si la subida falla por completo porque expiró un token, nadie se entera hasta ver el siguiente stack trace ilegible. Leer la documentación y activar una opción es una cosa distinta de confirmar que esa opción hizo lo que se esperaba.
La diferencia entre grupo y causa
Sentry agrupa eventos similares en un mismo issue. En el grouping por defecto, el stack trace es la señal central, y también se usa información como la exception y el message. Si hace falta, se puede cambiar el criterio de agrupación con fingerprints.
Pero el mismo issue no significa necesariamente la misma causa. Si una función común que envuelve fetch() lanza los errores de red desde un solo lugar, un fallo de DNS, una credencial expirada y una respuesta 500 del upstream pueden mezclarse en un mismo grupo. Al revés, si la misma causa produce excepciones distintas en varias rutas de código, se divide en varios issues.
Un issue es un paquete de incidentes por investigar, no una tabla de clasificación de causas de dominio. Usar el grouping tal cual como recuento de incidentes o KPI de producto hace perder de vista esta diferencia.
Si hace falta, se pueden ajustar los fingerprints o agregar un domain error code como tag. Pero afinar demasiado pronto las reglas de grouping hace perder las mejoras por defecto del SDK mientras solo crecen las reglas operativas. Yo creo que el mejor orden es mirar primero la distribución real de eventos y confirmar qué preguntas bloquea el grouping por defecto.
La línea de tiempo del fallo
Un error suele dejar solo la última escena. El breadcrumb adjunta, en orden cronológico, lo que pasó antes. Además de la navigation, los clicks, los console messages y las HTTP requests del navegador, también se pueden incluir cambios de estado registrados por la propia aplicación.
Se parece al log tradicional, pero el propósito difiere un poco. Un almacén de logs es fuerte para buscar eventos de todo el servicio; el breadcrumb es fuerte para restaurar la pequeña línea de tiempo justo antes de un error concreto.
Por eso, un cambio de estado importante puede necesitarse en ambos lugares. Si el estado de un pago pasó de pending a failed, en los logs operativos se agrega la tasa de fallo global, y en los breadcrumbs del evento de error se ve la secuencia de ese único usuario. No es copiar el mismo hecho, sino crear unidades de búsqueda distintas.
La documentación de Logs de OpenTelemetry describe cómo conectar automáticamente los logs existentes adjuntando los identificadores del trace y el span activos. La verdadera utilidad de los logs no está en el número de líneas sino en los puntos de conexión que permiten moverse hacia otras señales.
El camino donde surgió la latencia
Si el error responde "qué se rompió", el trace responde "por dónde pasó una solicitud y en qué usó el tiempo".
Un trace es un conjunto de spans. La carga del documento en el navegador, fetch, el route handler del servidor, las llamadas a APIs externas, las consultas a la base de datos y los background jobs pueden ser cada uno un span. Si comparten el mismo trace_id, pueden reconstruirse como un único grafo de la solicitud.
Esta conexión no surge de forma automática. Al cruzar el límite de una solicitud hay que transmitir el trace context. El estándar Trace Context del W3C define el formato de los headers traceparent y tracestate. Es el lenguaje común mínimo que permite unir la misma solicitud aunque los proveedores sean distintos.
En el frontend también hay condiciones aquí.
- Enviar trace headers a todos los dominios externos puede generar exposición de información y problemas de CORS.
- Hay que limitar el alcance para que el SDK del navegador solo transmita el context a los API origins permitidos.
- El servidor y el upstream también deben conservar o transformar los mismos headers.
- Si cada servicio toma sus decisiones de sampling por separado, el medio del trace queda vacío.
Cuando un trace se corta, en vez de concluir que no hay datos, hay que confirmar en qué frontera desapareció el context. El tracing distribuido desde el navegador hasta el servidor depende menos de instalar el SDK que del diseño de la context propagation.
Fronteras que merecen un span
La instrumentación automática captura bien las fronteras de las bibliotecas: HTTP requests, llamadas a la DB, el lifecycle del framework. La documentación de Instrumentation de OpenTelemetry explica que la zero-code instrumentation es útil como punto de partida, pero que para ver las decisiones internas de la aplicación hace falta code-based instrumentation.
Por ejemplo, con solo un span automático que dice que toda la API de pedidos tardó 800ms es difícil saber por qué fue lenta. Pueden hacer falta spans de dominio como este.
await tracer.startActiveSpan('checkout.calculate-discount', async (span) => {
  span.setAttribute('promotion.type', promotionType)

  try {
    return await calculateDiscount(cart)
  } finally {
    span.end()
  }
})
Ahora bien, si se crea un span por cada función, el trace se convierte en un registro de ejecución del código. La meta de la observabilidad no es almacenar todas las llamadas sino distinguir hipótesis sobre latencia y fallo.
Una buena frontera de span suele ser una de estas.
- Fronteras donde cambia el responsable del fallo, como red, DB o queue
- Fronteras donde se bifurca la ruta de ejecución, como cache hit y miss
- Fronteras donde se bifurca el resultado de dominio, como la aprobación de un pago o la decisión de permisos
- Trabajos cuyo presupuesto de latencia debe gestionarse por separado
Si mirando un span no se puede decir quién hizo qué y cuánto, hay que revisar la frontera o el nombre.
De la distribución al caso
Guardar todos los traces encarece rápido. Por eso lo habitual es ver el estado global del sistema con metrics y bajar al trace para las solicitudes concretas del tramo anómalo.
La documentación de Signals de OpenTelemetry distingue trace, metric, log y baggage como telemetry signals diferentes. En la documentación de Profiles aparte, la señal de profile figura como Alpha a septiembre de 2026. El modelo de datos y la vía de transporte OTLP ya existen, pero no debe asumirse que está al mismo nivel que las señales estabilizadas.
Las fortalezas de cada señal son estas.
| Señal | Fortaleza | Debilidad |
|---|---|---|
| metric | Tendencia global, tasas, distribuciones, alertas | Poco contexto de la solicitud individual |
| trace | El camino y la latencia de una solicitud | Guardarlo todo cuesta caro |
| log | Registro detallado de los hechos y búsqueda libre | El formato y la cardinality se degradan con facilidad |
| profile | La posición del código que usó CPU y memoria | Sin conectarlo a la solicitud, el impacto en el usuario se difumina |
Estas señales no compiten entre sí. Por ejemplo, se encuentra en el latency histogram la franja donde empeoró el p99, se abre una solicitud lenta con un exemplar o un trace id, y se miran los logs y el profile de ese span.
Grafana Tempo, según su documentación oficial, ofrece una estructura que genera metrics a partir de traces y los conecta con los logs de Loki y las metrics de Prometheus. La ventaja del stack open source es poder diseñar cómo se almacenan y conectan las señales sin quedar encerrado en las pantallas de un SaaS concreto. A cambio, hay que operar uno mismo el Collector, el storage, la retention, el rendimiento de las queries y las actualizaciones.
Dónde vive el costo de ejecución
Del trace se supo que cierto span tardó 2 segundos, pero puede no saberse en qué se usó la CPU dentro de él. El profile llena ese vacío registrando muestras de ejecución a nivel de función y el resource usage.
También aquí las preguntas del trace y del profile son distintas.
- trace: por qué servicios y trabajos pasó la solicitud del usuario
- profile: qué funciones usaron la CPU durante ese tiempo
En 2025, Sentry presentó Continuous Profiling y UI Profiling diferenciándolos de su producto de profiling existente. Continuous Profiling mira el resource usage de larga duración en los runtimes de servidor soportados, y UI Profiling mira el costo de ejecución de las sesiones de usuario. Al principio se centraba en iOS·macOS y Android, pero desde diciembre de 2025 Browser JavaScript y Electron también soportan UI Profiling.
Aun así, no todos los runtimes se miden de la misma forma. En el navegador, el CPU profile de DevTools y los Long Animation Frames pueden ser herramientas más directas para excavar una sesión concreta. Más que el nombre del producto, hay que confirmar las platforms soportadas, el método de sampling, el overhead de recolección y el alcance de la conexión con el trace.
La reconstrucción de la sesión
Cuando un usuario dice "el botón no funcionó", con solo errores y traces es difícil conocer el estado de la pantalla. Session Replay conecta los cambios del DOM, la entrada, la navigation, la console y la información de red en una forma reproducible.
La FAQ de Session Replay de Sentry explica que el replay no es un video que graba píxeles sino el resultado de registrar el DOM del navegador y reconstruirlo después. Por eso puede no ser exactamente igual a la pantalla original, y el canvas y los recursos externos tienen condiciones aparte.
Esta diferencia también importa desde la perspectiva de la privacidad. En el DOM hay valores de entrada, información de cuentas y contenido de publicaciones. El Web Replay SDK de Sentry ofrece por defecto enmascarar el texto y bloquear los medios, pero eso no vuelve automáticamente seguros la estructura del DOM de la aplicación y los custom components. La recolección de los bodies de request y response también debe permitirse explícitamente solo para las URLs necesarias.
Antes de activar Replay hay que decidir primero lo siguiente.
- Qué errores y sessions dejar como muestra
- Qué zonas del DOM y qué entradas enmascarar o bloquear
- Si hace falta recolectar los network bodies y headers
- Quién puede ver los replays y por cuánto tiempo se conservan
- Si el costo del SDK y de la serialización del DOM vale la pena para que lo pague el usuario
Cuanto más fuerte es el contexto del Replay, más fuerte es también su alcance de recolección. La decisión entre la capacidad de depuración y la minimización de datos no debe dejarse solo en los valores por defecto del producto. (Este blog no usa Replay. Como es un servicio donde el rendimiento de carga es la premisa de la visibilidad en buscadores, juzgué que el costo que paga el visitante supera las respuestas que daría la recolección.)
El fallo que se revela por ausencia
Los errores, los traces y el Replay muestran en profundidad el contexto de los hechos ocurridos. Pero si un trabajo programado ni siquiera arrancó, no hay hecho alguno que registrar.
Un cron monitor recibe como check-ins los estados de inicio y finalización del trabajo, y puede generar un estado missed si la señal no llega a la hora prevista. Aquí el objeto de observación no es un error lanzado por el código sino la ausencia del evento esperado.
Para mí esto no es historia ajena. Este blog recolecta automáticamente datos de Search Console todos los lunes, y si alguna semana ese trabajo no corre en silencio, hoy no tengo forma de saberlo. Como no falló sino que no ocurrió nada, no se produce ningún error. El propio dispositivo que reúne los datos de observación está en un punto ciego.
Esta perspectiva se aplica también a los health checks, los queue consumers y los pipelines de recolección de datos. Con solo la metric de "cero eventos de fallo" no se puede saber si hay salud. Hay que mirar a la vez si hubo entradas que procesar, cuándo fue el último éxito y si el volumen procesado está en su rango habitual.
Lo que vuelve difícil la observación suele ser, más que los hechos ocurridos, los hechos que no ocurrieron. Y esta frase regresa una vez más, de una forma que yo no esperaba.
El fallo dentro de la respuesta exitosa
Al revés, también hay fallos donde el hecho ocurrió pero no se ve porque quedó clasificado como éxito. Lo que me encontré apenas acoplé la instrumentación fue exactamente de este tipo.
El plan inicial era simple. Si ponía el reporte de errores en el catch del route handler de la API de estadísticas, sabría cuándo fallaba la consulta a Google Analytics. Pero al hacerla fallar a propósito en un build de producción local inyectando una clave de cuenta de servicio inválida, el error no llegaba al catch de la ruta. Los cuatro bloques catch del módulo de consulta de estadísticas, una capa más abajo, lo atrapaban primero y devolvían valores por defecto, y la respuesta salía así.
HTTP 200 OK
{ "slug": "/260610", "views": 0 }
El visitante ve las estadísticas en 0, y el servidor responde que todo está bien. Mirando solo la tasa de error y el uptime de la ruta, no pasó nada. La condición de éxito del sistema y la condición de éxito del usuario eran distintas. (En qué capa poner el catch lo traté en Manejo de errores; aquella vez la pregunta era "dónde hay que atrapar", y esta vez me encontré con "lo atrapamos y nadie se entera".)
Así que moví los puntos de instrumentación de la ruta a esos cuatro lugares, y les puse un tag que distingue en qué consulta explotó cada uno. Este tag juega más adelante un papel decisivo.
Esta situación ya tiene un nombre preciso. El paper de Gray Failure que Microsoft y el equipo de Azure presentaron en HotOS 2017 dice que los grandes accidentes de disponibilidad en la nube no suelen ser del tipo que se detiene por completo sino que vienen de esta zona gris, y define así su característica central.
Sostenemos que una característica clave del gray failure es la differential observability: que los detectores de fallos del sistema pueden no notar los problemas incluso cuando las aplicaciones los están sufriendo.
we argue that a key feature of gray failure is differential observability: that the system's failure detectors may not notice problems even when applications are afflicted by them.
Un sujeto está sufriendo el daño del fallo mientras otro sujeto no percibe ese fallo, y el problema es que este último es el responsable de detectarlo. Bajar mi punto de instrumentación de la ruta a la capa inferior fue exactamente el trabajo de cerrar esa brecha de percepción.
La solución no es convertir en fallo toda devolución de valores por defecto. El fallback puede ser la elección correcta para proteger la experiencia del usuario. En su lugar, hay que dejar como señales separadas el hecho de que el fallback se ejecutó, la latencia de la llamada original y la funcionalidad afectada.
try {
  return await fetchAnalyticsStats()
} catch (error) {
  captureException(error, { tags: { gaQuery: 'stats' } })

  return { totalPageViews: 0, todayVisitors: 0 }
}
Lo que hay que observar no es la excepción sino el hecho de que el sistema se salió de su camino normal.
La llamada a GA colgada 65 segundos
El primer issue real de producción que llegó tras mover los puntos de instrumentación es la siguiente escena de esta historia. Una llamada a GA fallaba con DEADLINE_EXCEEDED tras 65,877 segundos. Pero por la estructura vista arriba, la respuesta seguía siendo 200. En ese momento la home usaba renderizado dinámico y transmitía por streaming la zona de estadísticas, así que la página en sí aparecía de inmediato. En cambio, ese hueco quedaba largo rato en estado de carga y luego se llenaba de ceros en silencio.
Al excavar la causa, en el archivo de configuración de la biblioteca cliente de GA que uso estaba grabado esto.
"RunReport": { "timeout_millis": 60000, "retry_params_name": "default" }El timeout RPC por defecto de la biblioteca es de 60 segundos, y mi código no pasaba un timeout en ninguno de los cinco puntos de llamada. No es un error solo mío sino un tipo de error sobre el que se ha advertido ampliamente. El artículo sobre deadlines del blog oficial de gRPC, escrito por Gráinne Sheerin de Google SRE, tiene como primera línea bajo el título "TL;DR: Always set a deadline", y explica que sin deadline una solicitud en curso puede retener recursos y quedar colgada hasta el timeout máximo. El cliente de GA que uso también está basado en gRPC, así que la documentación ya advertía el mismo principio, pero los puntos de llamada no lo estaban cumpliendo.
El arreglo fue fijar el timeout en 5 segundos y pasarlo a todos los puntos de llamada. Y lo reproduje de forma determinista levantando un servidor TCP local que no responde.
| Condición | Tiempo transcurrido | Mensaje de error |
|---|---|---|
| Sin timeout (antes del arreglo) | 60,04 segundos | Deadline exceeded after 60.000s |
timeout: 5000 (después del arreglo) |
5,00 segundos | Deadline exceeded after 5.000s |
Como los números se movieron según lo descrito, quedó confirmado al menos que la configuración del timeout llega al código. Aclaro una cosa: el número 5 en sí no tiene fundamento. Como no medí la distribución de latencia de respuesta de GA cuando está sana, es en la práctica un valor elegido arbitrariamente. Pero la dirección sí tenía dónde apoyarse. Embracing Risk, del libro de Google SRE, dice que el 100% nunca es la meta de confiabilidad correcta. En este blog, las cifras de visitantes son información accesoria. Para la experiencia del visitante es mejor rendirse rápido y dibujar los valores por defecto que traerlas con exactitud.
La distribución medida de nuevo tras el arreglo
Hasta aquí iba a ser el desenlace original de esta investigación. Encontré la causa, la reproduje y la arreglé. Pero descubrí que en la release donde se desplegó el commit del arreglo se habían acumulado más de cien DEADLINE_EXCEEDED de la misma familia.
Saqué los 100 más recientes y miré la distribución de los tiempos reportados. Algo que conviene señalar de antemano: este valor no es el tiempo que GA usó realmente en responder. Es el wall-clock time desde el momento en que se armó el temporizador del deadline hasta el momento en que ese temporizador sonó de verdad.
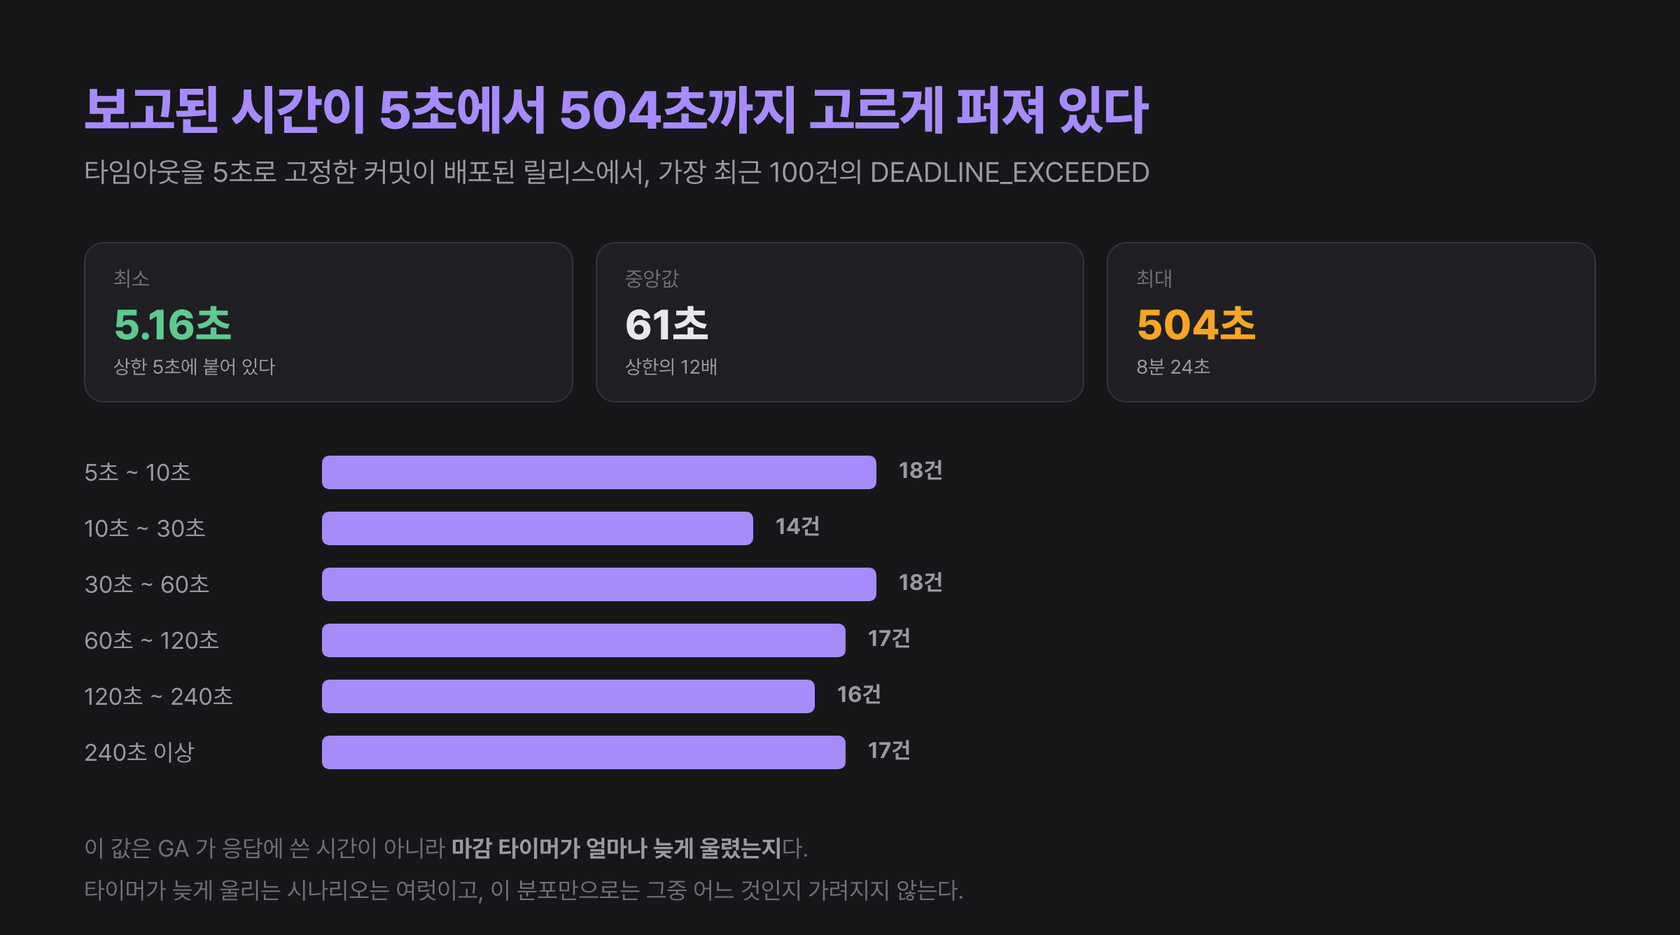
La lectura es esta. El límite inferior se respetó. No hay ni un solo caso cortado antes de 5 segundos, y el más corto es de 5,16 segundos, así que la configuración de 5 segundos en sí llega al código. Pero hacia arriba sube hasta 8 minutos 24 segundos, y la mediana es de 61 segundos. Lo más extraño es que los valores no se concentran en ningún tramo. Si fueran demoras causadas por un GA realmente lento, deberían acumularse cerca del tope, y no es así.
Los tags me dijeron más. Los únicos tags marcados en los 100 casos son stats y popular, y por lo general llegan de a pares. Lo que estos dos caminos tienen en común es que ambos son rutas de revalidación detrás de una caché de una hora. En cambio, las rutas restantes que reciben la solicitud del visitante y llaman a GA en el acto, sin caché (page, pages), no aparecen ni una vez entre los 100. Significa que el fallo no ocurre mientras se atiende la solicitud del visitante sino solo en el trabajo que rellena la caché después de terminada la respuesta.
Esta observación sacude una frase que escribí en una sección anterior. Escribí que el hueco de estadísticas quedaba largo rato cargando, pero si el fallo solo ocurre en la ruta posterior a la respuesta, puede que el visitante nunca haya esperado ese tiempo. Había una frase más escrita sin medir.
La hipótesis que formulé es esta. Este blog corre sobre funciones serverless, y una función serverless, al enviar la respuesta, congela su entorno de ejecución hasta la siguiente invocación. Si durante ese tiempo el temporizador también se detiene y se dispara tarde cuando la función despierta, puede quedar registrado un valor inflado en términos de wall-clock time y no el tiempo realmente esperado. Encaja con que el límite inferior esté pegado exactamente a los 5 segundos, con que los valores superiores no se concentren en ningún lado, y también con la observación de que el fallo solo sale del trabajo posterior a la respuesta.
Pero aquí hay que tener cuidado. Que la distribución no contradiga la hipótesis y que la apoye son cosas distintas. Hay varios escenarios en los que un temporizador se dispara tarde. Además de la congelación serverless, un renderizado pesado pudo estar reteniendo el event loop, o el contenedor pudo estar estrangulando la CPU. También dejé como candidato el hecho de que el presupuesto total de reintentos de la configuración de la biblioteca es de 600 segundos, y el máximo observado de 504 segundos cabe dentro. Todos pueden producir una distribución de esta misma forma, así que este gráfico no acota los candidatos.
Lo que tacha a un candidato es el tiempo de CPU del mismo intervalo. Si mientras pasan 61 segundos de wall-clock time el tiempo de CPU es casi 0, queda descartada la explicación de que un renderizado pesado estaba reteniendo el event loop. Esta es la pregunta que responde la señal de profile que vimos antes.
Pero el tiempo de CPU no lo resuelve todo. Como mientras se espera de verdad una respuesta el tiempo de CPU también se queda cerca de 0, un intervalo de espera y un intervalo detenido se ven con la misma forma. Para separarlos hay que mirar si el tiempo fluyó de manera uniforme dentro de ese intervalo. Por ejemplo, armando un temporizador que se dispara repetidamente a intervalos cortos y viendo si hay un punto donde ese intervalo se abre de golpe. Si el entorno de ejecución se congeló, los intervalos saltan; si de verdad se estuvo esperando, fluyen de manera uniforme. Medir el reloj solo justo antes y justo después de la llamada no sirve. El wall-clock time sigue corriendo incluso mientras la función está congelada, así que solo se recrearía el número que ya se tiene.
Agrego que esta lista de issues, la distribución de tags y los valores de tiempo no los vi abriendo un dashboard, sino que acoplé el servidor MCP oficial de Sentry y se los pedí a un agente. No solo bajó el costo de acoplar la instrumentación; también bajó el costo de abrir los datos acumulados.
La razón por la que dejó de ocurrir no fue el arreglo
Mientras escribía este post, volví a consultar ese issue. Para confirmar si lo que creí arreglado sigue arreglado ahora.
Al 14 de septiembre de 2026, los issues de esa familia estaban detenidos en 144 casos en total. La última ocurrencia fue el 18 de agosto, y desde entonces hay 0 casos en 27 días. La distribución de tags fue hasta el final solo el par stats y popular. Mirando solo el gráfico de ocurrencias, el problema parece haber desaparecido.
Pero yo, en ese lapso, no hice ninguna de las mediciones descritas en la sección anterior. Nunca verifiqué la hipótesis ni arreglé nada, entonces ¿por qué se detuvo? Al cotejar el historial de despliegues, la respuesta estaba en otro lado. La reforma multilingüe commiteada el mismo día en que se registró el último evento quitó de la home las zonas de estadísticas de visitantes y de artículos populares. Las pantallas que llaman a las rutas de revalidación de stats y popular eran exactamente esas dos, así que desde que esa reforma se desplegó a producción, el código que fallaba simplemente no tiene ocasión de ser llamado. No es que el código que fallaba se haya arreglado; desapareció la pantalla que lo llamaba.
Por lo tanto, este incidente no se resolvió: desapareció el objeto de observación. La hipótesis de la congelación serverless quedó sin verificar, y con ella desaparecieron también las condiciones de reproducción para recrear esa distribución en producción. El evento original del primer issue que reportó los 65,877 segundos superó su período de retención y ya ni siquiera se puede abrir.
Tengo una razón para dejar esta sección. El resolved de la lista de issues no es una prueba de que la causa se haya esclarecido. Hay varios caminos para que las ocurrencias lleguen a 0. Que se arregló de verdad, que nadie volvió a pisar ese camino, o que la propia instrumentación desapareció. Con solo la señal de error no se pueden distinguir estos tres. Lo que los distingue son las señales del camino normal, como el volumen de llamadas y el momento del último éxito, y esa es una razón más por la que hace falta la observación de los "eventos que no ocurrieron" de la sección anterior. Si acoplar la instrumentación es un trabajo de una sola vez, observar es el trabajo de seguir midiendo.
El límite de conocimiento del sampling
Los traces, los replays y los profiles necesitan sampling por el costo de almacenamiento y el overhead en el cliente. El problema es que al bajar el sample rate no solo se reduce el costo: también se reducen las preguntas que se pueden responder.
Un sampling aleatorio del 10% puede estar bien para estimar la distribución global, pero puede perder errores raros. Por eso hacen falta políticas que dejen replays adicionales solo para las sessions con error, o que conserven con prioridad los traces lentos y los traces fallidos.
Al revés, si solo se guardan las solicitudes con error, desaparece la base de comparación con los usuarios normales. No se puede juzgar si una solicitud lenta es especialmente lenta o si todo el sistema está lento.
Yo también pagué este costo. Este blog, para ahorrar, estaba configurado para recibir solo el 10% de las muestras de trace, y en la investigación de arriba, para dirimir si los tiempos transcurridos inflados eran espera real hacían falta el inicio y el fin del tramo de esa llamada, y la muestra era tan superficial que no había trace de las solicitudes problemáticas. Lo que ahorré fue mi factura y lo que perdí fue una pregunta que podía responder.
El sampling debe ser una política por pregunta, no un solo número.
- Una muestra probabilística para el baseline
- Una muestra prioritaria para los errores y los latency thresholds
- Una muestra temporal para investigar una release o funcionalidad concreta
- Una muestra aparte para replay·profile, donde la privacidad y el costo pesan más
Los datos que no se guardaron no los puede restaurar después ni la IA.
El diseño de instrumentación después de la IA
La razón por la que la IA es útil en la observación de sistemas es que los datos ya están estructurados. Issue, event, tag, span, trace y release se pueden consultar por API, y los logs y profiles también tienen tiempo e identificadores. Que yo pudiera obtener la distribución de tags de un issue y la fecha en que dejaron de ocurrir preguntándole a un agente desde el editor también se debe a esta estructura.
En junio de 2026, Sentry amplió la documentación de la API que usan los agents y la automatización, incluyendo endpoints relacionados con tracing, profiling y attachments. Muestra que los datos de observación se usan no solo como información que las personas leen en dashboards, sino también como interfaz donde los agents consultan evidencia.
La IA acelera exploraciones como estas.
- Encontrar combinaciones de issue y tag que crecieron tras una release reciente
- Resumir los spans lentos de un trace concreto y sus logs asociados
- Encontrar breadcrumbs y entornos de navegador comunes a varios eventos
- Conectar los hot paths de un profile con commits candidatos
- Proponer hipótesis de reproducción y puntos de instrumentación adicionales
Pero el domain state que no se instrumentó tampoco lo puede conocer el agent. Dónde dejar atributos como checkout.result, cache.status y fallback.reason solo puede decidirse entendiendo el código y las expectativas del usuario. Que en mi investigación el agente pudiera extraer al instante la distribución y los tags fue porque antes existió la decisión de bajar los puntos de instrumentación de capa y ponerles tags.
La IA puede proponer root causes, pero qué definir como fallo y a qué usuarios observar con qué costo es un juicio de ingeniería.
Las señales en un solo incidente
Encender todas las funciones de Sentry no es la conclusión de este post. Desde un error hay que poder mirar el pasado con breadcrumbs, seguir el camino de la solicitud con el trace, confirmar el alcance del impacto con metrics, y bajar a replay y profile cuando haga falta. A esto deben sumarse, en el mismo flujo de investigación, la ausencia de eventos esperados, como con el cron monitor, y las desviaciones clasificadas como respuestas normales.
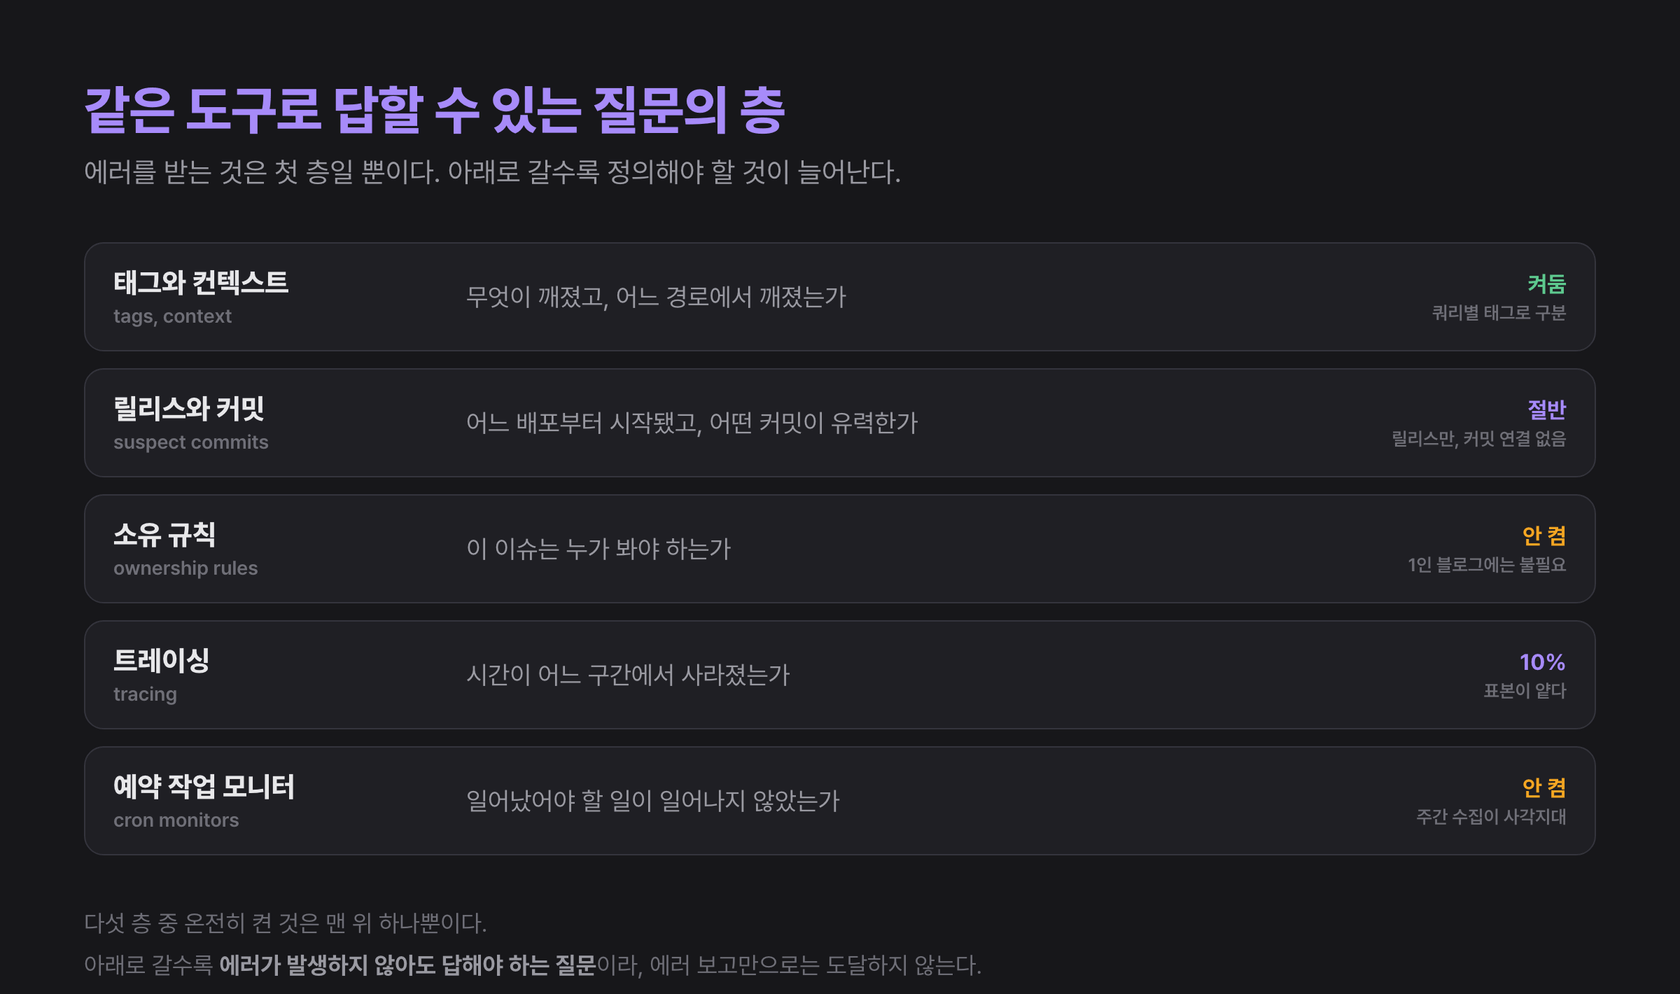
No creo que sea un boletín vergonzoso el hecho de que, de las cinco capas, lo único que este blog encendió por completo sea un solo tag. Qué capa encender no se decide hojeando la lista de funciones: solo después de decidir qué se va a considerar fallo se puede saber qué capa hace falta. Eso sí, en esta investigación los vacíos de dos capas, la muestra superficial de traces y el punto ciego de la recolección semanal, volvieron como costos reales, así que las próximas capas a encender ya quedaron decididas.
El trace context y las semantic conventions de OpenTelemetry extienden este camino de navegación más allá de un producto concreto. Eso sí, la browser instrumentation de JavaScript sigue siendo experimental y la señal de profile es Alpha. Hay que distinguir entre el hecho de estar incluido en el estándar y el hecho de poder usarse de forma estable en cada runtime.
La IA encuentra rápido candidatos para buscar y conectar estas señales. Pero la profundidad de la observación no la decide el número de funciones del producto sino si se puede uno mover entre las señales y si se expresó el estado que se salió del camino normal. Mis respuestas 200 no hablaron de fallo ni una sola vez hasta que planté la señal, y solo después de plantarla se reveló que aquello había sido un fallo.
En el próximo artículo, De la observación al juicio, quiero ver cómo interpretar junta esta información del sistema con los datos de usuario de GA4 y Search Console. Porque con solo mirar el sistema en detalle no se puede decidir qué arreglar primero. Antes de eso, me gustaría que los lectores de este post recuerden un issue que hayan cerrado como resolved. ¿Ese issue se detuvo porque se arregló, o simplemente nadie volvió a medirlo?