De la observación al juicio
En este artículo quiero hablar de cómo convertir los datos de observación en juicio.
Llevo unos años operando yo mismo GA4 y Search Console en este blog. Miro con qué consultas de búsqueda llegan los visitantes y, en función de eso, corrijo el título y la descripción de los artículos, una y otra vez. Sin embargo, resultó que llevar mucho tiempo mirando los datos y tomar buenas decisiones con esos datos son problemas distintos. Como contaré más adelante en este artículo, estuve a punto de llegar a dos conclusiones opuestas sobre las mismas métricas del mismo artículo en un intervalo de dos meses.
En la anterior observación del navegador vimos la información de rendimiento que produce el navegador, y en observación del sistema, los errores, logs y traces que deja el sistema. Cuando esta información se acumula lo suficiente, cómo se comporta el servicio se ve mucho mejor que antes. Pero qué arreglar primero, si ese problema importa de verdad a los usuarios y si la experiencia mejoró tras la corrección siguen siendo preguntas distintas.
El núcleo de este artículo no está en unir los datos a la fuerza a nivel de usuario, sino en comprobar la misma hipótesis de producto con distintas unidades de observación. Y tener más fuentes de datos no mejora automáticamente el juicio. En el momento en que pones en un mismo gráfico números con muestras y reglas de agregación distintas, hasta cambios sin relación pueden quedar atados en una historia verosímil. Lo que necesita la última etapa de la observación no son más dashboards, sino la capacidad de distinguir qué vio cada dato y qué no pudo ver.
Las tres capas que observa este blog
En lugar de empezar con abstracciones, es mejor desplegar primero mi propio caso. Este blog ha acabado observando en tres capas.
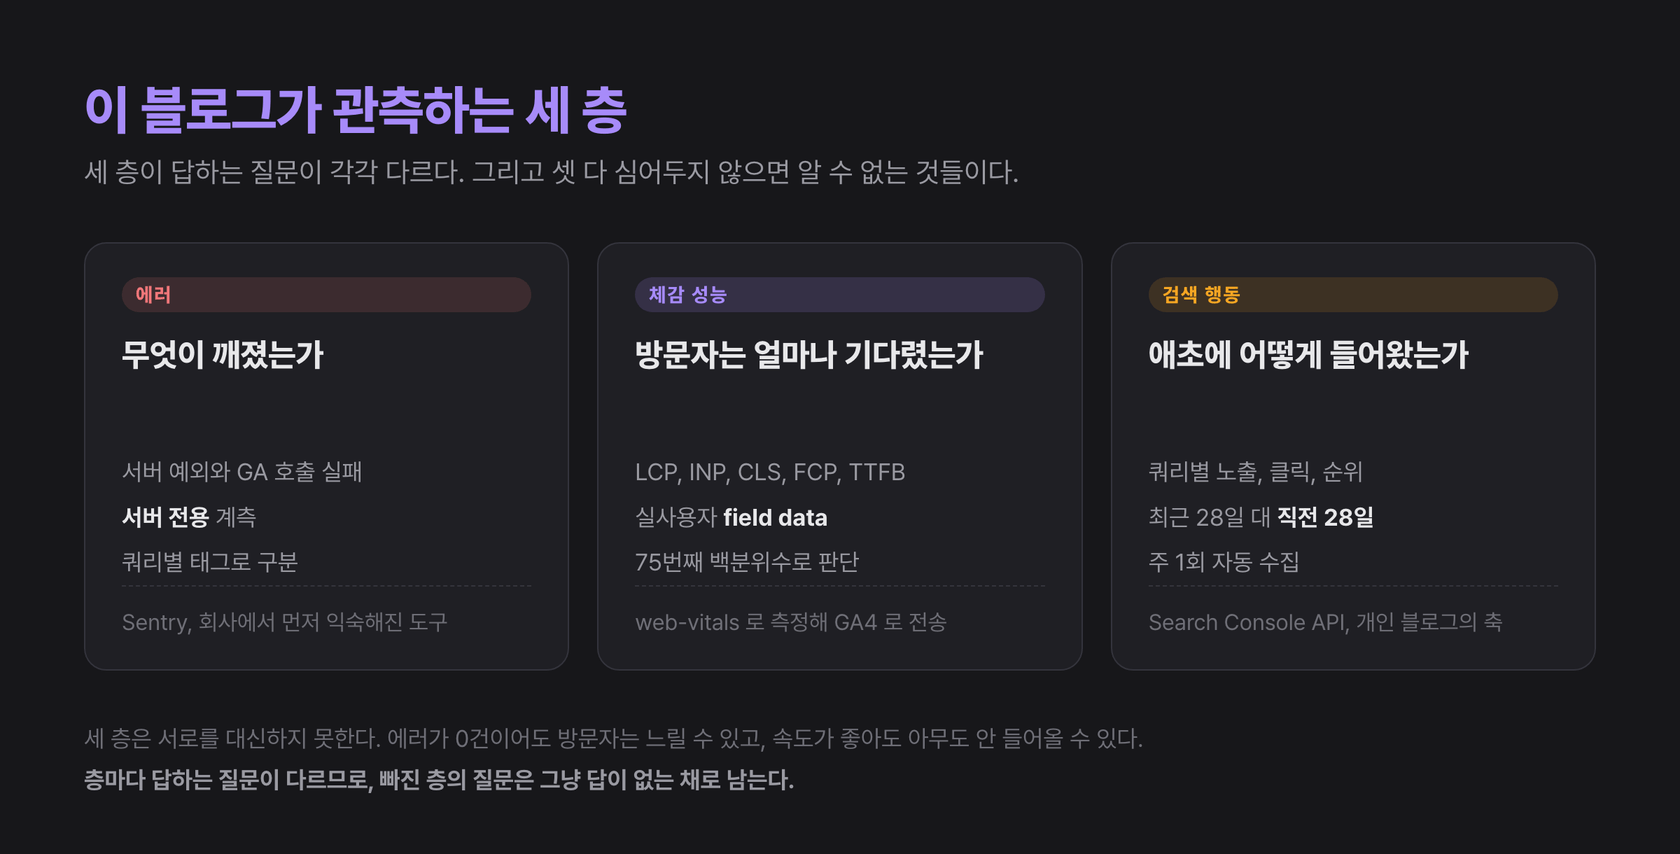
La primera capa es Sentry. Con instrumentación solo de servidor, atrapa las excepciones y las llamadas a GA que fallan en silencio. La segunda capa es el rendimiento percibido por usuarios reales. Los Web Vitals medidos en el navegador se envían a GA4 y se acumulan. La tercera capa es el comportamiento de búsqueda. Los datos de Search Console se recogen automáticamente cada semana, comparando los últimos 28 días con los 28 anteriores. Cada capa responde a una pregunta distinta. Qué se rompió, cuánto esperaron los visitantes y con qué consultas llegaron en primer lugar.
Las tres capas no pueden sustituirse entre sí. Con cero errores, los visitantes aún pueden sufrir lentitud, y un sitio rápido puede ser uno al que nadie entra. Las dos primeras capas se trataron en los dos artículos anteriores, así que el peso de este está en la tercera capa y en cómo leer las tres juntas.
Siendo honesto, el GA4 de este blog no se usa en profundidad como herramienta de análisis de comportamiento. Se parece más a un almacén de páginas vistas y de eventos web_vitals. Por eso, la parte de GA4 de este artículo combina las restricciones que he confirmado operándolo con criterios de diseño verificados en la documentación oficial. Distinguiré, sección por sección, hasta dónde llega la experiencia y desde dónde empieza la investigación.
Unidades de observación distintas
Es fácil llamar datos de usuario al RUM del navegador, a Sentry, a GA4 y a Search Console, pero sus unidades reales de observación difieren.
| Capa | Datos representativos | Unidad de observación | Pregunta que responde principalmente |
|---|---|---|---|
| Experiencia del navegador | LCP, INP, CLS, resource timing | Visitas de página e interacciones | Qué esperó el usuario y cuánto |
| Estado del sistema | error, span, trace, log, profile | Eventos y peticiones | Dónde falló o se ralentizó algo |
| Comportamiento de producto | GA4 event, session, key event | Acciones y sesiones | Qué hizo el usuario dentro del servicio |
| Intención de búsqueda | query, impression, click, position | Impresiones de búsqueda | Con qué problema llegó el usuario |
Aunque parezca el recorrido de una misma persona, no todas las capas observan al mismo usuario. Los bloqueadores de anuncios pueden bloquear las peticiones de GA y Sentry, y la muestra de analytics cambia según el estado del consentimiento de privacidad. Search Console proporciona datos agregados de los resultados de búsqueda, no usuarios individuales. CrUX es field data de usuarios de Chrome que cumplen ciertas condiciones.
Por tanto, es normal que los números de las cuatro capas no cuadren exactamente. El problema no es eliminar las diferencias, sino registrar a qué pregunta de qué muestra responde cada número.
El modelo de eventos de GA4
Un GA4 event modela una interacción del usuario con un nombre y parámetros. La documentación de configuración de eventos de Google distingue los eventos que el SDK recoge automáticamente, la enhanced measurement que se activa por configuración, los recommended events con nombres y parámetros prescritos, y los custom events que define el propio servicio. La misma palabra event difiere en quién posee su significado y su esquema.
Al principio dan ganas de enviar el mayor número posible de clics y transiciones de pantalla. Pero tener muchos eventos no profundiza la comprensión del usuario. Si conviertes la ubicación de la implementación en nombres, como button_click, button_click_2 y main_button_clicked, el significado analítico se derrumba cada vez que cambia el código.
Un buen evento expresa la intención del usuario más que un suceso del DOM.
gtag('event', 'article_reference_open', {
  article_slug: '260916',
  reference_type: 'specification',
  link_position: 'body',
})
Este evento deja constancia de que el usuario abrió una referencia del artículo, no de qué componente de botón pulsó. Aunque cambie la UI, la pregunta de análisis se mantiene.
Antes de diseñar eventos conviene escribir primero lo siguiente.
- Qué comportamiento del usuario se quiere entender
- Qué suceso determina que ese comportamiento ocurrió
- Cuáles son los parámetros mínimos que necesita el análisis
- Qué decisión se tomará cuando cambie este número
- Cómo se verificarán los duplicados y las omisiones
Si las dos últimas preguntas no tienen respuesta, el evento se convierte fácilmente en decoración del dashboard. (Aquí está también la razón de que el GA4 de este blog se quede en almacén. El único evento que puede responder a la pregunta 4 sigue siendo web_vitals.)
La diferencia entre recibir y reflejar
Con el GA4 Measurement Protocol se pueden enviar eventos desde servidores u offline systems fuera del navegador. Pero la referencia del Measurement Protocol de Google especifica una limitación importante. El endpoint de recogida devuelve 2xx cuando recibe una petición HTTP, y no devuelve un estado de error aunque el payload esté mal formado o los datos no se procesen.
Un HTTP 2xx significa que la petición fue recibida; no es prueba de que el evento haya entrado correctamente en el informe deseado. El fallo dentro de una respuesta de éxito que tratamos en el artículo de observación del sistema existe también en la recogida de analytics. Igual que en este blog había estadísticas vacías escondidas tras respuestas 200, en analytics el éxito del envío tampoco equivale al éxito del reflejo.
Por eso, antes de desplegar hay que comprobar el payload con el validation endpoint o el Event Builder, y después del despliegue hay que verificar el event pipeline en al menos tres etapas.
- Envío: ¿el client o el server mandó la petición?
- Recogida: ¿se ven el evento y sus parámetros en Realtime y DebugView?
- Análisis: ¿se puede consultar con las dimensiones previstas en los informes finales y el export schema?
Aunque el código que envía los datos tenga tests, si falta la configuración de recogida o el registro de una custom dimension, el valor no puede usarse en la etapa de análisis. Analytics también es un sistema operativo que necesita verificación posterior al despliegue.
Las preguntas que abren los eventos en bruto
Los informes por defecto de GA4 sirven para ver rápido las preguntas frecuentes sin manejar directamente los raw event. Pero aparecen límites cuando quieres combinar libremente eventos y parámetros o unirlos con otros datos.
BigQuery Export permite exportar los raw events de GA4 a diario o en modo streaming. El daily export de una standard property tiene un límite de un millón de eventos al día. El streaming export es rápido pero best-effort, no incluye la attribution de usuarios nuevos, y la attribution de usuarios existentes puede tardar en procesarse por completo. Esa es la razón de usar events_intraday_* para el análisis del mismo día y las tablas events_* finalizadas para el análisis diario estable.
Con acceso a los raw events se vuelven posibles preguntas como estas.
- ¿Cambió la tasa de navegación a la página siguiente en las sesiones que sufrieron un LCP lento?
- ¿Cambió la tasa de finalización de acciones clave en las sesiones con errores tras una release concreta?
- ¿Varía la profundidad de lectura dentro de la landing page según el tipo de query de búsqueda?
- ¿Difiere el interaction pattern de la misma función entre mobile y desktop?
Pero los raw data entregan, junto con la libertad de interpretación, la responsabilidad de manejar uno mismo la duplicación, la late arrival, la sessionization y las zonas horarias. Saber escribir SQL no garantiza un modelo de usuario correcto.
La intención que muestra la búsqueda
GA4 mira el comportamiento del usuario después de entrar en el sitio. Search Console muestra, antes de eso, con qué queries y resultados de búsqueda fue expuesto y clicado.
La Search Analytics API puede agregar clicks, impressions, CTR y position por dimensiones como query, page, country, device y search appearance. Pero la documentación oficial de la API explica que no garantiza todas las rows y devuelve las rows superiores según límites internos. La suma de las queries pequeñas puede no cuadrar exactamente con el total general.
Esta restricción no es una advertencia que viva solo en la documentación; es un fenómeno visible cada semana en mis CSV. En los datos de los últimos 28 días recogidos el 11 de septiembre, la suma de clics en la dimensión page es de 47, mientras que la suma de clics en la dimensión query es de 8. Mismo sitio, mismo periodo, y aun así la mayoría de los clics es invisible en la dimensión query. Las queries raras o anonimizadas simplemente no se devuelven como rows. Si intentas explicar todo el tráfico con los datos de query, acabas llenando ese hueco con imaginación.
La position media tampoco es una simple tabla de clasificación. Es un valor agregado de impresiones generadas en múltiples queries, devices, países y search appearances. Si cambia la composición de queries, la media puede moverse aunque el ranking de cada palabra clave siga igual.
El ranking bajó, pero los clics subieron
Me encontré con esta propiedad de la position media en los datos reales de este blog. ¿Puede Biome sustituir a ESLint y Prettier? es un artículo de diciembre de 2024, y durante mucho tiempo tuvo extrañamente pocos clics en relación con sus impresiones. Así que el pasado junio reescribí su seoTitle acercándolo a la forma de las consultas de búsqueda reales. Es un título de tipo comparativo que empieza por "Biome vs ESLint vs Prettier".
En la comparación de 28 días recogida a principios de agosto, las cifras del artículo se movieron así. Las impresiones cayeron un 11%, de 230 a 204, y la position media retrocedió de 8.9 a 11.6. Mirando solo esas dos métricas, es un artículo que empeoró. Pero los clics subieron de 2 a 13, y el CTR pasó de 0.87% a 6.37%.
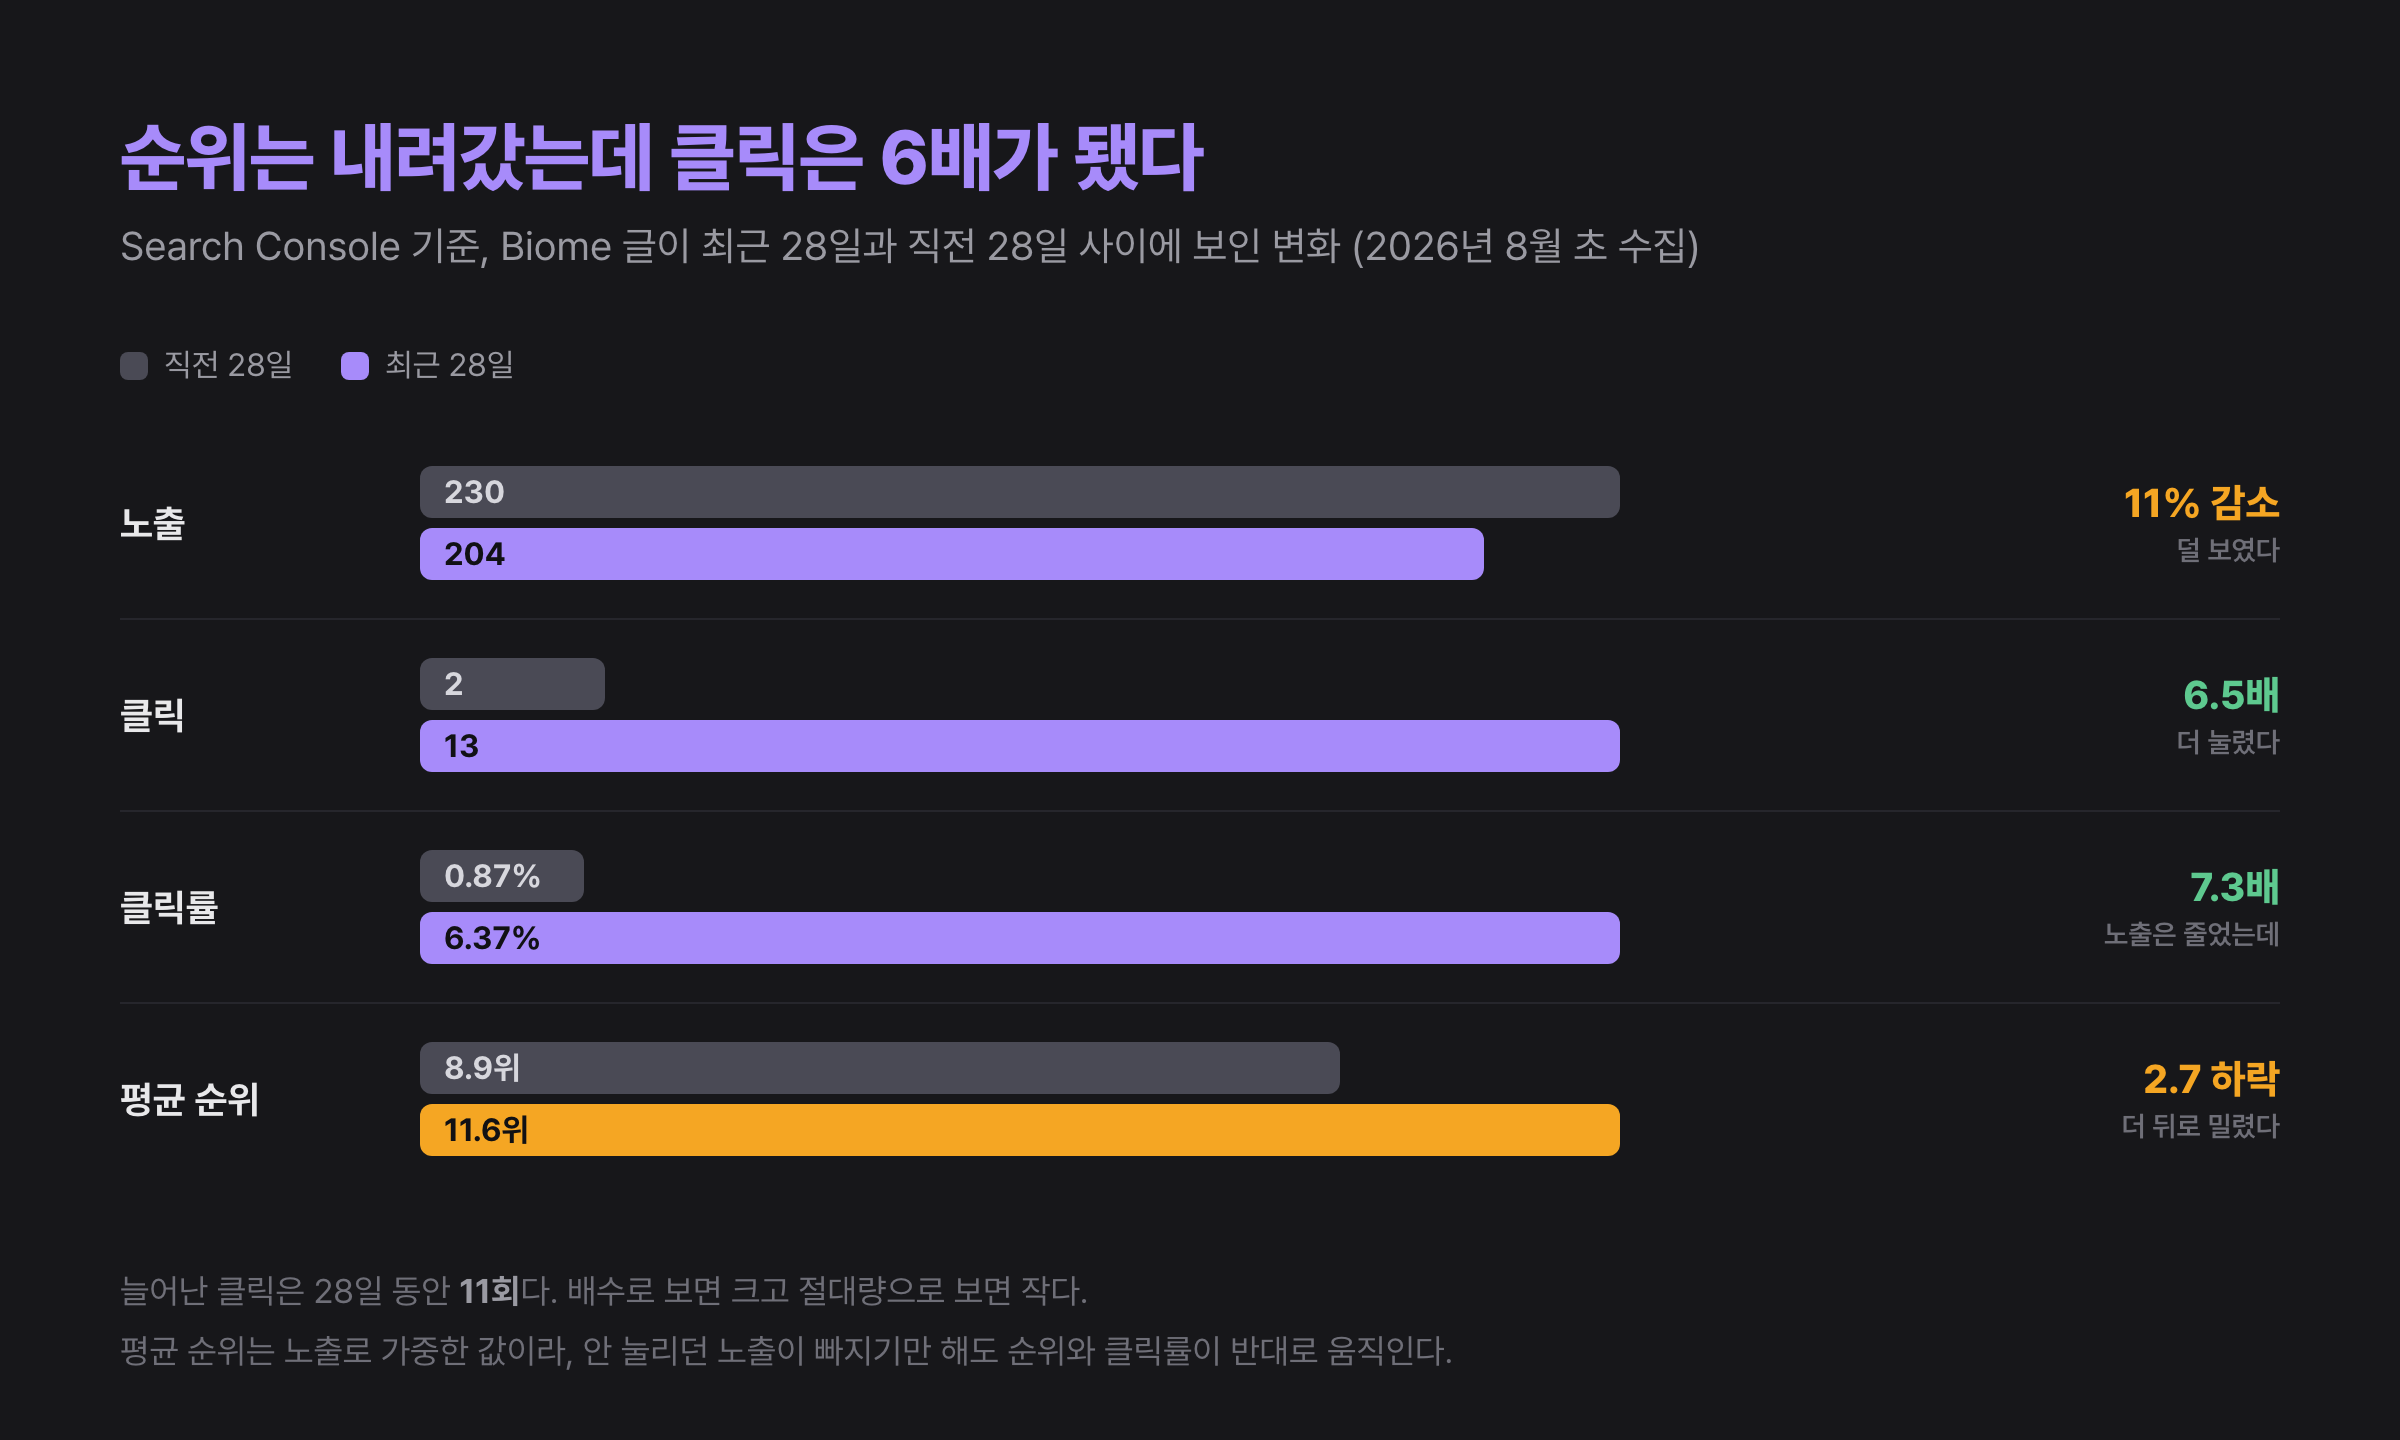
Lo honesto es desinflar esto primero. Estas cifras no demuestran el efecto del cambio de título. La position media es una media ponderada por impresiones, así que basta con que desaparezcan impresiones que salían arriba pero que nadie clicaba para que la posición empeore y el CTR suba mecánicamente. El query mix y la estacionalidad también pueden variar entre periodos, y el aumento absoluto de clics es de 11 en 28 días. Grande como múltiplo, pequeño en términos absolutos.
Aun teniendo eso en cuenta, algo queda. Si tomas el ranking como resultado, es un artículo que hay que retocar; si tomas el tráfico real como resultado, es un artículo que mejoró. Qué eliges como métrica de resultado cambia la conclusión de los mismos datos. Si yo hubiera estado mirando solo la caída del ranking, habría vuelto a desmontar un artículo que empezaba a funcionar.
Las cifras consultadas de nuevo en septiembre
Mientras ordenaba esta serie, volví a consultar el estado actual del mismo artículo. Cuando escribo sobre trabajo pasado, mi regla es comprobar si ese estado se mantiene todavía, y esta vez también me alegré de haberlo hecho.
En los últimos 28 días recogidos el 11 de septiembre, este artículo tiene 185 impresiones, 6 clics, un CTR de 3.24% y una position media de 20.8. Los clics bajaron a menos de la mitad del pico de 13, y la position media retrocedió durante todo el verano, 8.9 → 11.6 → 14.5 → 20.8 en orden de recogida. Es decir, la narrativa del giro, el ranking bajó pero los clics subieron, fue más nítida en la ventana de comparación de principios de agosto, y la ventana siguiente volvió a sacudir esa narrativa.
Esta nueva consulta no revierte la conclusión de la sección anterior. Los clics siguen por encima de los 2 previos al cambio, y el CTR sigue por encima del 0.87%. Además, cinco de las seis queries de búsqueda con clics registrados en este blog son queries comparativas de este artículo, como "eslint vs biome". Pero se sumó una lección. No solo la elección de la métrica: la elección del periodo de comparación también cambia la conclusión. Si completas una narrativa con una sola comparación de 28 días, los siguientes 28 días la romperán. Y todavía no sé por qué la position media sigue retrocediendo. Puede que haya cambiado la composición de las queries en las que aparece, o que hayan aumentado los documentos competidores. Hasta comprobarlo, queda como no resuelto.
Conexiones que empiezan por una hipótesis
Cuando se habla de conectar datos, lo primero que se piensa es en unificar los user id y session id. Por supuesto, tener dimensiones comunes como trace id, release, route y timestamp facilita el análisis. Pero unir todos los datos a nivel individual no debe convertirse en el objetivo.
Las queries de Search Console no pueden vincularse a individuos y tampoco deben vincularse. Los GA events de usuarios que no dieron su consentimiento pueden no existir. En los eventos de Sentry hay muchos errores que no necesitan identificar al usuario.
Por eso es mejor decidir primero la unidad de observación de la hipótesis.
| Hipótesis | Unidad de observación apropiada |
|---|---|
| Los errores de pago aumentaron tras la nueva release | Error rate y key event completion por release |
| Los usuarios de mobile empiezan a leer los artículos tarde | Distribución de LCP y engagement events por device |
| La landing page no encaja con cierta intención de búsqueda | Impression y CTR por query cluster y comportamiento por page |
| Un fallback se repite sin que el usuario lo vea | Eventos por fallback reason y proporción de sessions afectadas |
Con la hipótesis por delante, muchas veces se puede responder bien a nivel agregado sin identificadores personales. El caso anterior del artículo de Biome también es así. Lo que yo necesitaba no eran los usuarios individuales que clicaron ese artículo, sino una comparación en ventanas de 28 días de la composición de queries y los clics. La precisión de la observación y la precisión del rastreo de usuarios no son lo mismo.
Los límites de la correlación
El error más común al conectar datos de observación es leer como causa y efecto dos valores que se movieron en el mismo periodo.
Supongamos que la conversión cayó la semana en que empeoró el LCP. El rendimiento puede ser la causa, pero también son posibles el tráfico de campaign, cambios de precio, inventario, estacionalidad y cambios en el device mix. Si comparas medias globales, basta con que aumente el tráfico mobile para que los dos valores se muevan juntos. Por la misma razón, yo no até de inmediato el cambio del seoTitle y el aumento de clics como causa y efecto. El hecho de que dos sucesos se sigan en el tiempo no basta.
Estrechar la pregunta en este orden reduce las conclusiones precipitadas.
- ¿Cambiaron en la misma franja temporal?
- ¿Se mantiene la relación en el mismo entorno de usuario y route?
- ¿Encaja con una release o un punto de cambio concreto?
- ¿Se puede confirmar a nivel de evento el orden entre error y rendimiento?
- Tras una corrección o un experimento, ¿vuelve en la dirección esperada?
Los datos de observación son fuertes para reducir los candidatos a causa. Para confirmar la causalidad hacen falta, además, experimentos controlados, experimentos naturales o cambios reproducibles.
Distribuciones y proporciones
Cuanto más se comprimen el sistema y la experiencia de usuario en medias, más desaparecen los grupos importantes.
Con un LCP medio de 2 segundos, algunos usuarios de mobile pueden estar sufriendo 8. Aunque el error rate global sea bajo, puede concentrarse solo en un browser concreto que recibió la nueva release. Aunque el CTR suba, si las impressions cayeron bruscamente, la composición misma de los usuarios alcanzados puede haber cambiado. El CTR de 6.37% del artículo de Biome era exactamente este caso.
Por eso hacen falta combinaciones como estas.
- Rendimiento: no solo la median, también p75 y p95
- Errores: no solo el event count, también los affected users y la proporción de sessions
- Comportamiento: no solo el número de eventos, también la tasa de finalización sobre eligible users
- Búsqueda: no solo el CTR, también impression, click y query mix
- Despliegues: no solo el periodo completo, también el antes y después de la release y el tramo de despliegue gradual
También hay que guardar el denominador de las proporciones. 100 checkout errors por sí solos parecen un gran problema, pero el juicio cambia según sean 100 de 100 intentos o 100 de un millón.
Consentimiento y calidad de los datos
Cuanto más a fondo se trata la observación de usuarios, más difícil resulta tratar la privacidad y el consentimiento como una checklist legal añadida al final. Porque lo que se puede recopilar determina qué análisis son posibles.
La documentación oficial del Consent Mode de Google describe cómo los tags y SDK ajustan su comportamiento de almacenamiento y envío según el estado de consentimiento del usuario. El modo Basic bloquea los tags antes del consentimiento. El modo Advanced carga los tags con el estado de consentimiento por defecto y, mientras el consentimiento está denegado, envía señales de medición sin cookies que pueden aprovecharse para un modeling más específico.
Lo importante aquí es no tratar como lo mismo los modeled data y los observed data. Según la configuración y los requisitos, a los informes se les puede aplicar behavioral o key event modeling, así que no hay que asumir que el número en pantalla es siempre la simple suma de eventos observados directamente.
El diseño de la observación debe incluir estas preguntas.
- ¿Estos datos son realmente necesarios para la decisión?
- ¿Se puede responder a nivel agregado sin identificar a las personas?
- ¿Qué deja de recopilarse cuando el usuario lo rechaza?
- ¿Podemos operar el borrado y los periodos de retención?
- ¿Los valores por defecto del SDK coinciden con la política de nuestro servicio?
Recopilar menos datos puede reducir las oportunidades de análisis. Al mismo tiempo, reduce el ruido innecesario y el riesgo. Una buena observación se parece más a la recopilación mínima adecuada al propósito que a la recopilación máxima.
La definición de fracaso y de éxito
Qué recopilar como mínimo depende, al final, de cómo define el servicio el éxito y el fracaso. Las herramientas calculan error count, latency, sessions, conversion y CTR, pero no deciden qué valor es el fracaso del servicio y cuál es su éxito.
Devolver un HTTP 200 puede ser un fracaso si los datos centrales están vacíos. Al revés, aunque una API externa falle, si se mostró rápido un fallback y el usuario logró su objetivo, el servicio puede haber tenido éxito. Aunque la position de búsqueda caiga, si aumentaron los clics de los usuarios que quieres, el resultado de producto puede haber mejorado.
Para este juicio hacen falta frases explícitas entre las métricas técnicas y los resultados de usuario. Las frases que yo fijé de verdad para este blog son estas.
- El usuario debe poder encontrar en los resultados de búsqueda el artículo que esperaba.
- El contenido principal del artículo debe mostrarse dentro del tiempo fijado en el p75 de mobile.
- Aunque fallen las estadísticas accesorias, la lectura del cuerpo no debe retrasarse.
- Si un trabajo de recogida programado no se ejecuta, se considera un fracaso operativo.
Cuando existen estas frases, las metrics, alerts y eventos necesarios vienen detrás. Al revés, si empiezas encendiendo los dashboards por defecto de la herramienta, es fácil confundir lo medible con lo importante.
El papel del ingeniero que convierte la observación en juicio no es convertirse en quien más sabe de los datos. Es convertirse en quien traduce las expectativas del usuario a condiciones que el sistema puede verificar.
¿Sobre qué hay que poner las alertas?
Cuando la definición de fracaso existe en frases, la siguiente pregunta llega enseguida. ¿Dónde poner las alertas?
El documento de filosofía de alertas que Rob Ewaschuk escribió en los inicios del SRE de Google deja claro que una alerta que llama a una persona debe ser urgente, importante, accionable y real. Y recomienda poner las alertas sobre los síntomas, no sobre las causas: sobre señales visibles hacia fuera, como respuestas 500 o errores visibles para el usuario.
Sin embargo, entre este principio y lo que yo viví hay una tensión sutil. Como tratamos en el artículo de observación del sistema, el fracaso de este blog no fue un 500 sino una respuesta 200 con estadísticas vacías. La alerta basada en síntomas se apoya en la premisa de que el fracaso sale a la superficie, y un fracaso clasificado como éxito rompe exactamente esa premisa.
Por eso no creo que haya que rebatir este principio. Más bien llegué a la conclusión de que definir qué cuenta como síntoma es la parte de verdad difícil de este trabajo. En este blog el síntoma no fue un código de estado sino "la función de consulta de estadísticas devolvió su valor por defecto", y eso solo pudo convertirse en síntoma plantando instrumentación a mano. Aquí está la razón de que en la sección anterior propusiera fijar primero en frases el fracaso y el éxito. Solo con esas frases queda decidido sobre qué síntomas poner alertas.
El consejo que añade el mismo documento también merece grabarse. Inclínate por borrar las alertas ruidosas. Porque el exceso de monitorización es un problema más difícil de resolver que la falta de monitorización. Como referencia, el libro de SRE de Google incluye el propio fallo de la monitorización en su lista de disparadores para escribir un postmortem. Que el mecanismo que recoge los datos de observación se detenga en silencio también es un fracaso. En este blog, que la recogida semanal de Search Console no se ejecute alguna semana entra en esa lista.
La traducción entre datos
Con las alertas ya puestas, lo que queda es trasladar las expectativas del usuario a los distintos query languages y esquemas del RUM del navegador, Sentry, GA4 y Search Console. En este punto, el papel que puede asumir la AI no es tanto generar conclusiones como traducir una pregunta a una forma verificable en cada fuente de datos.
Por ejemplo, es posible un flujo como este.
- Convertir una pregunta en lenguaje natural en las API queries y el SQL de cada sistema.
- Crear transformaciones que alineen zonas horarias y dimensiones distintas.
- Buscar los segments cuya distribución cambia y los contraejemplos inesperados.
- Reunir juntas las releases relacionadas, los code paths y la documentación oficial.
- Proponer las siguientes hipótesis a comprobar y candidatos de instrumentación adicional.
Aquí está también la razón de que importen las semantic conventions de OpenTelemetry. Si cada servicio envía el mismo significado con nombres de atributo distintos, hasta la AI tiene que adivinar primero el esquema. Si se respetan nombres, unidades y stability comunes, a las herramientas y a las personas les resulta más fácil conectar las señales.
Aunque la AI ayude con el análisis, los pasos de verificación no disminuyen.
- Comprobar que el SQL generado maneja correctamente los eventos duplicados y las zonas horarias.
- Comprobar si la API devuelve todas las rows o solo las top rows.
- Comprobar que no se confunden medias con percentiles ni número de usuarios con número de eventos.
- Distinguir los modeled data de los datos observados directamente.
- No poner explicaciones excesivas a variaciones casuales de muestras pequeñas.
En resumen, la ventaja de la AI está en convertir preguntas en queries ejecutables y en ampliar los ejes de comparación. La responsabilidad de comprobar de qué muestra y con qué reglas de agregación salió el resultado sigue intacta.
El feedback loop como capacidad de producto
Cuando baja el coste de convertir preguntas en queries, también puede acortarse el tiempo entre la observación y el siguiente cambio. Lo importante entonces es no subir solo la velocidad de generación.
El informe DORA 2025 publicado por Google Cloud, basado en una encuesta a unos 5.000 profesionales técnicos de todo el mundo, resume que la adopción de AI mostró una relación positiva con el software delivery throughput y el product performance, y una relación negativa con la delivery stability. DORA explica el mecanismo en un artículo aparte de insights así. El tiempo ahorrado en la etapa de generación se reasigna a la sobrecarga de verificación, y la propia velocidad a la que se produce código que hay que revisar aumenta. Como dice el resumen del informe, la AI amplifica lo que ya existe más que arreglar al equipo. (El informe ROI of AI-assisted Software Development de DORA, actualizado en abril de 2026, también aborda de frente el problema de gestionar la caída de productividad al inicio de la adopción.)
La evidencia que yo me tomo más en serio es otra. Un estudio que METR publicó en 2025 asignó al azar, sobre 246 issues reales de 16 desarrolladores de código abierto experimentados, si se permitía o no el uso de AI, y en los issues donde la AI estaba permitida, completarlos llevó un 19% más de tiempo. Sin embargo, los desarrolladores esperaban de antemano ser un 24% más rápidos, e incluso después de experimentar la ralentización real, creían haber sido un 20% más rápidos. Cité este estudio en Ingeniero frontend de AI como parte de una discusión sobre productividad, pero en el contexto de este artículo se lee distinto. Es evidencia de que la sensación no puede sustituir a la medición. Si no se puede confiar en la sensación, hay que medir, y como muestra el caso anterior del artículo de Biome, incluso un valor ya medido hay que volver a medirlo cambiando el periodo.
Si la generación se acelera, la cantidad de cambio aumenta. Aunque los defectos aparezcan en la misma proporción, el número absoluto crece, y el código a revisar y el impacto en los usuarios se acumulan rápido. Si en ese momento la observación es lenta, el equipo solo sube su velocidad de despliegue, no su velocidad de aprendizaje.
Un feedback loop rápido es la capacidad de encadenar en corto los pasos siguientes.
- Desplegar un cambio.
- Observar lo que les ocurrió al sistema y a los usuarios.
- Encontrar la diferencia entre lo esperado y lo real.
- Acotar las hipótesis de causa.
- Verificar con el siguiente cambio.
La AI puede ayudar mucho en la exploración de los pasos 3 y 4. Pero no puede empezar si faltan las señales necesarias en el paso 2 o si no están conectadas con la información de release del paso 1.
Por eso, la base de una organización que usa bien la AI necesita no solo tests, sino también sistemas observables y métricas de resultado centradas en el usuario. La calidad del feedback loop, más que la capacidad de generación, se convierte en el cuello de botella.
Convertir la observación en juicio
Plegando los tres artículos de esta serie en una frase cada uno, queda así. La observación del navegador muestra qué percibió el usuario, la observación del sistema muestra en qué parte del sistema se produjo esa experiencia, y GA4 y Search Console muestran qué hizo el usuario dentro del servicio y con qué intención llegó. Estas señales no son el registro completo de una persona, sino evidencias que iluminan la misma hipótesis desde muestras distintas.
Por tanto, el criterio para conectarlas no es la cantidad de datos ni la precisión de los identificadores personales. Hay que elegir la unidad de observación que encaja con la hipótesis, registrar los denominadores y las omisiones, y volver a verificar las correlaciones con correcciones o experimentos. Los usuarios invisibles por la privacidad y el consentimiento también deben incluirse entre los límites del análisis. Y la conclusión obtenida de una comparación debe comprobarse de nuevo cambiando el periodo. Igual que las cifras de mi artículo de Biome contaron dos historias distintas en dos meses, la observación no es una consulta única, sino un medir continuo.
El propio objeto de la observación también se está ampliando. OpenTelemetry está organizando las semantic conventions para la AI generativa y las llamadas MCP en un repositorio aparte. Cuanta más ejecución confiemos a la AI, más se convierte esa ejecución en objeto de observación bajo los mismos principios.
La AI baja el coste de empezar esta verificación, pero no fija los criterios de éxito y fracaso. Decidir primero en frases qué experiencia proteger, recopilar las señales necesarias y confirmar los resultados con el siguiente cambio sigue siendo tarea del ingeniero. Cuando este ciclo es corto y preciso, la observación se convierte en una capacidad de producto y no en un dashboard. A los lectores de este artículo también les propongo elegir una métrica de su propio servicio, escribir en una frase qué van a considerar resultado, y volver a consultar con otro periodo una conclusión ya tomada. En mi experiencia, la segunda consulta enseña más que la primera.