Calibración y exceso de confianza en los LLM
En este artículo quiero hablar de la calibración de los modelos y del exceso de confianza que aparece después de RLHF. Está pensado para desarrolladores que quieren usar en su código, como criterio de decisión, la probabilidad o la confianza que devuelve un modelo. Al terminar podrás explicar en qué se diferencian la exactitud y la calibración, qué mide el ECE, cómo las probabilidades de un modelo pulido con preferencias humanas se separan de su tasa real de acierto y hasta dónde se conoce la causa.
Tuve que ordenar primero estos conceptos mientras ponía a prueba las afirmaciones de Jev, un modelo de decisión presentado por TypeSafe AI. En lugar de frases, Jev devuelve una probabilidad para cada opción y presenta la calibración como su objetivo de entrenamiento. Para examinar esa afirmación, primero necesitaba saber qué es la calibración y por qué se desajusta en los modelos existentes.
Exactitud y calibración
Primero hay que separar exactitud y calibración. La exactitud es qué porcentaje aciertas; la calibración es si sabes qué porcentaje vas a acertar. Si reúnes solo los días en los que se anunció un 70% de probabilidad de lluvia y resulta que de cada diez llovió siete veces, esa previsión está bien calibrada. No significa que su exactitud sea alta. Significa que conoce sus propios límites. Un modelo que solo acierta el 60% saca la nota máxima en calibración si dice de sí mismo que acierta el 60%.
La escala puede desviarse en dos direcciones. Si la probabilidad que declara el modelo es mayor que su tasa real de acierto, se llama overconfidence; si es menor, underconfidence. Si pones la probabilidad declarada en el eje horizontal y la tasa real de acierto de cada tramo de probabilidad en el eje vertical, se ve de un vistazo dónde se separan las dos. Un gráfico dibujado así se llama reliability diagram.
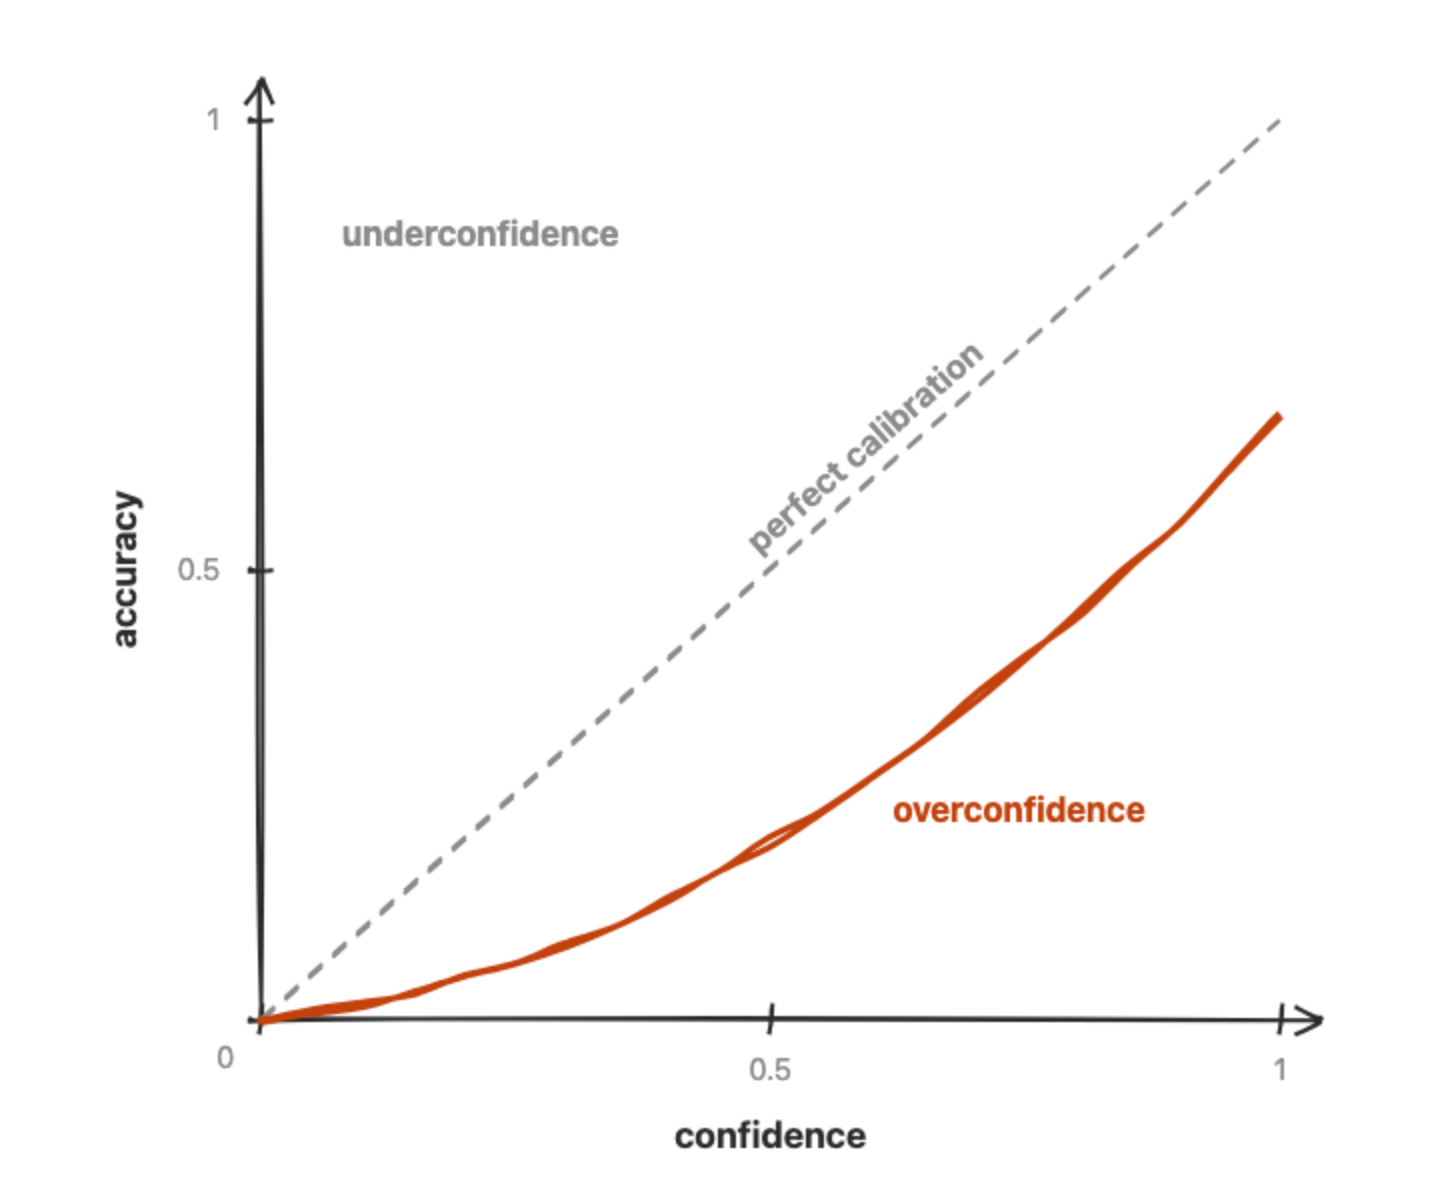
Si la curva cae sobre la diagonal, el modelo acertó tanto como dijo. Cuanto más cae por debajo de la diagonal, menos acierta en relación con la probabilidad que declara.
La métrica que mide ese desajuste es el ECE (expected calibration error). Según la definición de Guo et al. 2017, es la media, ponderada por la proporción de muestras de cada tramo, de la diferencia entre «la probabilidad declarada» y «la tasa real de acierto» en cada tramo de probabilidad, y 0 es la perfección. El código de abajo transcribe esa fórmula. Compara un modelo que acierta 6 de 10 preguntas cuando dice 0.6 cada vez y cuando dice 0.95 cada vez.
// Guo et al. 2017 의 식 (3). 구간은 등간격 10개(논문 실험은 15개), 경계는 왼쪽 닫힘
function ece(preds, M = 10) {
  const bins = Array.from({ length: M }, () => ({ n: 0, hit: 0, conf: 0 }))
  for (const { p, correct } of preds) {
    const b = bins[Math.min(M - 1, Math.floor(p * M))]
    b.n++
    b.hit += correct ? 1 : 0
    b.conf += p
  }
  return bins.reduce(
    (sum, b) => (b.n ? sum + (b.n / preds.length) * Math.abs(b.hit / b.n - b.conf / b.n) : sum),
    0,
  )
}

// 10문제 중 6문제를 맞힌다
const answers = Array.from({ length: 10 }, (_, i) => ({ correct: i < 6 }))
console.log(ece(answers.map((a) => ({ ...a, p: 0.6 }))).toFixed(3)) // 매번 0.6 이라고 말할 때
console.log(ece(answers.map((a) => ({ ...a, p: 0.95 }))).toFixed(3)) // 매번 0.95 라고 말할 때
Este es el resultado de ejecutarlo con Node v24.16.0 el 2026-10-08.
0.000
0.350
La exactitud es 0.6 en ambos casos. Solo cambió la probabilidad declarada, y aun así el ECE sube de 0 a 0.35. Pero como la fórmula toma un valor absoluto, el ECE mide solo el tamaño del desajuste, no su dirección. Un modelo que dice 0.25 cada vez y acierta igualmente 6 preguntas también obtiene un ECE de exactamente 0.35. Para saber si es overconfidence o underconfidence hay que mirar el reliability diagram o la confianza media menos la exactitud.
La función objetivo de RLHF
Entonces, ¿por qué se desajusta esta escala en un modelo pulido con retroalimentación humana? Primero hay que ver qué optimiza RLHF (reinforcement learning from human feedback). El esqueleto de construir un modelo de recompensa a partir de comparaciones de preferencias humanas salió de Christiano et al. 2017; uno de los primeros trabajos que lo llevó a modelos de lenguaje fue Ziegler et al. 2019, e InstructGPT lo aplicó al seguimiento de instrucciones. Lo que se empuja hacia arriba es la puntuación de un modelo de recompensa que imita la preferencia humana. Los trabajos con modelos de lenguaje suman a la recompensa una KL penalty que impide que el modelo se aleje demasiado del que había antes de empezar el aprendizaje por refuerzo, e InstructGPT además mezcló gradientes de los datos de preentrenamiento (PPO-ptx), pero lo que empuja hacia arriba sigue siendo esa puntuación.
Para un chatbot, la preferencia humana es el objetivo correcto. El problema es que esa preferencia se inclina a evitar el tono que revela incertidumbre. Zhou et al. 2024 mostraron, en cuatro conjuntos públicos de datos de preferencia, que los anotadores eligen menos las respuestas con atenuadores como "I'm not sure, maybe". La diferencia era pequeña pero significativa. Eso sí, no eligieron más las respuestas con expresiones que refuerzan la certeza. Leng et al. 2025 mostraron que los modelos de recompensa dan más puntuación a las respuestas que declaran una cifra de confianza alta, sin importar su calidad real. Ambos resultados se refieren a expresiones de confianza dentro del texto (verbalized confidence), no a probabilidades de tokens. TypeSafe, que propone un método de entrenamiento para sustituir a RLHF, también señala en su propia guía introductoria que RLHF puede premiar alucinaciones que suenan seguras (confident-sounding hallucinations). Es la postura de quien vende la alternativa.
Las curvas de calibración de GPT-4
En las probabilidades de los tokens también se ha observado un desajuste en la misma dirección. La Figure 8 del cuerpo del informe técnico de GPT-4 coloca lado a lado los reliability diagrams del modelo preentrenado y del modelo post-training, y su leyenda dice así:
Right: Calibration plot of the post-trained GPT-4 model on the same subset of MMLU. The post-training hurts calibration significantly.
El eje horizontal es la probabilidad (logprob) que el modelo asignó a cada una de las opciones A, B, C y D en preguntas de opción múltiple de MMLU, y el eje vertical es la tasa real de acierto en ese tramo. Según las cifras impresas en la Figure 8, el ECE del modelo preentrenado es 0.007 y el del modelo que pasó por PPO (el algoritmo de aprendizaje por refuerzo que se usa en RLHF para actualizar el modelo hacia puntuaciones más altas del modelo de recompensa) es 0.074. Empeoró más de diez veces.
En el panel derecho (PPO) de la Figure 8, las barras de 0.4 en adelante quedan por debajo de la diagonal, pero los tramos entre 0.1 y 0.3 quedan, al contrario, por encima. Las barras entre 0.1 y 0.9 se amontonan planas en una tasa real de acierto de aproximadamente 0.3 a 0.5, así que aunque suba la probabilidad que declara el modelo, la tasa de acierto apenas la sigue. En el 0.074 también se mezclan esos tramos de underconfidence. Y, como señalan Guo et al., un reliability diagram no muestra cuántas muestras caen en cada tramo, de modo que no se puede suponer que la distancia de una barra a la diagonal sea proporcional a lo que ese tramo aporta al ECE.
Este panel se diferencia del diagrama conceptual de arriba en dos cosas. Primero, no se limita a caer por debajo de la diagonal como la curva del diagrama conceptual, sino que la cruza una vez. Segundo, mete en los tramos las probabilidades de las cuatro opciones, así que también se aparta de la definición del código de arriba, que mide la probabilidad de la única respuesta elegida. Por eso no comparo el 0.074 con el 0.35 del código de arriba en la misma escala.
Entonces, ¿por qué empeoró? El cuerpo del informe solo dice que el modelo preentrenado estaba bien calibrado y que la calibración se redujo tras el post-training; no da una causa. Una pista está en Kadavath et al. 2022, de Anthropic. Las políticas RLHF que entrenaron a partir de sus propios modelos de lenguaje parecían, a simple vista, muy mal calibradas. El artículo dijo que no era sorprendente, porque el RL fine-tuning tiende a concentrar las predicciones en los comportamientos que reciben más recompensa. Fue un experimento breve añadido al margen, no el tema central. Sin embargo, al aplicar una sola temperatura, T=2.5, a todas las evaluaciones, los problemas de calibración quedaron en gran parte resueltos en tres evaluaciones. La temperatura es un valor que divide los logits; si es mayor que 1, deja intacto el orden de las respuestas y solo aplana la distribución de probabilidad. Yo leo el hecho de que un solo valor lo resolviera en gran parte como señal de que el desajuste no estaba concentrado en unos pocos tramos, sino que era toda la distribución estrechada hacia un lado. El artículo añadió además la salvedad de que un entrenamiento RL más intenso podría distorsionar la calibración de maneras que no se arreglan así.
Este es un resultado sobre modelos de Anthropic, así que no se puede trasladar directamente como causa de la Figure 8. Los estudios de la sección anterior también trataban expresiones de confianza dentro del texto. No encontré una fuente primaria que conecte directamente el resultado de que las personas evitan el tono inseguro con el desajuste en las probabilidades de los tokens.
La probabilidad que recibe tu código
La probabilidad de la Figure 8 es la probabilidad logarítmica de un token. Para recibir un valor del mismo tipo, según la especificación de la API de OpenAI, pones logprobs en true en una petición de Chat Completions y con top_logprobs eliges, entre 0 y 20, cuántos candidatos recibir en cada posición de token. El valor que obtienes pidiendo al modelo que diga un número de confianza junto con su respuesta es confianza expresada con palabras, y es un valor distinto de la probabilidad del token.
Los estudios sobre estos dos valores comparan pares distintos. Tian et al. 2023 informaron de que, dentro de modelos RLHF como ChatGPT, GPT-4 y Claude, la confianza expresada con palabras solía estar mejor calibrada que las probabilidades condicionales, y que en tres benchmarks a menudo reducía el ECE en torno a un 50% relativo. Eso sí, en esta comparación la probabilidad condicional de los modelos cuyos pesos no son públicos no era la probabilidad de tokens de la API, sino una estimación: la proporción de veces que salió la respuesta al muestrear 10 veces la misma pregunta. Leng et al., que vimos antes, informaron de que, frente a los modelos anteriores a RLHF, los modelos RLHF muestran más overconfidence en la confianza que expresan con palabras. Ambos resultados pueden ser ciertos a la vez. Y 0.074 es el valor que obtuvo el modelo post-training de GPT-4 de 2023 en un subconjunto de MMLU, así que no se puede trasladar tal cual a los modelos que llamas hoy por la API.
Para cerrar
En resumen, la calibración no trata de qué porcentaje aciertas, sino de si sabes qué porcentaje vas a acertar, y el ECE es la cifra que mide el tamaño de ese desajuste. Para ver la dirección hay que mirar el reliability diagram o la confianza media menos la exactitud. RLHF empuja hacia arriba la puntuación de un modelo de recompensa que imita la preferencia humana. Kadavath et al. consideran que esa optimización tiende a estrechar las predicciones hacia lo que más recompensa recibe. Hay estudios que muestran que las personas eligen menos las respuestas que revelan incertidumbre y que los modelos de recompensa dan más puntuación a las respuestas que declaran una cifra de confianza alta, sin importar la calidad. En GPT-4, el ECE quedó registrado pasando de 0.007 a 0.074 tras el post-training, pero OpenAI no llegó a escribir la causa. Como la calibración también sale distinta según si la probabilidad que recibe tu código es una probabilidad de tokens o una confianza expresada con palabras, sea cual sea, tienes que volver a medirla con tus propios datos.
Si las probabilidades de Jev, un modelo de decisión que presenta la calibración como objetivo de entrenamiento, son de verdad honestas se trata en Modelos de decisión, Jev y Kev.
Ojalá que tú también, antes de fijar en el código como umbral la probabilidad que devuelve un modelo, compruebes al menos una vez para qué se entrenó ese modelo y si su escala se sostiene con tus propios datos.