Modelos de decisión, Jev y Kev
En este artículo quiero hablar de un modelo que no genera texto. La semana pasada TypeSafe AI presentó Jev.
El primer uso que me llamó la atención fue la automatización del navegador. Browserbase abrió un PR que conecta Jev al act() de Stagehand. La estructura era enviar el árbol de accesibilidad de la página como state y preguntar, con opciones cerradas, «cuál es el siguiente elemento que hay que pulsar». En 40 tareas, la mediana de act() bajó de 1,97 segundos a 0,46, y de 147 acciones solo 4 volvieron a un LLM. El punto donde un script de Playwright se rompe en cuanto cambia un selector quedó cubierto por una llamada que devuelve una sola probabilidad. Mientras escribo esto, el PR todavía no se ha fusionado.
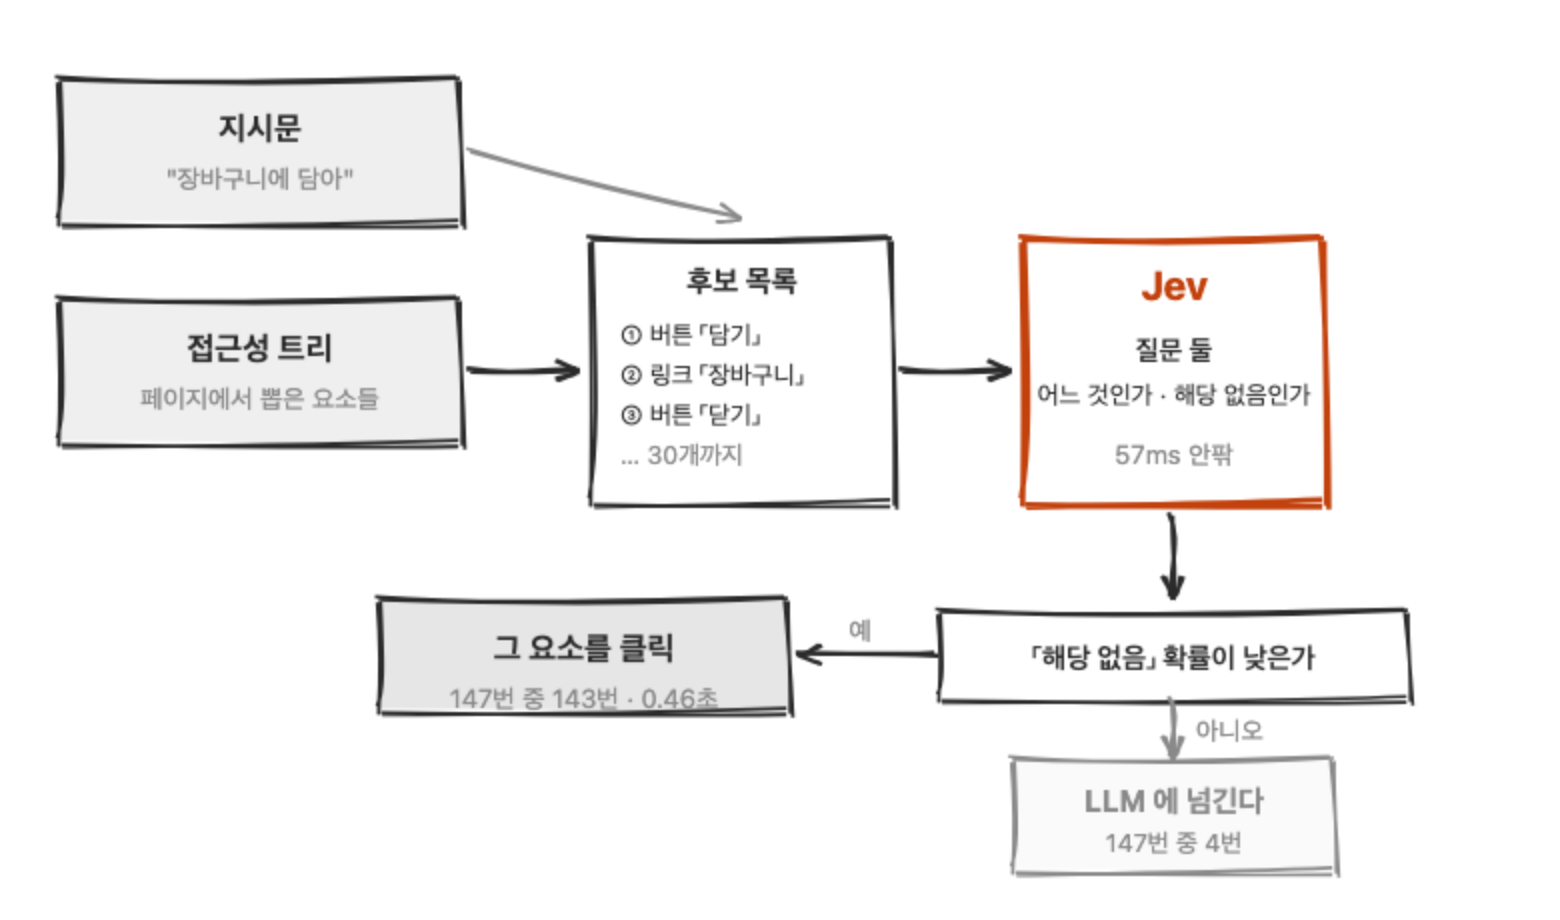
La línea que trazó ese PR es la pregunta de este artículo. Acepta la respuesta de Jev a partir de una probabilidad de 0,7 y, si no la alcanza, se la pasa a un LLM. ¿Puedo fiarme de la probabilidad que devuelve ese modelo y trazar con ella una línea en el código?
Con el benchmark de otros no basta para decidirlo, así que quiero verificarlo con mis propios datos. Este blog tiene una compuerta que bloquea los extranjerismos transcritos al hangul. La regla dice que 피커 debe escribirse picker, pero la expresión regular solo atrapa la mitad segura, y las palabras que viven dentro de un compuesto o ya están asentadas en coreano, como 멀티스레드 o 콜 스택, las decido yo a mano cada vez. Solo hay dos respuestas, revertir o dejar, quien sabe decide en un segundo, y el aprobado o el rechazo tiene que decidirse dentro de un script de build sin que nadie lo revise. Tiene la misma forma que la decisión de selector de Stagehand.
Así que el orden es este: qué devuelve Jev, de qué entrenamiento sale esa probabilidad, qué números aparecen cuando le paso mi compuerta y dónde se pueden usar esos números.
Un modelo que no genera texto
La fecha de publicación es el 15 de septiembre de 2026. La empresa no lo llama LLM; lo sitúa en una categoría nueva: System One Model. En este artículo los llamo modelos de decisión. Su fundador, Diogo Almeida, participó en OpenAI como cuarto autor del artículo de InstructGPT. Estuvo en el equipo que creó el método del que ChatGPT desciende en línea directa, y ahora está en el lado que señala los límites de ese método.
Jev no genera frases. Le das de antemano la forma de la respuesta, elige dentro de ella y devuelve además una probabilidad. Solo hay tres tipos de pregunta.
| Tipo | Qué pregunta | Qué devuelve |
|---|---|---|
choice |
Cuál de estas opciones es | La elección, probabilities, confidence |
score |
Qué nivel tiene | La puntuación, legend, probabilities, confidence |
noul |
Si es cierto | Una única probabilidad entre 0 y 1 |
El endpoint también es uno solo. Envías a POST /v1/systemone un state (el contenido que se evalúa), un model y unas questions (el mapa de preguntas), y llega la respuesta. Puedes meter varias preguntas sobre el mismo state en una sola petición, y añadir preguntas apenas alarga el tiempo de respuesta.
Por qué es rápido se explica con la asimetría entre prefill y decode que recogí en cómo funcionan los tokens. Un LLM es lento porque exprime la salida token a token, de forma secuencial, y Jev no tiene esa etapa de decode. Lee la entrada una vez en paralelo y lee la probabilidad directamente. Por eso no hay tarifa alguna de tokens de salida y solo se cobra la entrada, a $0.042 por millón de tokens.
Hay un análisis de un desarrollador llamado Archer Hume que llamó unas 10,000 veces a la API y reconstruyó el comportamiento desde fuera. Con 360 tokens de entrada la mediana fue 57.5ms; con 29,835 tokens, 218ms; y con 1,500 preguntas metidas, 610ms. De todo ello, la evidencia más directa es la observación de que una respuesta con 200 opciones volvía a la misma velocidad que una de 2. Significa que escribir la respuesta no cuesta tiempo.
Decisiones que nadie mira
La velocidad y el precio llaman la atención, pero la pregunta que Almeida lanzó en su artículo de presentación iba por otro lado: si los modelos llevan años siendo sobrehumanos conversando, ¿adónde ha ido toda la automatización?
Su respuesta es que se trata de dos clases de trabajo distintas. Un chatbot, un copilot y un agente de programación tienen como objetivo satisfacer a la persona que mira desde al lado. Las decisiones que se ejecutan en silencio en un servidor y que nadie mira no tienen ese objetivo. Si llamamos assistant a lo primero y automation a lo segundo, todos los modelos publicados hasta hoy se hicieron para lo primero.
Ya hice una distinción parecida al ordenar el diseño de harness. Dentro de un sistema de agentes hay incontables decisiones que nadie mira. ¿Paso esta petición a una persona? ¿Puedo ejecutar este comando? Ahora mismo se las preguntamos todas a un LLM caro. La otra mitad que mi compuerta de expresiones regulares no cubre también es una decisión de ese tipo.
El hueco que dejó RLHF
Pero ¿por qué hacía falta un método de entrenamiento nuevo? ¿No basta con pedirle solo sí/no a un modelo de los de siempre?
La respuesta está en la genealogía de RLHF (reinforcement learning from human feedback). El esqueleto de levantar un modelo de recompensa a partir de comparaciones de preferencia humana salió del artículo de Christiano et al. de 2017; Stiennon et al. lo aplicaron en 2020 a los modelos de lenguaje, e InstructGPT lo extendió al seguimiento de instrucciones. Los tres artículos comparten una única función objetivo: producir la salida que el evaluador humano prefiere más.
Aquí hay que separar exactitud y calibración. La exactitud es qué porcentaje aciertas; la calibración es si sabes qué porcentaje vas a acertar. Si reúnes solo los días en los que se anunció un 70% de probabilidad de lluvia y resulta que de cada diez llovió siete veces, esa previsión está bien calibrada. No significa que su exactitud sea alta. Significa que conoce sus propios límites. Un modelo que solo acierta el 60% saca la nota máxima en calibración si dice de sí mismo que acierta el 60%.
La métrica que mide ese desajuste es el ECE (expected calibration error). Es la media, ponderada por la proporción de muestras de cada tramo, de la diferencia entre «la probabilidad declarada» y «la tasa real de acierto» en cada tramo de probabilidad, y 0 es la perfección.
Para un chatbot, la preferencia humana es el objetivo correcto. El problema es que las personas prefieren una respuesta segura antes que una que titubea. Así el modelo adquiere la costumbre de hablar de forma tajante incluso cuando la cosa es ambigua. La documentación de TypeSafe llama a esto mode dropping: optimizar la preferencia empuja al modelo a favorecer un estilo concreto y aplasta la probabilidad de las demás salidas posibles.
OpenAI también dejó escrito lo mismo en su propio informe. La Figure 8 del informe técnico de GPT-4 pone una al lado de otra las curvas de calibración del modelo preentrenado y del modelo tras el post-training, y su pie dice así.
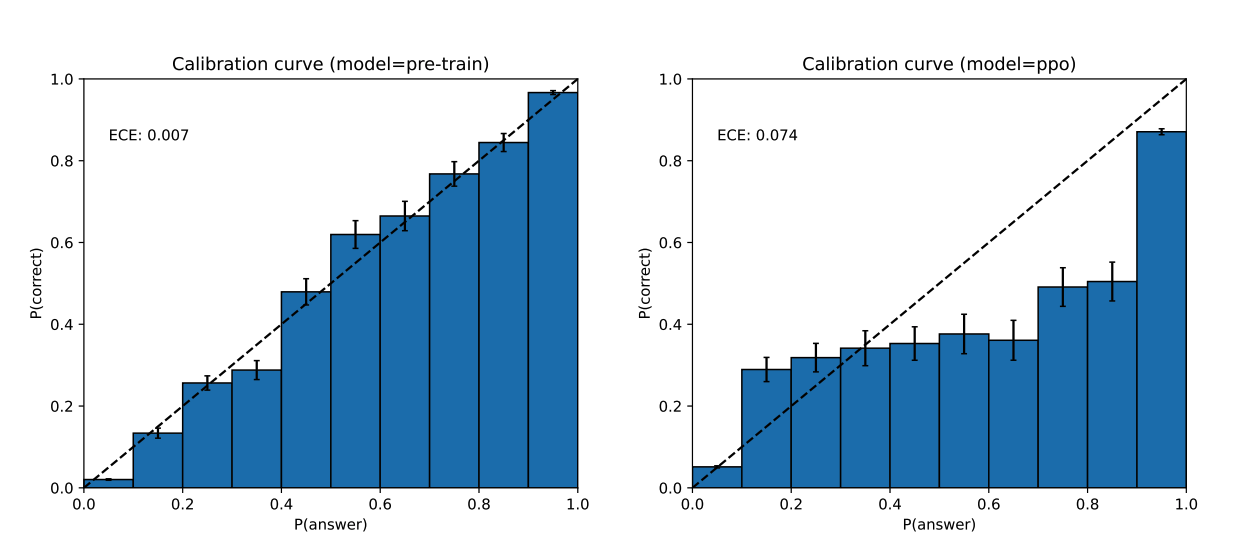
Fuente: OpenAI, GPT-4 Technical Report (arXiv:2303.08774), Figure 8.
Right: Calibration plot of the post-trained GPT-4 model on the same subset of MMLU. The post-training hurts calibration significantly.
Según las cifras impresas en la figura, el ECE del modelo preentrenado es 0.007 y el del modelo que pasó por PPO es 0.074. Empeoró más de diez veces. En el proceso de pulirlo para que satisficiera a las personas se recortó su capacidad de saber qué porcentaje iba a acertar.
Aun así, el ECE por sí solo no basta. Un predictor constante que estampa 0.6 en todas las entradas también tiene ECE 0 si su tasa real de acierto es del 60%. Si la probabilidad solo es honesta pero no se separa caso por caso, no hay sitio donde trazar la línea. Por eso, al margen de la calibración, hay que mirar también si la probabilidad de verdad se separa, y «la proporción que se puede automatizar dentro de un presupuesto de error», que usaré más adelante, es la métrica que reúne esas dos cosas en una sola cifra.
Desde el punto de vista del software, lo que importa es esta parte. Si la probabilidad es honesta y se separa, se puede trazar la línea. Sale una estructura en la que por encima de 0.95 se procesa automáticamente y por debajo se pasa a una persona.
TypeSafe dice haber abierto un tercer camino apuntando a ese lugar: RLHF, que optimiza la preferencia humana; RLVR (reinforcement learning with verifiable rewards), que optimiza respuestas correctas que una máquina puede puntuar; y RLCD, que según ellos optimiza decisiones calibradas.
Ahora bien, de RLCD lo único publicado son tres líneas de contrato de salida. A fecha de 23 de septiembre de 2026, cuando escribo este artículo, no hay artículo ni informe técnico en ninguna parte de la documentación ni del artículo de presentación de TypeSafe. Existe por separado un artículo de ICLR 2024 que usa la misma sigla, pero ahí significa reinforcement learning from contrastive distillation, un método distinto. Conviene no mezclarlos al buscar.
Qué es en realidad confidence
Entonces, ¿es honesto el número que devuelve Jev? Antes de responder hay que ver una cosa. El número que devuelve no es uno solo.
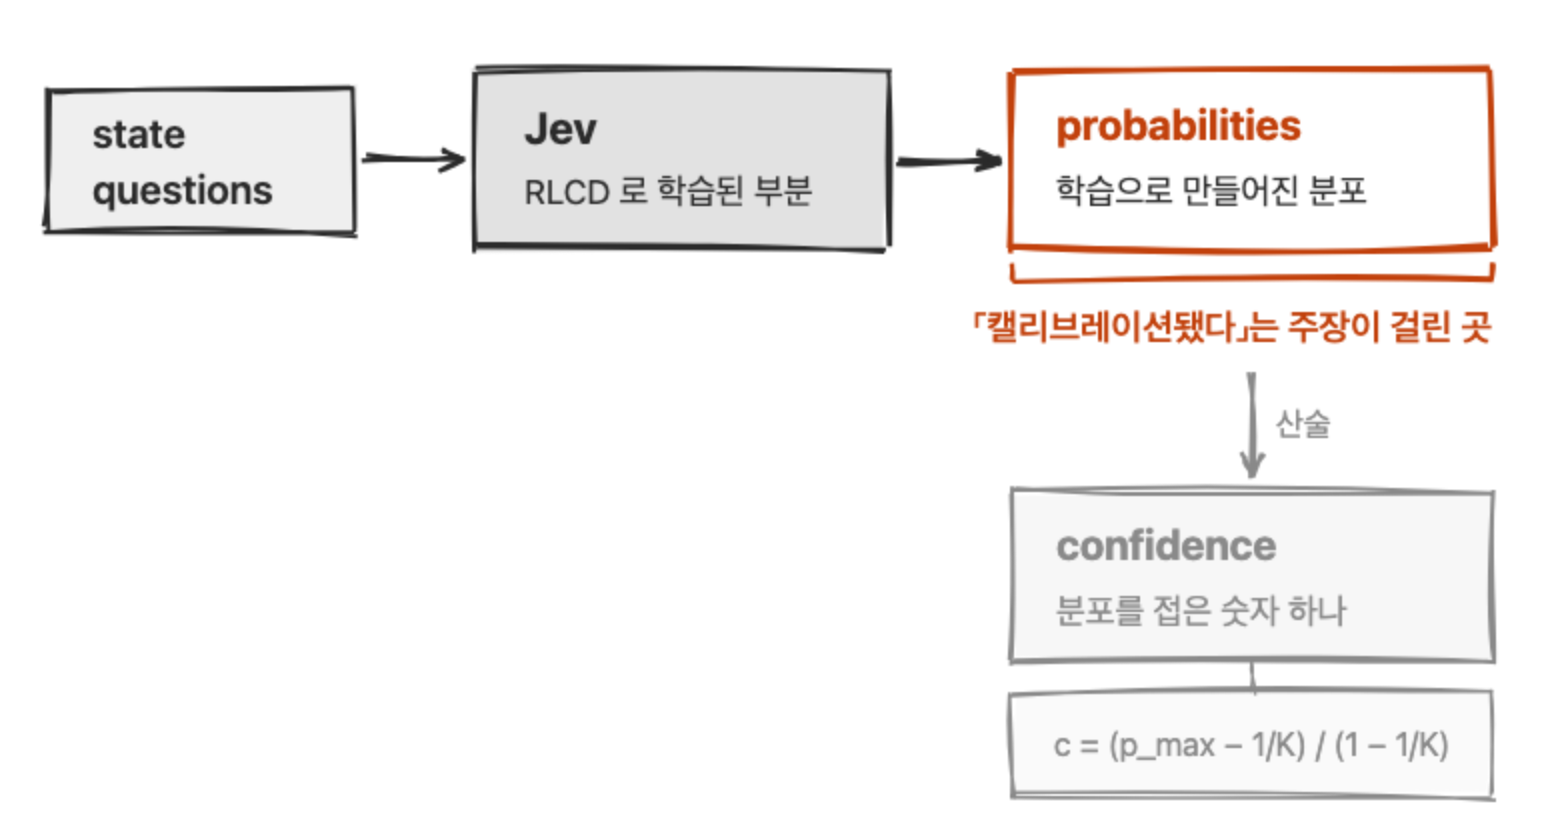
Las respuestas de Choice y Score traen juntos probabilities y confidence. Lo primero es una distribución de probabilidad sobre todas las opciones; lo segundo, un único número entre 0 y 1. Cuando pones un umbral en el código, la mano va primero hacia confidence.
Este valor no lo produce el modelo. El archivo _utils/confidence_metrics.py de system-one-adapter-python, publicado por la organización TypeSafe, tiene 32 líneas en total, y la parte de Choice es así.
def choice_confidence(probs: list[float]) -> float:
    """Scale peak choice probability from uniform to certainty."""
    if len(probs) == 1:
        return 1.0

    normalized_probs = _normalize(probs)
    uniform_probability = 1.0 / len(normalized_probs)
    return (max(normalized_probs) - uniform_probability) / (1.0 - uniform_probability)
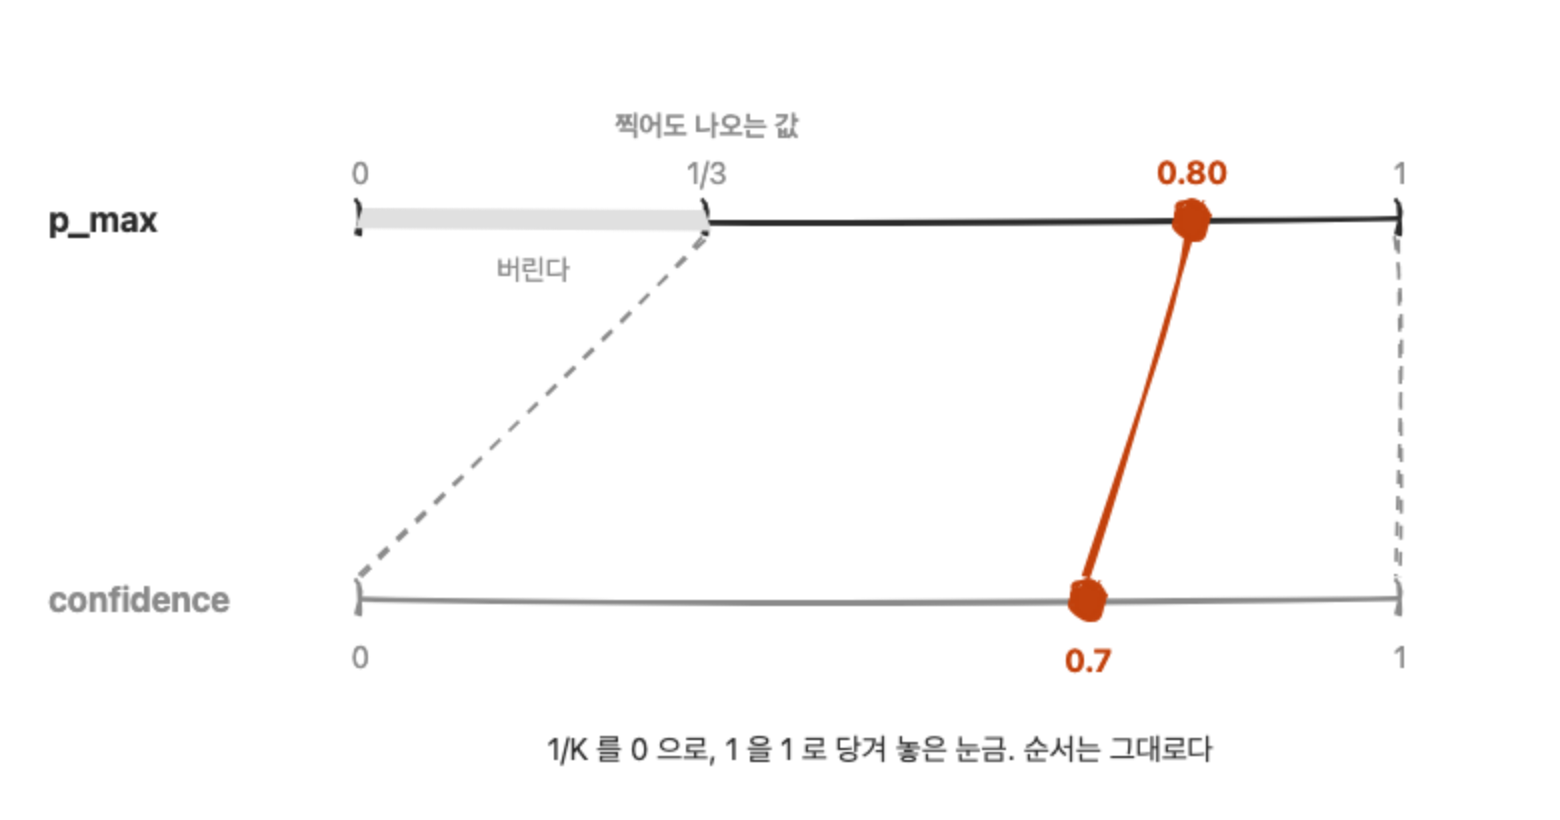
No hay llamada al modelo ni parámetros aprendidos. Entra un vector de probabilities y sale un número real. Escrito como fórmula es c = (p_max − 1/K) / (1 − 1/K), y si hay tres opciones y la probabilidad máxima es 0.8, da 0.7.
Este repositorio no es el servidor Jev de producción, sino una implementación alternativa que imita la misma API con un LLM. Así que esto por sí solo no permite afirmarlo con rotundidad. Pero hay dos pruebas más que apuntan a la misma fórmula. La página sobre confidence de la documentación oficial de TypeSafe describe este valor como "a statistic computed from the probability distribution" y en su código de demostración incluye (3 × largest probability − 1) / 2 como fórmula aproximada para tres opciones. Con K igual a 3 coincide con la fórmula de arriba. Y un registro de auditoría de afirmaciones dejó anotado que, en la API real, con una respuesta a la que se dieron solo dos opciones, ambas incorrectas, y cuya ganadora valía 0.52, el confidence llegó como 0.04. Con K igual a 2, (0.52 − 0.5) / (1 − 0.5) = 0.04. Coincide con la fórmula.
En el mismo repositorio, Score usa directamente otra fórmula: divide la distancia absoluta media respecto al nivel más frecuente entre la que daría una distribución uniforme y luego lo resta de 1. La documentación no publica la fórmula de Score. Es decir, bajo un mismo nombre, confidence, hay dos fórmulas, y si cambia el tipo el mismo número significa otra cosa. Que Noul no tenga confidence obedece a la misma razón: no hay distribución que plegar.
La documentación tampoco lo esconde. Incluso indica que, si quieres usar otro cálculo, te dará el probabilities completo para que lo hagas a tu manera. Está escrito; el problema está en usarlo sin leerlo.
Pero la tabla comparativa del artículo de presentación pega ambas cosas. Dice "Calibrated: higher confidence means higher accuracy". Quien lo lee entiende que confidence es el valor calibrado, cuando la afirmación de calibración recae en realidad sobre probabilities.
Cuánto se abre esta distinción en cifras es algo que ya se ha medido. Una medición independiente de la calibración publicada por un desarrollador llamado scienthoon midió por separado el ECE que sale al leer confidence como «probabilidad de acertar». En OpenBookQA es 0.035; en HellaSwag, 0.078; y en un conjunto sintético, 0.18. Las probabilidades originales de esos mismos conjuntos eran 0.024, 0.029 y 0.107, respectivamente. En los tres conjuntos, el lado de confidence sale peor.
El porqué del empeoramiento está en la fórmula. Con K fijo, c es una transformación monótona creciente de p_max, así que conserva el orden. El poder discriminativo se mantiene y basta con reescribir el umbral. Lo que se rompe no es la información, sino la escala. Si K cambia de una pregunta a otra, aparece un problema más: también cambia el factor de estiramiento. El mismo p_max de 0.8 se convierte en 0.6 con dos opciones y en 0.75 con cinco. En una carga de trabajo donde se mezclan números de opciones distintos, eso se vuelve un problema en cuanto usas un único umbral.
La calibración cambia según la distribución
Entonces, ¿se puede confiar en el lado de probabilities?
Hay publicado un registro de mediciones hechas llamando de verdad a Jev. En el repositorio de Kev, la implementación de reproducción de código abierto que hizo Jared Palmer, hay un directorio runs/jev-*, y usage.json deja constancia, con "model": "typesafe-ai/jev", de que se trata de llamadas reales pasadas por Vercel AI Gateway. Si se suman los seis directorios jev-* con su usage.json, entre el 18 y el 20 de septiembre de 2026 se hicieron 5,364 llamadas, con 2,418,260 tokens de entrada. De los siete conjuntos de abajo, scienthoon se importó convirtiendo los archivos de resultados de ese desarrollador, así que no está incluido en este total.
Que el precio cobre realmente solo la entrada se confirma en otro sitio. El autor del benchmark de phishing lo anotó mirando el dashboard de TypeSafe. De los 4.56 millones de tokens de dos ejecuciones, 3.66 millones fueron de entrada y 900,000 de salida, y el cargo fue de $0.15, una cifra que coincidía con calcular solo la entrada.
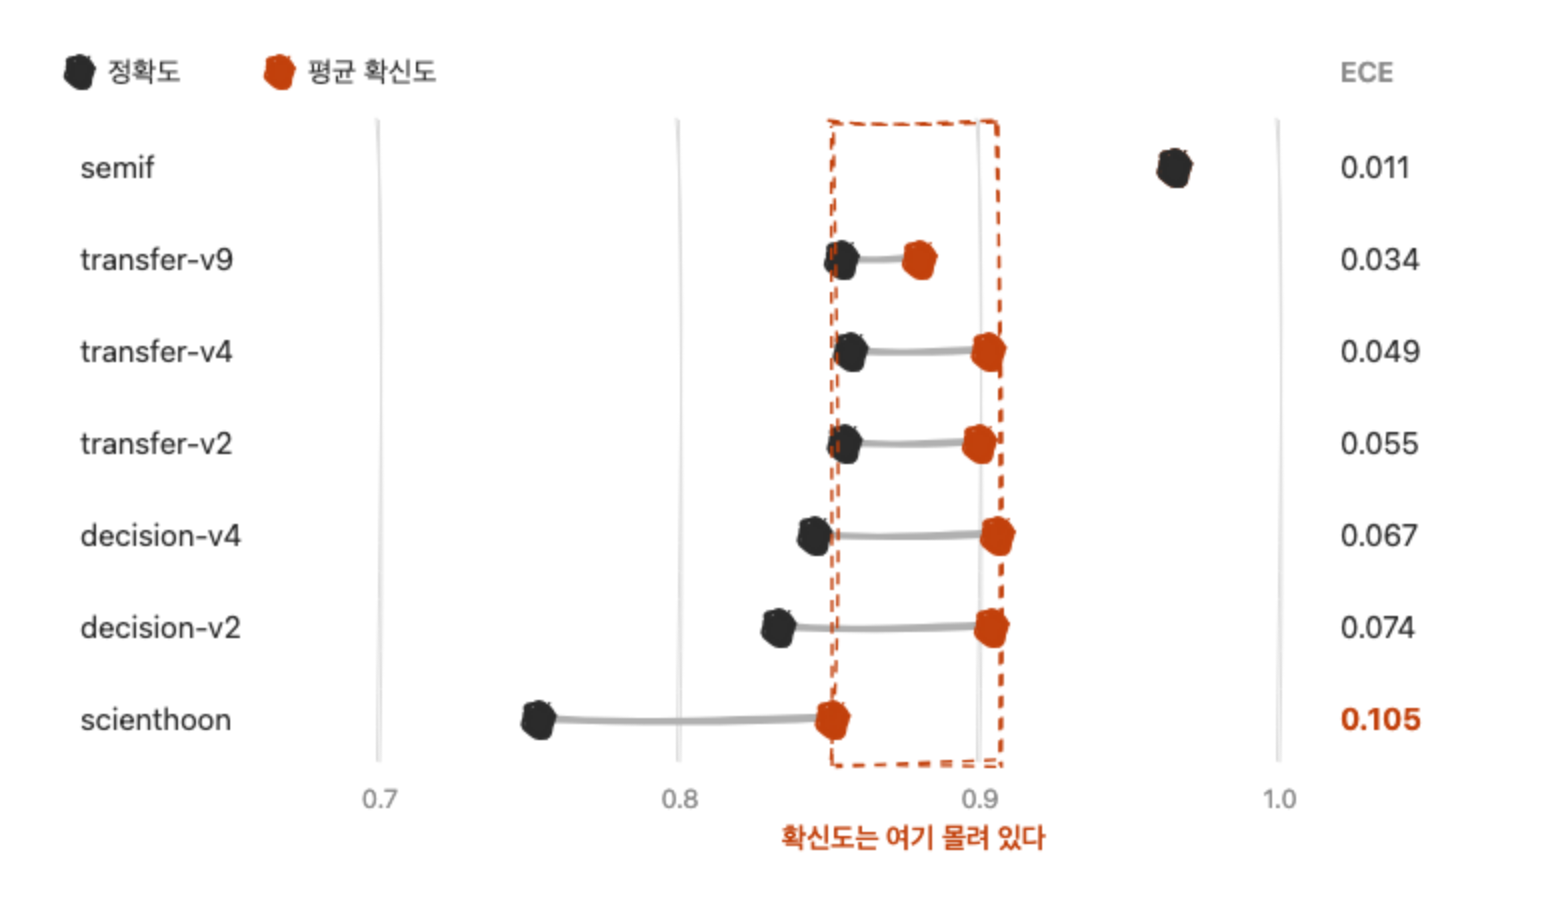
Si se sacan del report.json de ese mismo directorio las métricas de los siete conjuntos de evaluación y se ordenan, queda así. Abajo, la confianza no es el campo confidence, sino el máximo de probabilities. El exceso de confianza es 평균 확신도 − 정확도 (confianza media menos exactitud) y en total son 5,743 casos. Los valores son los del bloque clean, que excluye de la puntuación de exactitud las entradas «desconocido», aquellas cuya base de juicio se ha borrado.
| Conjunto de evaluación | n | Exactitud | Confianza media | Exceso de confianza | ECE |
|---|---|---|---|---|---|
| semif | 144 | 0.965 | 0.965 | -0.000 | 0.011 |
| transfer-v9 | 1,046 | 0.854 | 0.880 | +0.026 | 0.034 |
| transfer-v4 | 656 | 0.857 | 0.903 | +0.046 | 0.049 |
| transfer-v2 | 560 | 0.855 | 0.900 | +0.045 | 0.055 |
| decision-v4 | 1,264 | 0.845 | 0.906 | +0.061 | 0.067 |
| decision-v2 | 1,200 | 0.833 | 0.904 | +0.071 | 0.074 |
| scienthoon | 873 | 0.753 | 0.851 | +0.099 | 0.105 |
Se leen dos cosas.
Primera: el ECE se mueve casi diez veces. Va de 0.011 a 0.105. Mismo corrector, mismo modelo. «Está calibrado» no es una propiedad del modelo, sino una relación entre el modelo y la distribución. Que la calibración se venga abajo cuando cambia la distribución es un resultado ya conocido. Lo nuevo aquí es que la misma forma aparece también en un modelo que presenta la calibración como objetivo de entrenamiento.
El 0.105 del conjunto con mayor ECE es incluso mayor que el 0.074 del GPT-4 post-RLHF que vimos antes. Ahora bien, estos dos no deben leerse como un ranking. Las tareas son distintas, y el ECE es un estimador cuyo valor se mueve según en cuántos tramos se divida y en qué tramo se acumulen las muestras, de modo que enfrentar cifras salidas de correctores distintos no constituye una comparación válida.
Segunda: el ECE medido se explica casi por completo con el exceso de confianza. La diferencia entre ambas columnas está, en los siete casos, entre 0.002 y 0.011. Como el ECE es la media ponderada de las brechas por tramo, no puede ser menor que el exceso de confianza global; que esa diferencia sea casi 0 significa que el signo del desajuste de cada tramo se inclina en una sola dirección. No es ruido que se cruce y se cancele entre tramos.
Por qué ocurre se ve leyendo la tabla en vertical. Si quitamos semif, seis valores de confianza media se apelotonan entre 0.851 y 0.906. En ese mismo rango, la exactitud se mueve entre 0.753 y 0.857, el doble de ancho. La confianza apenas se mueve aunque cambie la distribución; solo se mueve la exactitud. La diferencia que queda es directamente el ECE.
Otro benchmark muestra cómo se manifiesta esta propiedad en la práctica. En una medición sobre 2,000 correos de phishing con Claude Haiku 4.5 como grupo de control, la exactitud de Jev fue del 62.6% y la de Haiku del 81.3%. Pero lo que más llama la atención es el ECE. El ECE que reporta el repositorio es 0.154 para Jev y 0.097 para Haiku, y si el registro de auditoría de afirmaciones vuelve a medir el valor P(phishing) de Jev en 10 tramos de 0 a 1, sale 0.170. Se lea como se lea, el modelo que presenta la calibración como objetivo de entrenamiento perdió en calibración frente a un LLM hecho con RLHF. El mismo autor sacó un 91.6% solo con una regla de lista de hosts de enlaces.
Si se mira la misma métrica en varios conjuntos, la amplitud queda más clara. La proporción que se puede automatizar con un presupuesto de error del 5% es 0.486 en el conjunto scienthoon, 0.695 en transfer-v9 y 1.000 en semif. El corrector de Kev anota que este valor es el máximo obtenido eligiendo el umbral dentro de la muestra, y no una garantía de error tras el despliegue. Ninguna de ellas debe citarse como si fuera una especificación del modelo.
La compuerta de transcripciones
Leer el benchmark de otro y medir sobre mis propios datos son cosas distintas. Así que hice pasar de verdad por el modelo la compuerta del principio.
Todavía no tengo una clave de API de Jev. En su lugar ejecuté en local el Kev-9B que mencioné antes. Es una implementación de reproducción que monta un LoRA de rank 16 y una pointer head sobre Qwen3.5-9B-Base, con licencia Apache-2.0. Las cifras de abajo no son las de Jev. Los datos de entrenamiento de Kev son tareas de decisión en inglés, y en la medición de su propio autor Kev-9B queda por detrás de Jev incluso en tareas en inglés: su proporción de automatización con un presupuesto de error del 5% va de 0.45 a 0.57, mientras que la de Jev es 0.70, y en MMLU-Pro es 0.52 frente a 0.84. Además, la propia documentación de TypeSafe declara sobre Jev que el inglés es su lengua principal de entrenamiento y el CJK no está al mismo nivel.
El conjunto de evaluación lo saqué de 18 artículos en coreano de este repositorio. El criterio de verdad de las etiquetas es con qué grafía escribe este repositorio esa palabra de forma consistente. Es decir, no es el consenso de la comunidad de documentación técnica coreana, sino la costumbre de este blog; en las palabras donde ambas cosas divergen, el modelo puede acertar según el criterio de la comunidad y fallar según este.
- Conjunto de la compuerta, 102 frases. Son palabras que la compuerta ya conoce. Los positivos son 23 frases contrafácticas en las que palabras que el texto escribe en inglés, como
calendar,pickeroadapter, se han devuelto a su transcripción en hangul; los negativos son 79 frases en las que aparecen de verdad palabras quewrite-post.mddeclara como excepción, como리렌더링o콜 스택. Aquí la compuerta de expresiones regulares actual acierta el 100% por definición. - Conjunto en reserva, 60 frases. Son palabras que la compuerta no ha visto nunca. Es lo que en machine learning se llama conjunto held-out. Los positivos son 30 casos en los que
loader,mutationyprefill, que el texto escribe solo en inglés, se han devuelto a su transcripción; los negativos son 30 casos con리듀서,스냅샷y런타임, que el texto escribe solo en hangul. Aquí la expresión regular no atrapa ni un solo positivo.
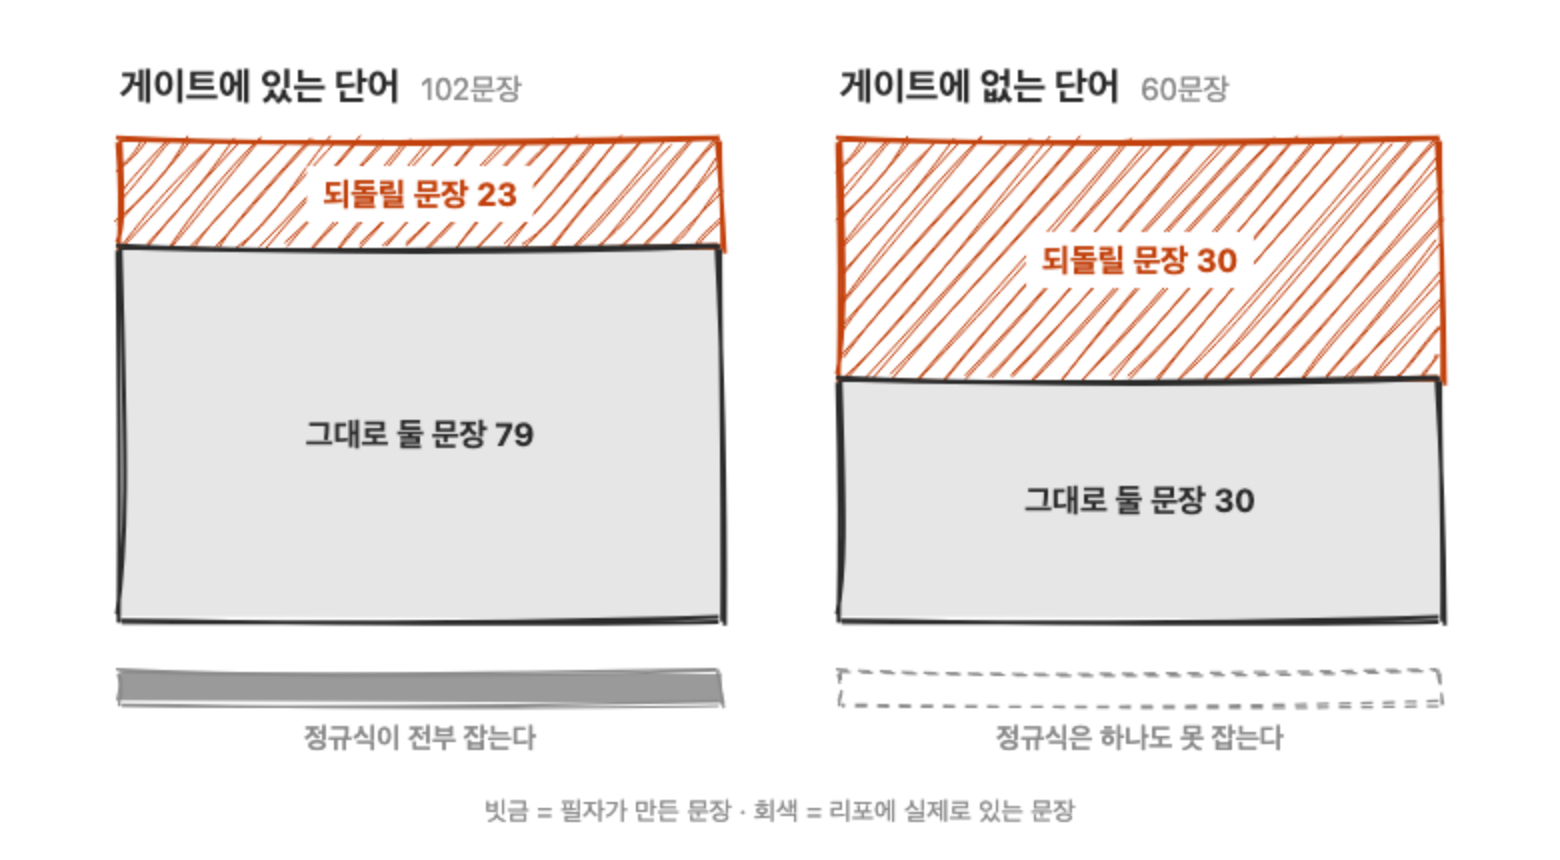
Dejo dicho de entrada el desequilibrio de que los positivos son frases contrafácticas escritas por mí y los negativos son frases reales. Y la muestra efectiva no es el número de frases, sino el número de palabras. Como la etiqueta se decide por palabra, las frases en las que aparece la misma palabra no son observaciones independientes. El conjunto de la compuerta tiene 24 palabras distintas y el conjunto en reserva, 13.
La tabla de abajo agrega solo una pregunta noul, la que pregunta «¿hay que devolver esta palabra al inglés?». Metí cuatro preguntas en la misma petición, pero las otras tres eran la forma negativa, una variante de Choice y un juicio sobre compuestos cuya etiqueta no conseguí fijar bien, así que no las mezclo aquí. La proporción de automatización con presupuesto del 5% es la proporción máxima que se obtiene cortando desde la confianza más alta hacia abajo sin que el error del tramo superior pase del 5%.
| Conjunto de la compuerta | Conjunto en reserva | |
|---|---|---|
| Frases / palabras | 102 / 24 tipos | 60 / 13 tipos |
| Compuerta de expresiones regulares actual | 1.000 | 0.500 |
| Exactitud de Kev-9B | 0.225 | 0.500 |
| Exactitud por palabra | 6/24 | 7/13 |
| Línea base de clase mayoritaria | 0.775 | 0.500 |
| ECE | 0.664 | 0.336 |
| Confianza media | 0.876 | 0.821 |
| Proporción con confianza de 0.9 o más | 0.490 | 0.317 |
| Acierto real de ese tramo | 0.240 | 0.526 |
| Automatización con presupuesto del 5% | 0.010 | 0.000 |
La línea base de clase mayoritaria es la puntuación que se obtiene sin leer la frase, estampando siempre la etiqueta más frecuente. El modelo queda por debajo de eso.
La última fila es la respuesta de este experimento. En el conjunto en reserva, por muy alto que pusiera el umbral, no hubo ni una sola decisión que pudiera procesarse automáticamente dentro de un 5% de error.
Mirando la distribución de predicciones se ve qué ocurrió. El modelo respondió «hay que devolverla» en las 162 frases. En las 37 palabras distintas, todas. Acertó todos los positivos y falló todos los negativos. Por eso el 0.500 del conjunto en reserva no es habilidad: es la cifra que sale porque el conjunto está equilibrado.
Y con eso la confianza media era 0.876. En el conjunto de la compuerta, el 49% superó una confianza de 0.9, y el acierto real de ese tramo es 0.240.
Tampoco se cumplió la identidad estructural. Al sumar las probabilidades de «¿hay que devolverla?» y «¿hay que dejarla como está?», en el conjunto de la compuerta salió una media de 1.655, y las 102 frases se desviaron de 1 en más de 0.1.
Es así por diseño. Las dos preguntas son evaluaciones separadas que no se leen entre sí, y la propia TypeSafe incluye en su página sobre jaggedness un ejemplo en el que refund 0.72 y not_refund 0.47 suman 1.19.
El punto que engancha en la práctica es este. Un umbral ajustado para Noul no debe trasladarse a Choice. Siendo el mismo juicio, las frases en las que la conclusión difería fueron entre el 14% y el 17%.
Si fuera un modelo que dice que sí a cualquier cosa que le preguntes, este resultado no significaría nada. Empecé por comprobar eso.
| Estado / pregunta | Qué pregunté | Respuesta |
|---|---|---|
| Coreano / coreano | 이 문장은 영어로 쓰여 있는가? (¿Esta frase está escrita en inglés?) | 0.02 |
| Coreano / coreano | 이 문장은 요리법을 설명하는가? (¿Esta frase explica una receta de cocina?) | 0.04 |
| Coreano / coreano | 이 문장은 한국어로 쓰여 있는가? (¿Esta frase está escrita en coreano?) | 0.98 |
| Coreano / inglés | Is this sentence written in English? | 0.01 |
| Inglés / inglés | Is this sentence about software? | 0.96 |
Lee coreano, dice «no» y separa 0.02 de 0.98. No es un sesgo global de complacencia. Lo que esto descarta llega hasta ahí. Queda la posibilidad de que la redacción misma de la pregunta de la compuerta sea mala.
El resultado de meter las reglas en el state
Entonces, ¿cambia algo si le doy directamente el conocimiento que hace falta para decidir? El método de adaptación a un dominio que recomienda la documentación de TypeSafe es este: sin tocar los pesos, envías el material de referencia dentro del state.
Cogí los párrafos de reglas que ya están escritos en write-post.md, los metí también en el state y volví a ejecutarlo. La entrada pasó de 100 tokens por frase a 450. El conjunto de la compuerta es una filtración, porque ese material de referencia enumera por su nombre tanto las palabras de la compuerta como las excepciones. Por eso ese lado es el grupo de control que sirve para ver «si al menos lee el material de referencia», y la prueba de verdad es el conjunto en reserva.
| Compuerta (filtración) | Compuerta + reglas | Reserva | Reserva + reglas | |
|---|---|---|---|---|
Exactitud de noul |
0.225 | 0.676 | 0.500 | 0.500 |
| Exactitud por palabra | 6/24 | 7/13 | 5/13 | |
| Positivos correctos | 23/23 | 1/23 | 30/30 | 8/30 |
| Negativos correctos | 0/79 | 68/79 | 0/30 | 22/30 |
| Automatización con presupuesto del 5% | 0.010 | 0.314 | 0.000 | 0.050 |
| Latencia mediana | 2,924ms | 6,903ms | 2,908ms | 6,918ms |
La latencia corresponde a inferencia local en un M2 Max, así que no está en el mismo eje que la latencia de la API de Jev que vimos antes. Lo que hay que mirar aquí no es el valor absoluto, sino el factor de 2.4 que aparece al meter el material de referencia.
En el conjunto en reserva, que está equilibrado, la exactitud por frase pasó de 0.500 a 0.500: no se movió en absoluto. Por palabra incluso bajó, de 7/13 a 5/13.
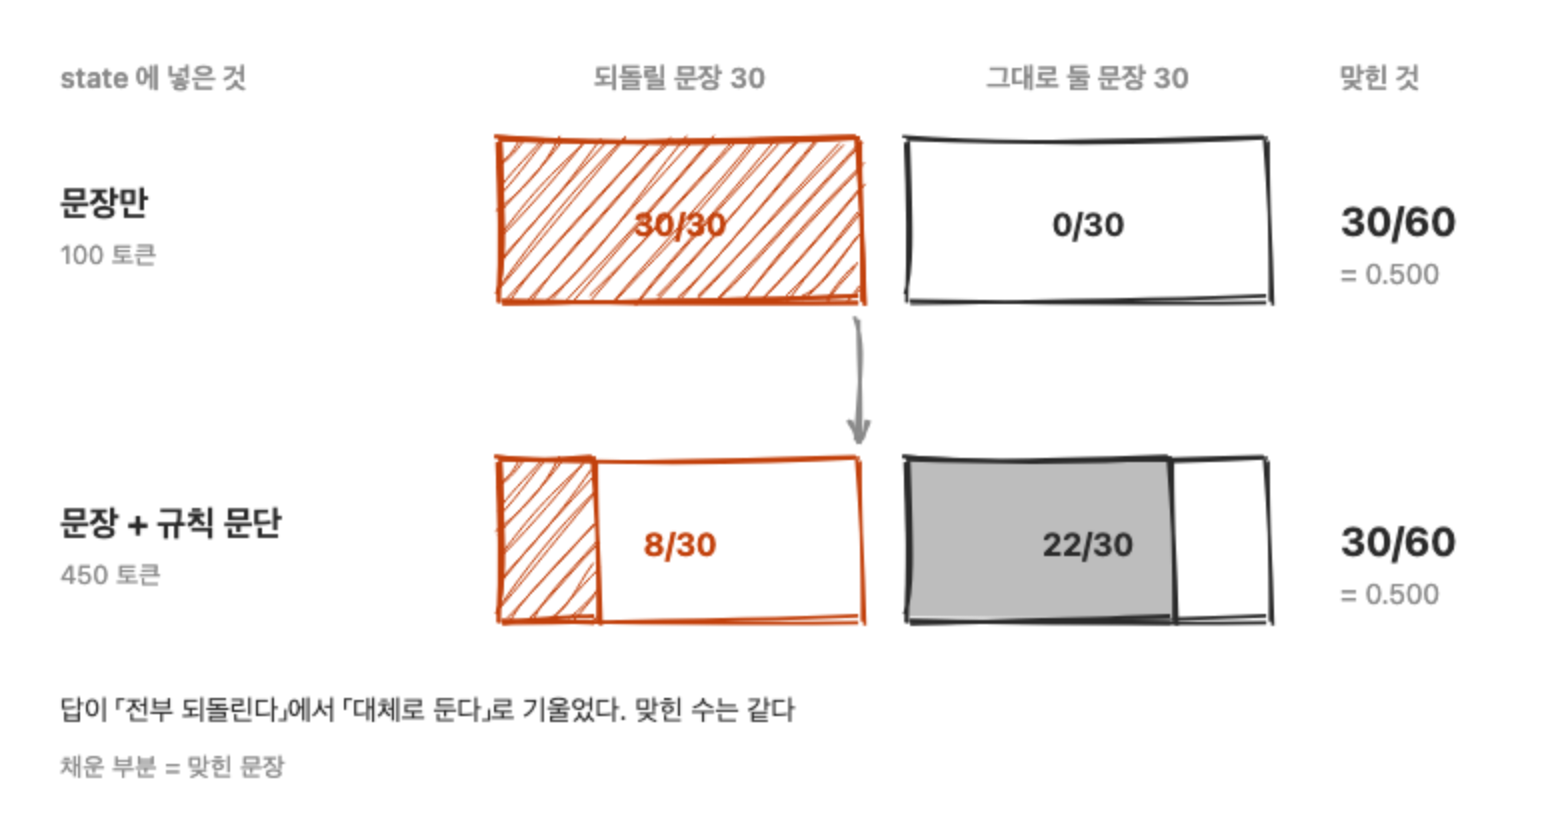
El salto de 0.225 a 0.676 en el conjunto de la compuerta no es una mejora de habilidad. Antes respondía «se devuelve» en las 102 frases, y al darle el material de referencia solo respondió así en 12. Los negativos subieron de 0/79 a 68/79, pero los positivos se hundieron de 23/23 a 1/23. En ese conjunto los negativos ganan por 79 a 23, así que una constante del tipo «déjalo casi siempre» recibe automáticamente una puntuación más alta. No aprendió a distinguir: cambió la inclinación.
Eso no significa que el modelo no lea las frases. Con las mismas frases de las mismas palabras, al darle el material de referencia las predicciones se dispersaron frase a frase. La desviación típica de 로더 subió de 0.096 a 0.217, y la de 뮤테이션 de 0.042 a 0.236. Lee, pero no distingue.
Y este resultado también sacude la interpretación de la sección anterior. Si un solo texto del state da la vuelta por completo a la salida, el «devolverlas todas» de la primera ejecución podría no ser un límite del modelo, sino una carencia en la redacción de la pregunta. Este artículo no ha podido descartar esa posibilidad.
Una cosa sí mejoró de forma visible. La suma de las probabilidades de «se devuelve» y «se deja» se acercó, en el conjunto en reserva, de 1.508 a 0.963, y las frases que se alejaban mucho de 1 bajaron de 59 a 18. Pero la exactitud no se movió. Que las probabilidades de dos preguntas encajen entre sí y que esas probabilidades sean correctas son cosas distintas.
El lugar de los modelos de decisión
Visto hasta aquí, es fácil inclinarse a concluir que toda esta categoría de modelos es inútil, pero poner uno al lado de otro los benchmarks publicados dice que no es así.
| Tarea | n | Jev | Comparación |
|---|---|---|---|
| Spam, dentro de la distribución | 18,514 | 98.3% | Regresión TF-IDF 98.4% |
| Spam, fuera de la distribución | 2,876 | 98.6% | Regresión TF-IDF 73.0% |
| Phishing | 2,000 | 62.6% | Haiku 4.5 81.3%, línea base de reglas 91.6% |
| Rerank, 8 conjuntos en inglés | 1,617 | nDCG@10 0.692 | Cohere Rerank 4 Pro 0.691 |
Solo la fila de rerank es una métrica de calidad de ranking de búsqueda, así que está en un eje distinto del de la exactitud de las demás filas.
Dentro de la distribución, una expresión regular o un clasificador ya ajustado gana o empata. Es el mismo lugar en el que, en mi conjunto de la compuerta, la expresión regular ganó por 1.000 a 0.225. Si puedes reunir etiquetas, entrenar un modelo pequeño sale más barato, más rápido y más exacto. Eso es algo que se hace desde hace mucho.
La brecha se abre cuando la distribución es nueva y no hay etiquetas. En el spam fuera de la distribución, 98.6% frente a 73.0%. El clasificador ajustado se viene abajo ante una forma que no ha visto nunca, y este aguanta. El lugar de los modelos de decisión son las decisiones para las que no se pueden reunir datos, etiquetarlos y entrenar. Es el sitio donde cada situación es nueva, no se logran reunir etiquetas y aun así hay que decidir en cuestión de segundos.
Este marco explica también por qué falló mi discriminación de transcripciones. Lo que esa decisión necesita no es razonamiento general, sino el conocimiento de dominio concreto de qué palabras se han asentado en la documentación técnica coreana, y para una implementación de reproducción de 9B entrenada con tareas de decisión en inglés eso no está fuera de la distribución: sencillamente no existe en ella. Ahí está la razón de que tampoco funcionara darle las reglas por escrito.
En un artículo de TechCrunch, Armin Ronacher, CTO de Earendil, la empresa que hace el harness Pi, dijo lo siguiente.
At the end of the day, it delegates the hallucination problem a little bit to the user.
No ha eliminado la alucinación: ha pasado la decisión al desarrollador. La documentación de TypeSafe también escribe que la calibración es una propiedad que se cumple sobre un conjunto de predicciones y no una garantía de que una respuesta individual sea correcta, y bajo la barra del 0% de tasa de alucinación del artículo de presentación, en el apartado Nuance, se lee "Our number is not empirical". El formato está garantizado; el contenido no.
Los 194 proyectos de jevable
Como en mis datos falló, fui a ver dónde lo usan los demás. jevable.com es una curación independiente en la que un desarrollador llamado Nikunj revisa y reúne los proyectos con Jev que aparecen en X. A fecha de 23 de septiembre de 2026 son 194, y las fechas de alta se concentran entre el 16 y el 20 de septiembre de 2026. 152 entraron en un solo día, el 18 de septiembre. Tres días después del lanzamiento.
| Categoría | Cantidad |
|---|---|
| Games | 39 |
| Developer tools | 34 |
| Productivity | 31 |
| Agents | 19 |
| Experiments | 18 |
| Creative tools | 16 |
| Data & research, Finance, Browser extensions, Robotics, Marketing | 37 |
Si en vez de por categoría se reagrupan por «qué se le pregunta», salen tres formas. Las cifras de abajo son las que cada autor escribió en su propia publicación.
Primera, clasificación y enrutamiento. Clasificar 1,500 correos, clasificar documentos fiscales, clasificar 1,891 anuncios de la competencia en 19 segundos por $0.12, 14 typed checks sobre un único diff de PR, detectar publicidad en las notificaciones de Android, clasificar 26 planos de construcción en 2.9 segundos. Es la misma forma que la compuerta de transcripciones del principio. Como decía la tabla de la sección anterior, son lugares donde las etiquetas se acumulan cada día, así que con el tiempo un clasificador pequeño entrenado con tus propias etiquetas gana o empata. La ventaja de Jev está en el primer día, cuando no hay etiquetas.
Segunda, bucles de selección de acciones. Un browser agent enganchado a Browser Use que terminó una búsqueda de vuelos en 7 segundos por $0.0039, un computer use que maneja el Mac por voz, un juego que cada vez que Mario muere hace fork de la VM en cuatro ramas y elige la que sobrevive, un motor de expresiones faciales que decide en cada mensaje diez cosas de un personaje 3D, como la boca, las cejas y la mirada. El action space cambia en cada paso, así que no se pueden reunir etiquetas, y la decisión tiene que bajar por debajo del segundo. Es el mismo lugar en el que la diferencia se abrió con el spam fuera de la distribución. Creo que también por eso Games es la categoría más grande, con 39. Un juego es un bucle de selección de acciones en el que equivocarse tiene vuelta atrás.
Tercera, interfaces que muestran la probabilidad al usuario. Ask Jev, que devuelve solo el veredicto en lugar de una respuesta; JevForm, un formulario ramificado que elige la siguiente pregunta por probabilidad; Upweight, que reordena la portada de Hacker News con seis deslizadores como profundidad técnica y drama. Como el umbral no está metido en el código y es una persona quien lee la probabilidad, es donde menos pesa la exigencia de calibración que este artículo ha puesto en cuestión.
Una cosa llama la atención. De las 194 descripciones, 30 anotan el coste y 53 la velocidad, pero solo 7 anotan la exactitud o una línea de base. Los resúmenes solo recogen el inicio de cada post, así que es una cota inferior, pero la dirección está clara. Que es rápido y barato se sabe el primer día; si acierta, solo se sabe midiendo, y los que miden son pocos. Uno de esos 7 es jevcal. Su autor dice que todo el mundo elige el umbral a ojo, y la herramienta devuelve el umbral y la proporción de procesamiento automático a partir de tus datos y la exactitud objetivo. Es exactamente el procedimiento que recomienda la sección siguiente, convertido en herramienta.
Cómo trazar la línea
La conclusión de este artículo es esta. No leas como una especificación la probabilidad que devuelve el modelo: mídela tú mismo sobre tus propios datos y traza ahí la línea.
El procedimiento para medir es este. Reúnes un centenar largo de casos etiquetados, construyes una tabla de tasa real de acierto por tramo de probabilidad y vas bajando el umbral desde arriba mirando la tasa de error del tramo superior. Si has fijado un presupuesto de error, la cobertura máxima que respeta ese presupuesto es justamente la proporción que puedes automatizar. Que en mi experimento el acierto real del tramo con confianza de 0.9 o más fuera 0.240 salió a la luz con 102 frases.
Una escala desajustada suele poder arreglarse. Si el exceso de confianza está repartido de forma uniforme por todos los tramos, una sola temperatura lo corrige casi del todo. Kev hizo justamente eso y bajó su ECE de 0.106 a 0.042. El problema es que ajustar esa temperatura exige tener las etiquetas de esa distribución, y eso es exactamente lo que no hay en producción. Además, la temperatura no puede cambiar el orden de las probabilidades, así que la proporción automatizable no sube en la misma medida. Por eso el orden importa más que la escala, y la cobertura bajo presupuesto de error es una métrica más práctica que el ECE.
Si hubiera clavado en el código el 0.9 que la documentación usa en su ejemplo, esta compuerta habría corregido mal, en silencio, 38 casos. Como no salta ningún error, es un fallo difícil de advertir. La documentación de TypeSafe también escribe, justo debajo de ese ejemplo, que lo pruebes con tus propios datos. Lo que acaba clavado en el código no suele ser la frase de debajo, sino el número de arriba.
Aunque no tengas clave, medir puede empezarse hoy mismo. Kev está publicado bajo Apache-2.0 y corre en un portátil.
Me gustaría que contaras cuántas llamadas del servicio que operas le preguntan solo sí/no a un modelo grande. Antes de mover esas llamadas a un modelo de decisión, te recomiendo medir primero dónde habría que trazar la línea después de moverlas. Yo pude decidir no tocar la compuerta porque respeté ese orden. Cuando consiga una clave de Jev pienso volver a pasar el mismo conjunto, y si entonces cambia la conclusión, también lo escribiré.